ResearchMan
Technology Archive
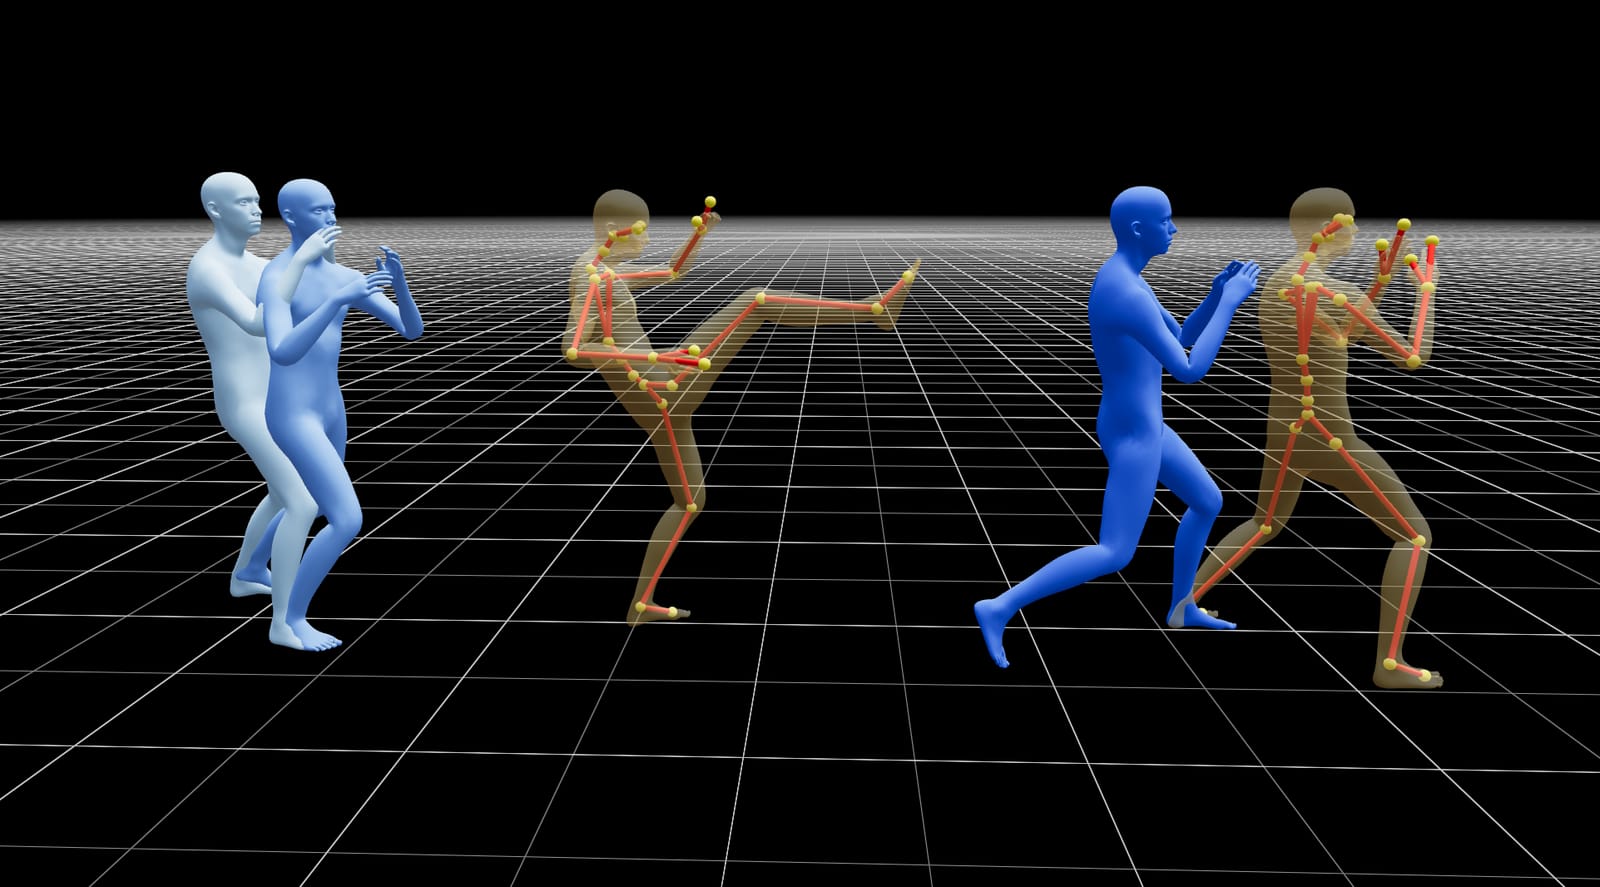
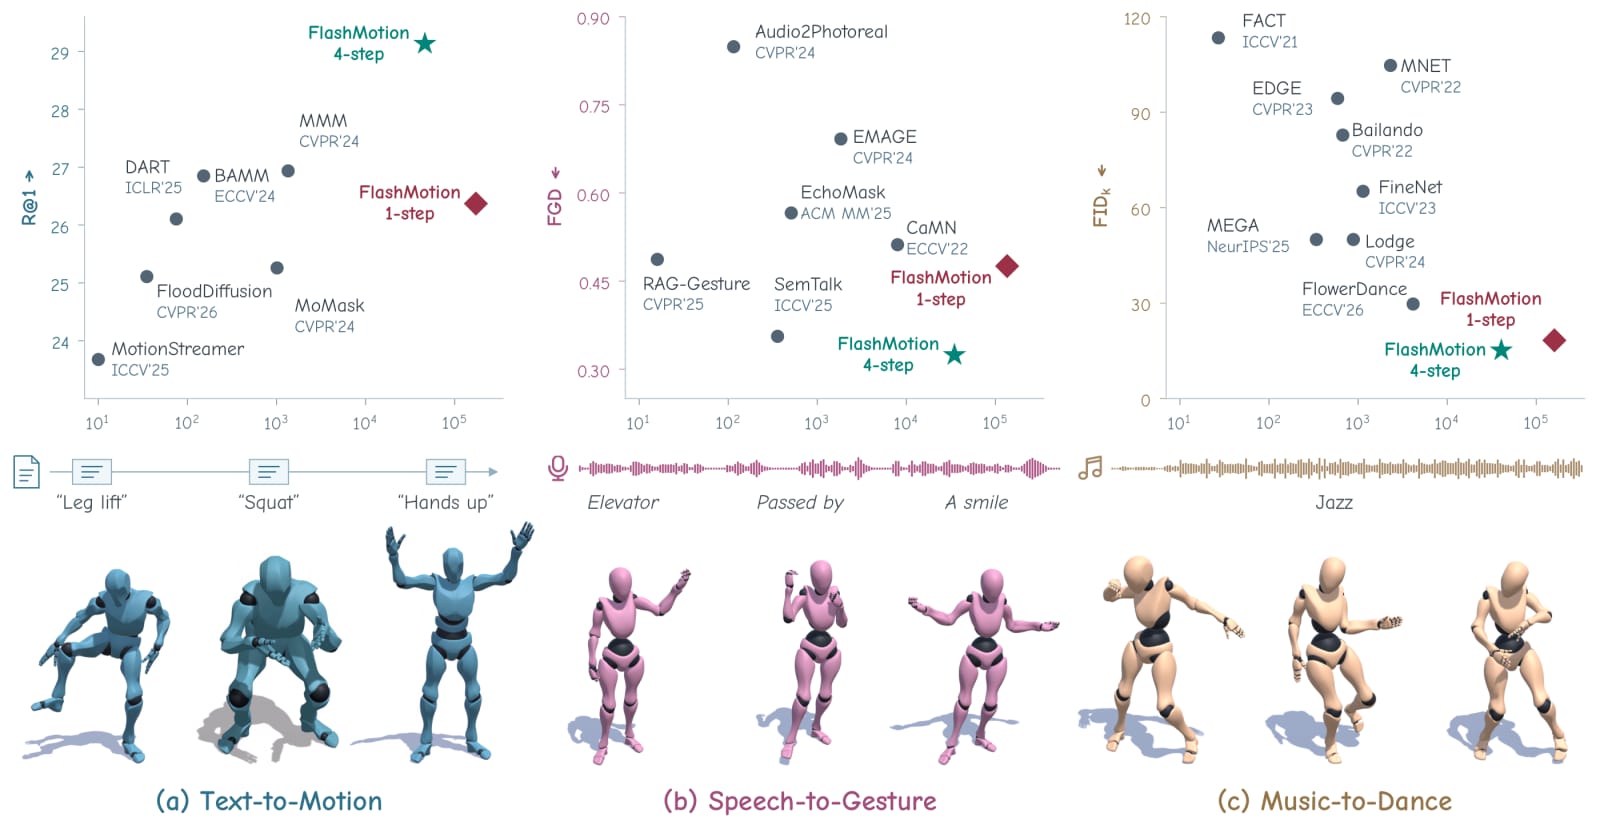
FlashMotion
文章・音声・音楽のどれからでも、長尺の3D人体モーション(動作・身振り・ダンス)を1〜4ステップの少ない計算で一気に作る研究。コードと学習済み重みが公開されている。
Kaixing Yang ほか(FlashMotion 研究チーム) / GitHub
#Motion/Body#Audio/Music
Pianoid
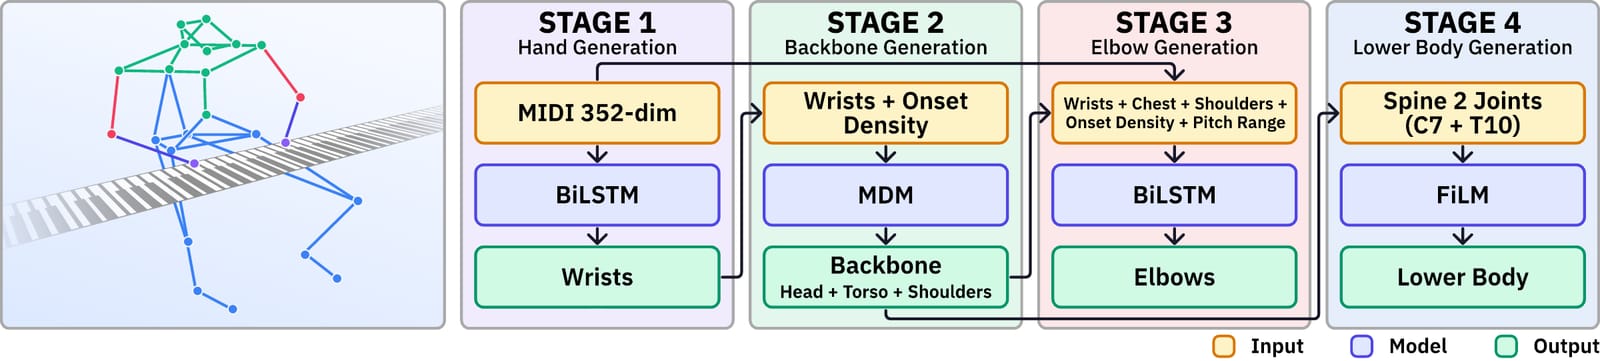
ピアノ演奏のMIDIデータだけから、ピアニストの上半身〜下半身26関節の3D動きを生成する研究(ISMIR 2026)。コードと学習済み重み(GitHub Release)が公開されている。
KAIST(Joonhyung Bae, Juhan Nam) / GitHub
#Motion/Body#Audio/Music
LynnReal-Hand
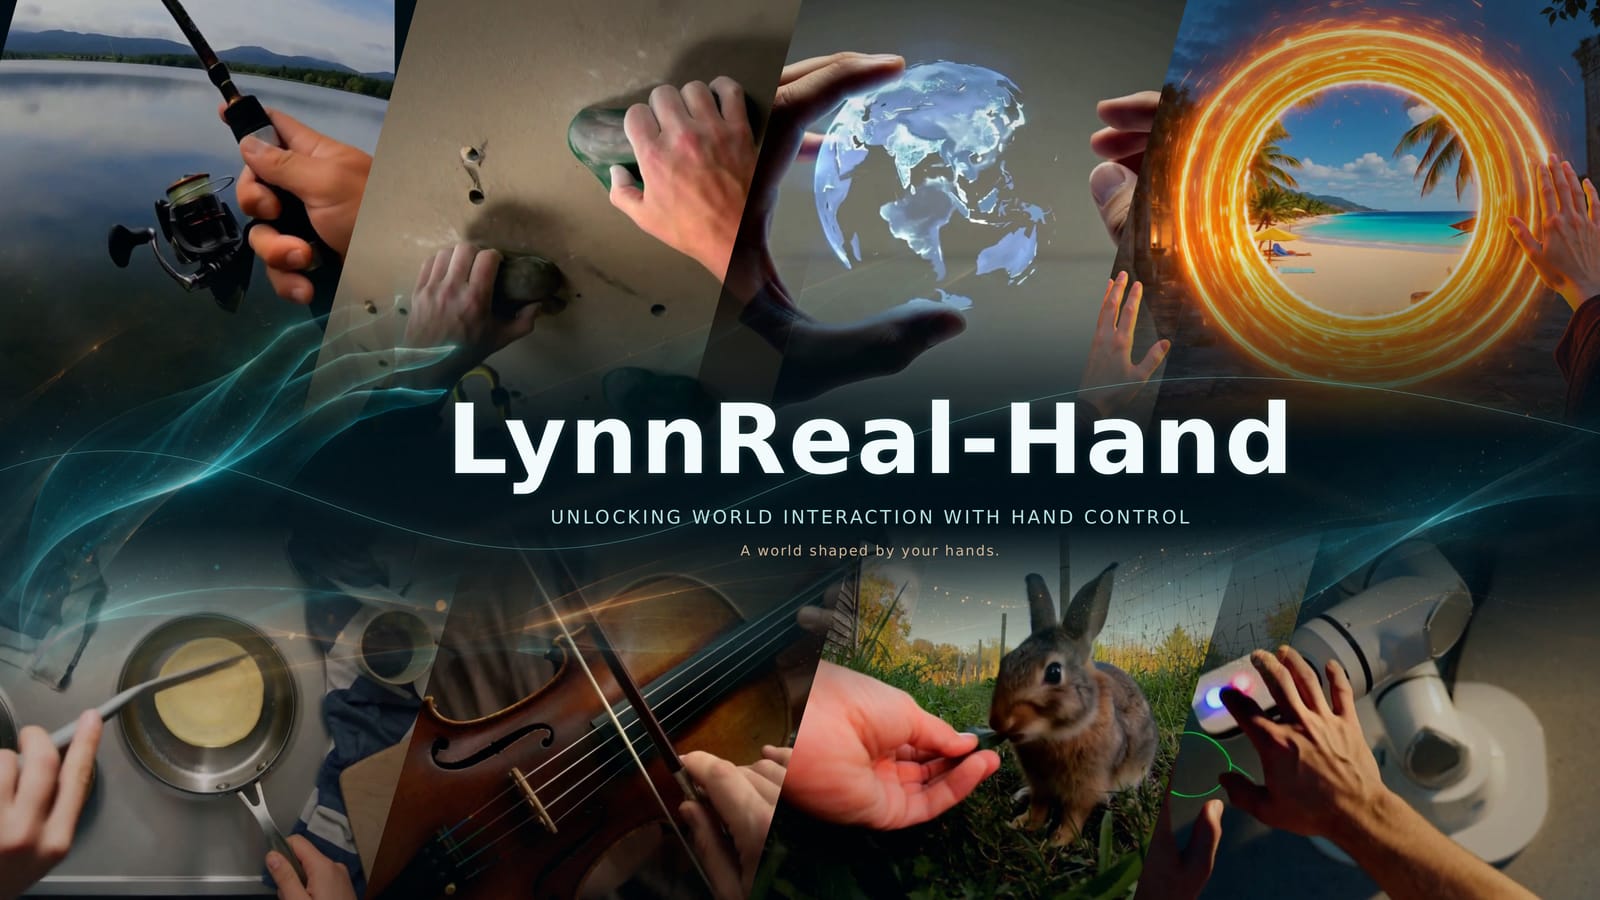
最初の1枚の画像・文章・手の動きの映像を入れると、手の動きに合わせて物に触れる・動かす様子を映像として生成する「手で操作できる世界モデル」。推論コードと重みが公開されている。
LynnReal-AI(Shaohao Rui ら) / GitHub
#Motion/Body#GenVideo#HCI/MediaArt
SimDPS (Similarity-Guided Diffusion Posterior Sampling for Music Inpainting)
録音された音楽の「数秒〜十数秒の欠落部分」を、同じ曲の別の場所から似た文脈の断片を探し出し、それを手がかりに拡散モデルで自然に埋め直す手法。追加学習なしで既存の音楽生成モデルに差し込め、CLIとPythonで使える。
Sean Turland, Eloi Moliner, Vesa Välimäki(アルト大学の研究者と見られる。arXivページに所属の記載なし) / GitHub
#Audio/Music
DOPPLERGEIST
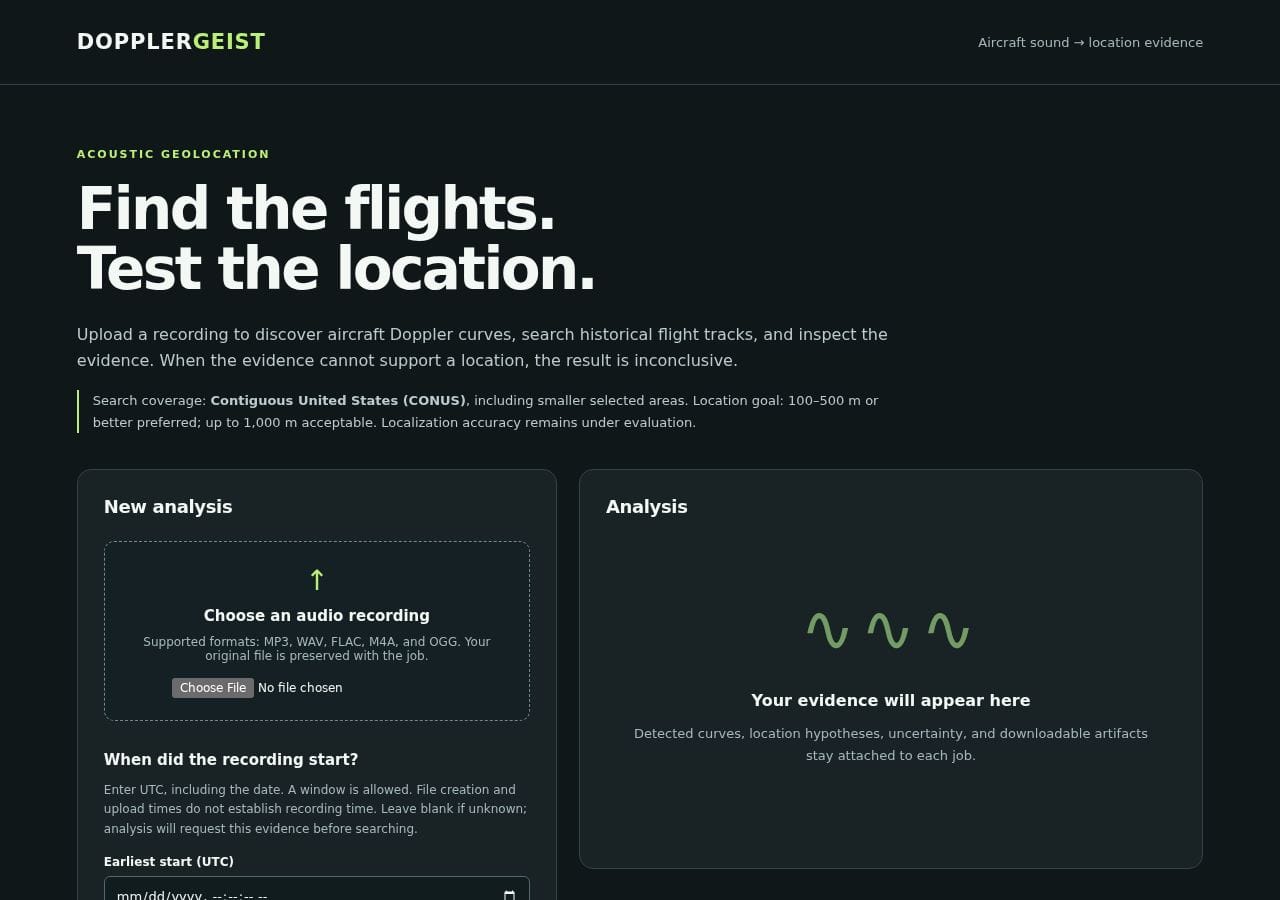
録音に混ざった飛行機の通過音(ドップラー効果)を手がかりに、過去の飛行記録(ADS-B)と照合して録音地点を推定するPythonツール。2026年11月に公開・PyPI配布。
Cinna Davis(個人開発・1337isnot1337) / GitHub
#Audio/Music#CreatorTools
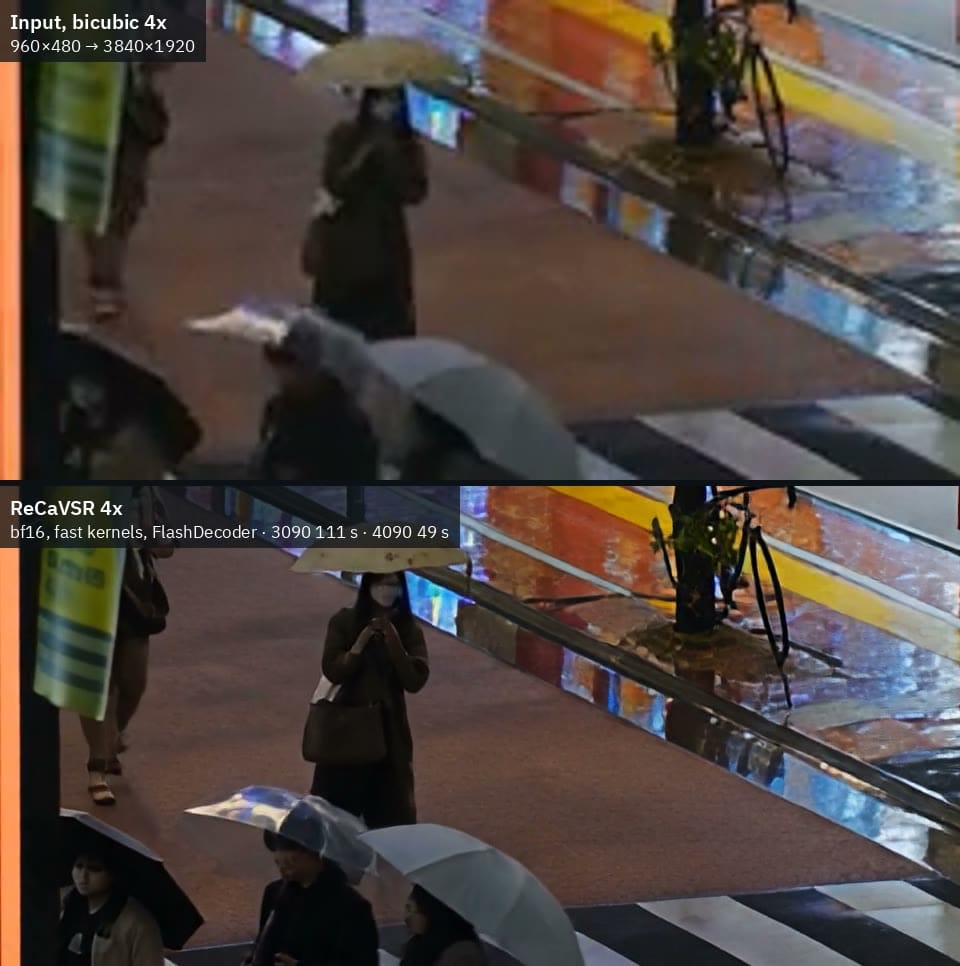
ReCaVSR
動画を1ステップの拡散モデルで4倍に高画質化するアップスケーラー。ComfyUIノードとint8軽量版が公開され、8GBのGPUでも動かせる。
USTC(中国科学技術大学)/ ComfyUI版: PedroMarinhoDev / GitHub
#GenVideo#CreatorTools
TaoMate-FVSR
生成AI動画の小さくぼやけた顔を、音声を手がかりに復元し、差し替え音声に口の動きも合わせ直す顔動画修復モデル。
TaoLive AIGC / GitHub
#GenVideo#CreatorTools
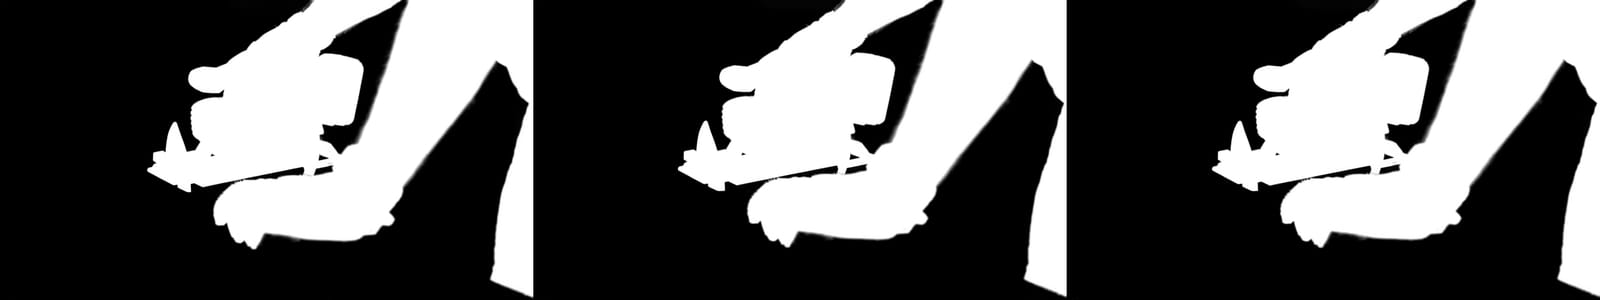
LTX Alpha Gen for DaVinci Resolve (cvt-ltx-alpha-gen)
LightricksのLTX-2.5 Alpha Genモデルを使い、DaVinci Resolve/Fusion内で映像の切り抜き(ロトスコープ)マットを生成するOFXプラグイン。
Creative Video Tips / GitHub
#CreatorTools#GenVideo
Vauss
スマホや360°カメラで撮った動画を、コマンド1本で3D Gaussian Splatのシーンに変換するRust製ツール。Blender 5.3向け出力、ゲーム用の当たり判定の書き出し、AIエージェント連携まで備える。
voyager-so / GitHub
#Spatial/3D#CreatorTools#AI/Agents
EDGAR (Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure)
ぼやけ・伸び・ちらつきが出た Gaussian Splatting 製の頭部アバターを、1枚の本人参照画像と1ステップ拡散モデルで補修する手法。補修結果は元の3Dアバターに焼き戻されるため、描画速度は落ちない。
KAIST(Kwan Yun, Junyong Noh ら) / GitHub
#Spatial/3D#CreatorTools
SuperMimic
人型ロボットの全身モーション追従を、「1つの微分可能な世界モデル」で学習するUC Berkeleyの手法。従来7日間・GPU128枚だった学習を、H100 1枚・約3時間で上回ったと報告している。
UC Berkeley(HybridRobotics / Pieter Abbeel・Koushil Sreenath 研究室) / GitHub
#Motion/Body#AI/Agents
LivLiv Player
ブラウザ上で2.5Dキャラクターを動かす軽量JavaScriptライブラリ。マイク音声からのリップシンクとウェブカメラの顔トラッキングに対応し、VRMやPNGTuber形式も同じAPIで扱える。
LivLiv(livliv-dev) / GitHub
#CreatorTools#Motion/Body#HCI/MediaArt
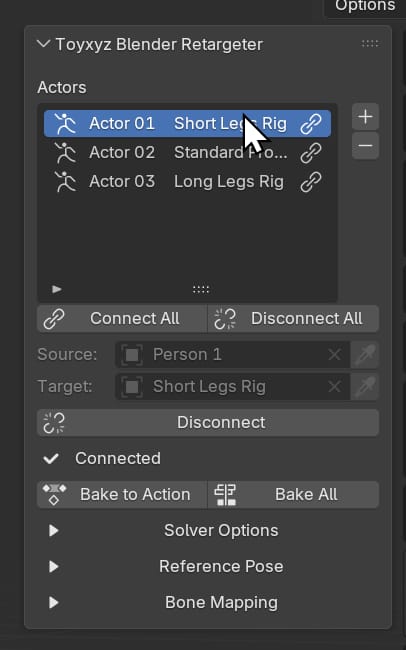
Toyxyz Blender Retargeter
体型の違うキャラクター同士でモーションを移し替える Blender 5.0 以上向けアドオン。足の長さの違いに合わせて歩幅・足の接地・手の届く範囲を自動調整し、ライブでプレビューしてからアニメーションとして書き出せる。
toyxyz / GitHub
#Motion/Body#CreatorTools
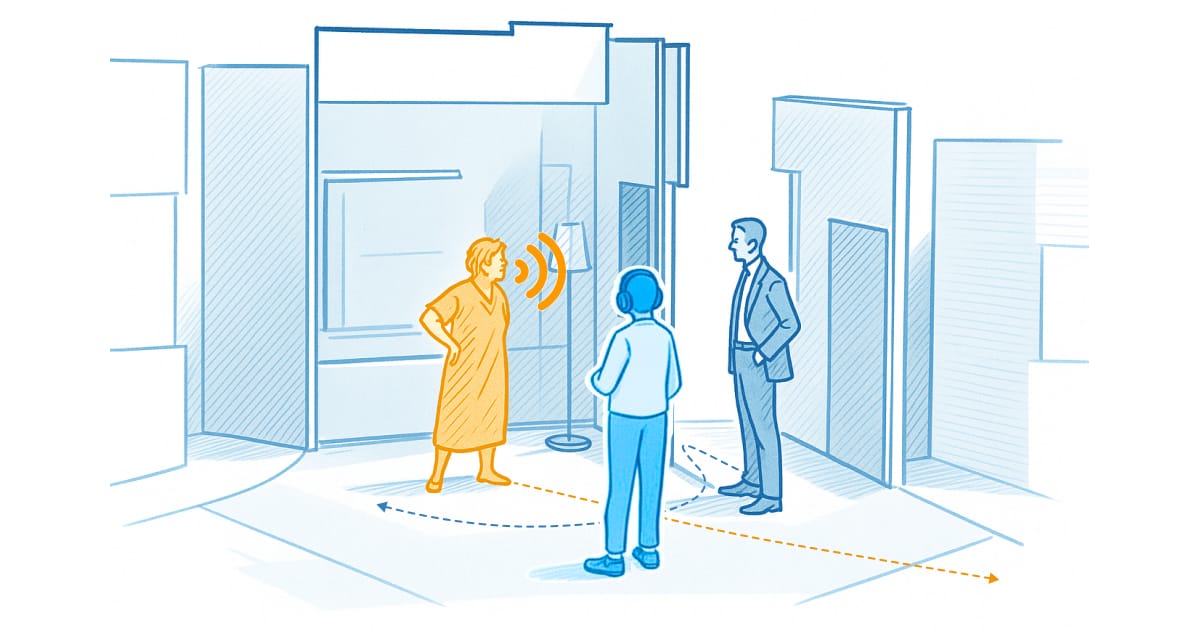
Sonic Stage
ドラマや対談など「セリフが中心の動画」を、目の見えない人・見えにくい人が場面を把握しやすい立体音響(3D空間音響)に自動変換するシステム。UIST 2026 のベストペーパー受賞作。
HKUST / Columbia University / University of Rochester(Shuchang Xu, Xiaofu Jin, Gaurav Jain, Wenshuo Zhang, Huamin Qu, Brian A. Smith, Yukang Yan)
#Audio/Music#HCI/MediaArt
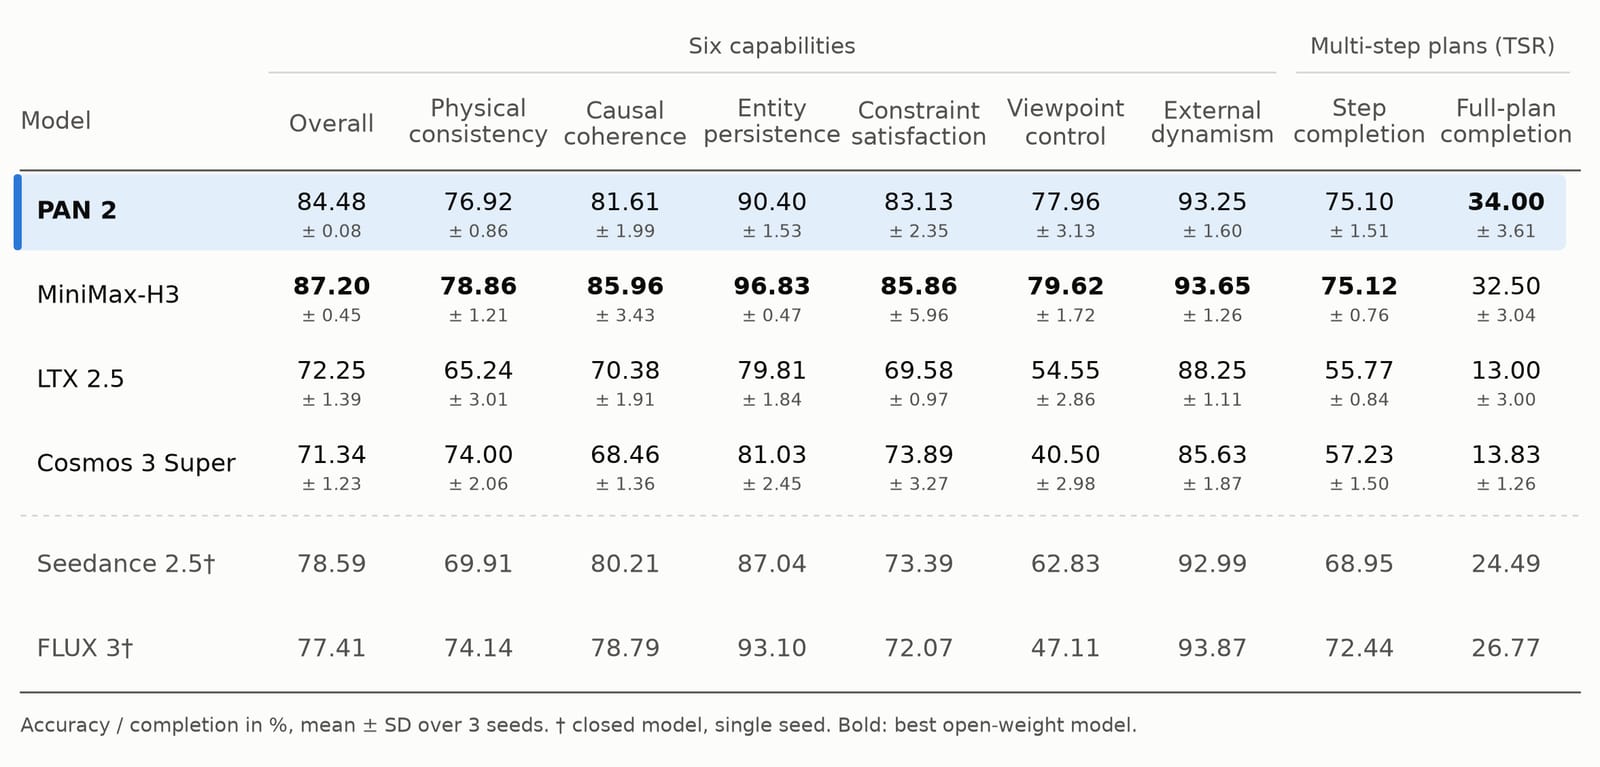
PAN 2
MBZUAI が公開した290億パラメータの「世界モデル」。行動を書いたテキストと最初の1コマから、最長20秒・704x1248・24fps の映像を生成する。重み・推論コード・学習設定が Apache-2.0 で公開されている。
MBZUAI Institute of Foundation Models (IFM) / GitHub
#GenVideo#AI/Agents
ComfyUI-Dials
MiniMax H3 の出力を「2つのプロンプトの差」から約14KBのスライダーに変えて操作する、学習不要の ComfyUI ノード集。動きの量(ほぼ静止〜疾走)などを数値で連続調整できる。
matlowai(個人開発) / GitHub
#GenVideo#CreatorTools
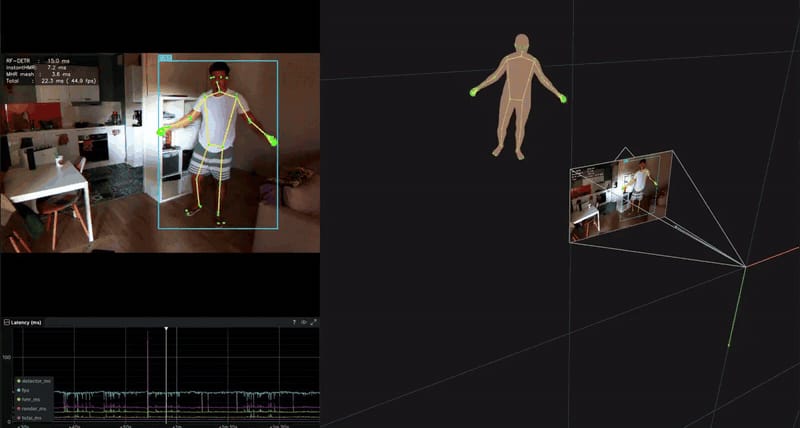
InstantHMR (ComfyUI-InstantHMR)
写真・動画・ライブカメラに写る人物の3D体形とポーズを、1人あたり約1msで復元する軽量モデル。ComfyUI ノード版では GLB/BVH 書き出しやキャラ駆動、VMC 配信まで行える。
Naturalpad Studio / jtydhr88 / GitHub
#Motion/Body#CreatorTools#GenVideo
Quick GS Editor(Quick Gaussian Splat Editor)
ガウシアン・スプラッティング(写真から作る3Dシーン)を、ブラウザ上で穴埋め・クリーニング・位置合わせ・変形・合成できる無料のエディタです。World Labs のオープンソース描画エンジン Spark で作り直され、有償のWindows版 Pro ではローカルで1枚の画像から3Dシーンを生成できます。
Tijerín Art Studio
#Spatial/3D#CreatorTools
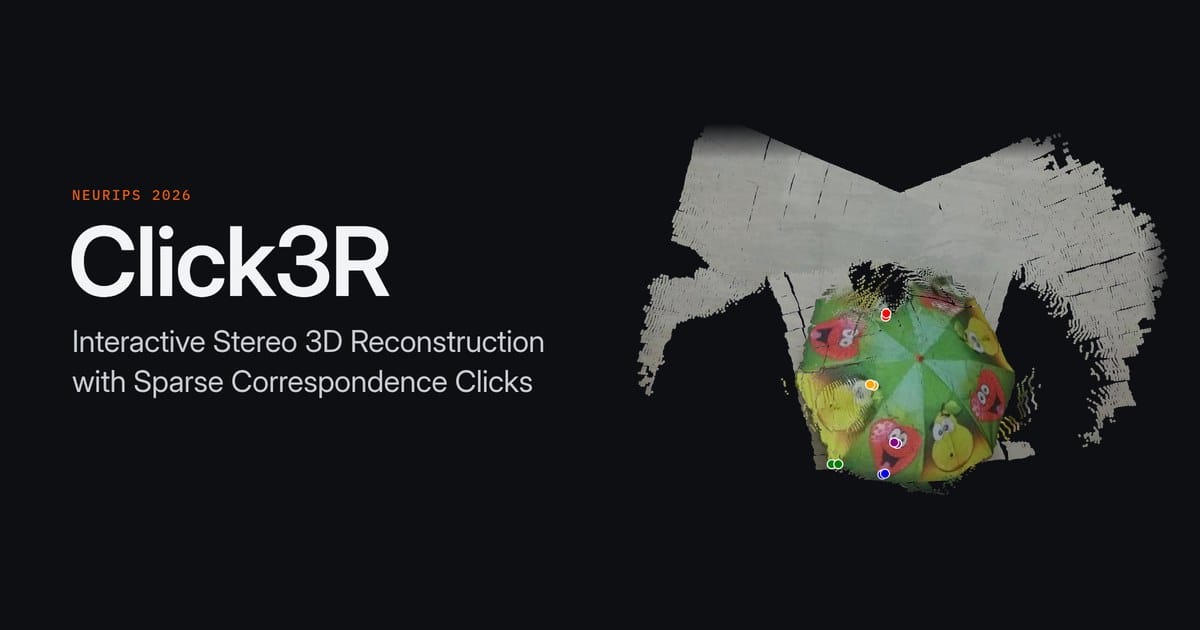
Click3R
2枚の写真から3Dを復元するAIが間違えたとき、人が「この点とこの点は同じ場所」とクリックで数回教えるだけで、その場で直せる手法です。
University of Virginia (UVA Computer Vision Lab) / GitHub
#Spatial/3D#CreatorTools
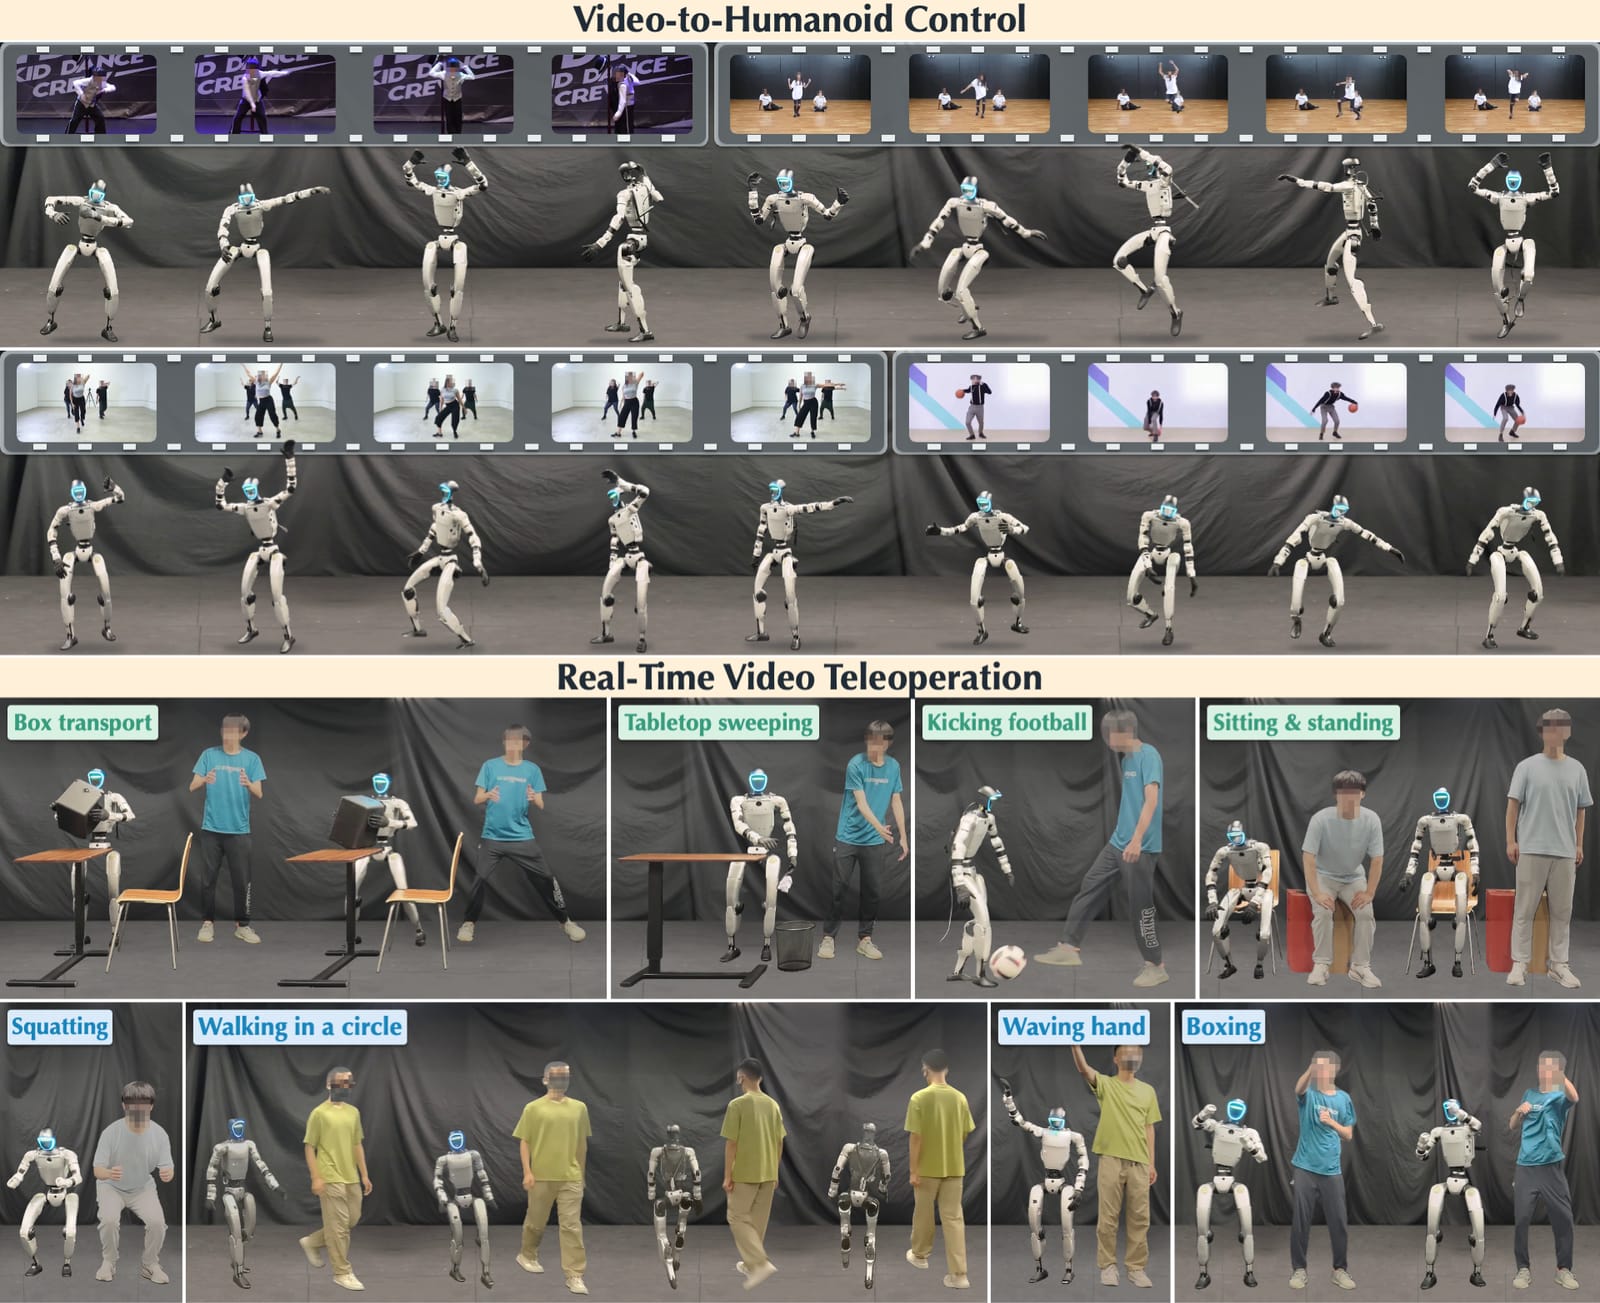
ViT-H
普通のカメラで撮った人の動画から、人型ロボット(Unitree G1)が実際に実行できる動きを直接つくり出す技術。従来の「人の姿勢を復元→ロボットに変換→追従」という3段階を飛ばせる。
北京大学 / BIGAI(北京通用人工知能研究院) / GitHub
#Motion/Body#AI/Agents
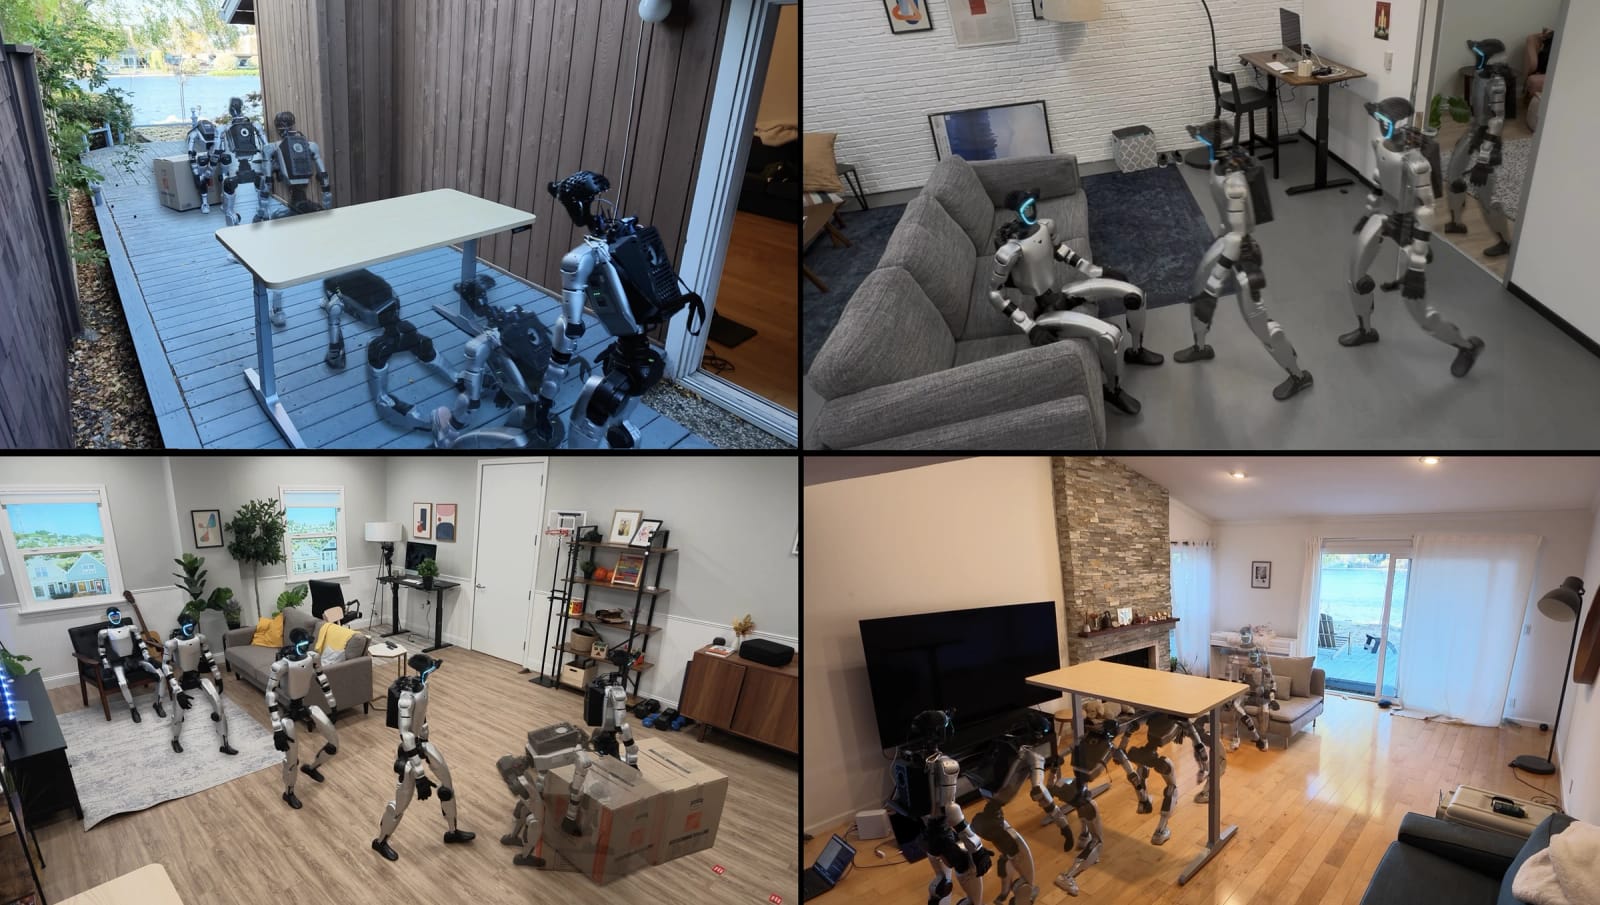
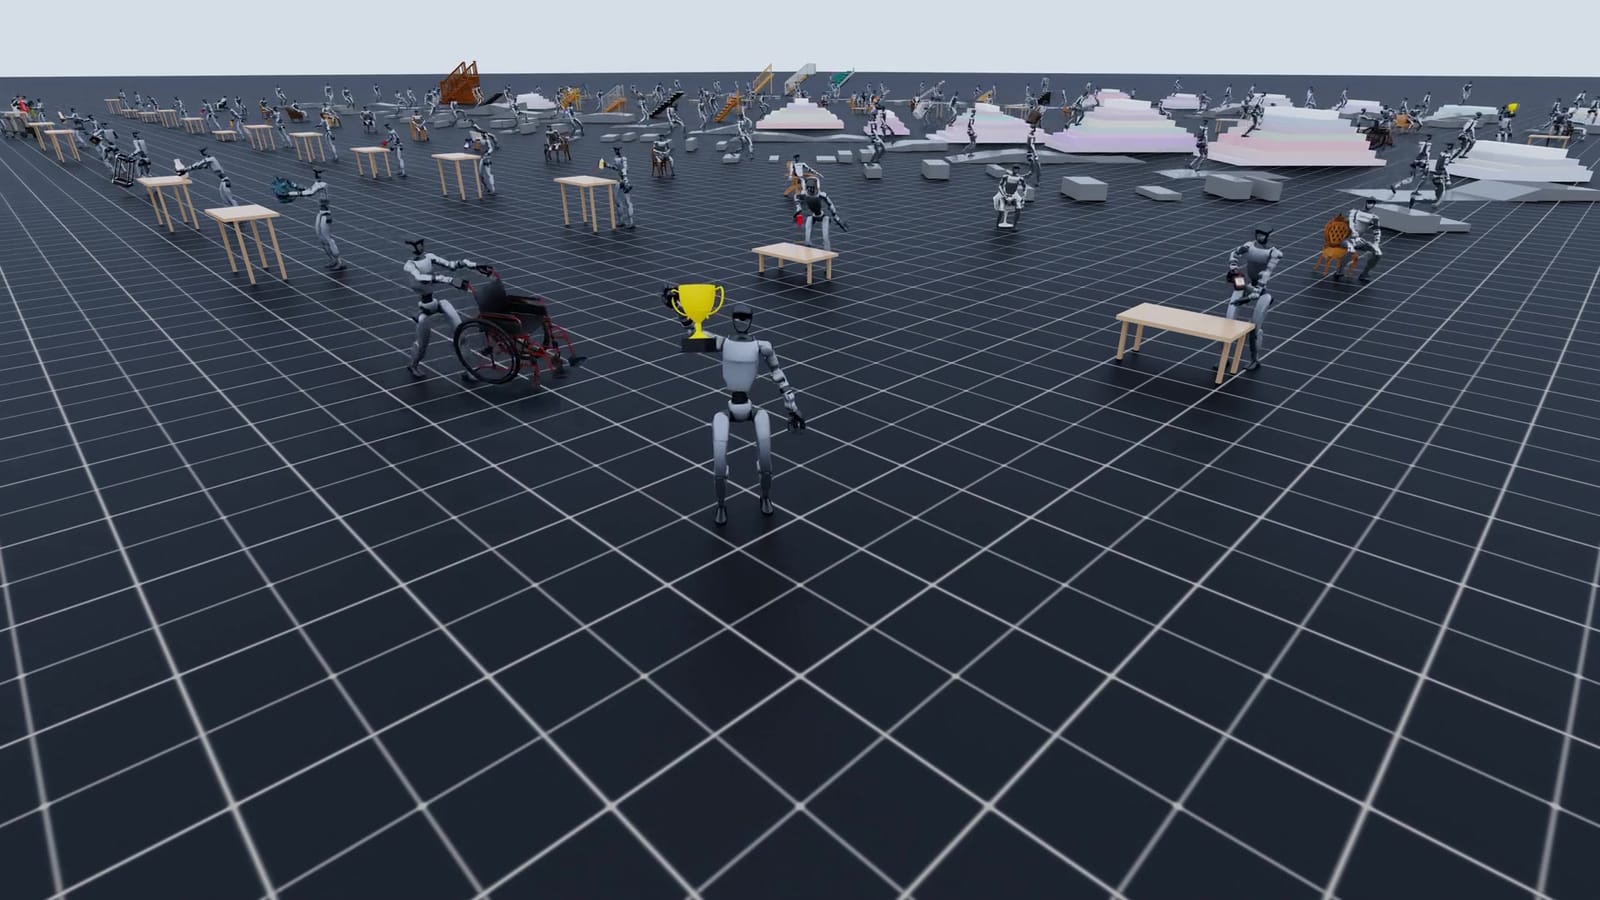
HALO (Perceptive Humanoid Motion from Simulation)
シミュレーション上の1,000軒の仮想住宅だけで学習し、ヒューマノイドロボット(Unitree G1)が本物の家で座る・くぐる・押すを自律実行する研究。データ生成から学習、実機配備までのコードを公開している。
Apple(apple-aiml-research) / GitHub
#Motion/Body#AI/Agents
Vork
AIエージェントがコードでシーンを書き、GPUで描画して結果を見て修正するための、画面を持たない3D・VFXエンジン。Rust製で、Windows・Linux・Macで動く。
Voyager(Nullframe, Inc.) / GitHub
#Spatial/3D#CreatorTools#AI/Agents
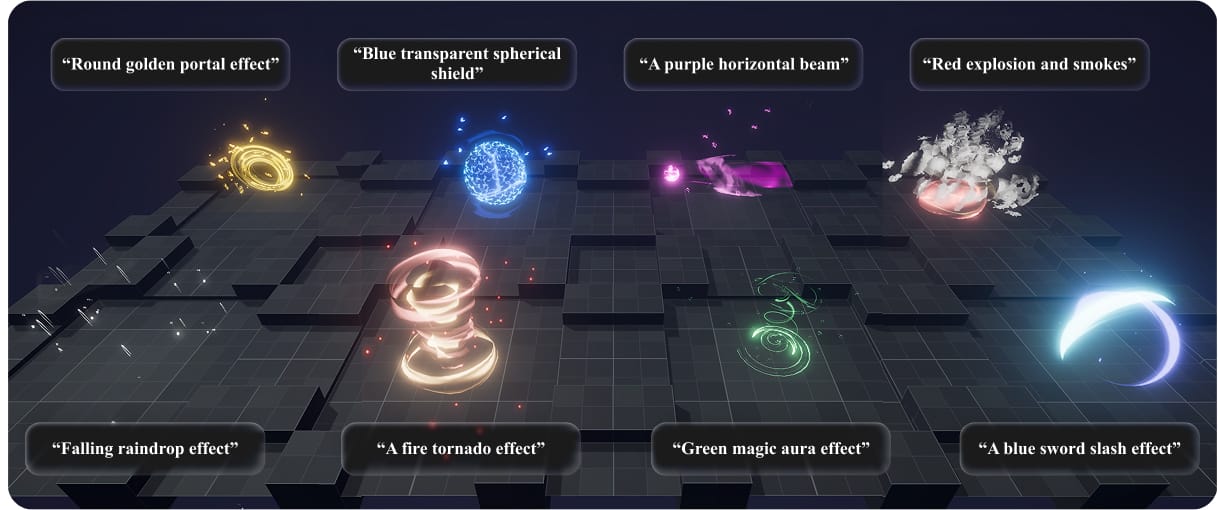
SpeLL
「炎の竜巻」「剣の斬撃」といった文章から、Unity上で後から調整できる3D VFX(視覚効果)の下書きを作る研究。UIST 2026採択。
GIST HCIS Lab(Jeongseok Oh, SeungJun Kim) / GitHub
#CreatorTools#AI/Agents#GenVideo
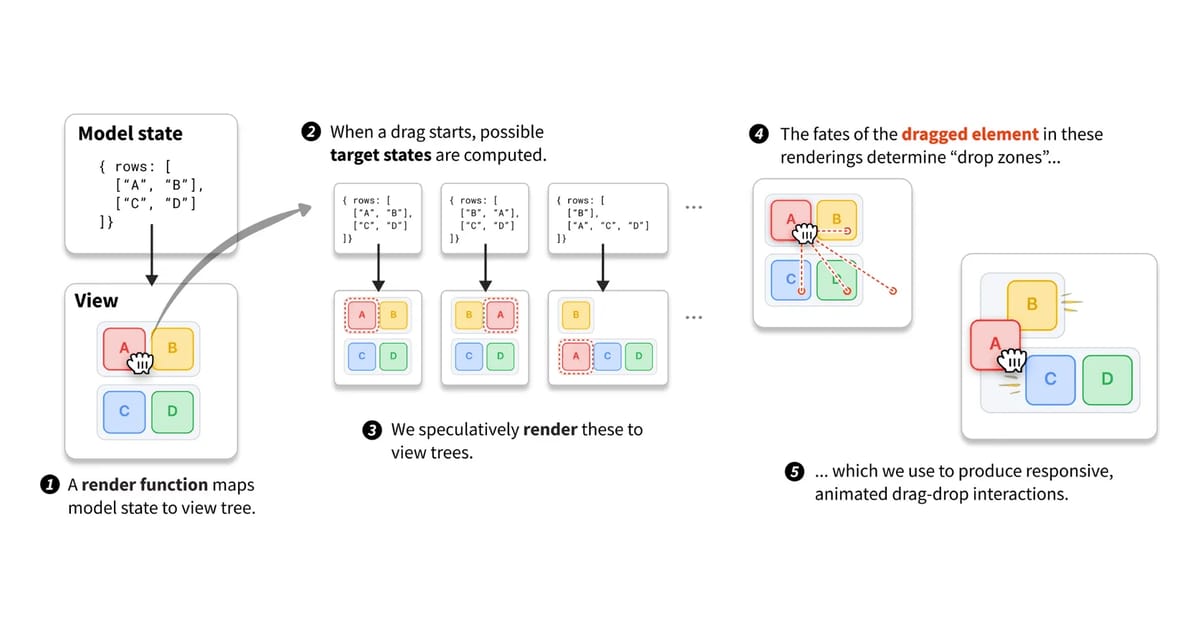
Declarative Dragging(Dragology)
「ドラッグしたらどの状態に変わるか」だけを書けば、滑らかなドラッグ操作が自動で作れるWebライブラリ。UIST 2026のBest Paper受賞。
Joshua Horowitz, Andrew Blinn, Jeffrey Heer(UIST 2026 Best Paper) / GitHub
#HCI/MediaArt#CreatorTools
Mirror Skin
ロボットの皮膚に「これから触れる人の体の部位」を映し出し、いつ・どこに触れるかを事前に知らせる表示手法。UIST 2026採択。
Saarland University Human Computer Interaction Lab(David Wagmann, Matti Krüger, Chao Wang, Michael Gienger, Jürgen Steimle)
#HCI/MediaArt#Motion/Body
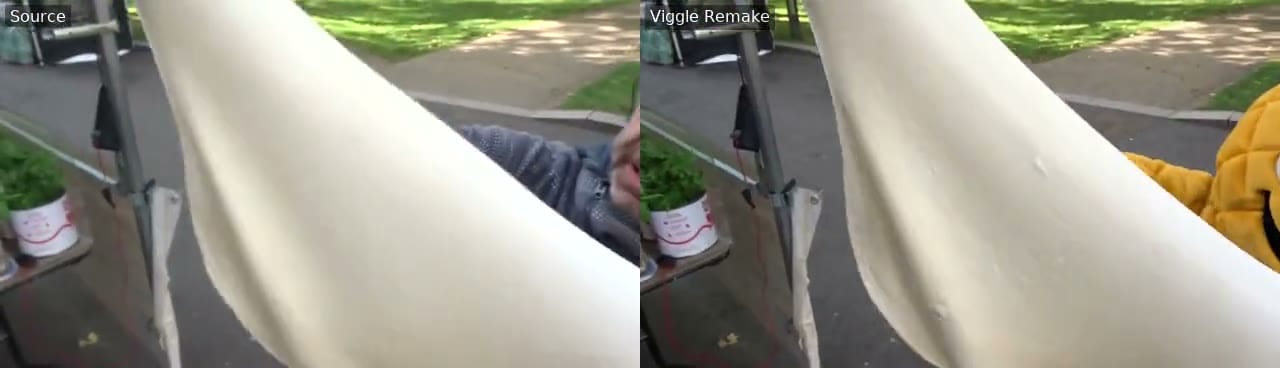
Viggle Remake
撮影済みの映像を、人物や物・背景・天候・照明だけ差し替えて「撮り直し」できる動画編集モデル。Viggle が MiniMax H3 向けの LoRA(既存モデルに後付けする追加学習ファイル)として公開した。
Viggle AI
#GenVideo#CreatorTools
H3 Continuity Studio (ComfyUI-H3-Continuity-Studio)
MiniMax H3 の動画クリップを時間軸(タイムライン)に並べて複数ショットの映像を作る ComfyUI 用ノード群。カットをまたいで部屋や衣装を保つ「視覚の記憶」機能を持つ。
KadoBOT / GitHub
#GenVideo#CreatorTools
H3 Ripple (ComfyUI-WepeNerd)
Photoshop などで手直しした1〜2枚のフレームの変更を、動画のショット全体へ波及させる MiniMax H3 用 LoRA と ComfyUI ノード。
WepeNerd / GitHub
#GenVideo#CreatorTools
StarLightGS
Gaussian Splat(3Dスキャンの点群的な表現)をUnreal Engine 5のライトで照らし直せるようにする、オープンソースのUE5.7+プラグイン。
CoSTAR National Lab / GitHub
#Spatial/3D#CreatorTools
GaussianRenderFormer
Gaussian Splatをラスタライザ(従来の描画エンジン)なしで、Transformerだけで画像に描画する研究。コードと学習済み重みが公開済み。
SVLwoof (アカデミア研究チーム) / GitHub
#Spatial/3D
Solv3R
ループ型Transformerで、複数枚の写真・映像から3D形状を、一括・逐次・ストリーミングのいずれでも復元できる研究。推論コードと重みが公開された。
UBC Vision (University of British Columbia) / GitHub
#Spatial/3D
Kiteva (motion-graphics-agent)
文章で書いたアイデアと参考素材から、モーショングラフィックス主体の短編映像(最長5分・1080p/1440p)を作るローカル動作のエージェントアプリ。企画案の作成から3秒のプレビュー、本編レンダリング、編集用データの書き出しまでを1つの画面で進められる。
delexw(個人開発・Yang Liu) / GitHub
#CreatorTools#AI/Agents#GenVideo
TopX
骨格ファイル(BVH)だけを渡せば、未知のキャラクターでもテキストから動きを生成できるモデル。4〜117関節の骨格に1つのモデルで対応する。
Tengjiao Sun ほか(Hansung Kim 研究グループ) / GitHub
#Motion/Body#AI/Agents
Open Bot Avatar
AIエージェントの「顔」となるキャラクターを、SVGパス1本と目の位置だけで定義し、立体感のある目線追従アニメーションとして表示するOSSとエディタ。
Dominik Scholz / GitHub
#AI/Agents#CreatorTools
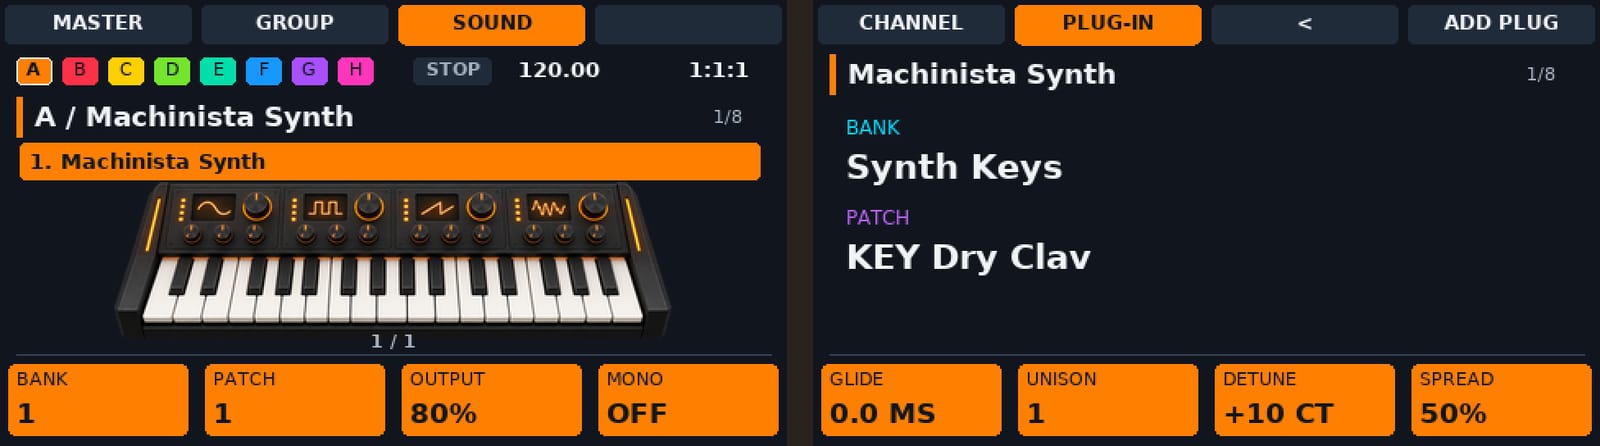
Machinista
Native Instruments の Maschine コントローラー(Mikro/MK1/MK2/MK3/Maschine+)を、Raspberry Pi 4/5 につなぐだけでパソコン不要の単体音楽制作機に変えるオープンソースのファームウェア兼アプリ。
photogeen(個人開発) / GitHub
#Audio/Music#HCI/MediaArt
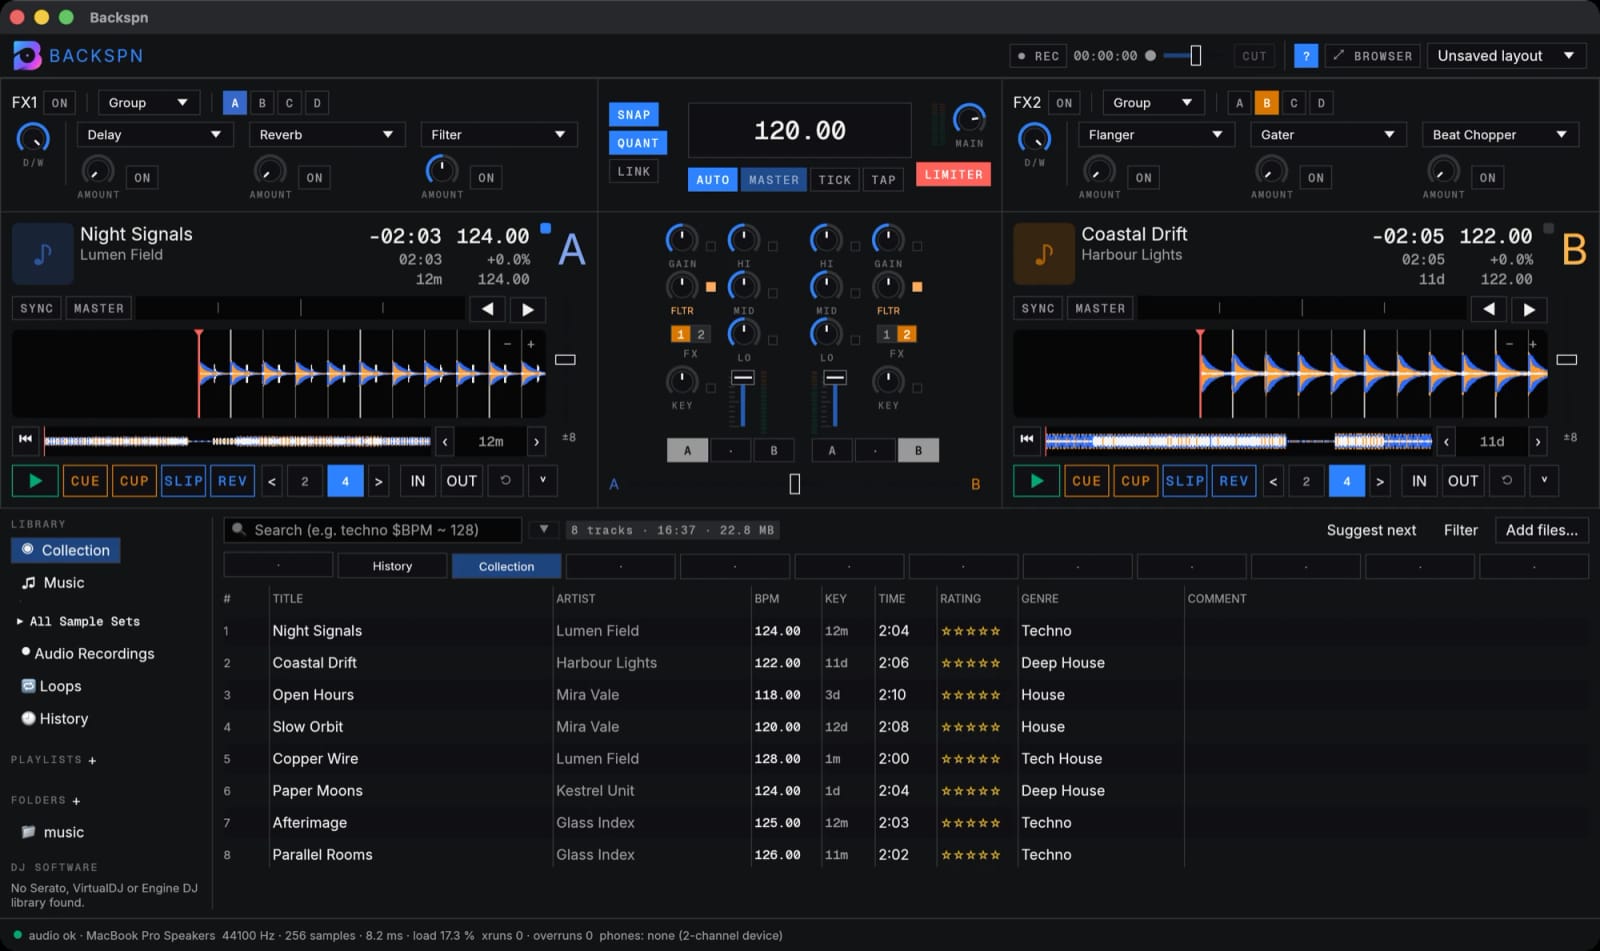
Backspn
ステム分離(ドラム・ベース・ボーカル等に分解)、74種のビート同期エフェクト、あらゆる MIDI/HID コントローラー対応を備えた、Rust 製の無料オープンソース DJ ソフト。
suitux(個人開発) / GitHub
#Audio/Music#CreatorTools
SimLlama(Similarity-Label Conditioning for Game Music Generation)
ゲーム音楽の「テーマ曲」に対して、どれくらい似せるか(high/mid/low)をラベルで指定して、続きの楽曲セクションをMIDIで生成するAI。コード・学習済み重み・試聴デモが公開されている。
Centre for Digital Music, Queen Mary University of London / GitHub
#Audio/Music
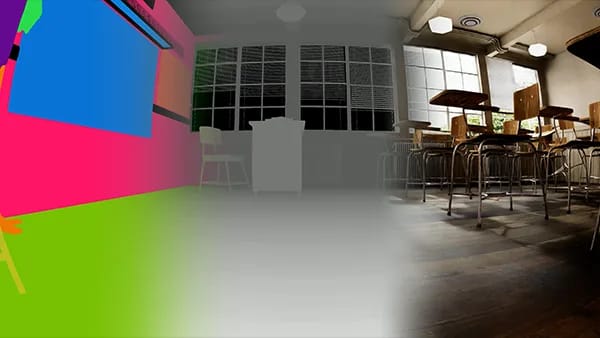
ComfyUI Motion Previs Studio
3D空間でキャラ・カメラ・ライトを配置して動画生成AI用のプリビズ素材(骨格・深度・マスク・カメラ行列)を書き出すローカルのデスクトップ/Webツール。プロンプトを書くのではなく「ショットを演出する」発想。
navarisun1982(個人開発) / GitHub
#GenVideo#CreatorTools#Spatial/3D
ComfyUI-Tessera
MiniMax H3を使い、544p程度の動画を2K〜8Kへ、タイル・チャンク分割で一般向けGPU1枚でも処理できるようにしたComfyUIの動画アップスケーラー。
hashu786(個人開発) / GitHub
#GenVideo#CreatorTools
ARROW (Arbitrary Reconstruction and Tracking of 4D Observations in the Wild)
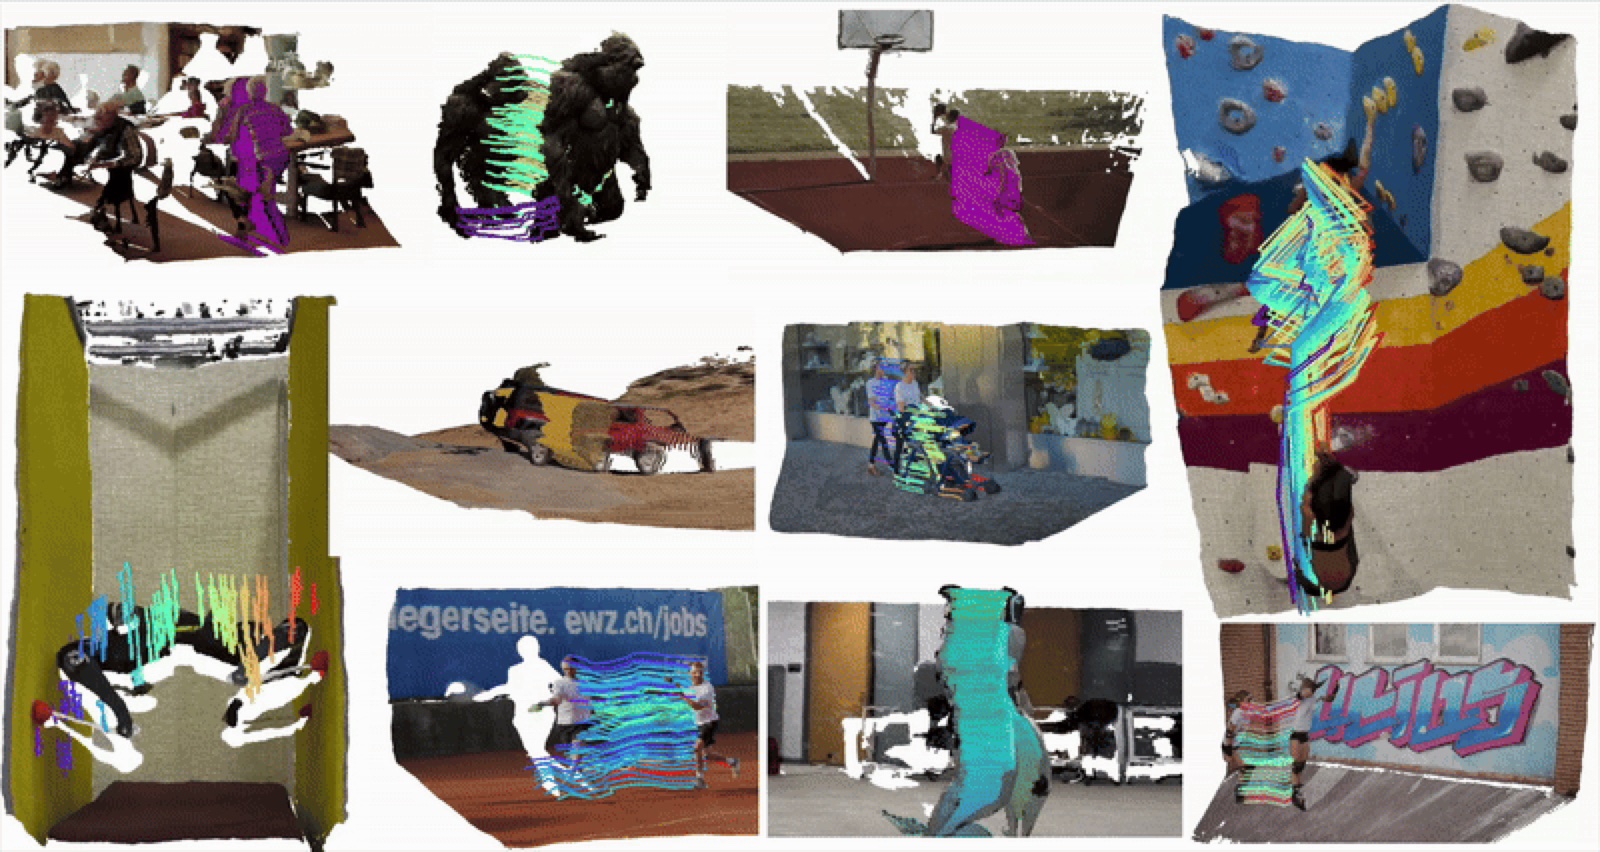
写真の束、動くカメラの動画、複数カメラの映像のどれを入れても、3D形状の復元と「画面上の点が3D空間のどこへ動いたか」の追跡を1つのモデルで行う研究。推論コード・重み・ブラウザ用ビューアが公開されている。
RWTH Aachen University (Computer Vision Group) / GitHub
#Spatial/3D#Motion/Body
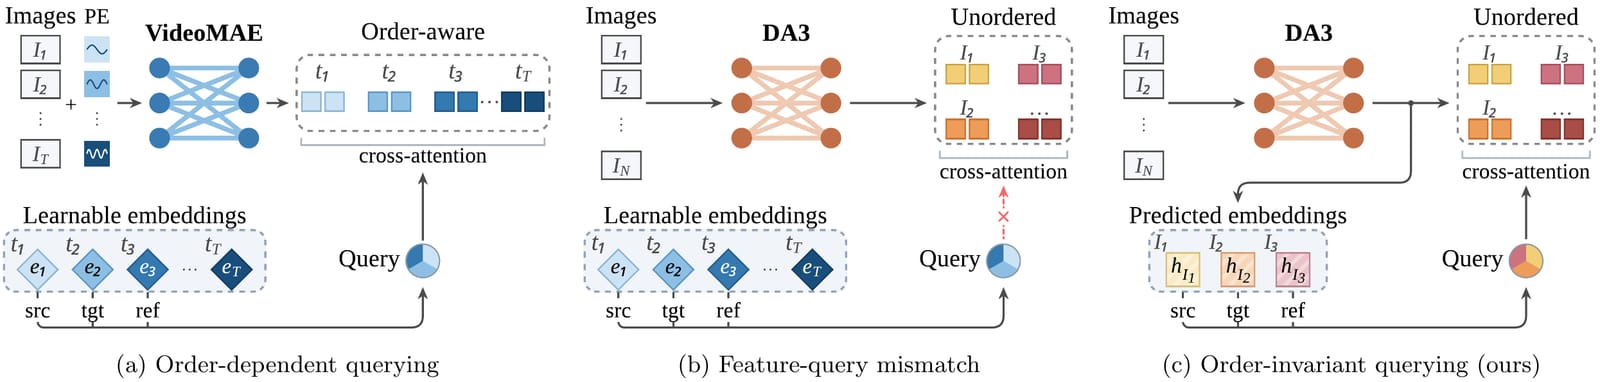
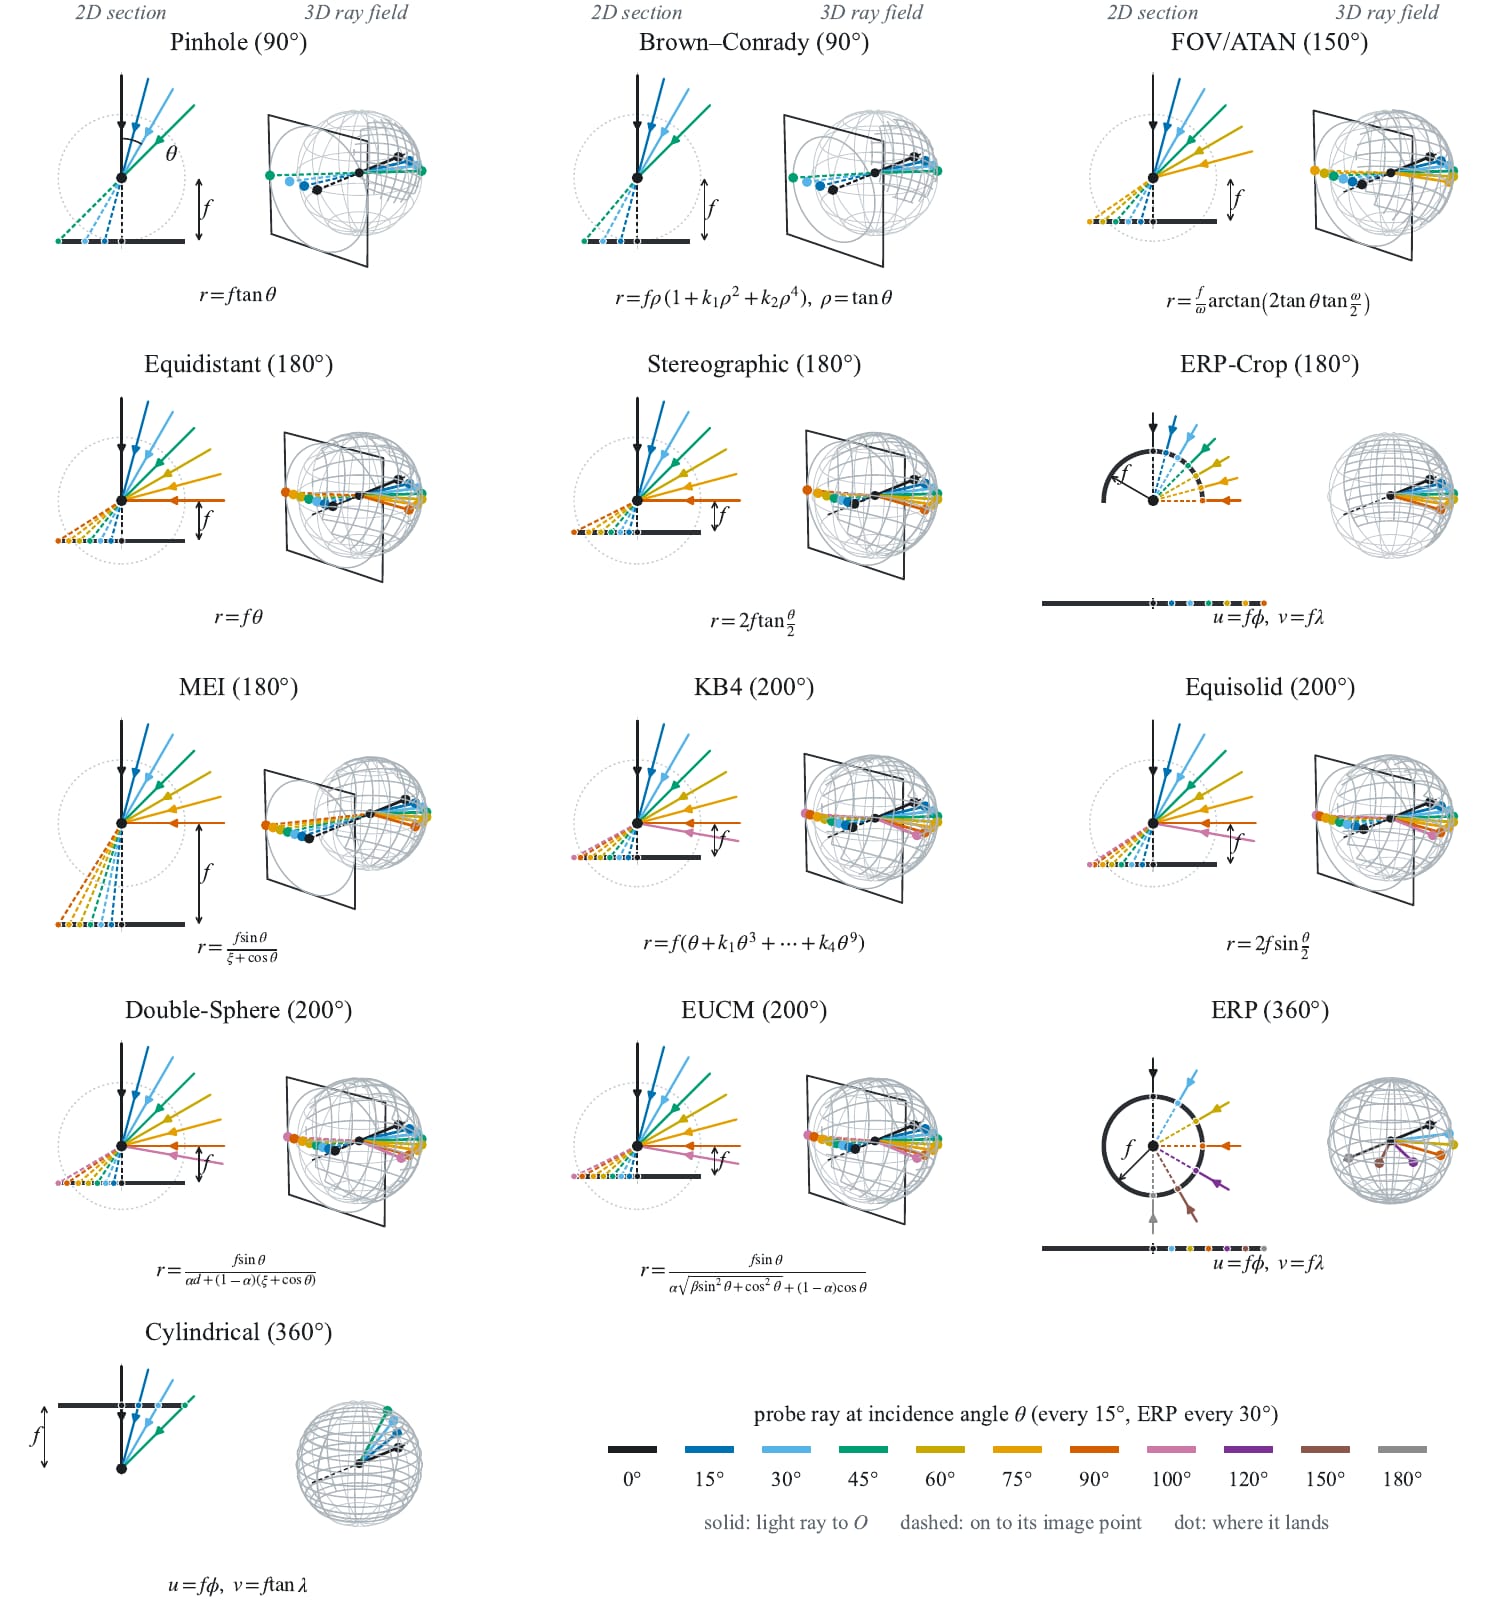
Any3R
ピンホール、魚眼(180度超)、360度パノラマなど、種類の異なるカメラの画像を混ぜて入れても、1回の処理でカメラ位置・深度・3D点群を出す3D復元モデル。推論・評価コードと重み、Gradioデモが公開されている。
Jingong Chen ほか(研究チーム) / GitHub
#Spatial/3D
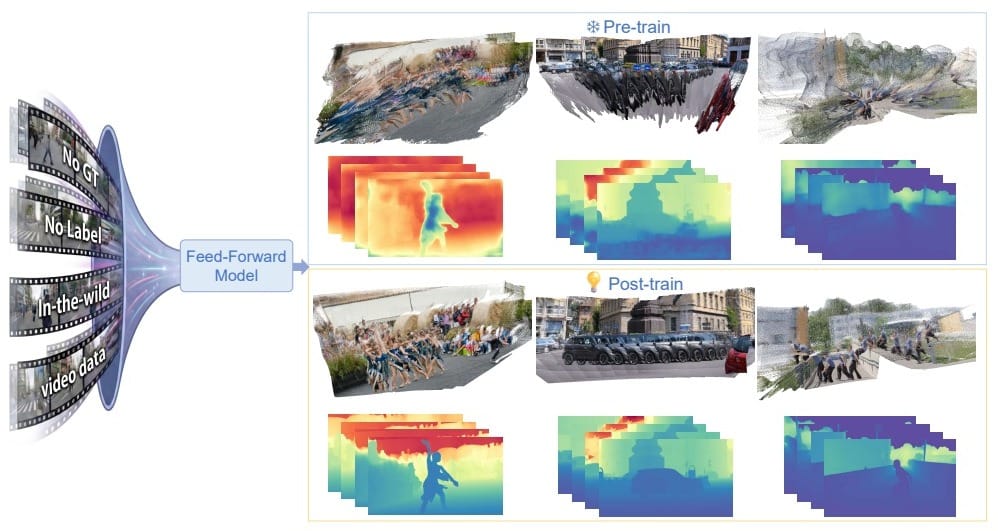
PURE (Refining Feed-forward 3D Reconstruction with Unlabeled Post-training)
既存の3D復元モデル(Pi3・Depth Anything 3・VGGT)を、正解データなしの普通の動画だけで追加学習し、動く被写体を含む場面でも精度を上げる手法。コード・重み・Hugging Faceデモが公開されている。
Yaolong Zhu, Yuan Liu ほか(ACM Multimedia 2026 採択) / GitHub
#Spatial/3D#Motion/Body
SculptForge
ZBrush代替をうたう無料のオープンソース彫刻アプリ。0.9.0で、スマホ動画や写真から手元のPCだけでGaussian Splatを学習し、ワンクリックで彫刻できるメッシュに変換する機能が入った。
islandmed / SculptForge contributors / GitHub
#Spatial/3D#CreatorTools
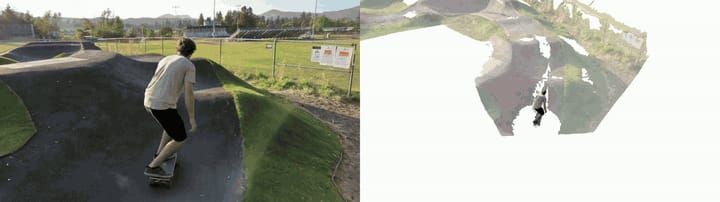
ReLift (Dense 3D Tracking as Lifted Trajectory Repair)
普通の動画1本から、映っている全ピクセルが3D空間でどう動いたかを追跡するモデルです。壊れた軌跡を直す小さな補正モデルで精度を上げています。
Technion / NVIDIA / GitHub
#Spatial/3D#Motion/Body
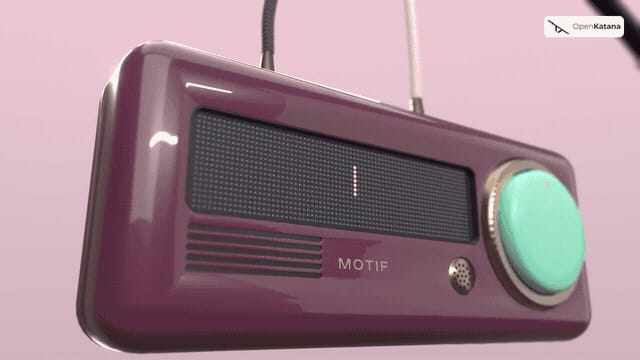
OpenKatana
Claude Code や Codex などの AI エージェントが「動画編集者」として使える、オープンソースの編集エンジン。カット割り・速度変化・3D・文字アニメ・音楽を1つのプロジェクトにまとめ、手元の PC で書き出す。
rk0neki(個人開発・Comfy Developer Platform 上に構築) / GitHub
#AI/Agents#CreatorTools#GenVideo
anymove
AI動画1本から、ドラゴンや蜘蛛などあらゆる「人間以外」のリグ付きキャラのアニメーションを作り、GLBで書き出すモーションキャプチャ手法とツール一式。
Patch (Patch-gg) / GitHub
#Motion/Body#GenVideo#CreatorTools
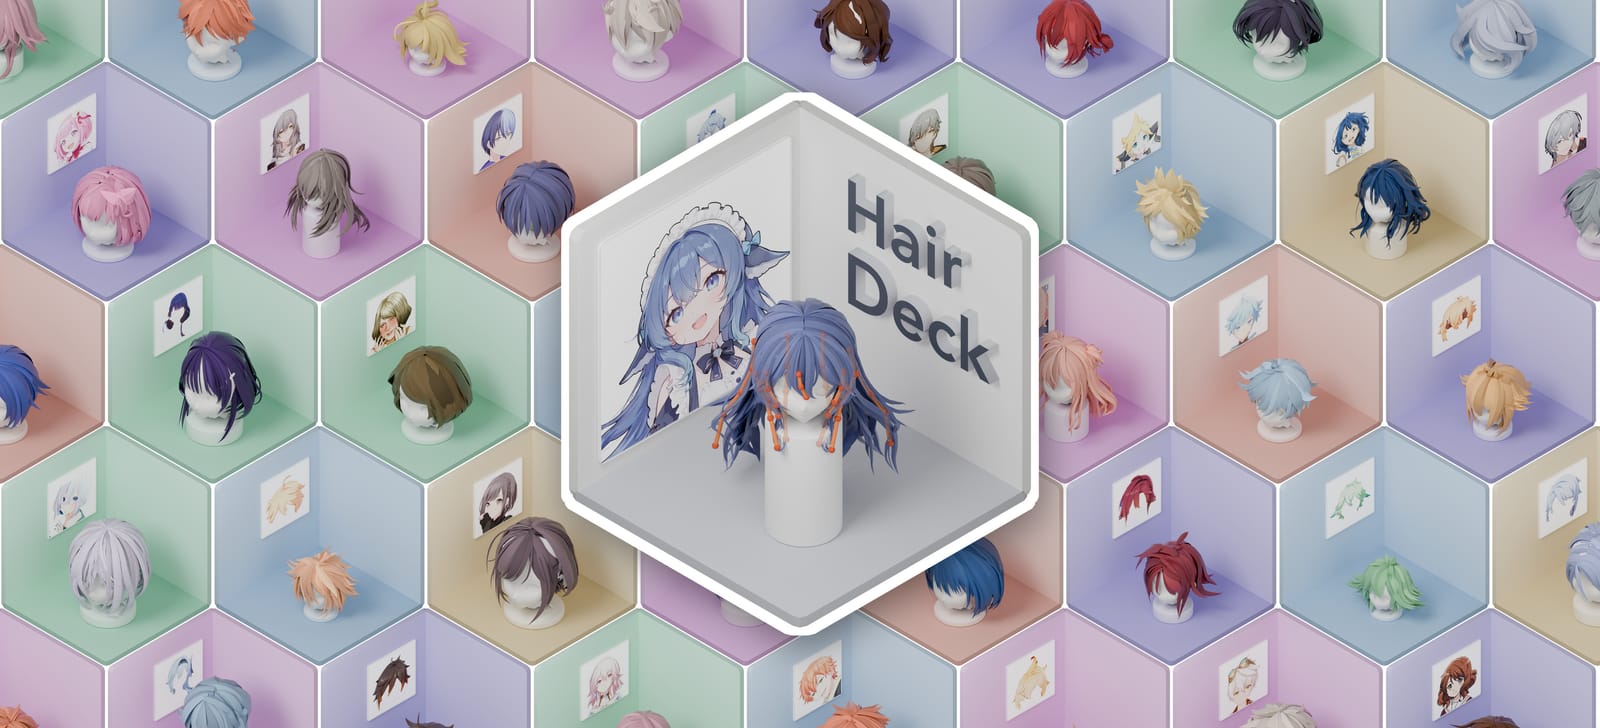
HairDeck
1枚の画像から、ゲームやアバター用の「ヘアカード」(髪の毛束を表す板状メッシュ)と、それを揺らすスプリングボーンを同時に生成する。VRMでも書き出せる。
hyz317(研究グループ) / GitHub
#Motion/Body#Spatial/3D#CreatorTools
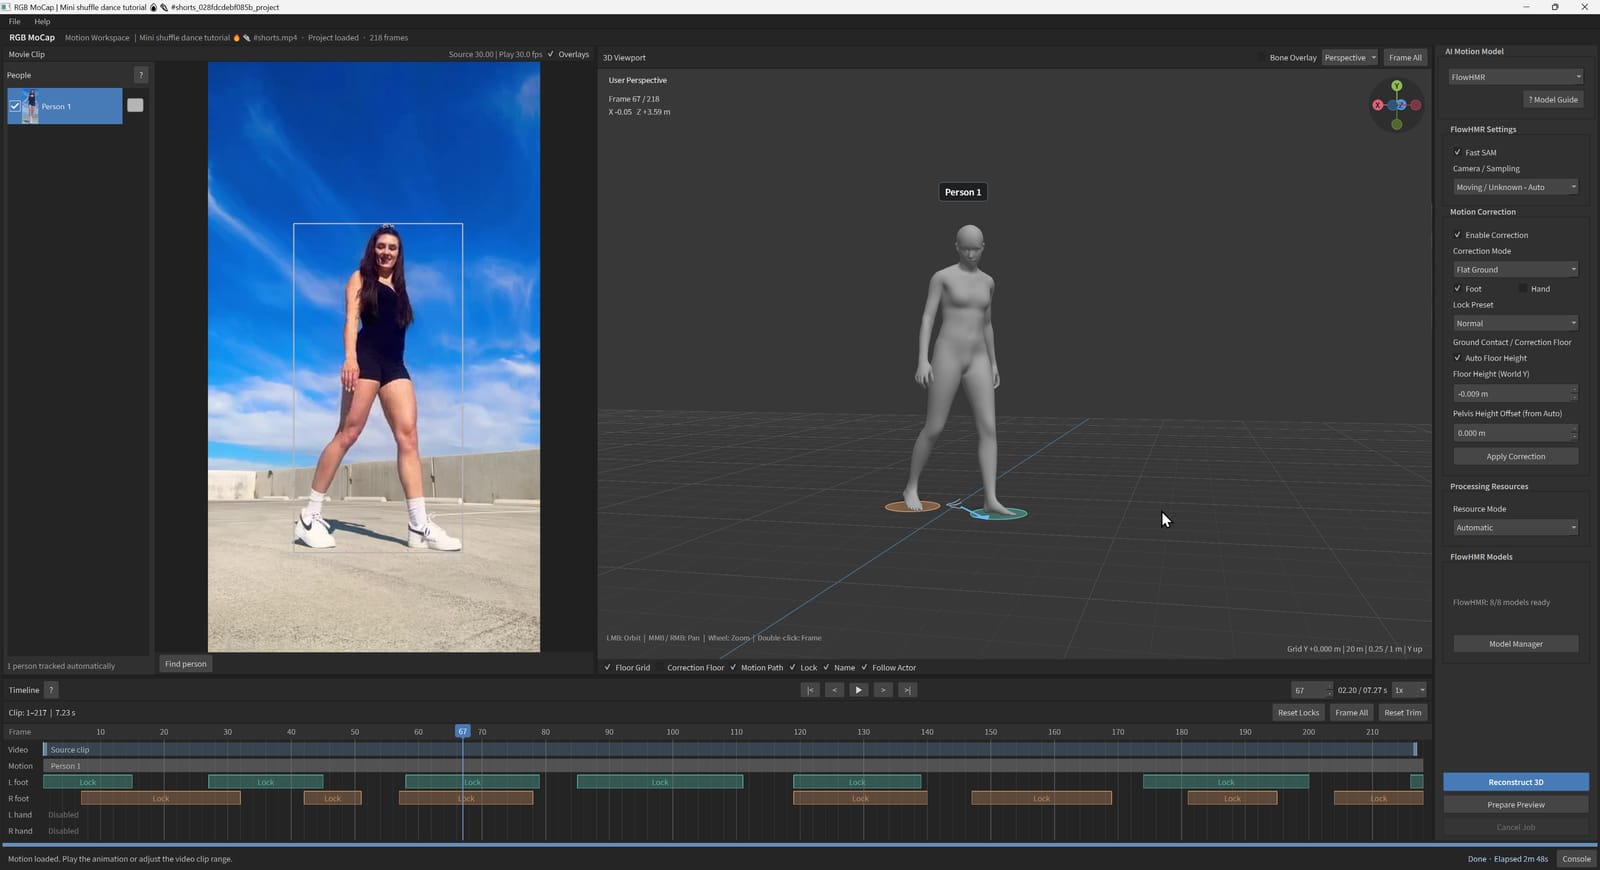
RGB MoCap(toyxyz_RGBMocap)
通常の動画から人物のモーションを取り出し、ミキサモ(Mixamo)・VRM・PMXキャラへ移して、FBXやVMDで書き出せるWindows用アプリ。処理はすべてローカルのAIで行う。
toyxyz / GitHub
#Motion/Body#CreatorTools
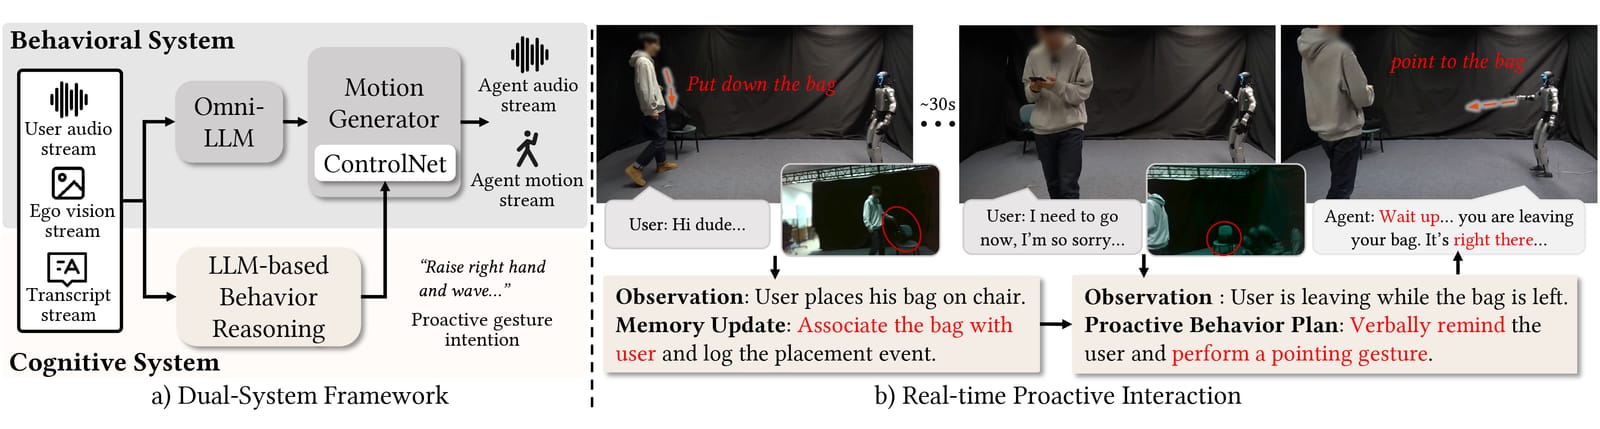
ProAct
人と話しながら、声と身ぶりをリアルタイムに生成し、記憶や状況判断をもとに自分から話しかけるヒューマノイドロボット向けの対話システム。コードは2026-10-31に公開された。
ProActRobot(SIGGRAPH Asia 2026 Journal Track採択論文) / GitHub
#AI/Agents#Motion/Body#HCI/MediaArt
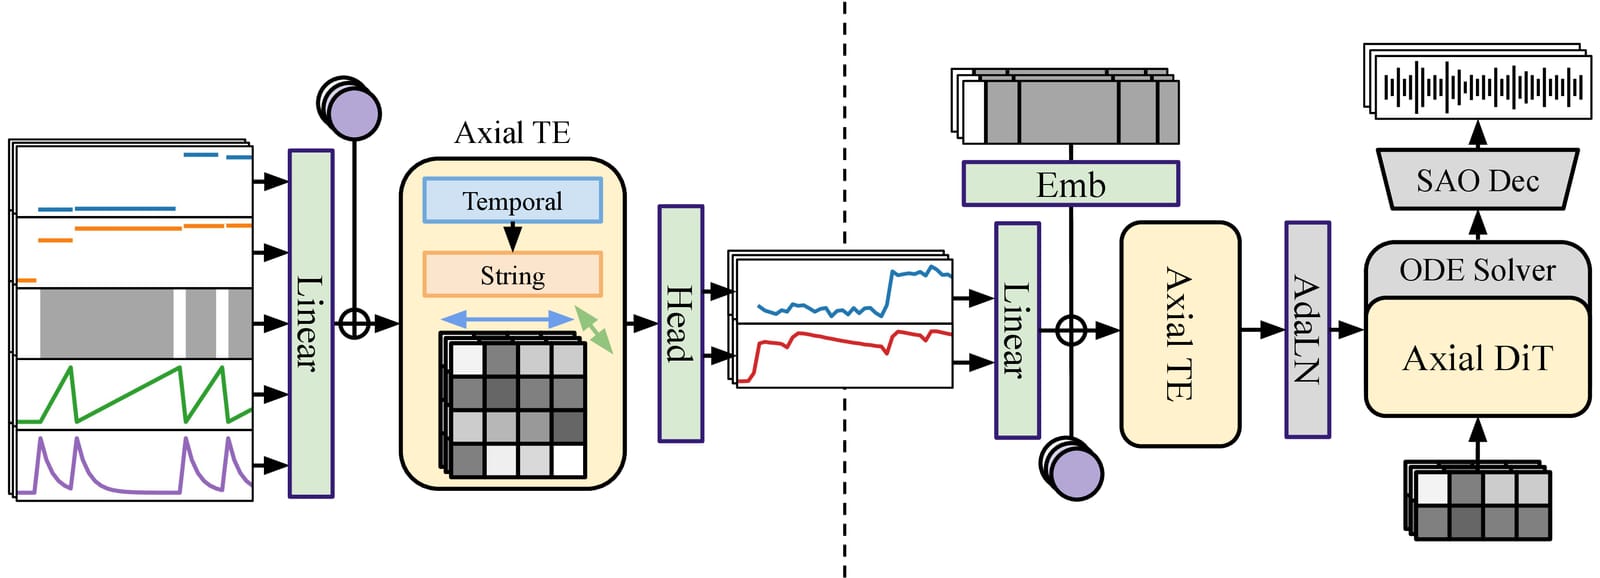
JIT-MPE (Just-in-Time Multi-Pitch Estimation)
ライブ演奏の音から「今どの音が鳴っているか」を20ms刻みで即座に推定し、あとから修正していく軽量AI。CPU1スレッドで動き、コードと重みも公開されている。
Yoshiyuki Kobayashi (Frieve-A) / GitHub
#Audio/Music#HCI/MediaArt
Ctrl-LFM Guitar Synth (Expressive Guitar Synthesis via Controllable Latent Flow Matching)
楽譜(MIDI)から6弦ギターの演奏音を作るAIで、弦ごとの音程と音量の曲線を先に作って編集できる。コード・チェックポイント・試聴デモが公開されている。
Hsueh-Wei Fu, Yen-Tung Yeh, Yi-Hsuan Yang(所属は未記載) / GitHub
#Audio/Music
CapAura
導電性の家具(金属の机や椅子など)をそのまま「電気を感じるセンサー」として使い、カメラも装着機器も無しで部屋の中の人の姿勢や動きを推定する研究(UIST 2026)。
慶應義塾大学 KMD(南澤研)ほか(Jianan Zhang, Kohei Kobayashi, Hideaki Nii, Kouta Minamizawa ら) / GitHub
#HCI/MediaArt#Motion/Body
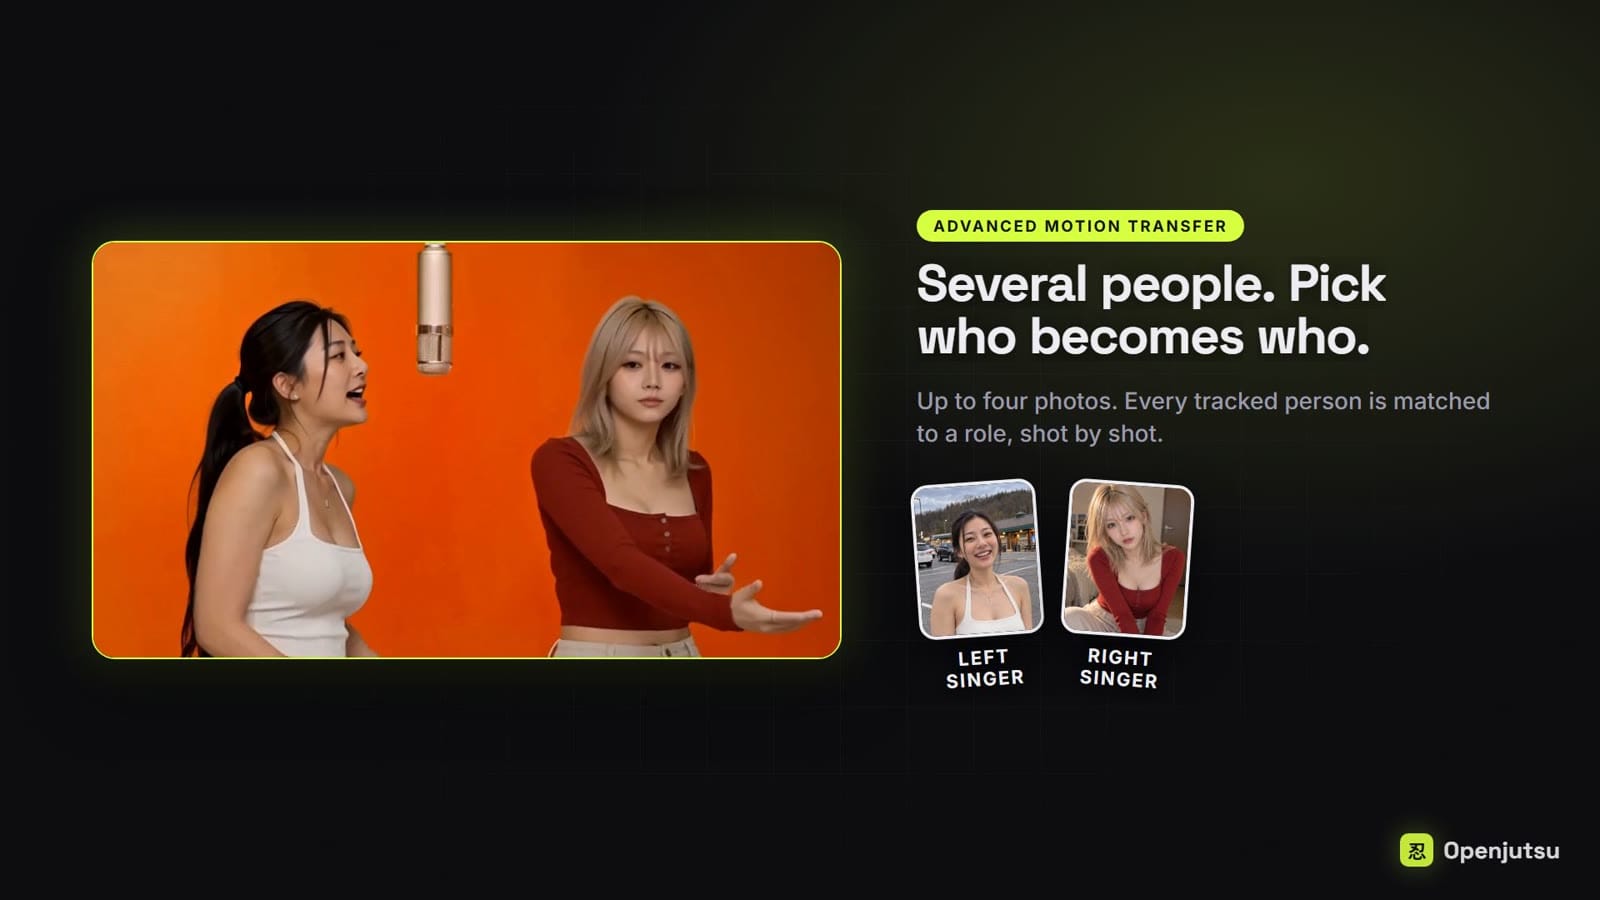
Openjutsu
動画と1枚のキャラクター写真を渡すだけで、動画の主役をそのキャラクターに差し替える完全ローカルのツール。髪や服の変更、物体の削除、背景の変更にも対応する。
D3voz(個人開発者) / GitHub
#GenVideo#CreatorTools
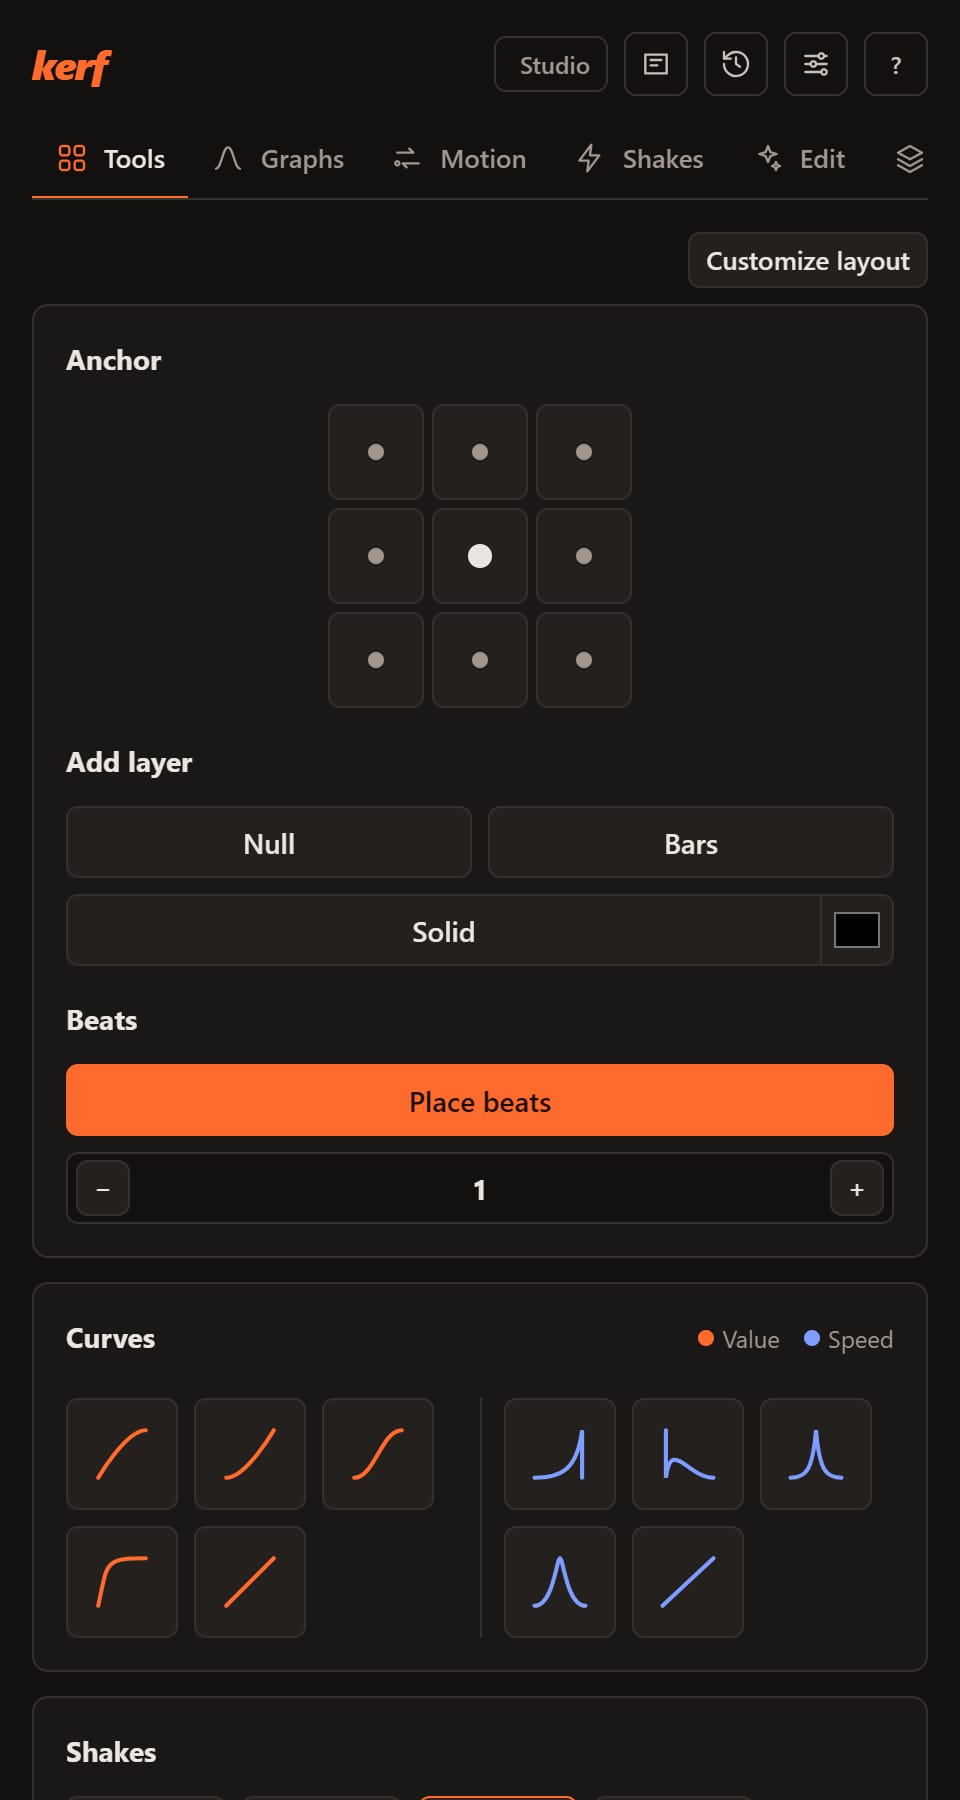
Kerf
Premiere Pro・After Effects・DaVinci Resolve の画面内で動く、無料のオープンソース編集支援ツールキット。無音カット、字幕、194種のテンプレート、手ぶれ補正、AI切り抜きなどを備える。
kamalivaturi(個人開発者) / GitHub
#CreatorTools#GenVideo
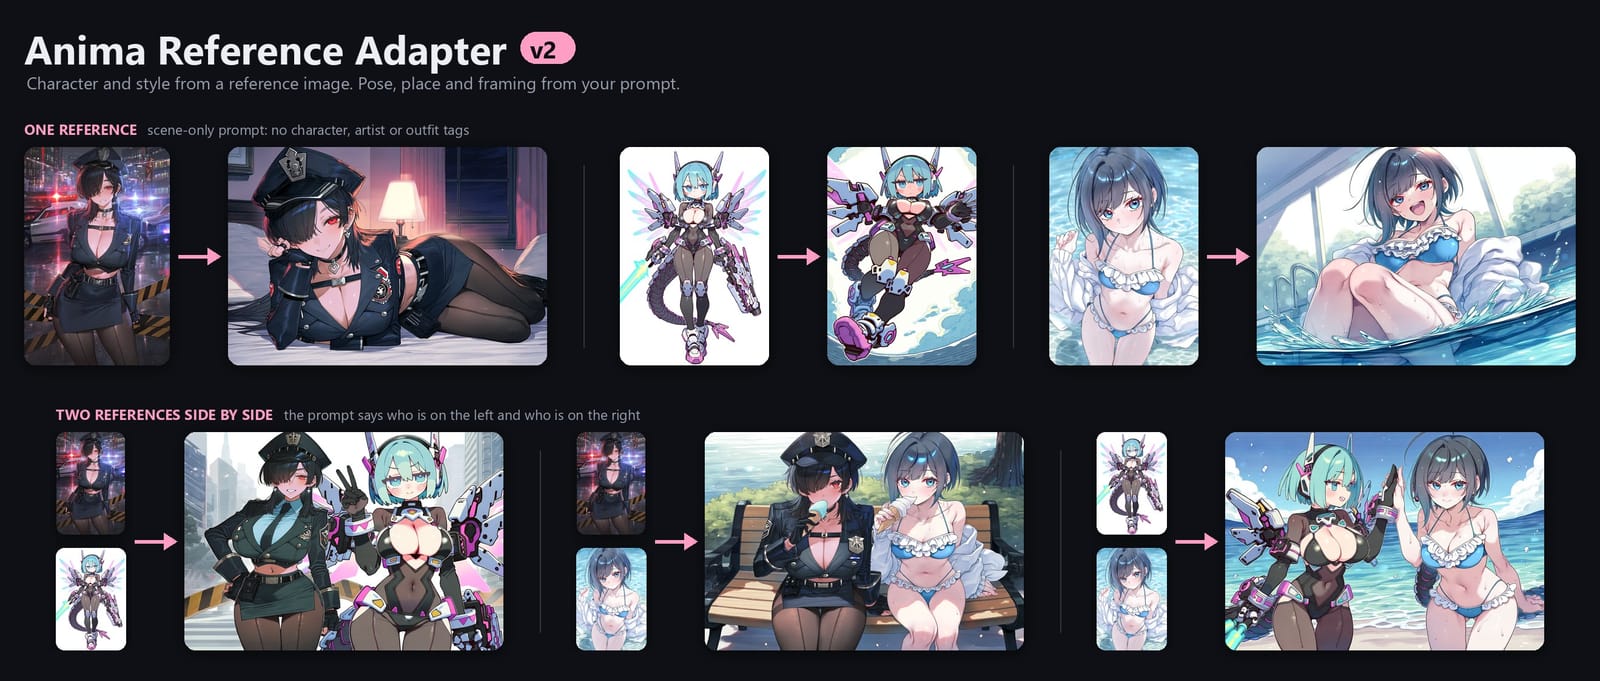
Anima Reference Adapter (ComfyUI-Anima-Ref-Adapter)
アニメ系画像モデル Anima に、参照画像を1枚渡すだけで、キャラクターと画風を保ったままポーズ・背景・構図をプロンプトで変えられる ComfyUI 用アダプター。
ElectronGirl(個人開発者) / GitHub
#CreatorTools#GenVideo
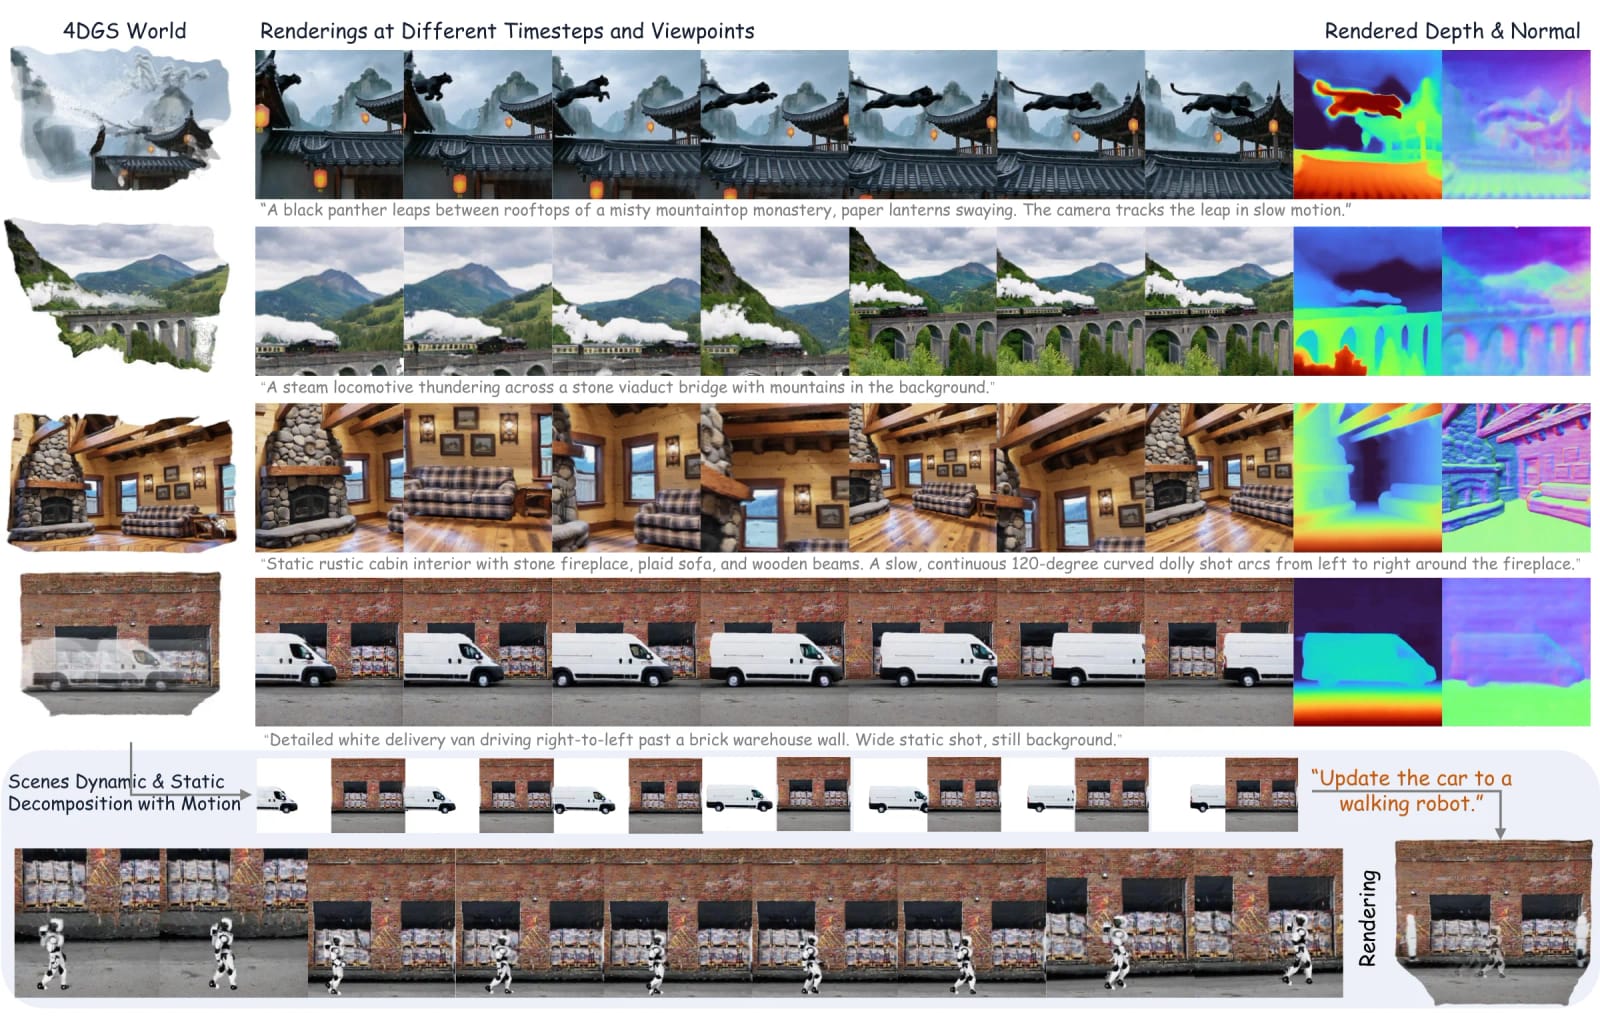
AEON
テキストや1枚の画像から、動画ではなく「あとから自由な角度で見られる4Dの世界」(動く3D空間)を直接生成する世界モデル。
Tsinghua University (Weiqi Zhang ら) / GitHub
#Spatial/3D#GenVideo
ComfyUI-SpEdE (Splat Edit Engine)
Gaussian Splat(3Dスキャン)のシーン内でオブジェクトをクリックし、削除・差し替え・切り出しができるローカル実行のComfyUIノード群。
Burgstall-labs / GitHub
#Spatial/3D#CreatorTools
Gaussian Splat to Blender Nodes (World to World Mapping)
Gaussian Splatで撮ったシーンを、AIエージェントと一緒にBlenderの編集可能なジオメトリノードとシェーダに作り直すスキル/ツールキット。
gokayfem / GitHub
#Spatial/3D#CreatorTools#AI/Agents
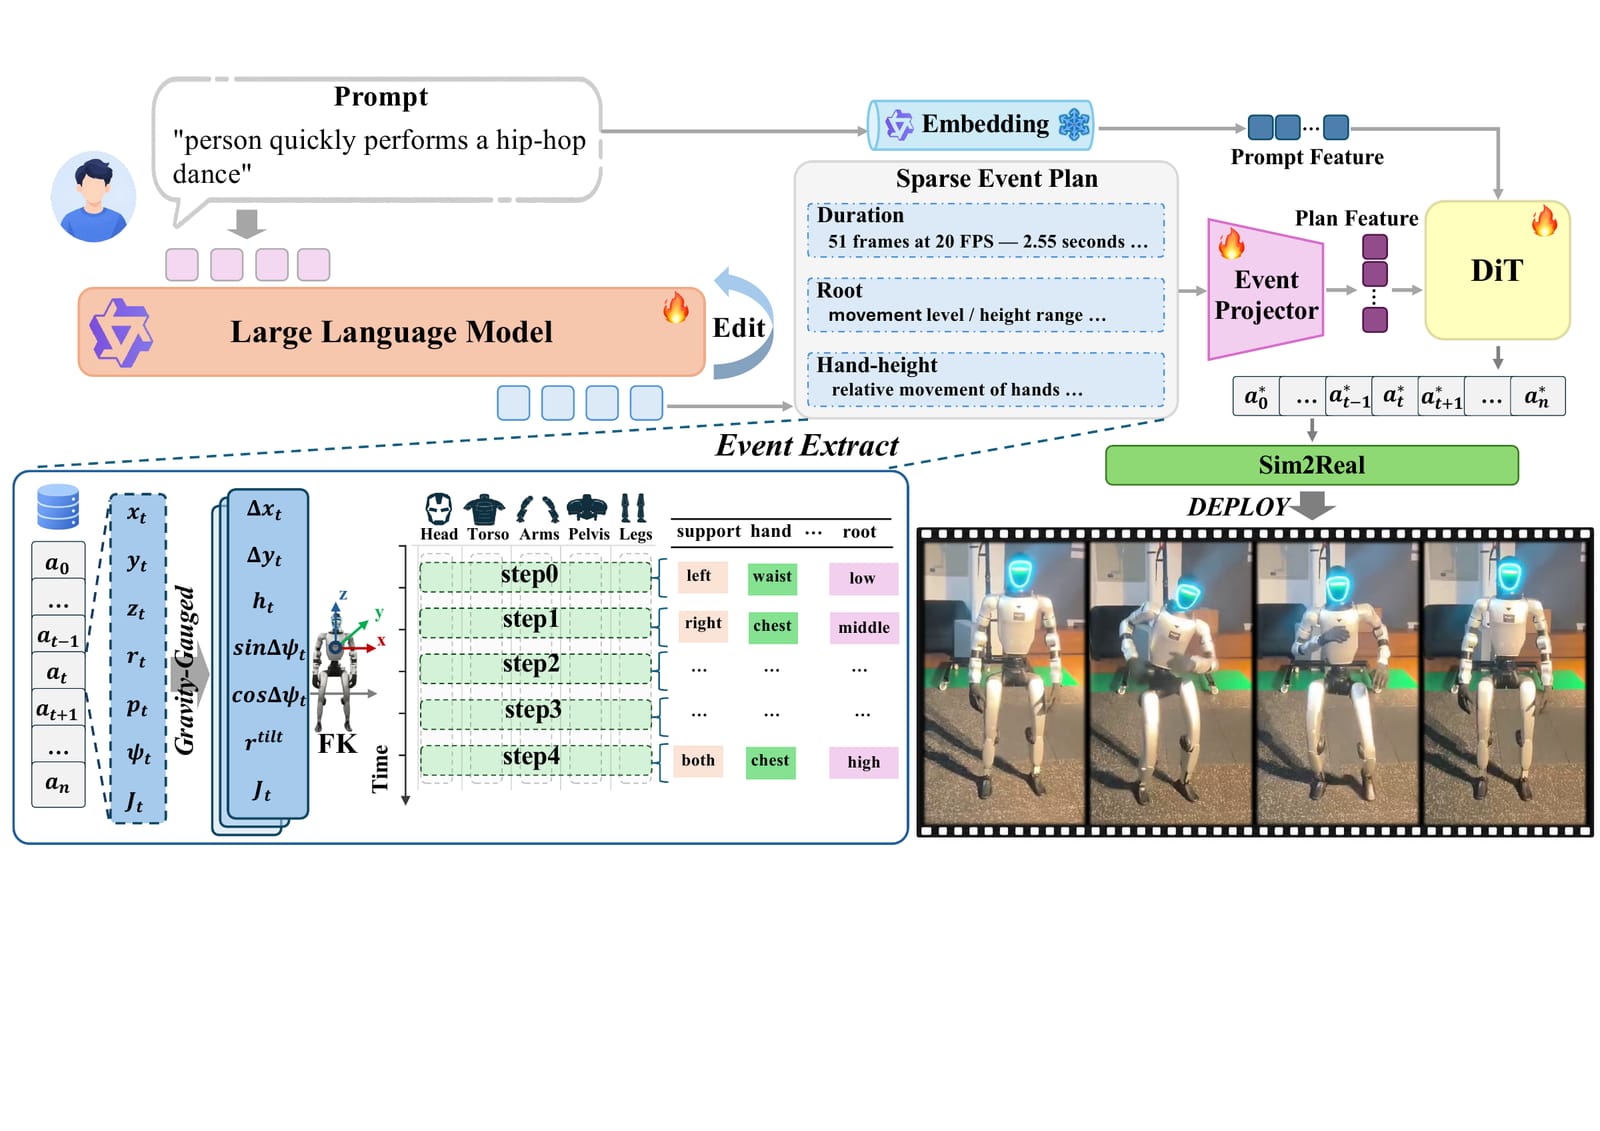
TRACE (Typed Reference-Aware Conversational Editing for Humanoid Motion Diffusion)
「もう少し深くお辞儀して」のような会話で、人型ロボット(Unitree G1)の動きを文章から作り、そのまま手直しできるモーション生成・編集システム。
Multimodal-Perception-Action(Zejian Kang ほか) / GitHub
#Motion/Body#AI/Agents
Context-Aware Generation and Modulation of Expressive Motion Behavior (gen-mod-expressive-motion-behavior)
文章・画像・音声から「その場の状況に合った表情豊かなジェスチャー」をロボットに生成し、感情の強さなどをリアルタイムに調整できる、基盤モデル活用のモーション生成システム。
Till Hielscher, Scaparro, Arras(Univ. of Stuttgart ロボティクス研究グループ) / GitHub
#Motion/Body#AI/Agents#HCI/MediaArt
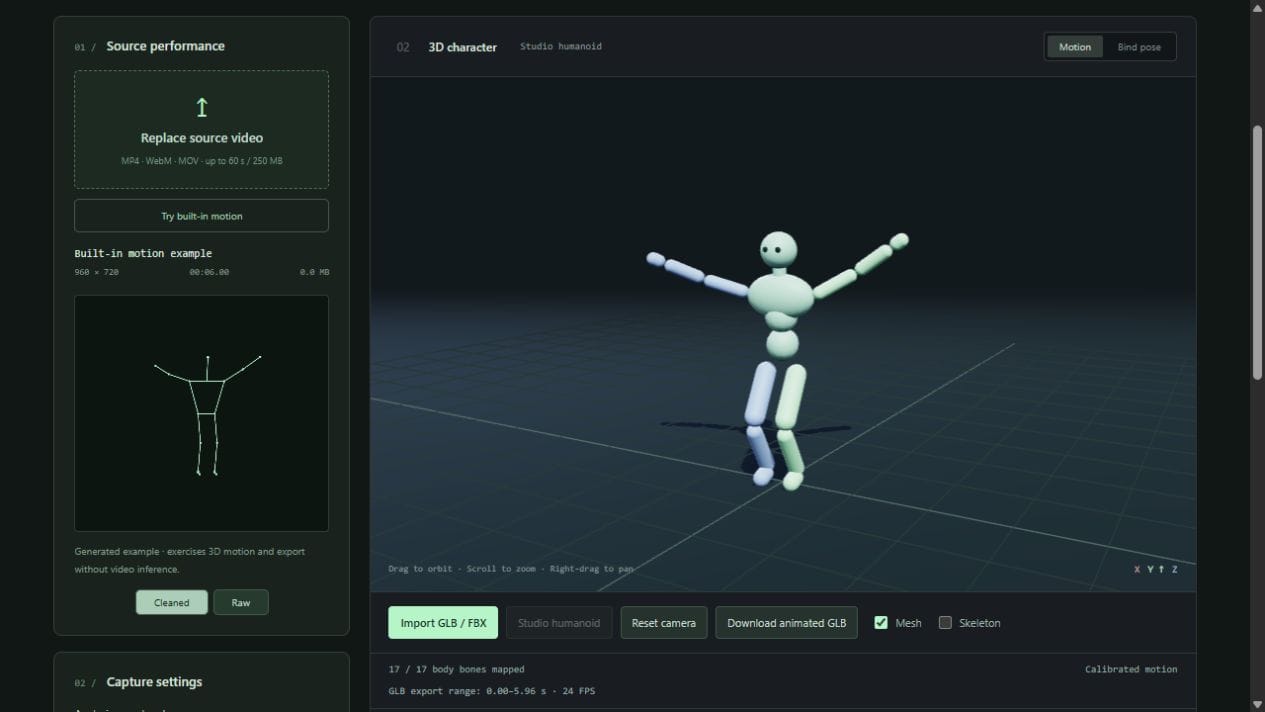
MotionBridge
手持ちの動画1本から人の動きを読み取り、3Dキャラ(Blender用)や2D切り抜きキャラの動きデータに変換できる、ブラウザ上で動くオープンソースのモーションキャプチャツール。
adonisglobal(個人開発) / GitHub
#Motion/Body#CreatorTools
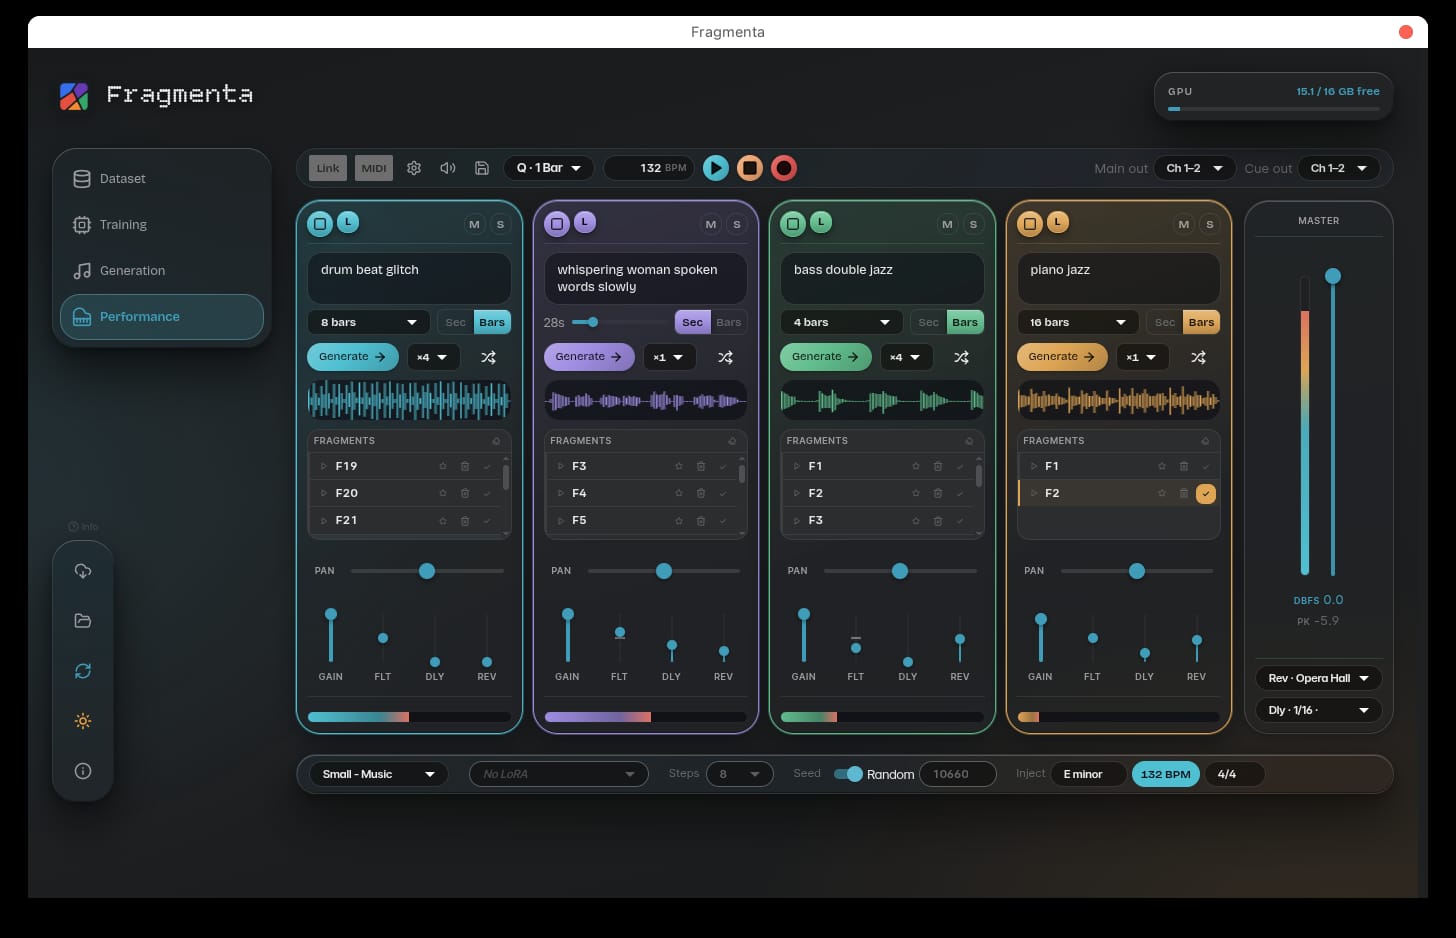
Fragmenta
自分の音源でStable Audio 3を追加学習(LoRA)し、そのモデルでの生成とライブ演奏までを1本で行えるデスクトップアプリ。v1.2.0を2026-10-27に公開。
MAz-Codes(個人開発) / GitHub
#Audio/Music#CreatorTools
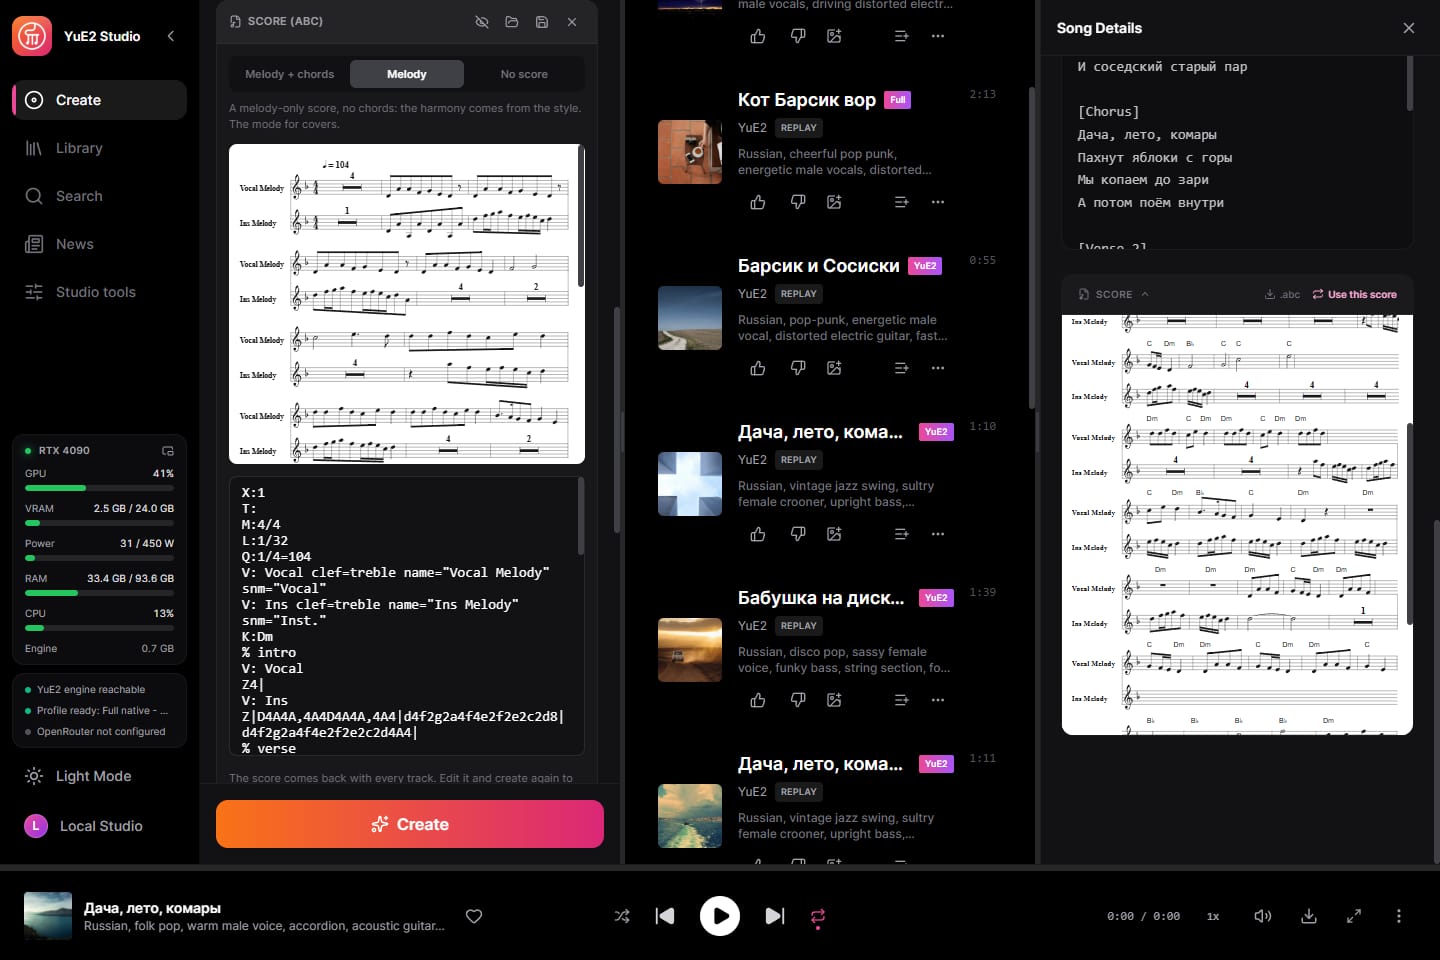
YuE2 Studio
歌付きの楽曲を手元のNVIDIA GPUで作れるデスクトップアプリ。生成結果が楽譜(ABC記法)として見え、音符・テンポ・調を直して作り直せる。
timoncool(個人開発) / GitHub
#Audio/Music#CreatorTools
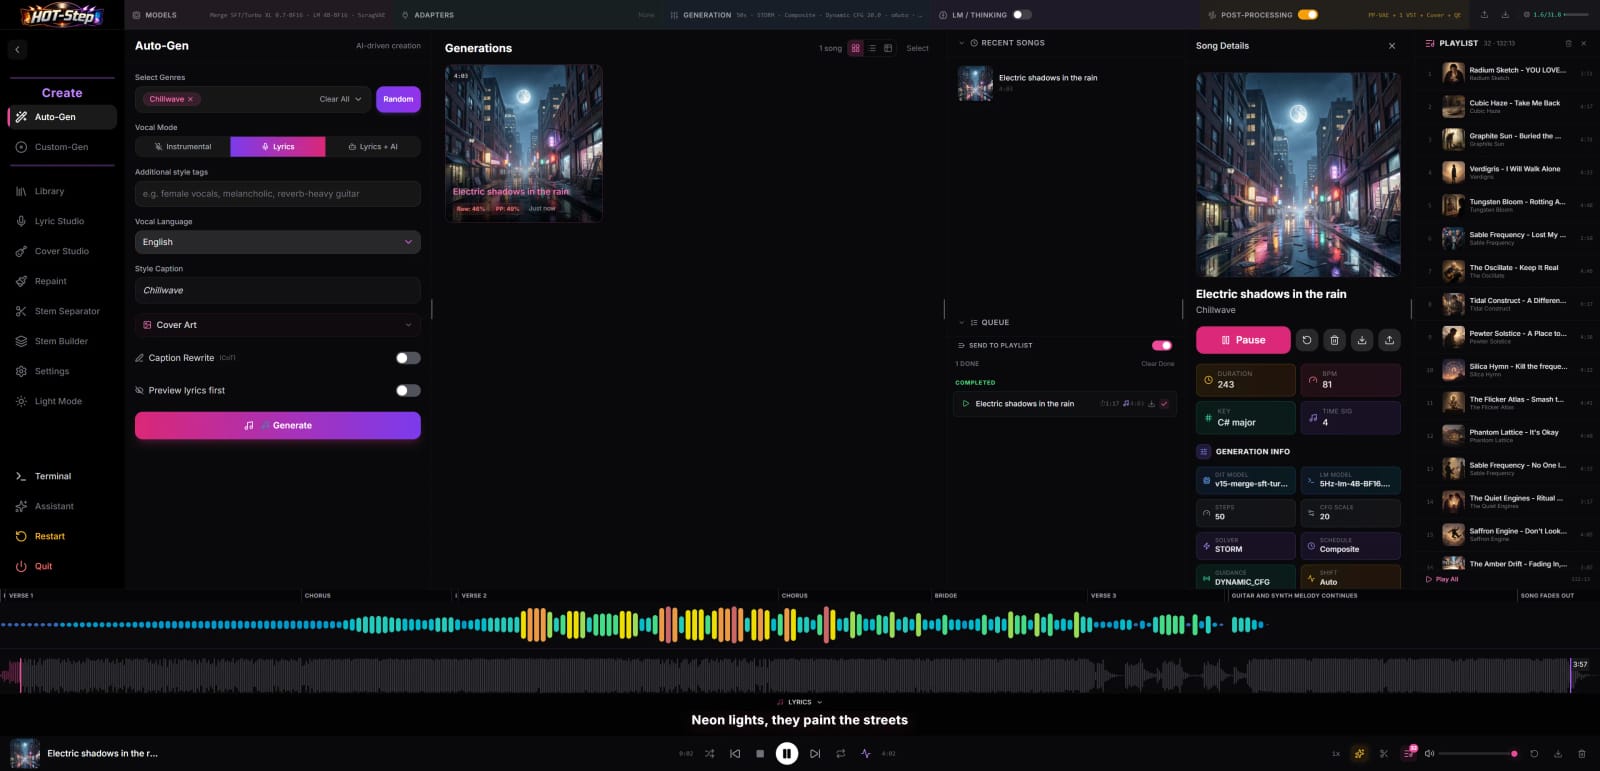
HOT-Step CPP
ACE-Step 1.5・MiniMax-Music3・YuE2・Stable Audio 3を1つの画面で切り替えて使える、ローカル完結の音楽生成スタジオ。
scragnog(個人開発) / GitHub
#Audio/Music#CreatorTools
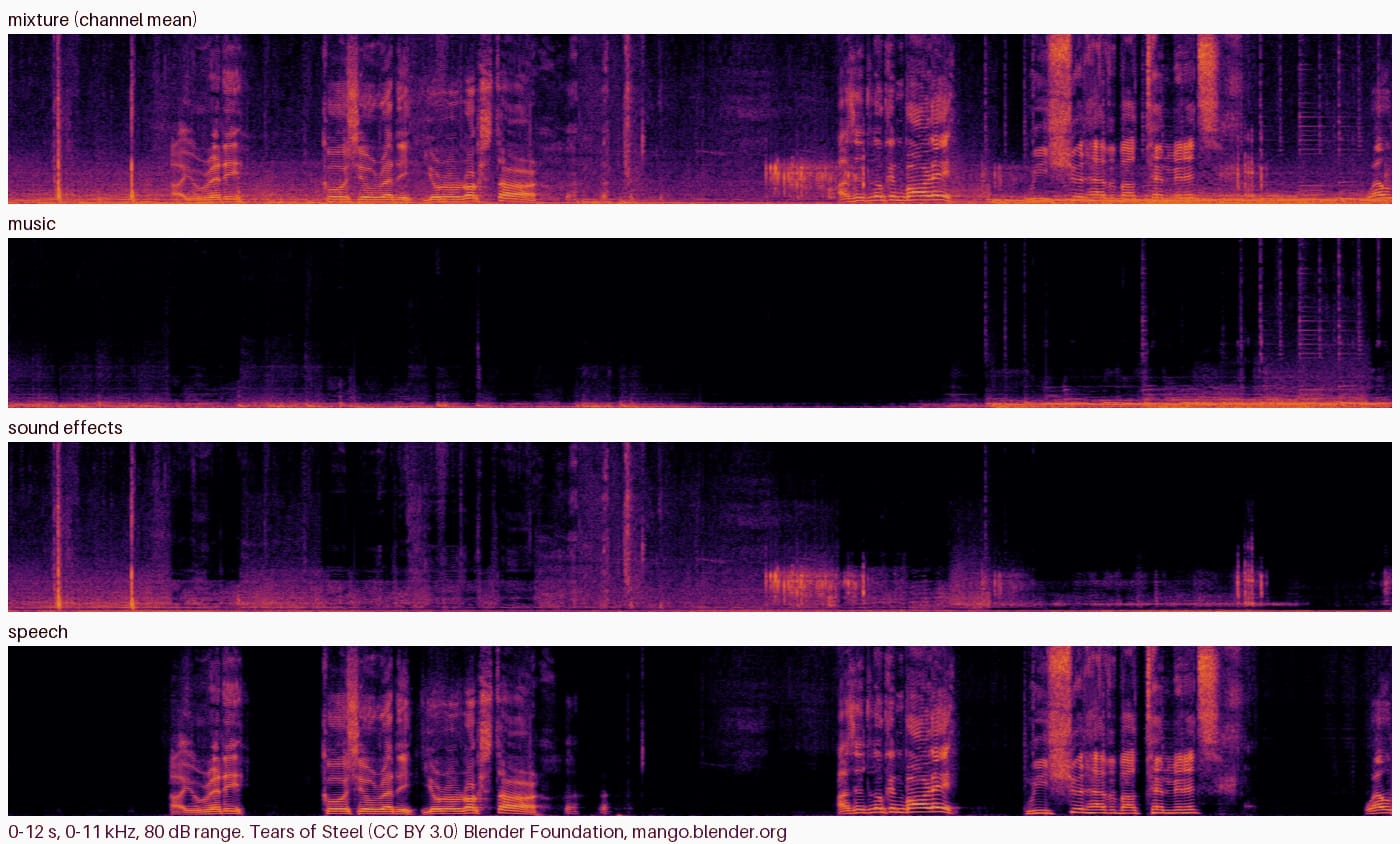
ComfyUI-DBS
映画やCMの音声を「音楽・効果音・セリフ」の3つに分けるComfyUIノード。セリフだけ消した動画も作れる。
hiroki-abe-58(非公式ノード)/ 元モデル: Tsinghua Univ. (Dynamic Band Splitting) / GitHub
#CreatorTools#Audio/Music
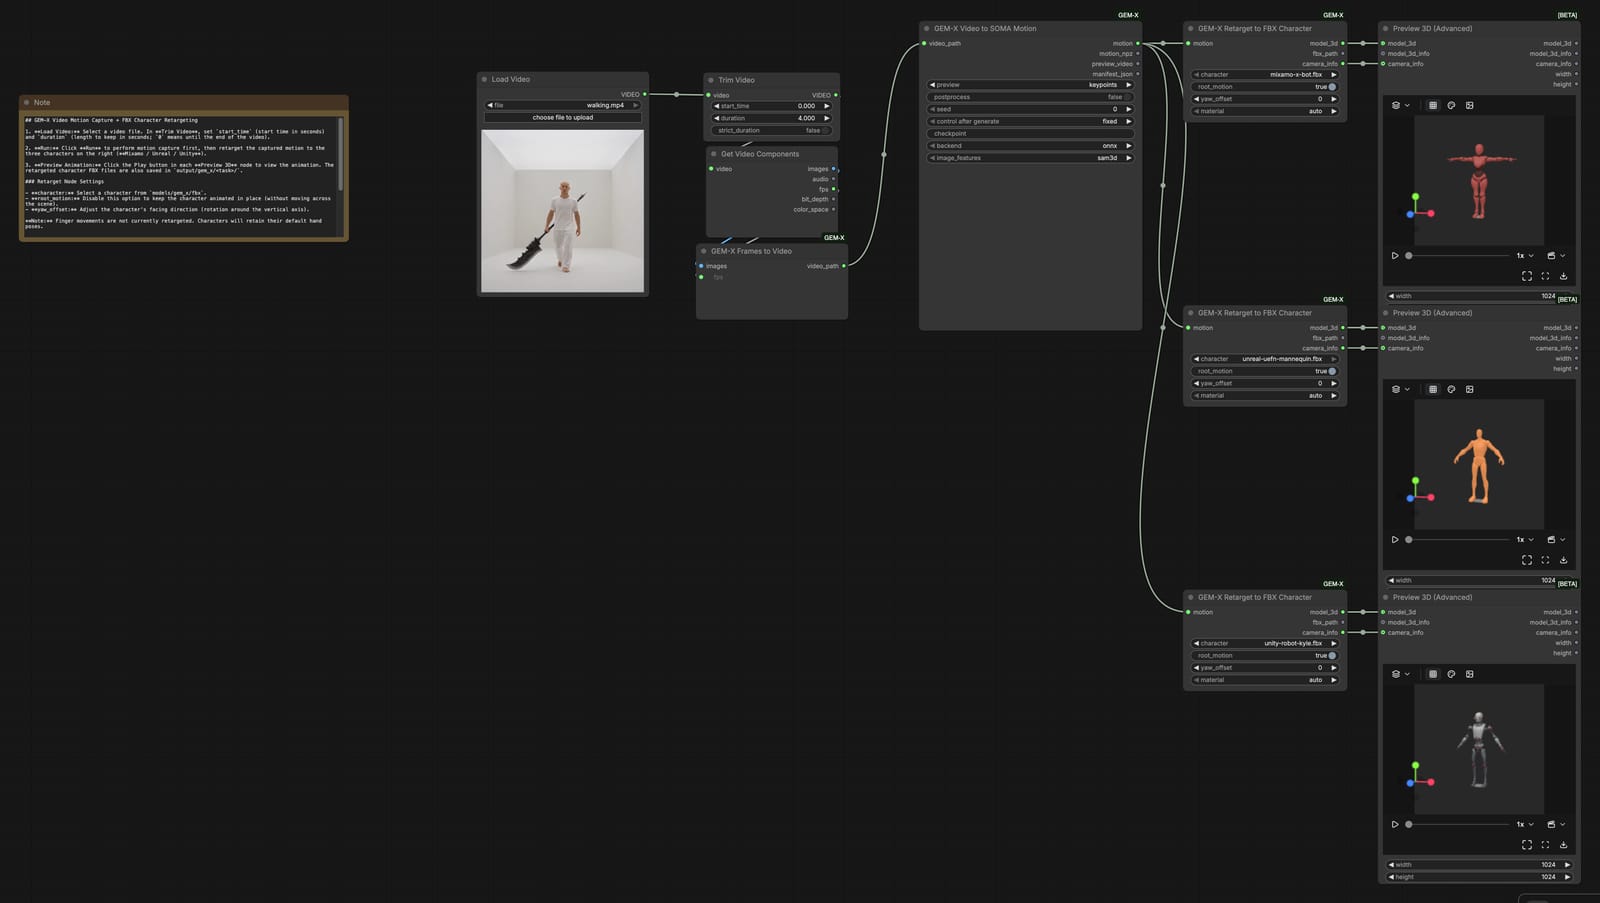
ComfyUI-GEM-X
1本の動画から全身モーションを取り出し、Mixamo/Unreal/UnityのFBXキャラに適用するComfyUIノード。
lkevincc0(非公式ノード)/ 元研究: NVIDIA (NVlabs GEM-X) / GitHub
#Motion/Body#CreatorTools
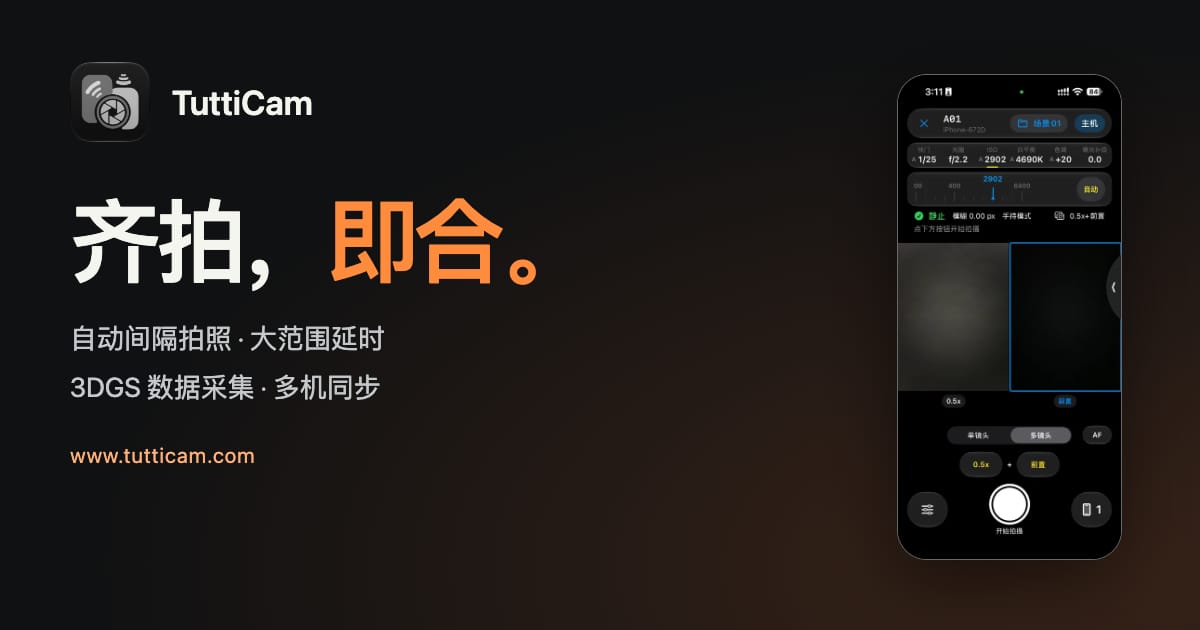
TuttiCam
iPhone・Androidスマホや一部のアクションカメラ、ミラーレスを最大8台そろえ、同じ瞬間に自動で連続撮影するGaussian Splatting用の撮影アプリ。3Dモデル生成そのものはしない。
dtpoi(個人開発) / GitHub
#Spatial/3D#CreatorTools
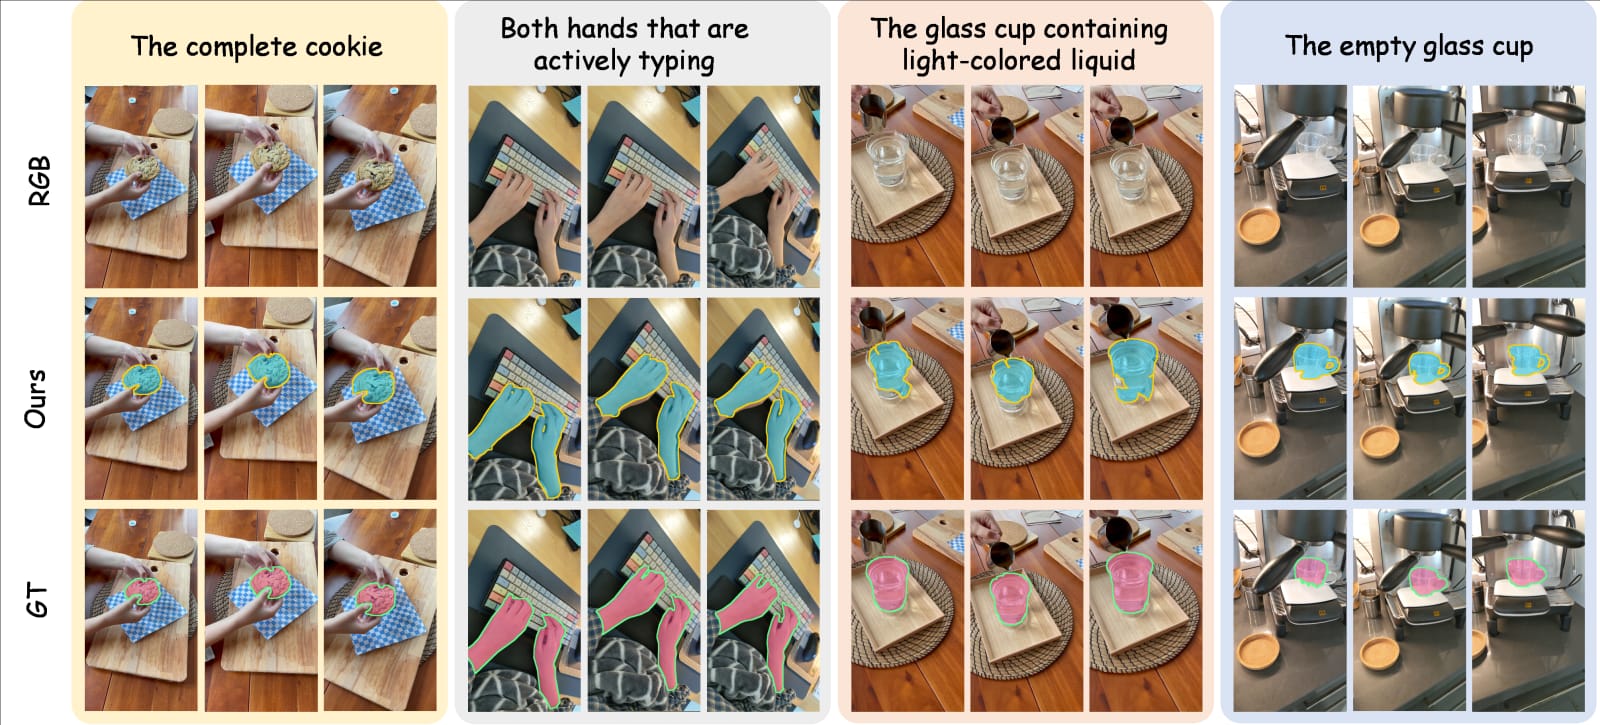
R4DGS / ReferGaussian
動く3Dシーン(4D Gaussian Splatting)に対して「手前で走っている人」のような自然言語で対象を指定し、時間をまたいで追跡・切り出せる手法とベンチマーク。
Bangpu Chen ら(ACM MM 2026採択と記載) / GitHub
#Spatial/3D#AI/Agents
Hi3D V1.0
粗い3Dメッシュと参照画像から、最大1536³の高精細ジオメトリに仕上げる、3Dモデル生成モデルのオープンソース版(推論コードと重みを公開)。
Hi3D(旧Sparc3D) / GitHub
#Spatial/3D#CreatorTools
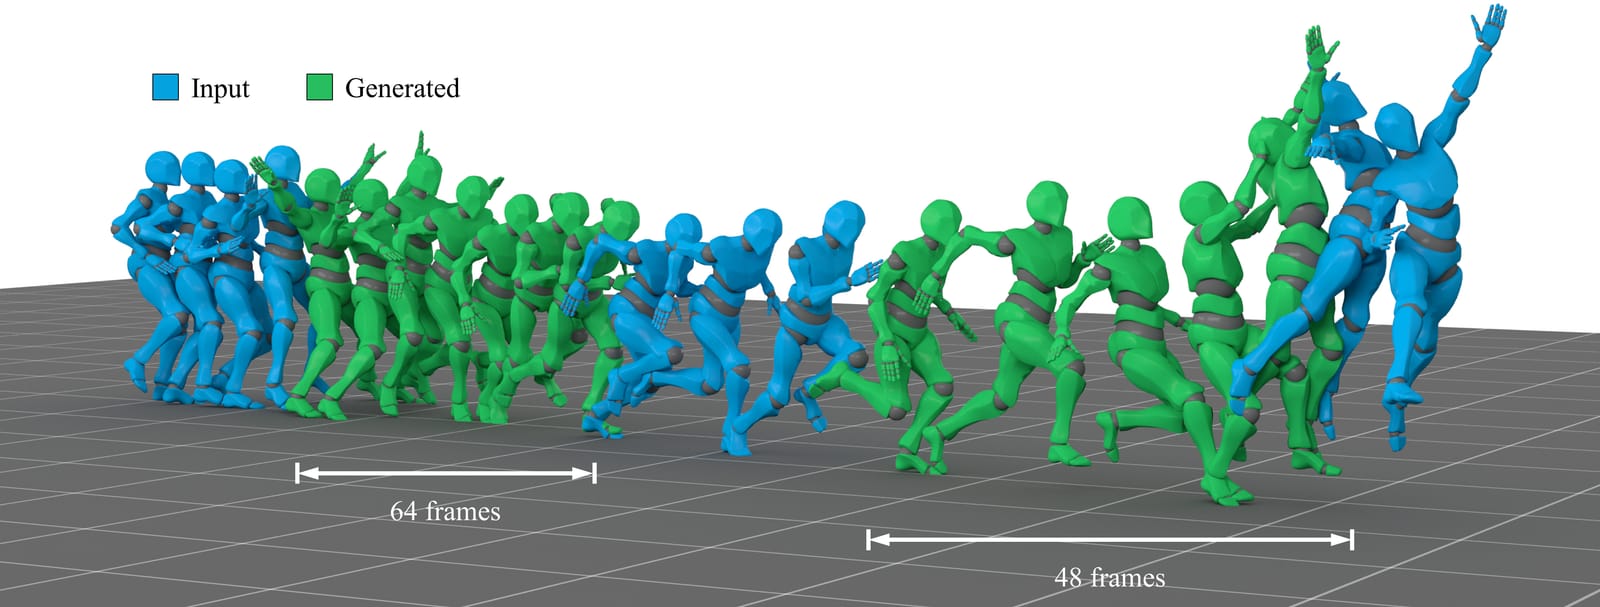
Length-varying Neural Motion Stitching via Cluster Transition Graph
2つのモーション(アニメーション)クリップを、つなぎ目の長さを自動で決めながら自然につなぐ手法。SIGGRAPH Asia 2026採択で、学習・推論コードがMITで公開されている。
KAIST Visual Media Lab (Haemin Kim, Junyong Noh ほか) / GitHub
#Motion/Body#CreatorTools
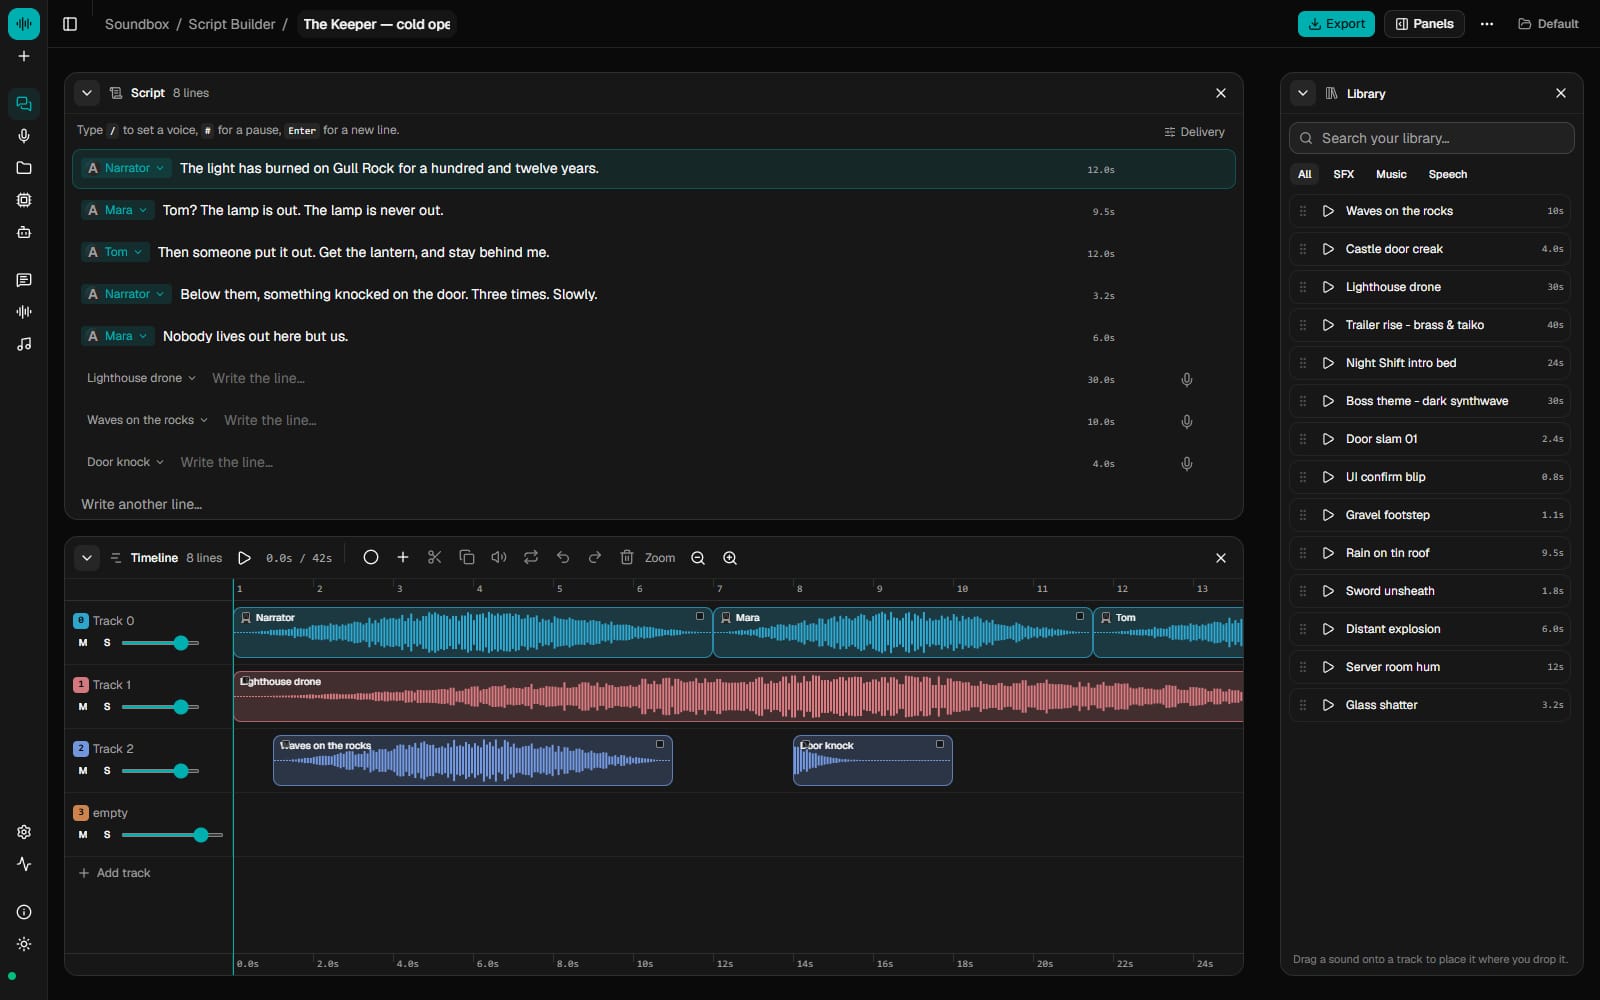
Soundbox
効果音・音楽・音声合成・ボイスクローンを、すべて自分のPC上で動かせるデスクトップアプリ。ElevenLabsやSucoの代わりに使えるオープンソースを目指している。マルチトラックのタイムラインと、AIエージェント向けのMCPサーバーも付く。
HamSanders(個人開発) / GitHub
#Audio/Music#CreatorTools#AI/Agents
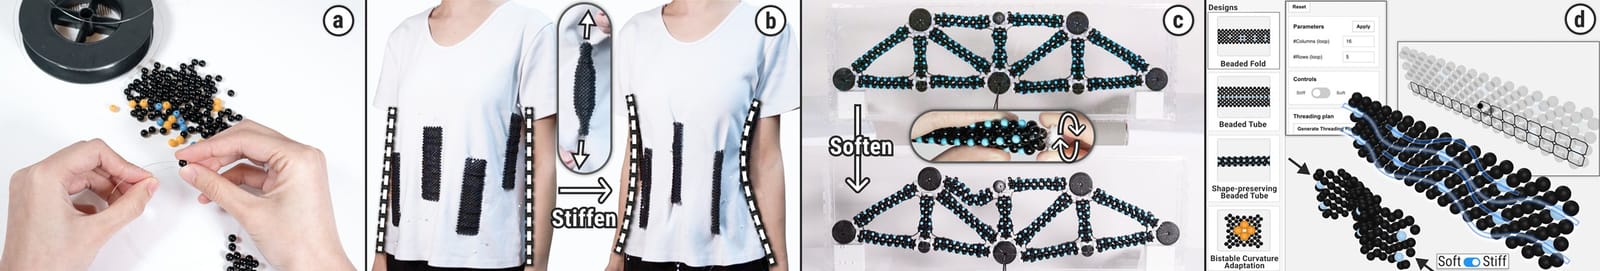
MetaBeads
ふつうのビーズと糸だけで、形が変わり、硬さも切り替えられる素材・装置をつくる手法。UIST 2026(11月、デトロイト)採択の査読付き研究。
Carnegie Mellon University Interactive Structures Lab(Alexandra Ion ほか)
#HCI/MediaArt#Motion/Body
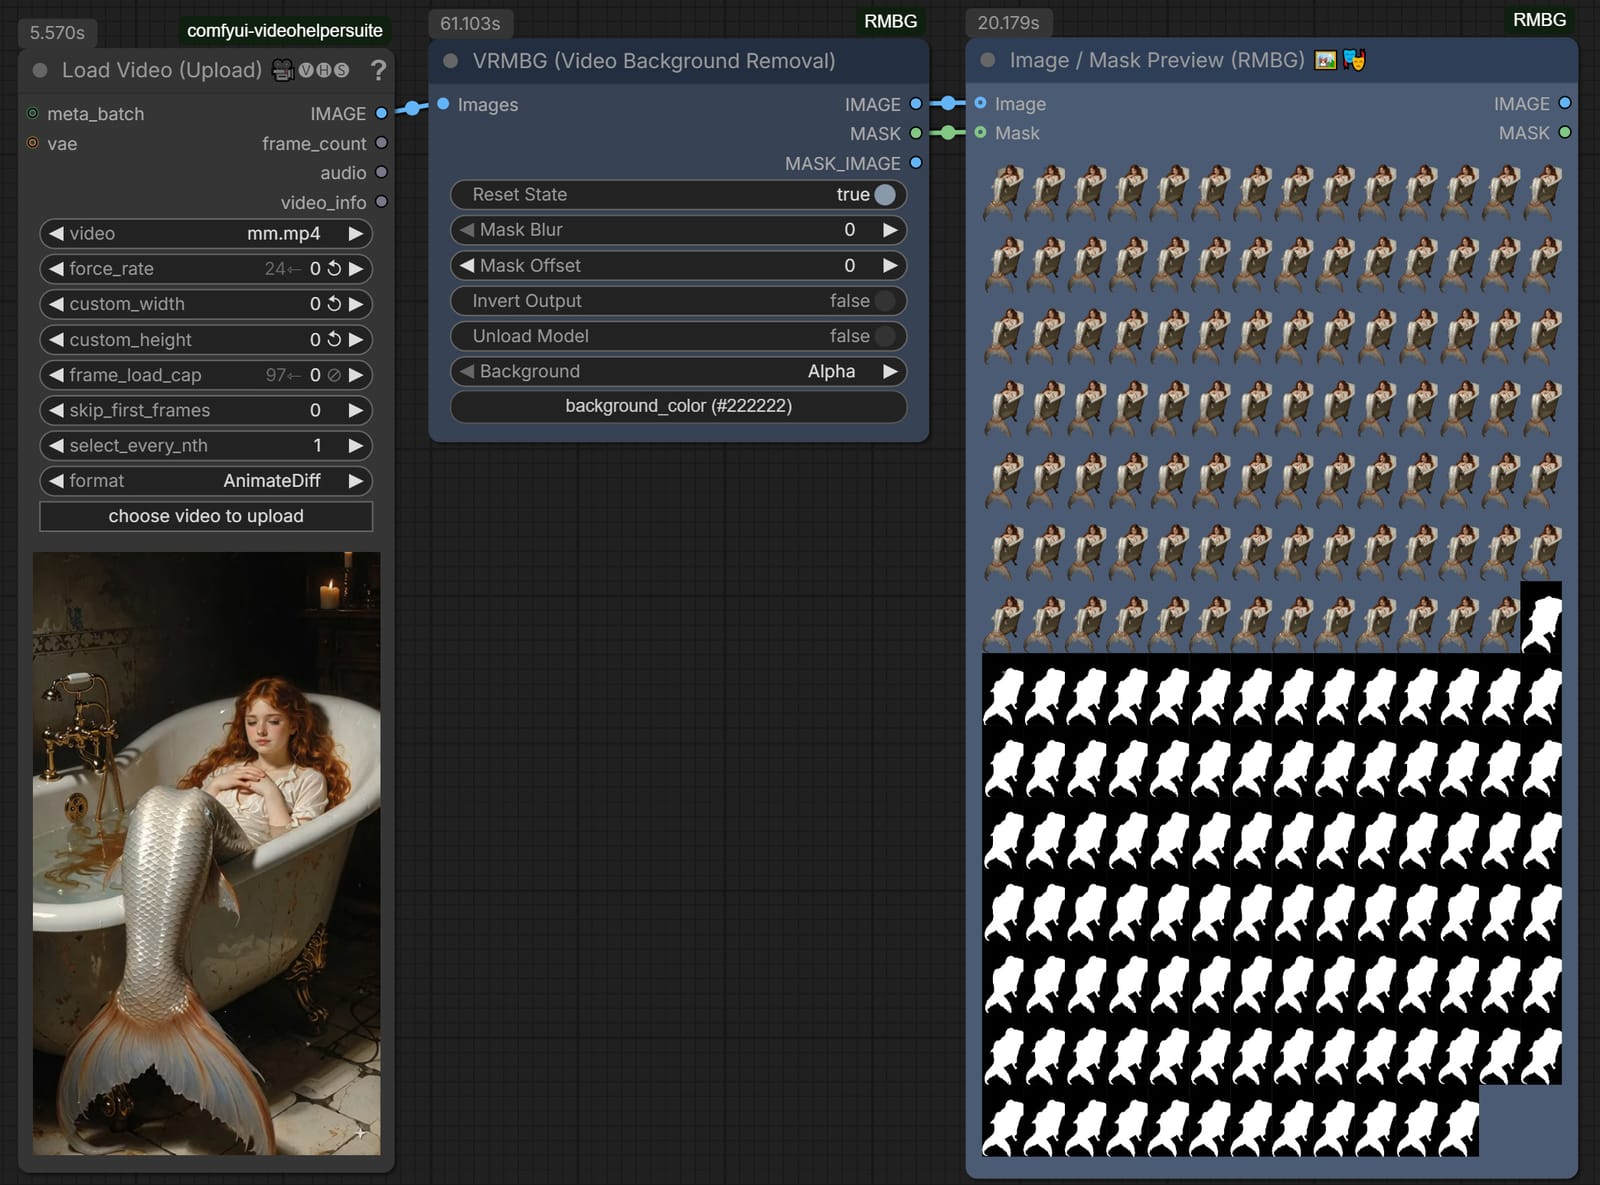
ComfyUI-RMBG v3.3.0(VRMBG 動画マッティング+Canvas)
ComfyUIで背景除去・切り抜きを行う定番ノード集が v3.3.0 で初の動画ノードを追加。前のフレームを手がかりに切り抜くため、ちらつきの少ない動画の背景除去ができる。
1038lab(コミュニティ開発) / GitHub
#CreatorTools#GenVideo
TaoMate-H3-FL2VA
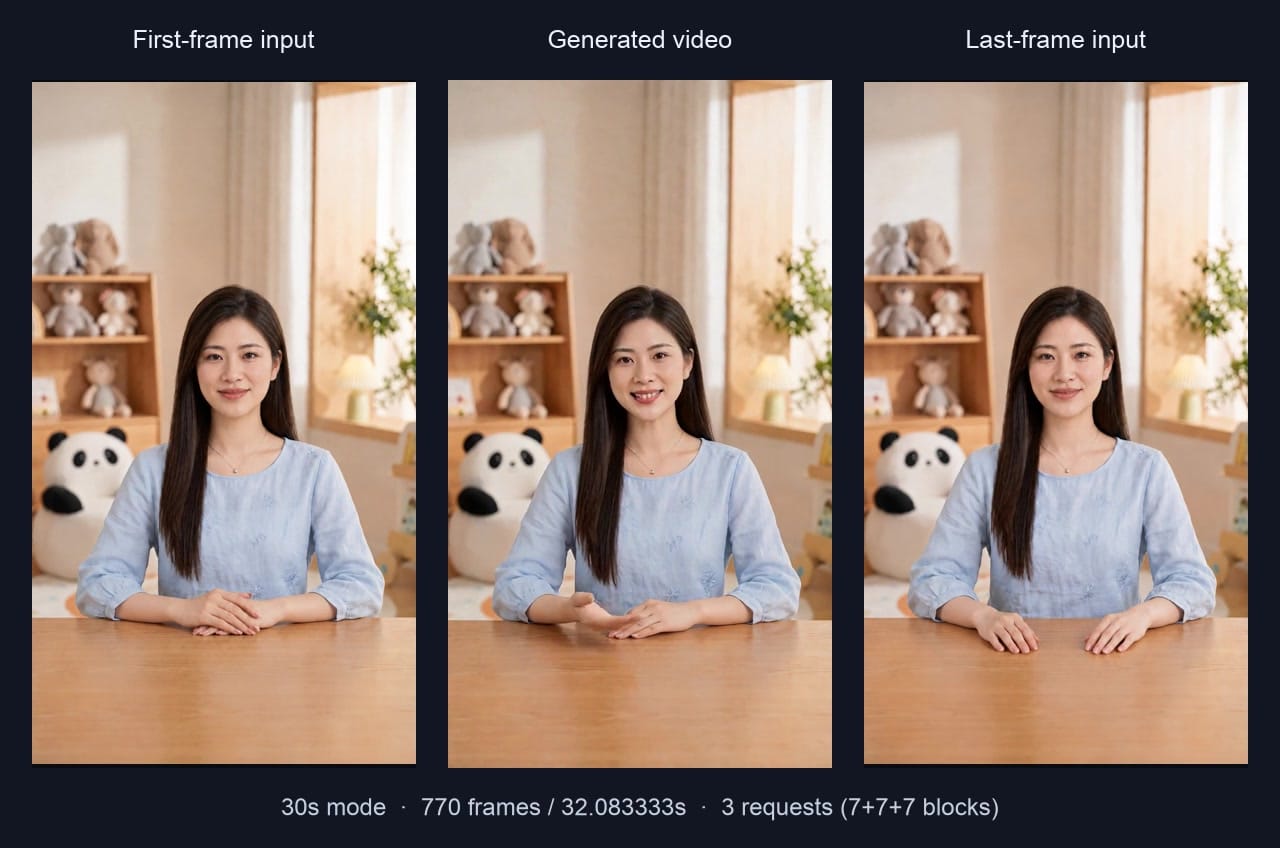
最初のコマと最後のコマを指定すると、その間をつなぐ映像と音声を同時に、ほぼリアルタイムでストリーミング生成するMiniMax H3用の3ステップLoRA。
Alibaba TaoLive AIGC Team / GitHub
#GenVideo#Audio/Music
PTD(Parametric Trajectory Distillation)for MiniMax-H3
約33Bの映像+音声同時生成モデルMiniMax-H3を、LoRAだけで4〜6ステップに蒸留し、50ステップの元モデルより約7〜11倍速く生成できるようにした手法とComfyUI対応コード。
EPFL VITA Lab / NVIDIA / Stanford(Lan Feng ほか) / GitHub
#GenVideo
Matrix-Game 4.0
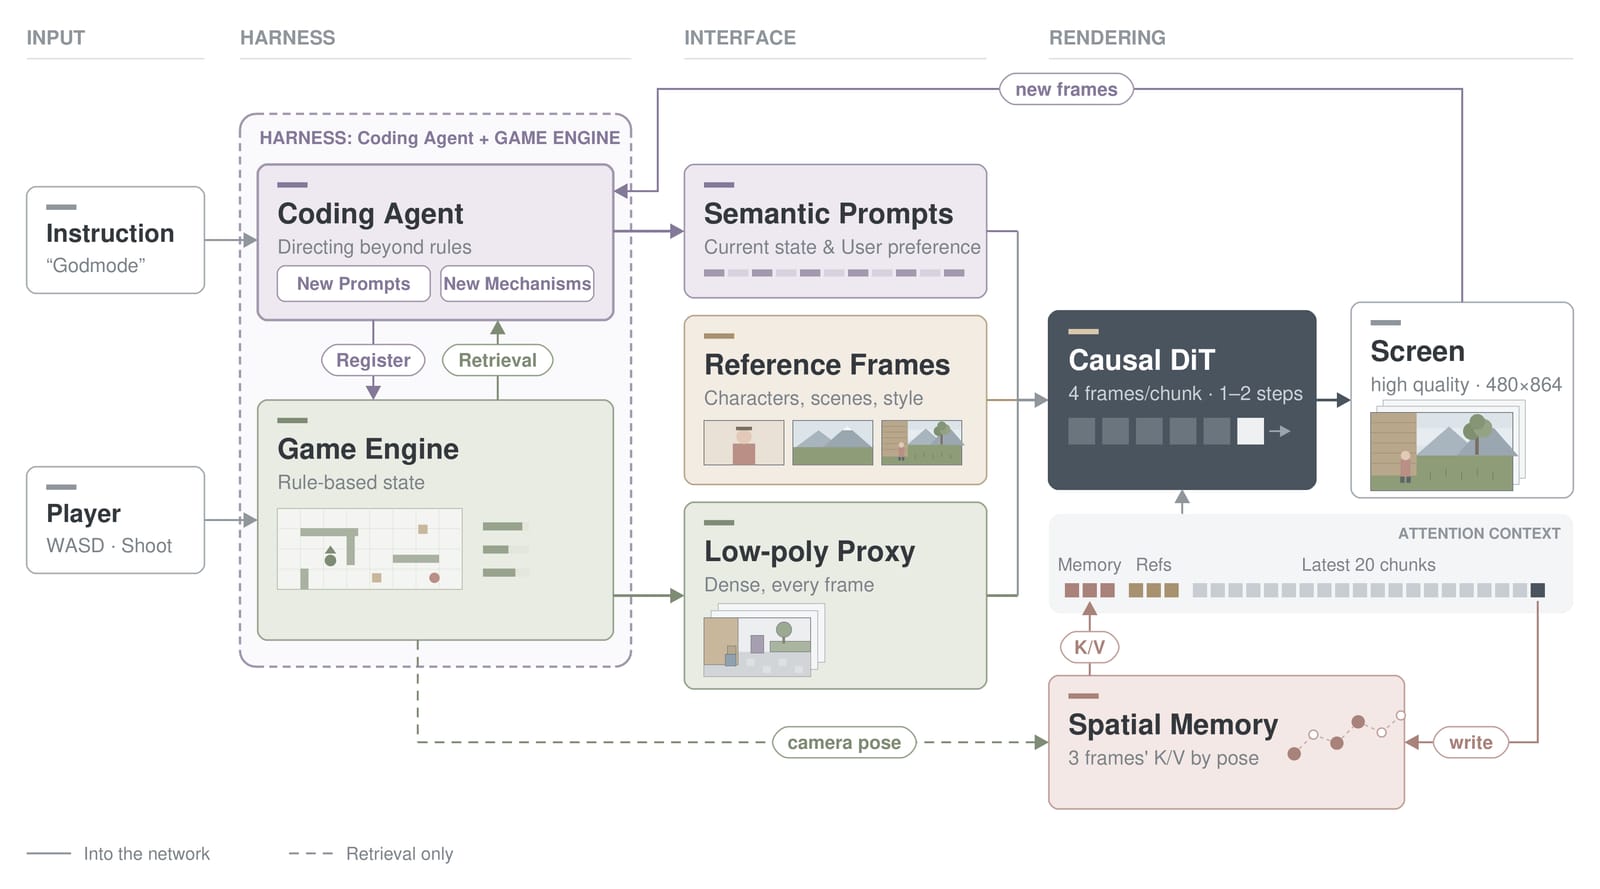
ゲームエンジンが出す粗いローポリ映像を、動画生成モデルがリアルタイムで精細なゲーム映像に描き直す「操作できるワールドモデル」。キー入力から画面表示までの遅れは112ms、RTX 5090で480p・60FPSの動作が報告されている。
Skywork AI(UC San Diego・CUHK・上海AI Lab ほかとの共同研究) / GitHub
#Spatial/3D#GenVideo#AI/Agents
FreeGaussian
Insta360の生データ(.insv)から、ブラウザだけでGaussian Splat(写真のようにリアルな3D空間)を作るクラウドツール。床が水平で実寸の空間になり、ロボット用シミュレータに使えるメッシュ(GLB/USDZ)も一緒に出力される。
OVER the Reality
#Spatial/3D#CreatorTools
Manga2Animate
漫画の数ページとキャラクター設定画から、まず台本、次に絵コンテを作り、最後に動画を生成するマルチエージェント方式の漫画アニメ化フレームワーク。
National Yang Ming Chiao Tung University / GitHub
#GenVideo#AI/Agents#CreatorTools
ATAS (Any Time, Any Space)
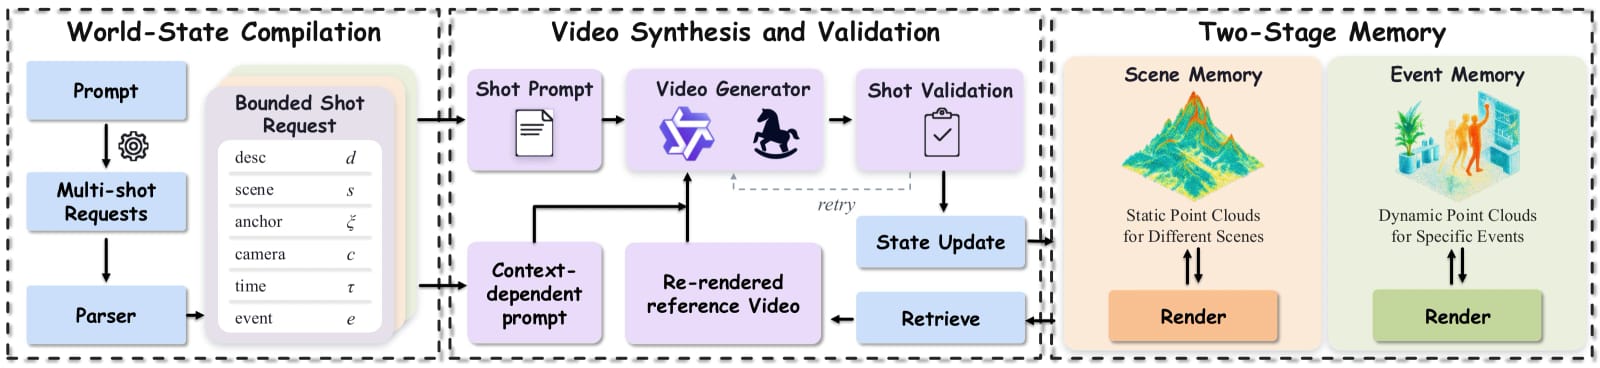
脚本から複数ショットの映画を作る際、「1つの世界」を3Dで覚えておき、場所の再訪や過去の出来事の別アングル撮影を可能にするエージェント型映像生成フレームワーク。
Zhejiang University / Monash University / UC Berkeley BAIR ほか / GitHub
#GenVideo#AI/Agents#Spatial/3D
OpenVLHarness
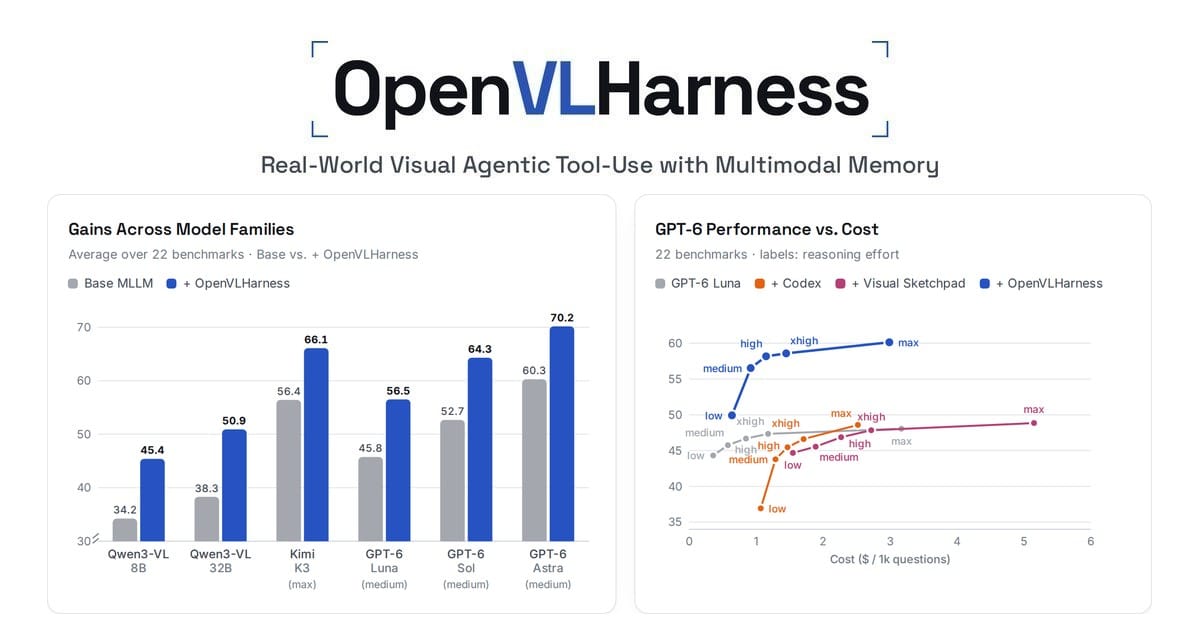
画像を見られるAI(マルチモーダルLLM)に、拡大・文字認識・物体の位置特定・奥行き推定・Web検索・Pythonコード実行などの道具を持たせ、見たものを「記憶」として貯めさせる、学習不要のエージェント基盤。
UCLA NLP / Apple / GitHub
#AI/Agents
DualSense Haptic Designer
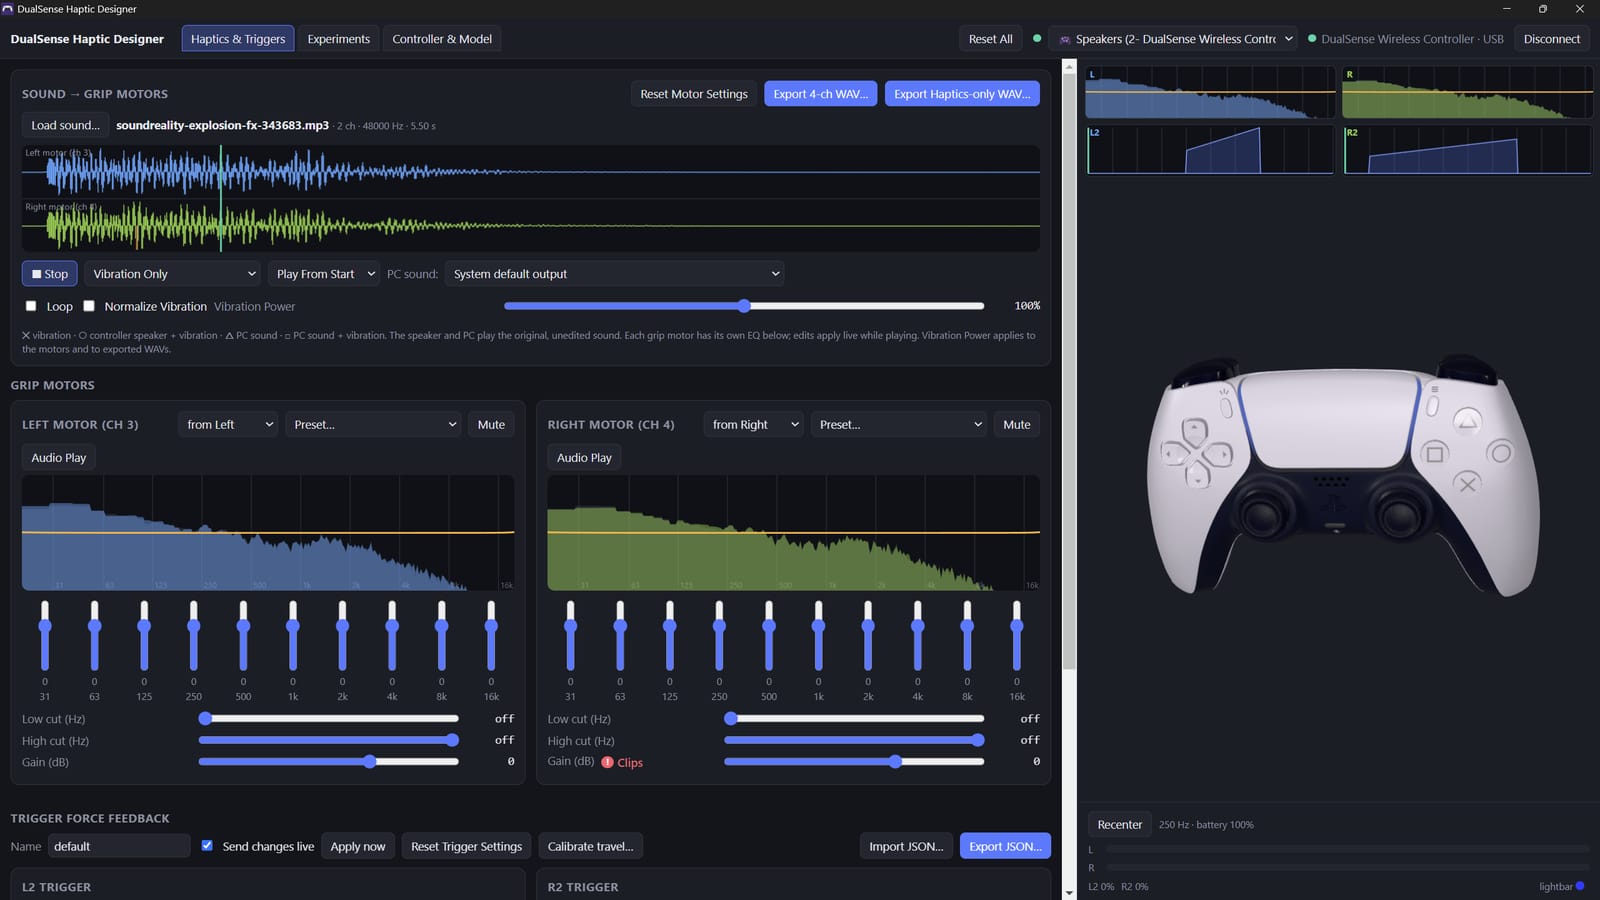
PS5コントローラー(DualSense)の振動と、トリガーの手応えを、音ファイルやグラフから設計・試し打ちできるデザインツール。Windowsアプリ版と、ChromeやEdgeで動くWeb版がある。
Jellybit(個人開発者) / GitHub
#HCI/MediaArt#CreatorTools
coopiano
録音した音(サンプル)を使わず、ハンマー・弦・響板の物理モデルだけでピアノの音を作るC++製シンセ。MIDIファイルをWAVに書き出せ、macOSではMIDI鍵盤からの演奏もできる。
Peter Cooper(個人開発者) / GitHub
#Audio/Music#CreatorTools
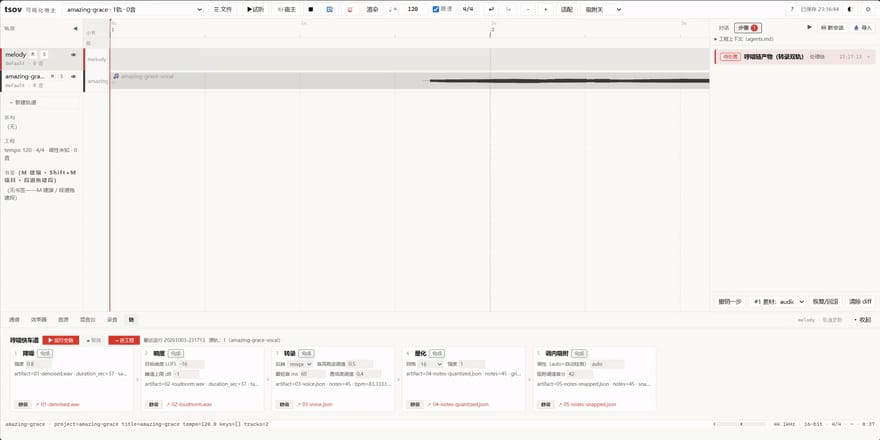
tsov (the shape of voice)
鼻歌を録音すると楽譜(MIDI)に起こし、AIチャットで編曲・ミックス・書き出しまで進められるローカル動作の音楽制作ワークスペース。変更は差分として確認でき、元に戻せる。
luolianst(個人開発者) / GitHub
#Audio/Music#AI/Agents
Code Video Model (CodeVideoBench)
文章から「Three.jsのコード」で3Dシーンを組み、その粗い映像をお手本にして動画生成AIに最終映像を作らせる、設計図つきの動画生成手法。
Code Video Model Team / GitHub
#GenVideo#Spatial/3D#CreatorTools
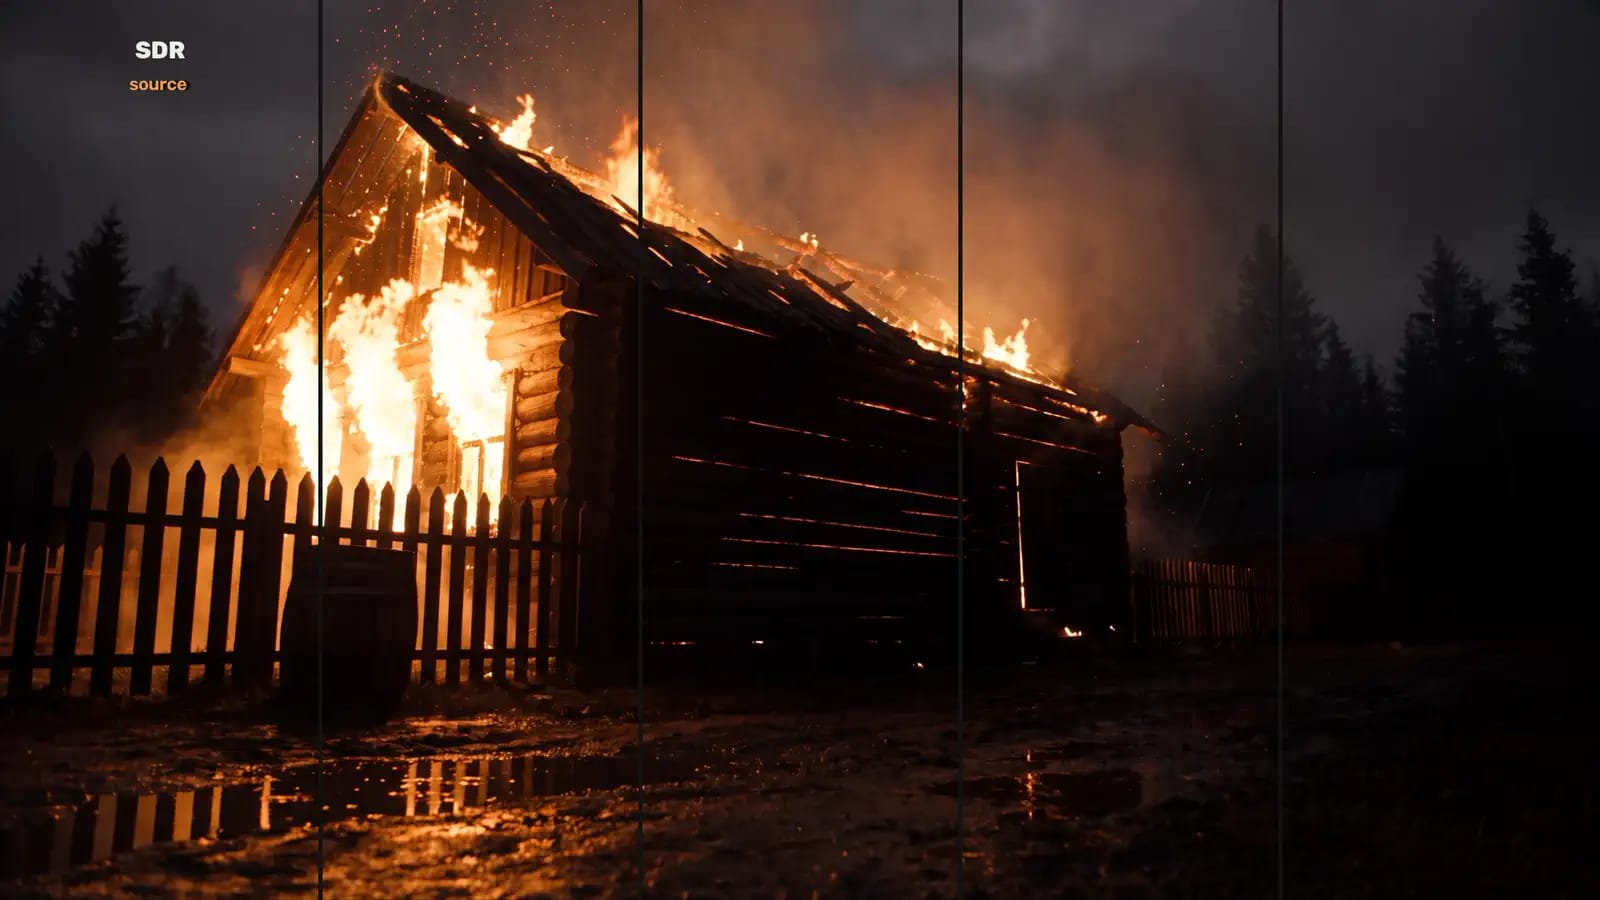
HDR Converter
AI生成映像(SDR)の白飛びした明るい部分だけを作り直し、合成ソフトで使える16bitのOpenEXR(HDR)連番に変換するWindows用アプリ。
Andrew Divnogorsky / GitHub
#CreatorTools#GenVideo
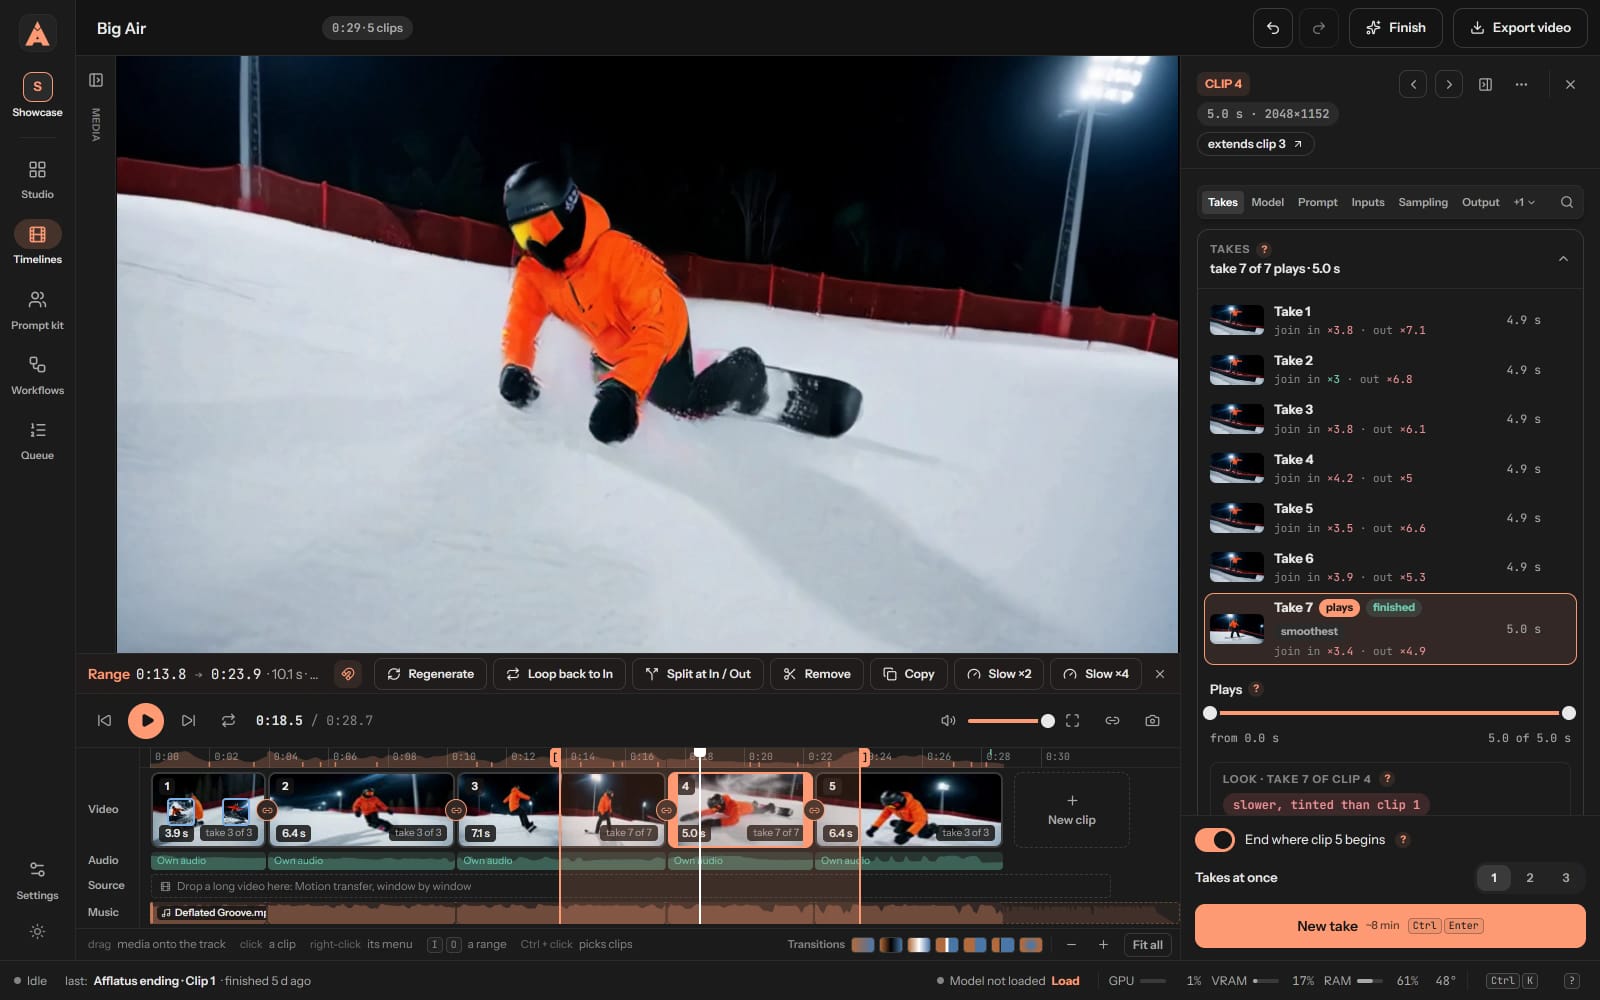
Afflatus
ComfyUIのノードグラフを見せず、モデルごとの入力フォームと履歴・タイムライン編集・複数PCへの振り分けキューを足した、自前サーバー用の画像・動画制作スタジオ。
bardak971 / GitHub
#CreatorTools#GenVideo
OpenFilm
Claude CodeやCodexなどのコーディングAIに「Webページとして動画を作らせ」、ブラウザ上のエディタ(Studio)で手直しできるオープンソースの動画エージェント。
OpenFilm contributors / GitHub
#AI/Agents#CreatorTools#GenVideo
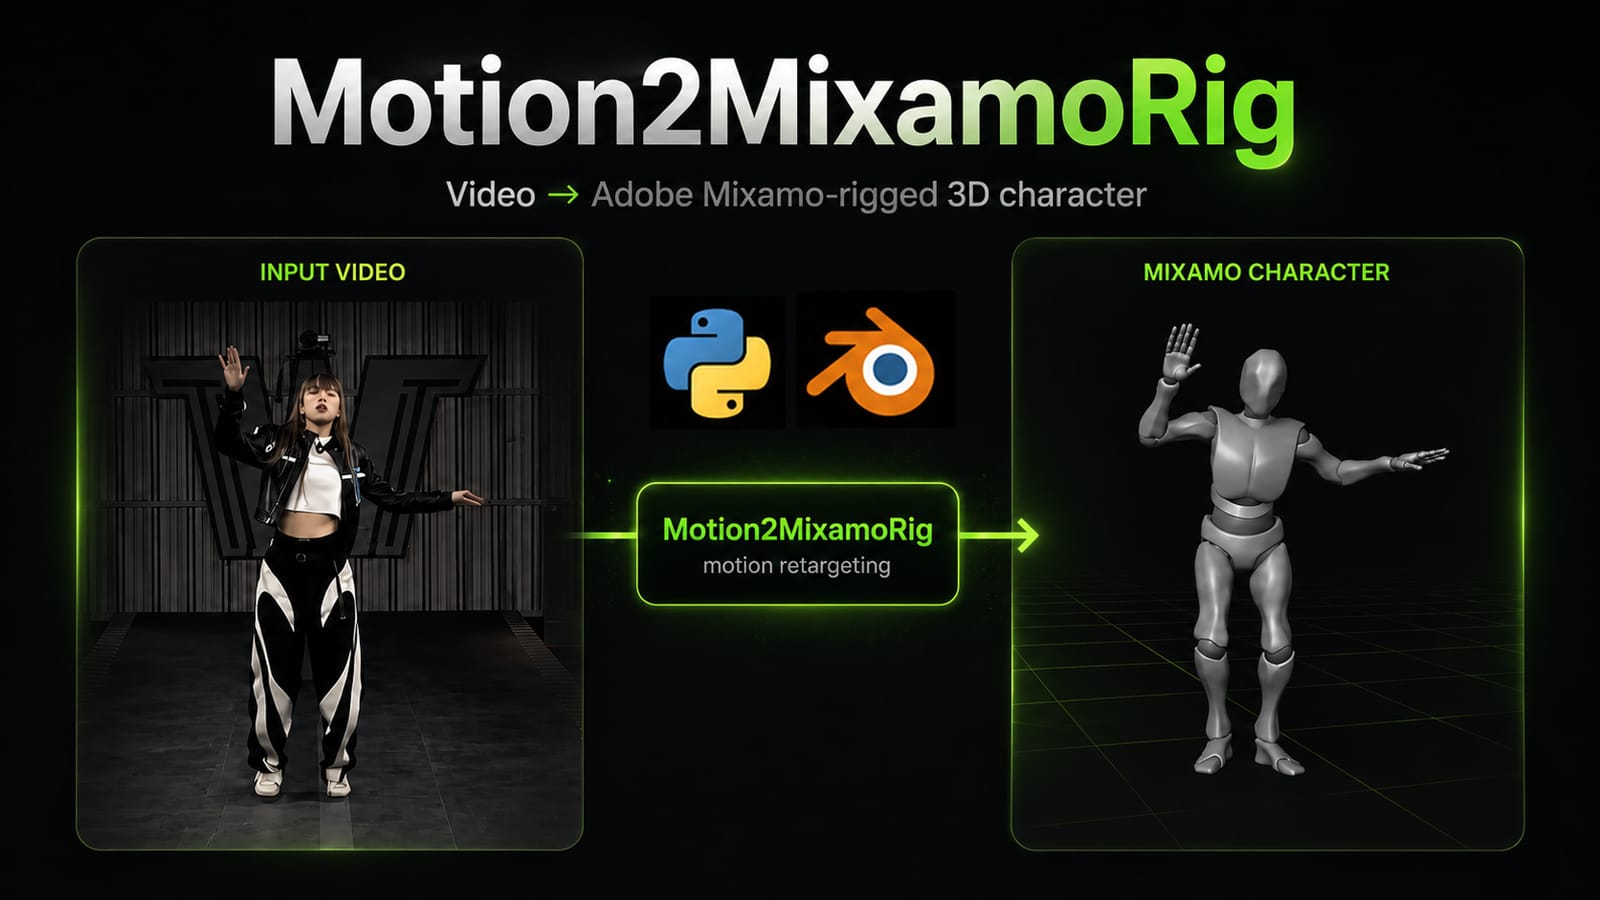
Motion2MixamoRig
1人の人物が映った動画(または1枚の写真のポーズ)から3Dの動きを推定し、AdobeのMixamo規格のキャラクターに自動で移し替え、Blender/Unityに持ち込めるアニメ付きキャラ(.glb)を出力するOSSツール。v0.1.5(2026-10-15)でBlender 4.2+用アドオンが加わった。
MaxLiu22(個人OSS) / GitHub
#Motion/Body#CreatorTools
Animatica Choreographer(Blender add-on)
NVIDIAのテキスト→モーション生成モデル(Kimodo)などを、Blenderのタイムラインから使えるようにしたアドオン。文章とキーポーズ、通過点を指定して3Dキャラの動きを生成する。2026-10-11にv1.0となり、直近も改良が続く。
Animatica / GitHub
#Motion/Body#CreatorTools#AI/Agents
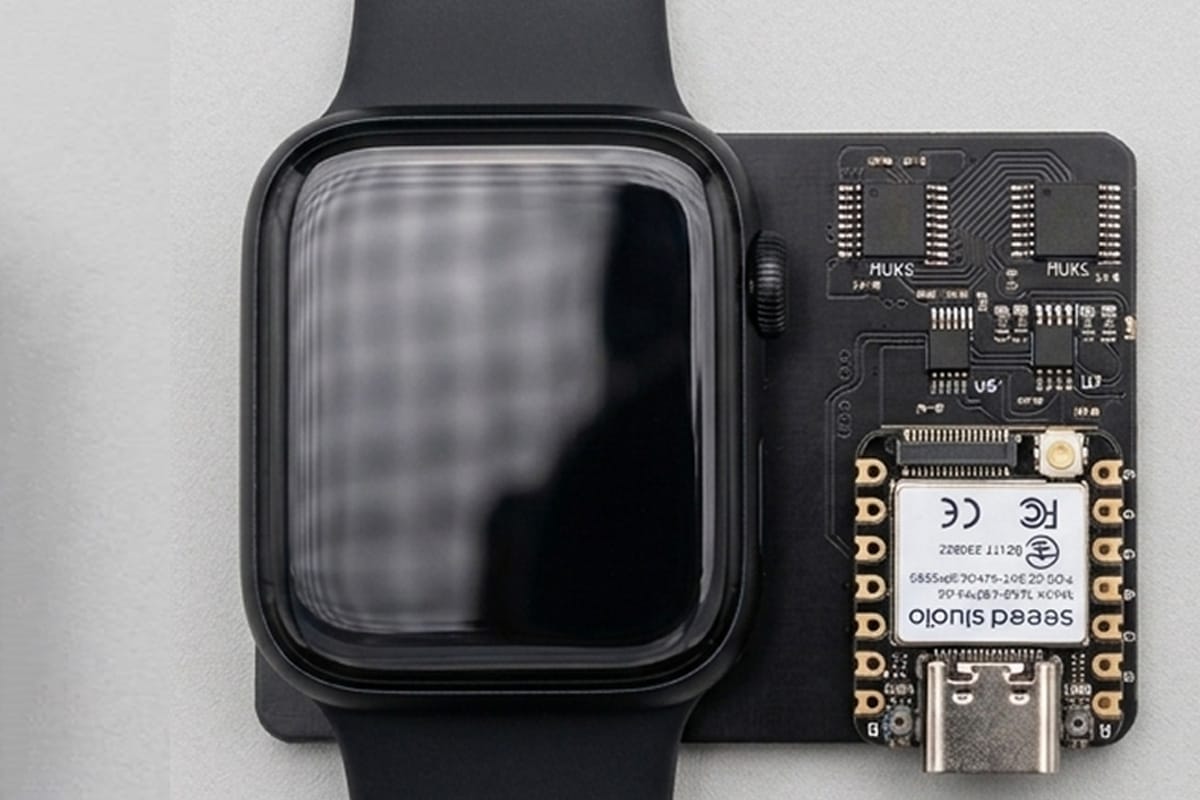
EITWatch
スマートウォッチの裏ぶた(直径40mmの時計ケース裏)に電極を並べるだけで、手のジェスチャーを読み取るセンサー。回路図・基板データ・ファームウェアまで公開されている。
Northwestern University SPICE Lab (Xuanyou Liu, Novel Alam, Karan Ahuja) / GitHub
#HCI/MediaArt#Motion/Body
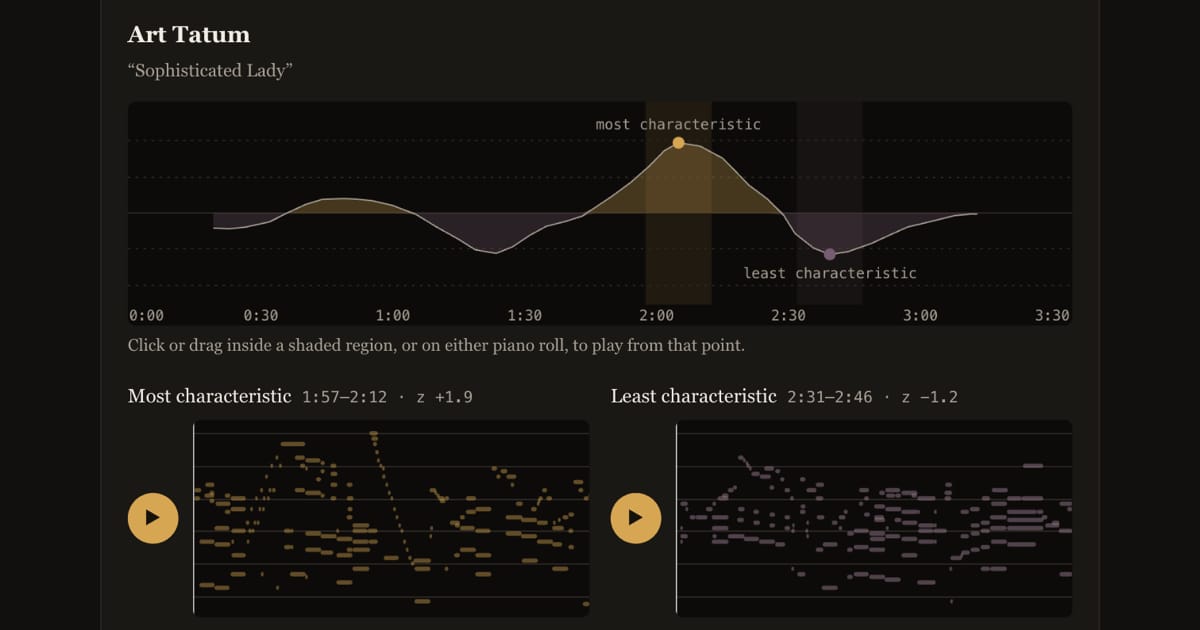
Jazz Pianist Style (Learning Jazz Pianist Style with Cross-Attention Conditioning)
ジャズピアニスト12人それぞれの「弾き癖」を学習し、指定した奏者らしい続きを作れるピアノAI。コード、学習済みモデル、デモページがすべて公開されている。
Drew Edwards (Queen Mary University of London) / Akira Maezawa (Yamaha) / Simon Dixon / GitHub
#Audio/Music#AI/Agents
LightVAE
動画生成AIの最後の工程である「潜在表現→映像に戻す処理(VAEデコード)」を、画質をほぼ保ったまま最大約3倍速くする軽量版VAEと、ComfyUI用ノード。
ModelTC / LightX2V チーム(論文: Shiqiao Gu ら) / GitHub
#GenVideo#CreatorTools
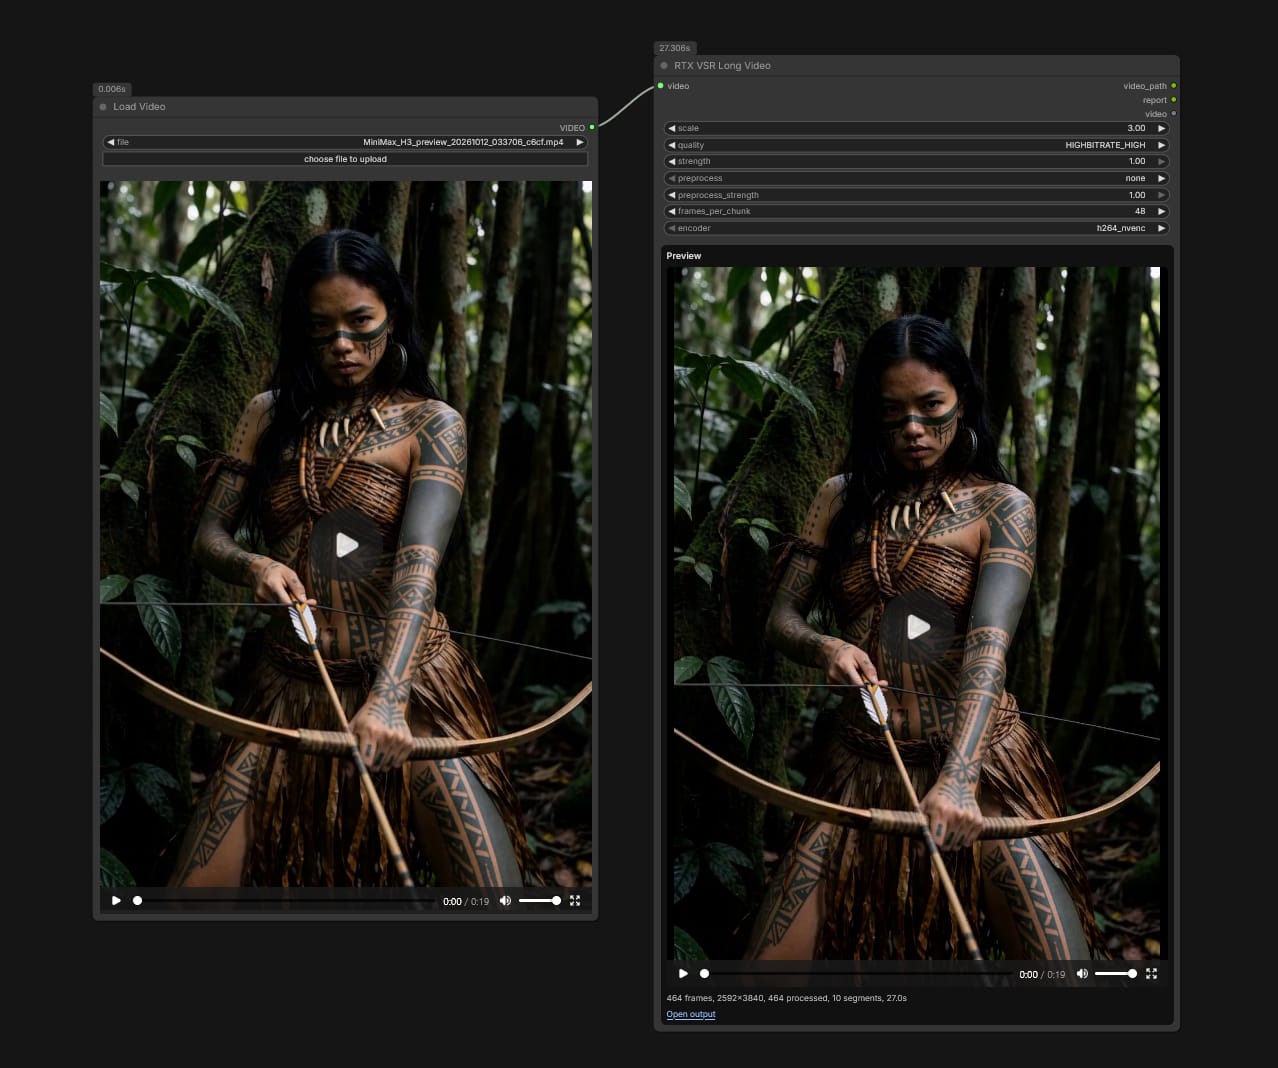
ComfyUI NVIDIA RTX VSR Long Video
NVIDIA RTXの動画超解像(最大4倍)を、長尺・高解像度でもメモリを使い切らずに実行できるComfyUIノード。音声保持とNVENC書き出し付き。
tritant / GitHub
#GenVideo#CreatorTools
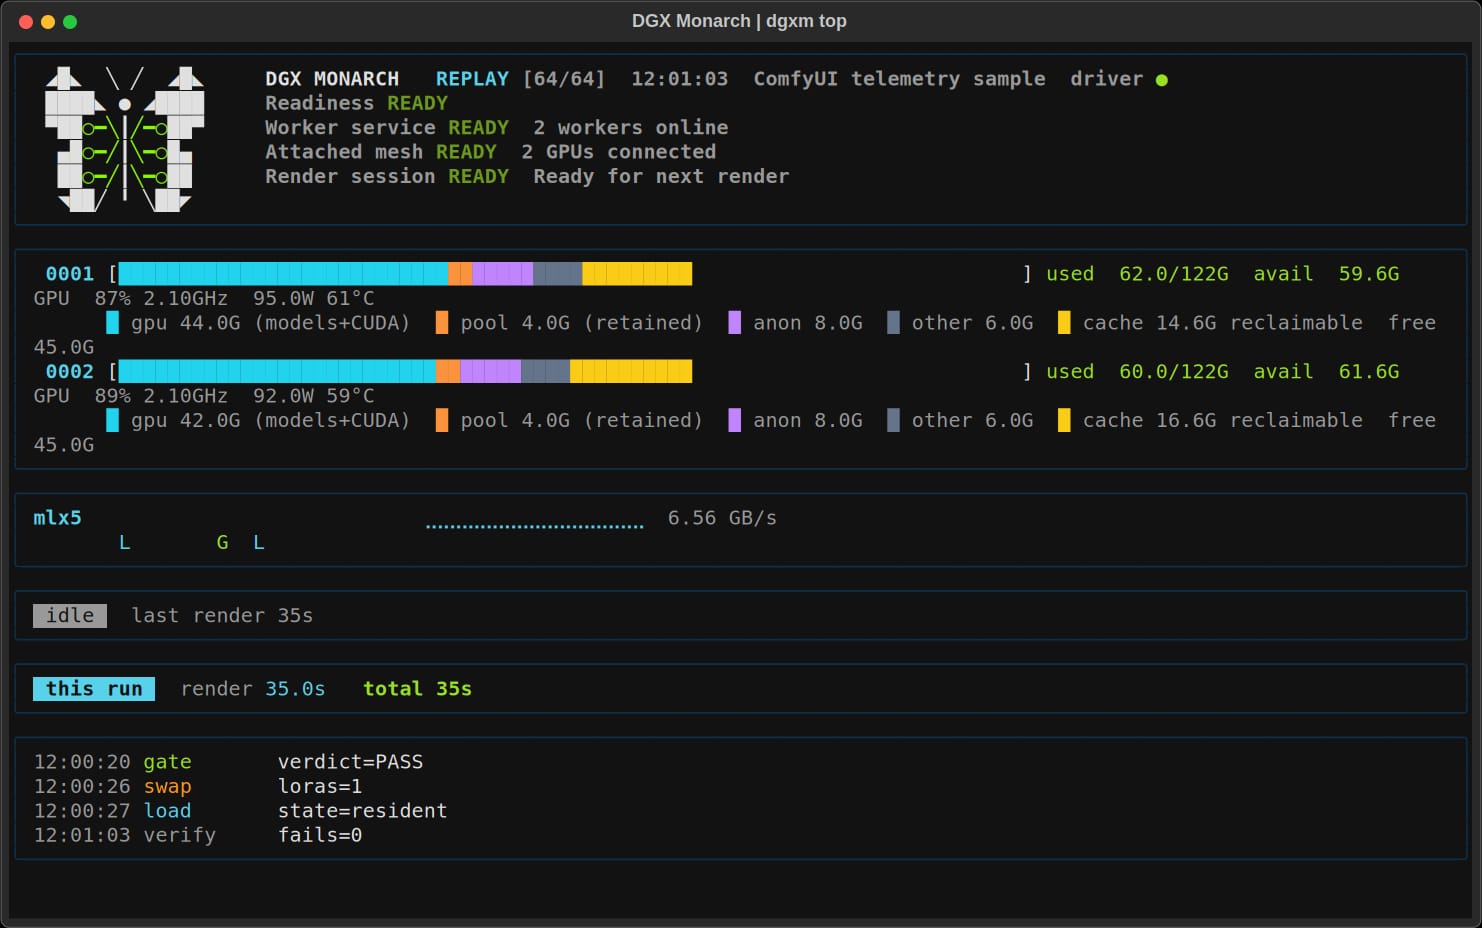
DGX Monarch
NVIDIA DGX Spark 2台をつなぎ、ComfyUIの画像・動画生成を分担して高速化・大型モデル化するカスタムノード集。サンプルワークフロー59本付き。
Deen-Media / GitHub
#GenVideo#CreatorTools
UNITAS
ロボットの手や人の手の動きと、それによって物の置かれた空間がどう変わるかを、同じ3D座標の中でまとめて予測する「3D世界モデル」。1.7Bパラメータで、推論コードと学習済みモデルが公開されている。
DexForce / CUHK-SZ ほか / GitHub
#Spatial/3D#Motion/Body
WallGS Pro
3Dスキャン映像(Gaussian Splat)を Unreal Engine 5 の中でライティングし直せる有償プラグイン。静止の3DGSと動く4DGSの両方に対応し、Lumenの反射にもスプラットが映る。
Walhar Gohar
#Spatial/3D#CreatorTools
TACTYC Gaussian Splat v2.0
Gaussian Splatのスキャンを、Cinema 4D+Redshiftでレンダリング・リライトできる形に変換するプラグイン。粒ごとに小さなテクスチャ付きカードを作る方式。
TACTYC Studio
#Spatial/3D#CreatorTools
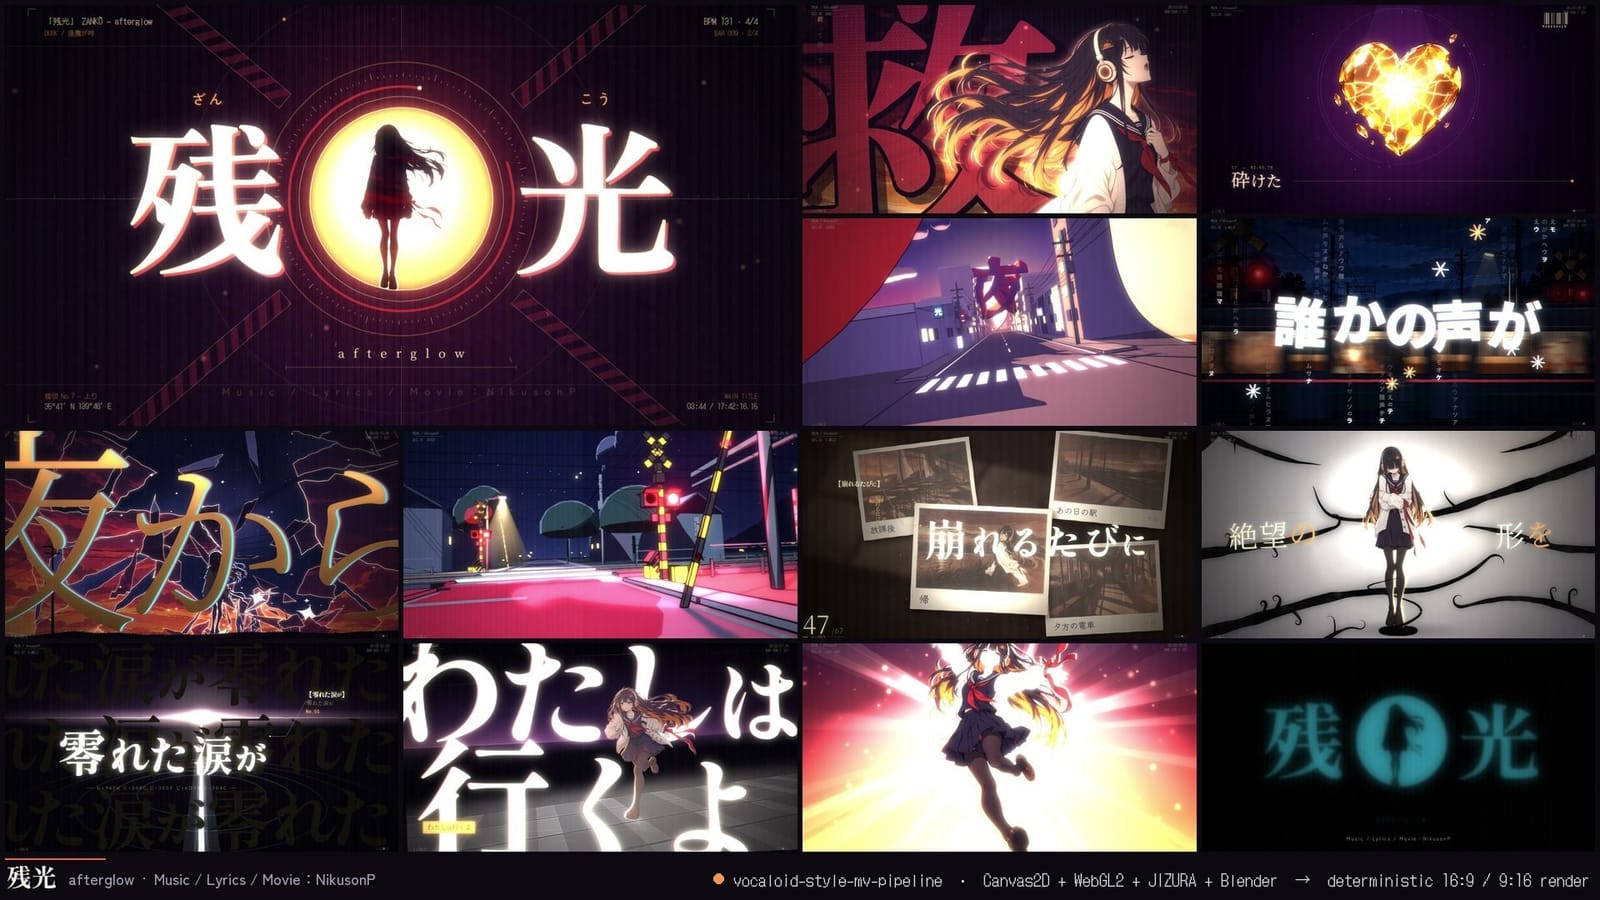
Vocaloid-Style MV Pipeline
ボカロ風の「手書き(tegaki)リリックMV」を、曲と歌詞から自動で作るためのClaude Code用スキル兼プロジェクト雛形。1曲3分46秒・68カット級の作例を約4分でレンダリングできる。
EGSECDA(個人開発者) / GitHub
#HCI/MediaArt#Audio/Music#CreatorTools
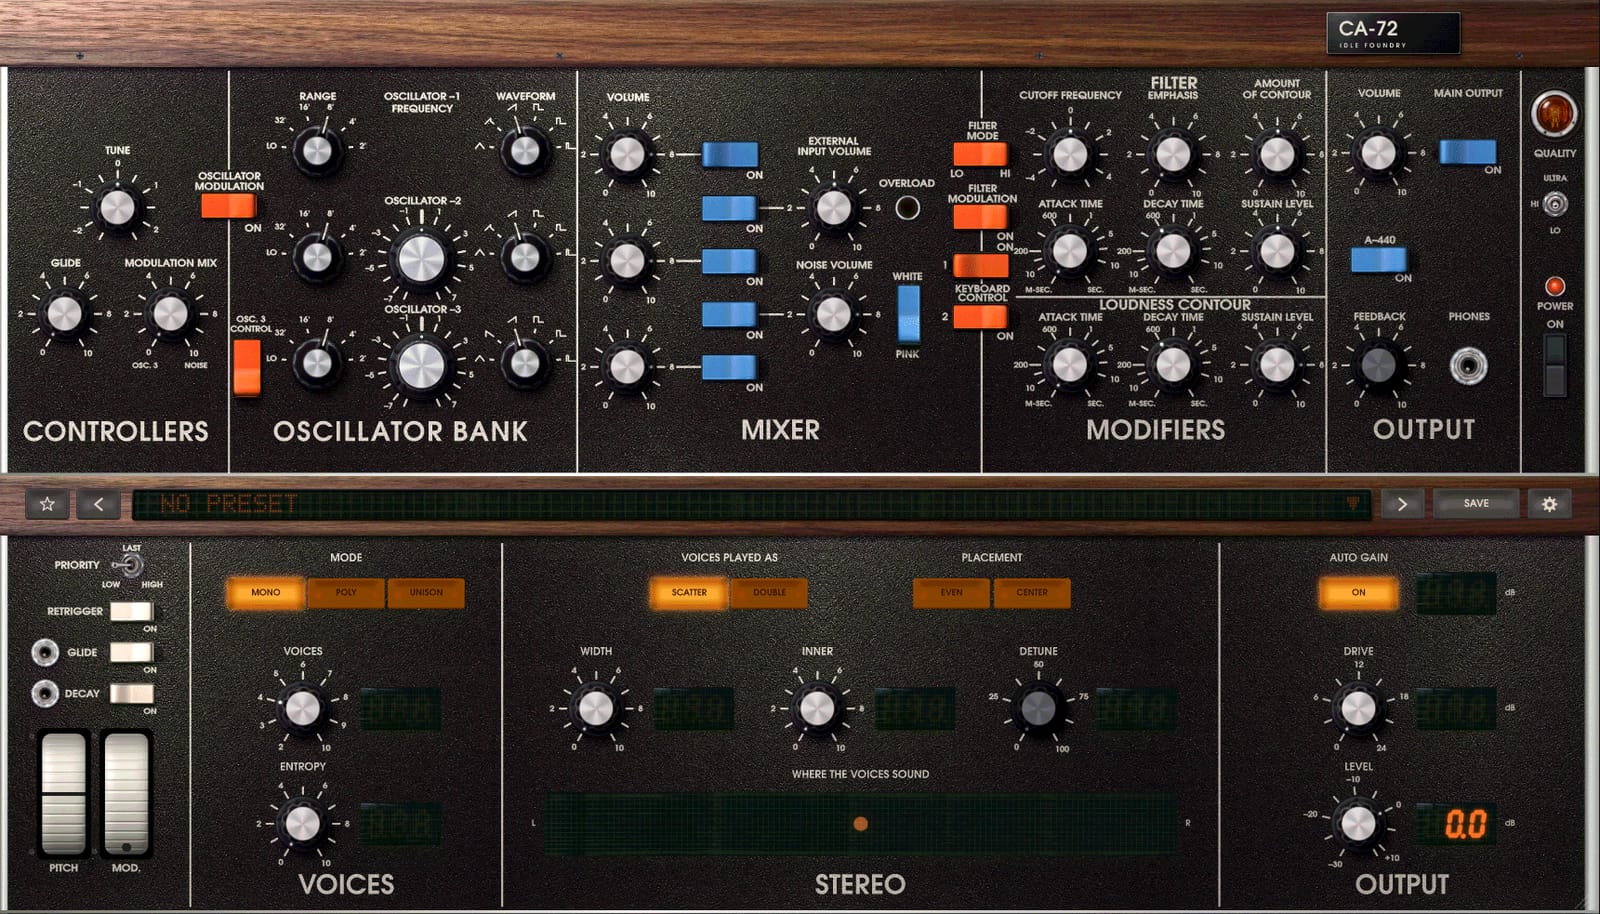
CA-72
1970年代前半のアナログ・モノシンセ(Minimoog Model D系)を、回路図レベルで再現した無料のシンセサイザープラグイン。VST3・CLAP・AUに対応し、Windows/macOS/Linuxで使える。
Idle Foundry Ltd. / GitHub
#Audio/Music
AutoSynth
「太いベース」のような文章や参考音を渡すと、完成した音そのものではなく、シンセサイザーのつまみの設定一式(音符・パラメータ・モジュレーション配線)を作ってくれるAI。出てきた音は、あとから人間がつまみで微調整できる。
Gus Xia 研究グループ(Tristan Wu, Daniel Chin, Liwei Lin, Junan Zhang, Gus Xia) / GitHub
#Audio/Music#CreatorTools#AI/Agents
MiniMax H3 Person Remover LoRA
動画内で緑にマスクした人物をAIで消し、背景を補完して復元するMiniMax H3用LoRAとComfyUIワークフロー。
Akatz Labs (akatz-ai) / GitHub
#GenVideo#CreatorTools
Kandinsky 6.0 Video
映像と44kHzの音声(リップシンク込み)を同時に作る動画生成モデルが、コード・重みともMITで公開された。3B(Lite)と29B(Pro)の2種類で、ComfyUIノードとDiffusers対応も用意されている。
Kandinsky Lab / GitHub
#GenVideo#Audio/Music
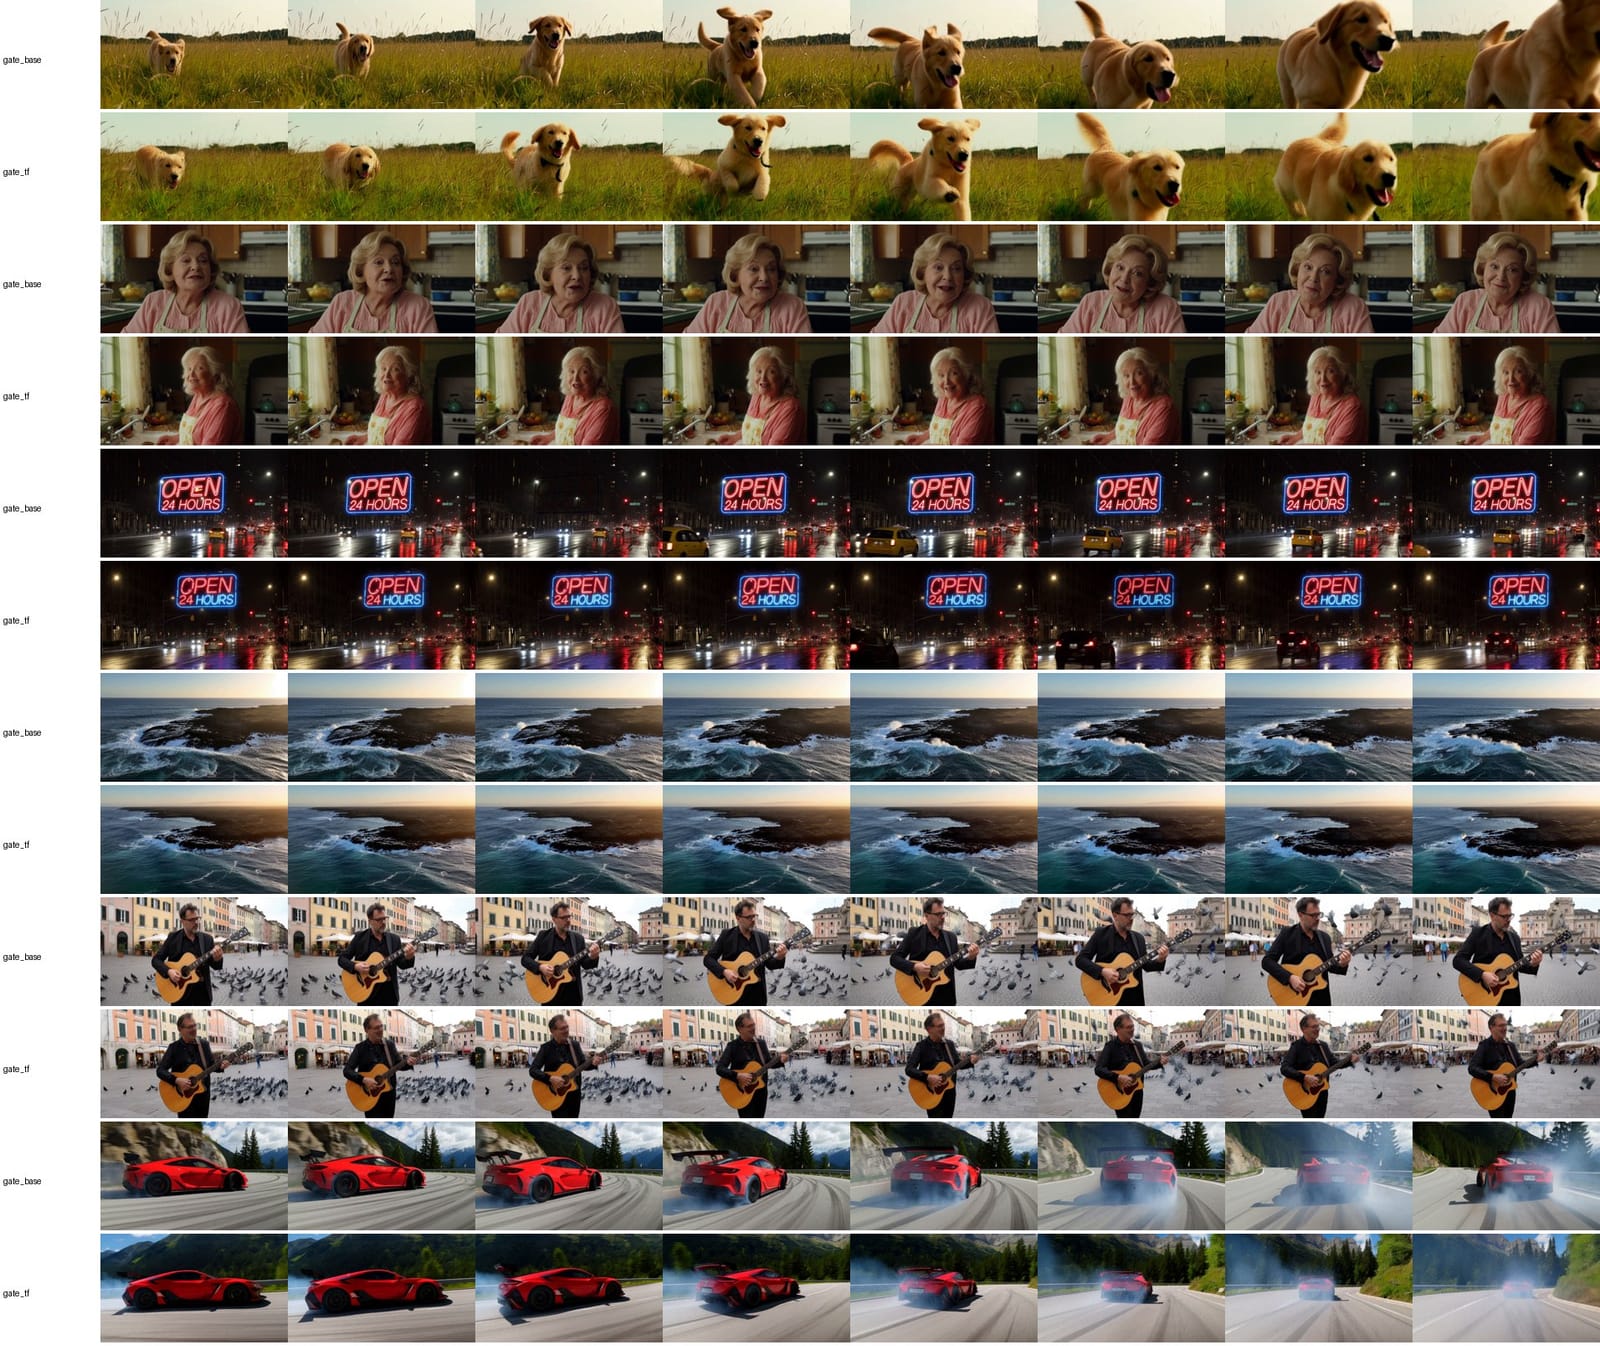
Veda Sparse Attention for ComfyUI (MiniMax-H3)
動画生成の最大の負荷であるアテンション計算の約9割を飛ばし、ComfyUI上のMiniMax-H3の生成を約2.9倍に高速化するカスタムノード。MODELにつなぐだけで使える。
Veda-Sparse (ByteDance / HKU) / GitHub
#GenVideo#CreatorTools
Long-WAM
ロボットの過去映像を最大19.2秒ぶん覚えさせ、未来の映像を予測しながら約0.1秒で動作を決めるワールドモデル。コード・学習済みモデル公開済み。
NVIDIA / MIT / HKU / UCSD / GitHub
#Spatial/3D#AI/Agents
Mobile-4DGS
静的な3Dシーンも動く4Dシーンも、スマホのブラウザ(WebGL)でリアルタイム表示できるGaussian Splatting軽量化手法。学習・描画コードを公開。
University of Technology Sydney / GitHub
#Spatial/3D
FlowHMR
1台のカメラで撮った普通の動画から、足が滑らず物理的に自然な3D人体モーションを取り出すモーションキャプチャ用の生成モデル。推論コード、チェックポイント、Web デモが公開済み。
FlowHMR authors(Zhanke Wang, Chengfeng Zhao, Qing Shuai ほか) / GitHub
#Motion/Body#AI/Agents
MotionPersona
「誰の歩き方か(人物)」「体型」「スタイル(怒り・酔っ払い・水泳など9種)」を指定して、キーボードやゲームパッド操作に応じて歩くキャラクターの動きをリアルタイム生成するモデル。コード・重み・リアルタイムデモが公開された。
Mingyi Shi, Wei Liu, Jidong Mei, Wangpok Tse, Rui Chen, Xuelin Chen, Taku Komura ほか(AIGAnimation) / GitHub
#Motion/Body#GenVideo
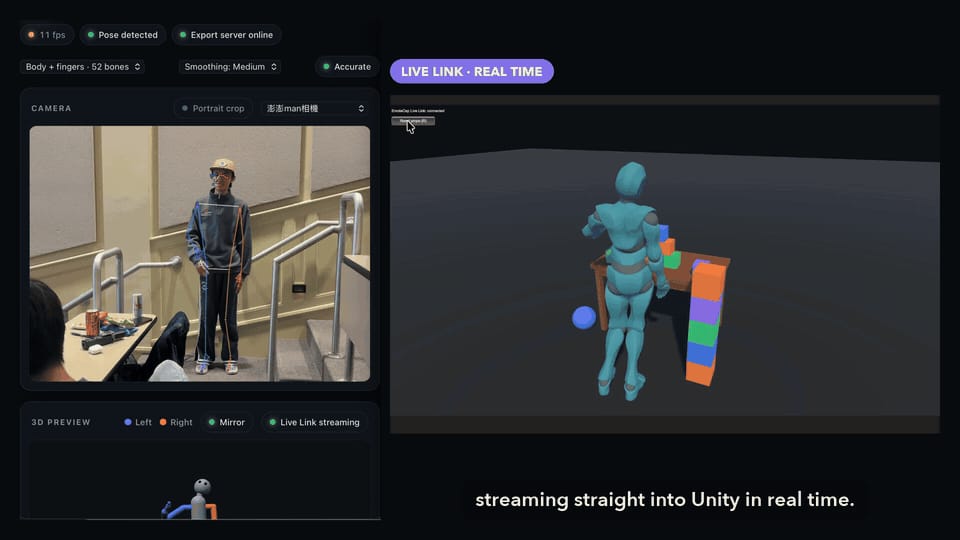
EmoteCap
ウェブカメラやiPhone動画、既存の動画ファイルから、スーツなしでUnity向けのヒューマノイドアニメーション(指30関節込み)を作るモーキャプツール。ハッカソン優勝作品。
eric20041027(HackNite Hackathon 2026 Overall Winner) / GitHub
#Motion/Body#CreatorTools
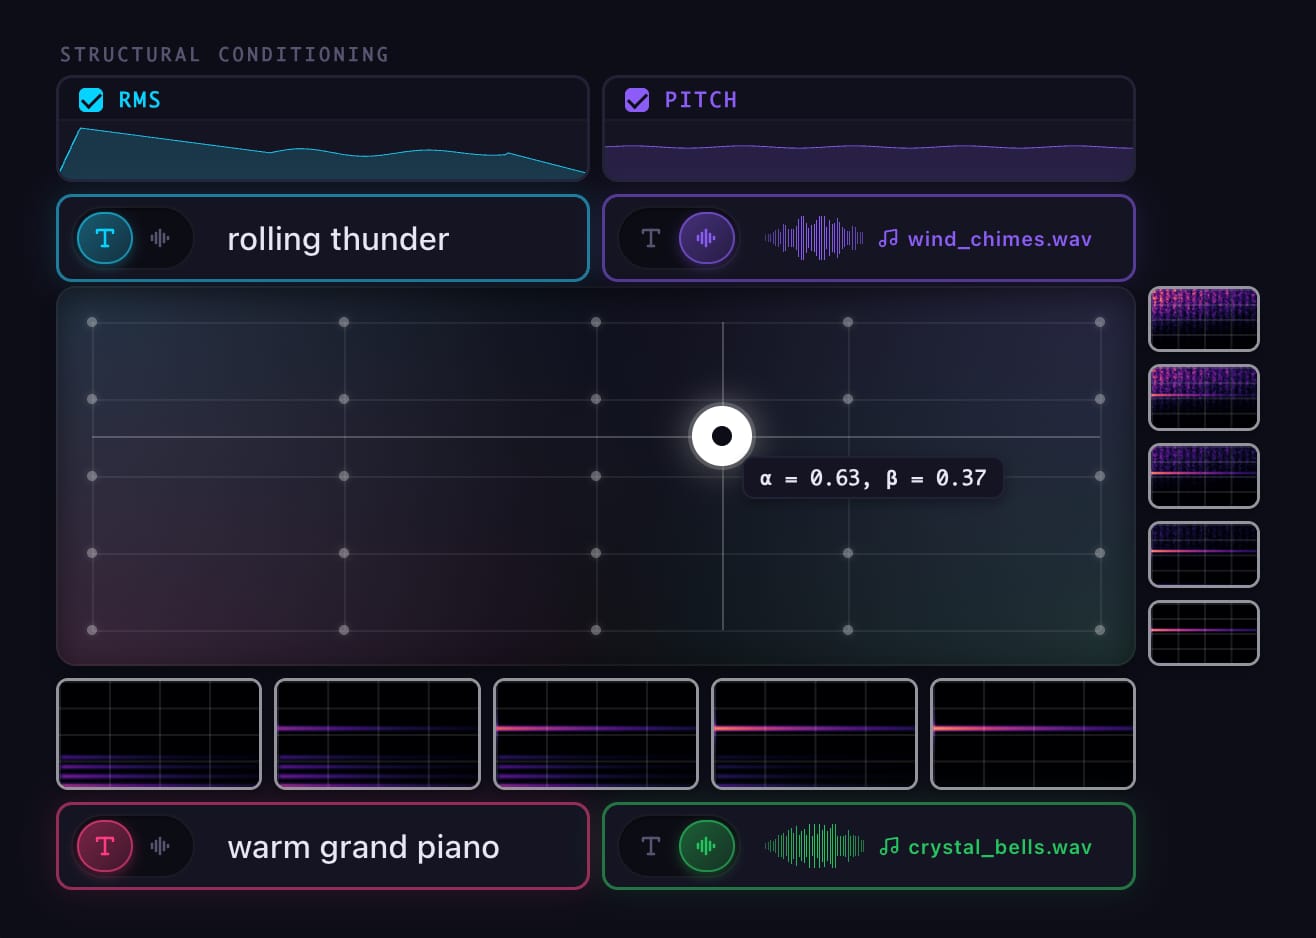
smorph (Playable Sound Morphing with Diffusion Models)
音の鳴り方(強弱・音程の動き)を保ったまま音色だけを別の音へ滑らかに変える、拡散モデルのサウンドモーフィング手法。2Dパッドで音色を弾いて探れるデモ付き(ISMIR 2026)。
Northwestern University / Adobe Research / Wizdom Music
#Audio/Music#HCI/MediaArt
SheetSage2
曲の音源(mp3など)から、メロディ・コード・拍・キー・曲の構成を読み取り、編集できる譜面(ABC記法)とMIDIに変換するAI。モデルの重みと推論コードが公開されている。
Multimodal Art Projection (M-A-P)
#Audio/Music
WorldSonus
映像を100ミリ秒ずつ流し込みながら、その場で48kHzのステレオ音を生成する「映像→音」モデル。再生中でも文字の指示を書き換えて音を変えられる。
HKUST / Noiz AI ほか / GitHub
#Audio/Music#GenVideo
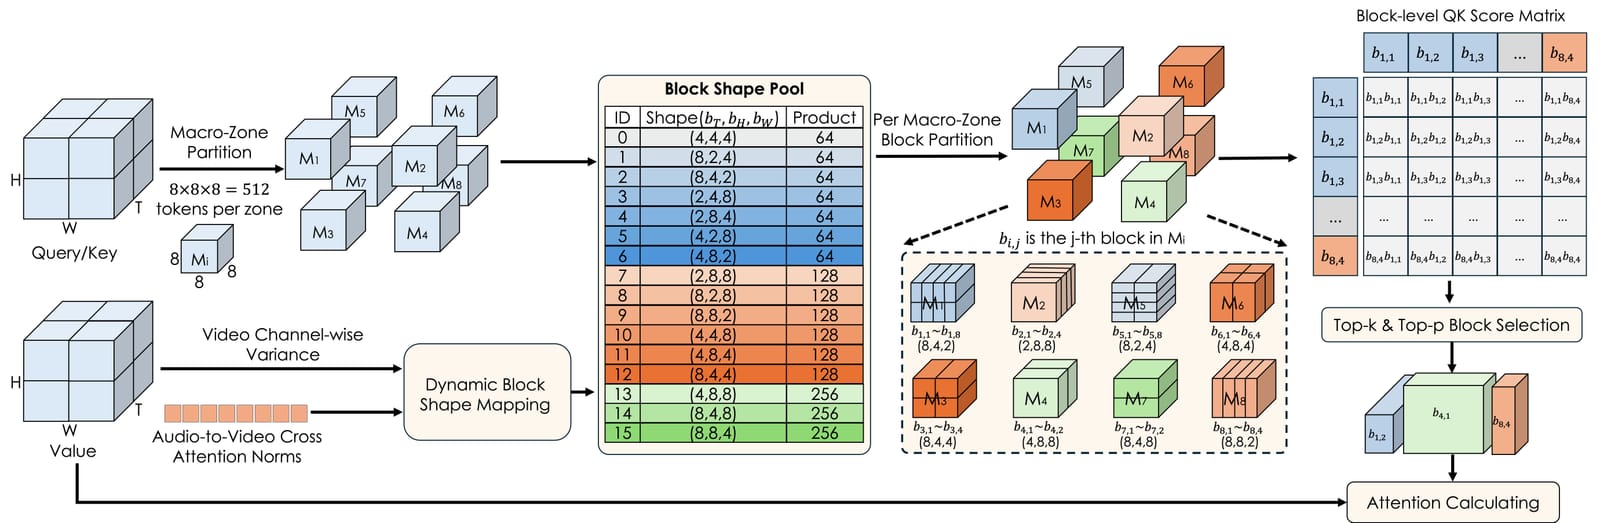
Prism(動的スパースアテンションによる2Kネイティブ映像+音声同時生成)
映像と音声を同時に作る生成AIを、2K(2560×1440)解像度で直接学習できるようにした動的スパースアテンション手法。訓練コード・推論コード・preview重みがMITで公開された。
Fudan University / Tencent Hunyuan Foundation Model Team / Zhejiang University / GitHub
#GenVideo#Audio/Music
Cinematic Director Camera DSL
「/MS /LOWANGLE /DOLLYIN:MS>MCU:SLOW」のような短い撮影用語を書くと、MiniMax H3・Kling・Veoなど各AI動画モデル向けのカメラ指示文に変換するDSL。Claude Codeスキル兼CLI。
Sidekick Animation Studio Ltd (SK-SL-source) / GitHub
#GenVideo#CreatorTools
MiniMax H3 on TensorFold(NVFP4 ComfyUIローダー)
MiniMax H3(音声付き動画モデル)をRTX 50シリーズ1枚で高速に動かす、ComfyUI用のドロップイン・ローダーノード。Windowsネイティブで標準の約2.3倍、Turbo LoRAと疎アテンション併用で最大7.7倍と報告。
jayleaton / GitHub
#GenVideo#CreatorTools
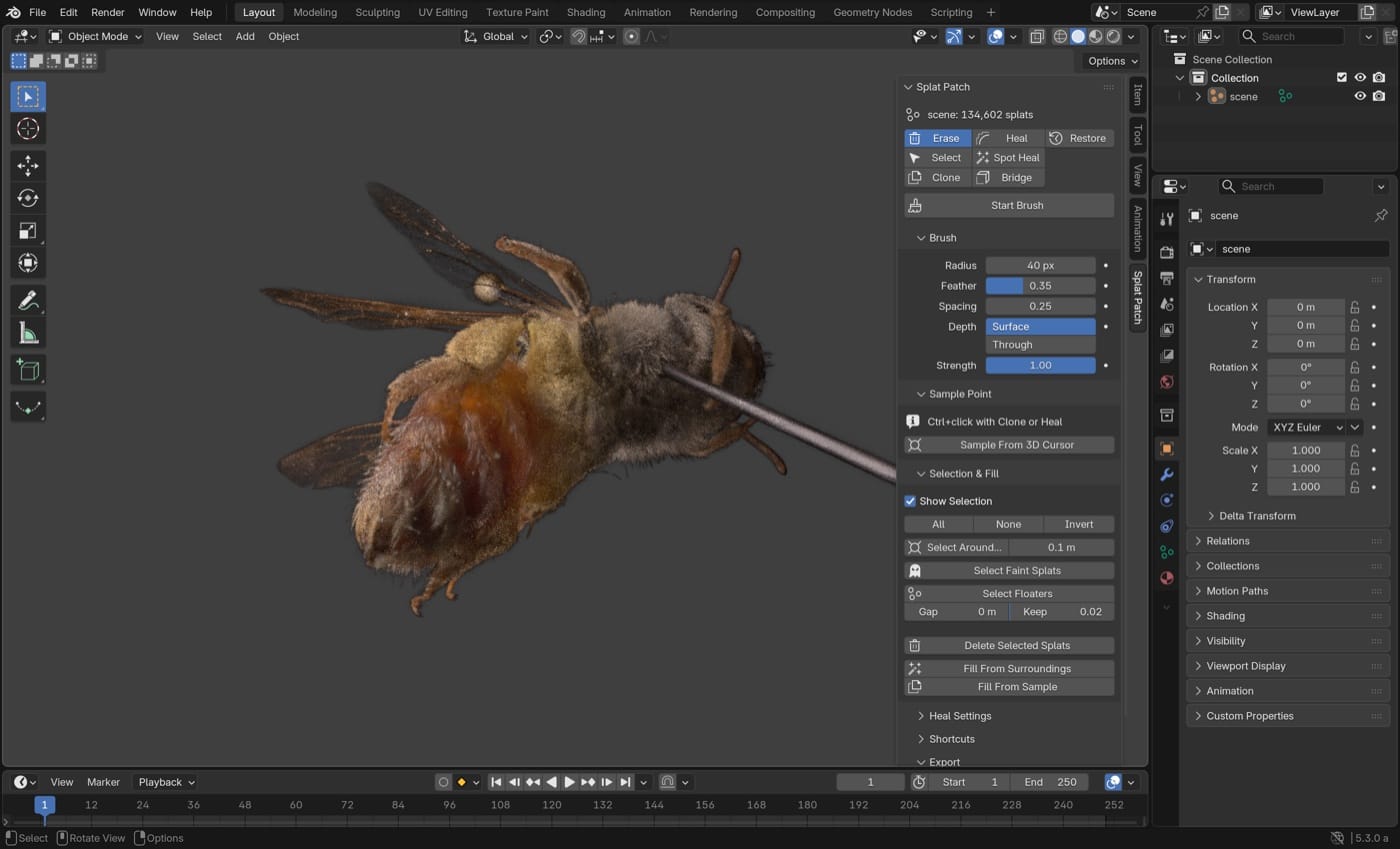
Gaussian Splat Patch
Gaussian Splat(写真から作る3Dスキャンデータ)を、Photoshopのスタンプやブラシのような感覚でBlender上で修正できる無料の拡張機能。不要物の消去、複製、色なじませ、穴埋めができる。
Tim Fennell(個人開発) / GitHub
#Spatial/3D#CreatorTools
Gaussian Render Capture
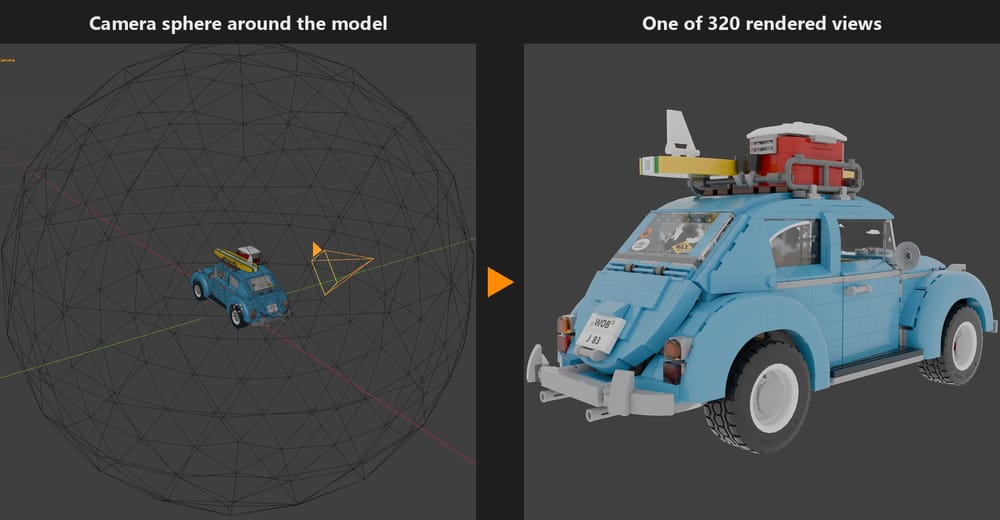
Blender上の3Dモデルから、Gaussian Splatting学習用のCOLMAP形式データセット(複数視点の画像+カメラ位置)を自動で作るアドオン。Postshot、LichtFeld Studio向け。
Michael Klein(virtualrepublic) / GitHub
#Spatial/3D#CreatorTools
giro
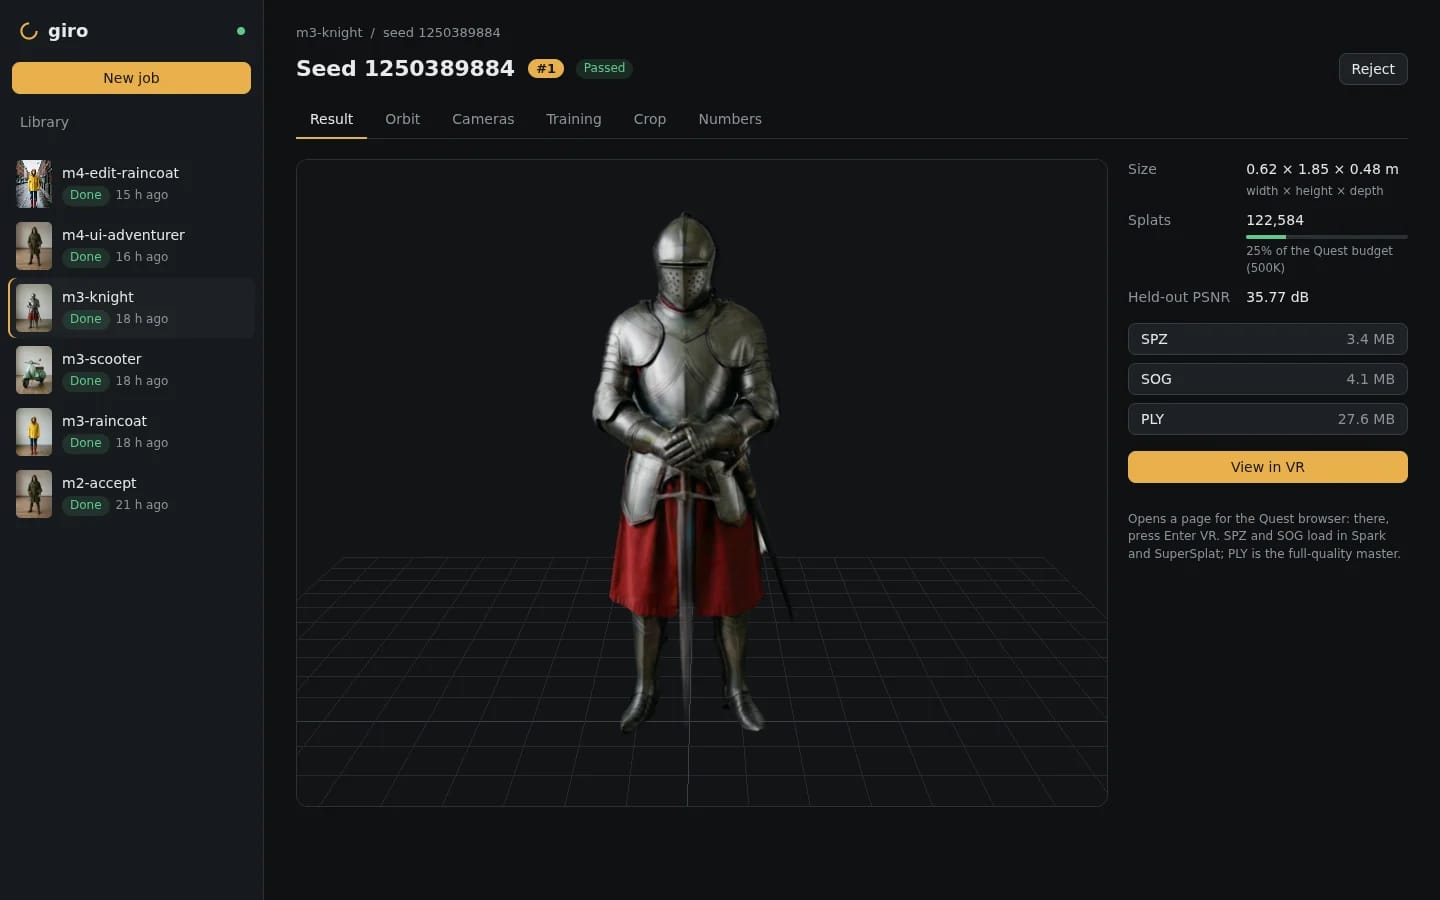
1枚の画像から360°周回動画をAIで生成し、そこからVR対応のGaussian Splatを作る実験的パイプライン。失敗した動画を自動で選別・再生成する品質ゲートが特徴。
kevinraymond(個人開発) / GitHub
#Spatial/3D#GenVideo
CozyClay
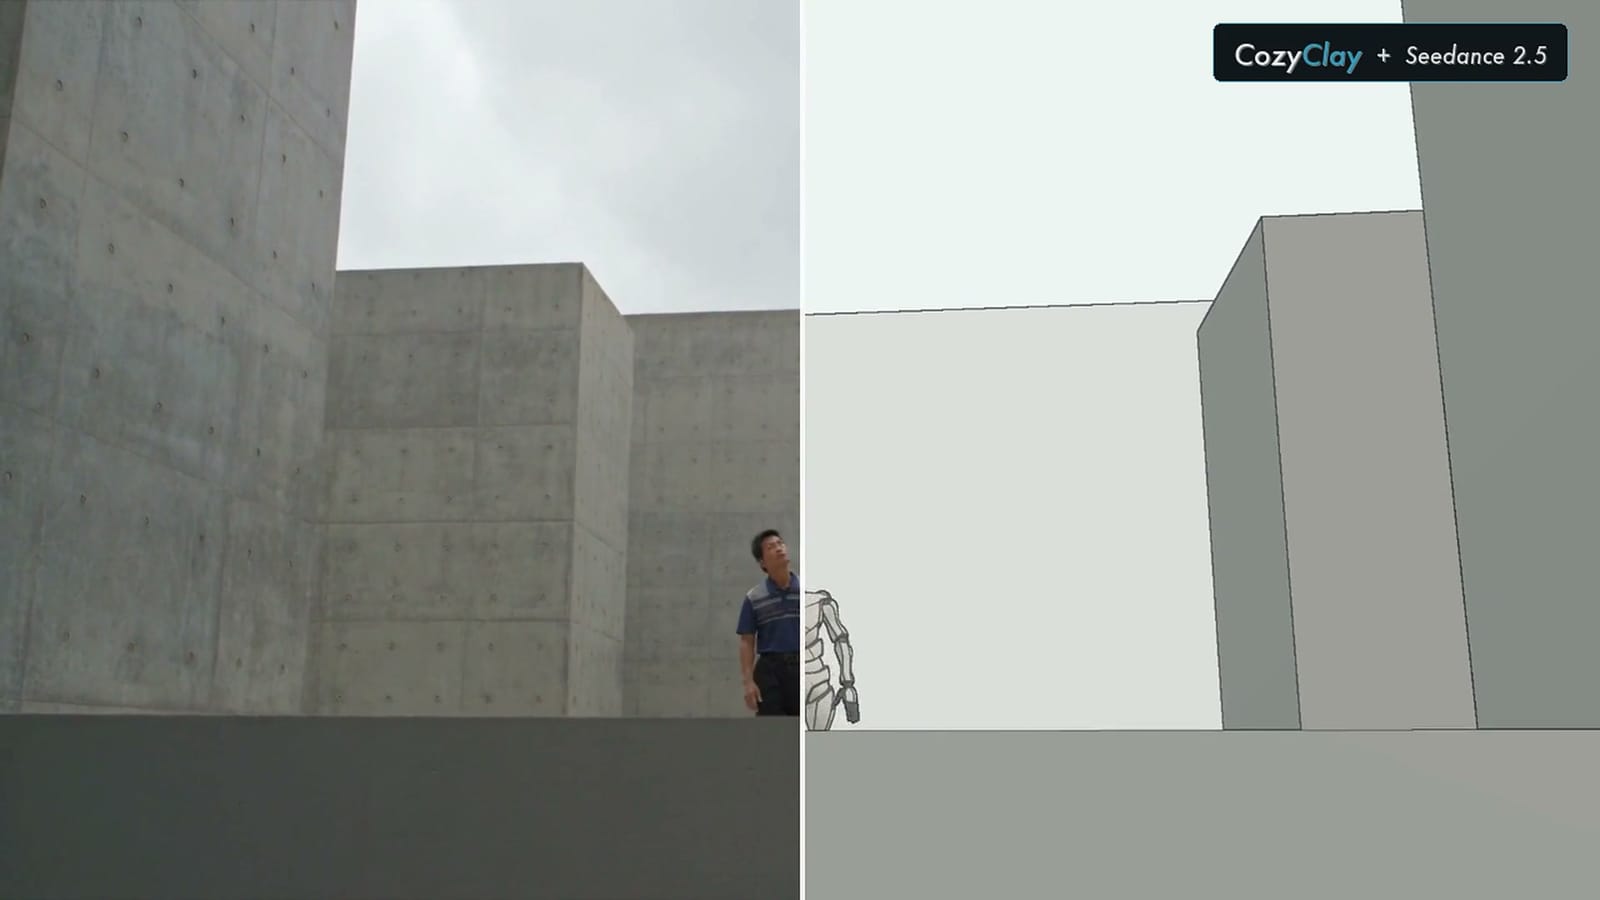
ブラウザだけで動くオープンソースのプリビズ(撮影前の仮映像)ツール。シーンを組み、キャラにポーズを付け、カメラのカットを切り、そのカットをAI動画モデルへ渡せる。
NomaDamas (Doyun) / GitHub
#CreatorTools#Motion/Body#AI/Agents
iki
Live2Dの代わりになることを狙った、無料・MITライセンスの2Dパペット(顔が動く2Dキャラ)エンジン。Claude Code用プラグインが、文章の指示からキャラの部品画像を作り、まばたきや視線などの動きまで自動で仕込む。
zeikar / GitHub
#CreatorTools#AI/Agents#Motion/Body
CurveCodec (AnimationCodec)
人・動物・ロボットなどどんな骨格のアニメーションでも、再学習なしで1/10以下に圧縮できるコーデック。SIGGRAPH Asia 2026採択で、コードと学習済み重みが2026年10月2日に公開された。
The University of Hong Kong / Adobe Research (Mingyi Shi, Huancheng Lin, Xuelin Chen, Taku Komura) / GitHub
#Motion/Body#CreatorTools
Audionaut
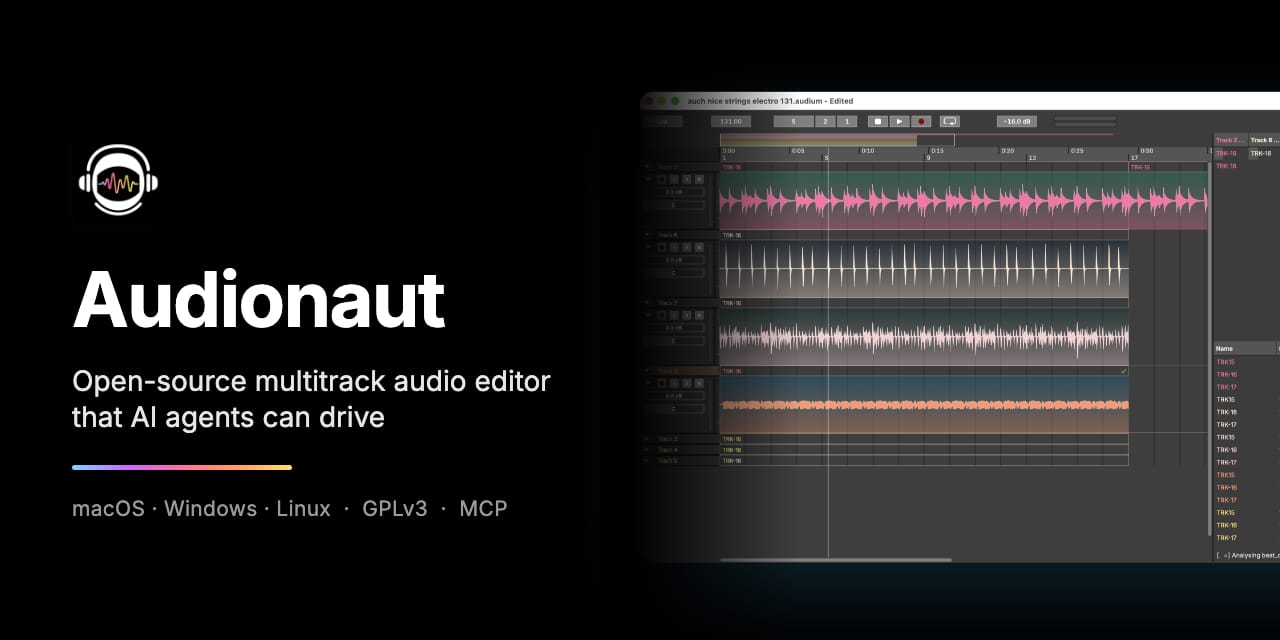
3〜4年かけて作られた、C++/JUCE製の無料オープンソース・マルチトラック音声エディタ。Claude CodeなどのAIエージェントからMCP経由で編集を指示できる。
kvoltmer(個人開発) / GitHub
#Audio/Music#CreatorTools#AI/Agents
This Is The Voice
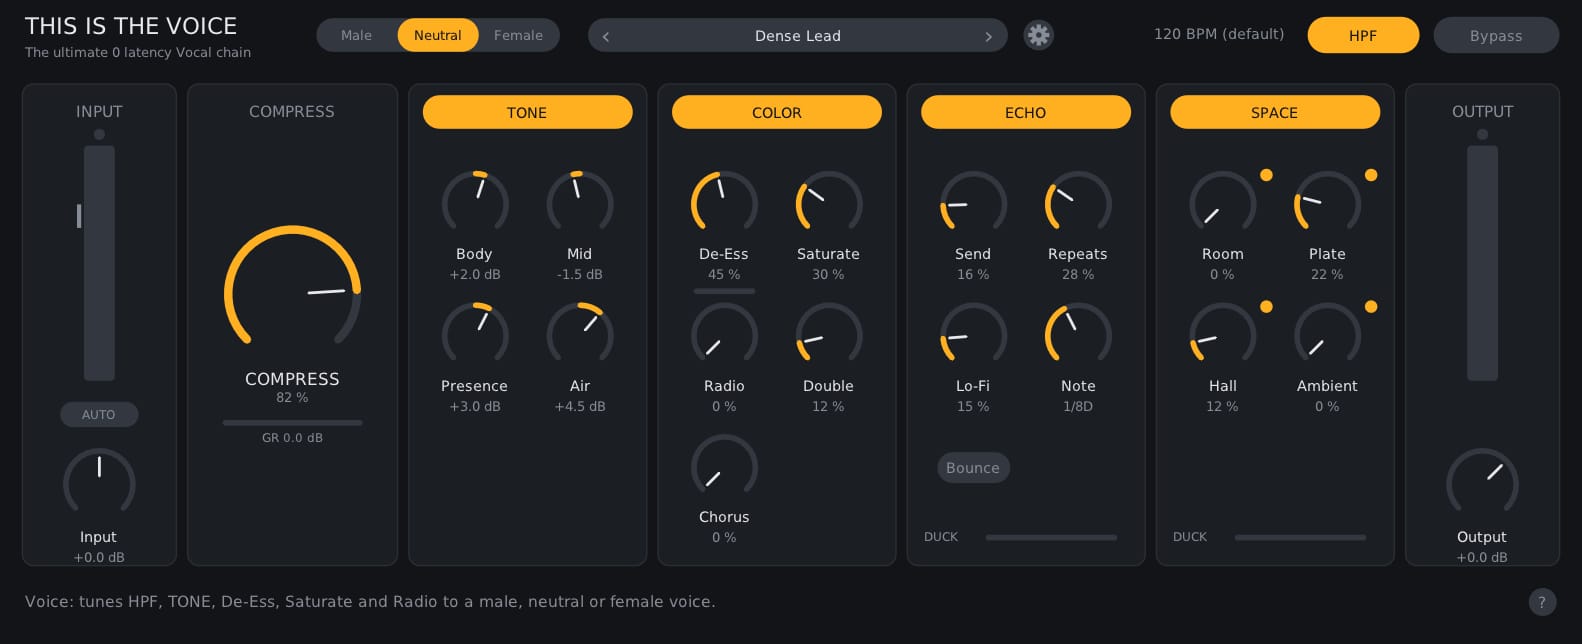
ボーカル録音〜仕上げに必要な処理を1つにまとめた、無料オープンソースのボーカルプラグイン(CLAP優先、VST3/AU/LV2対応)。報告レイテンシーがゼロなのが売り。
pehadavid(個人開発) / GitHub
#Audio/Music#CreatorTools
Iblis
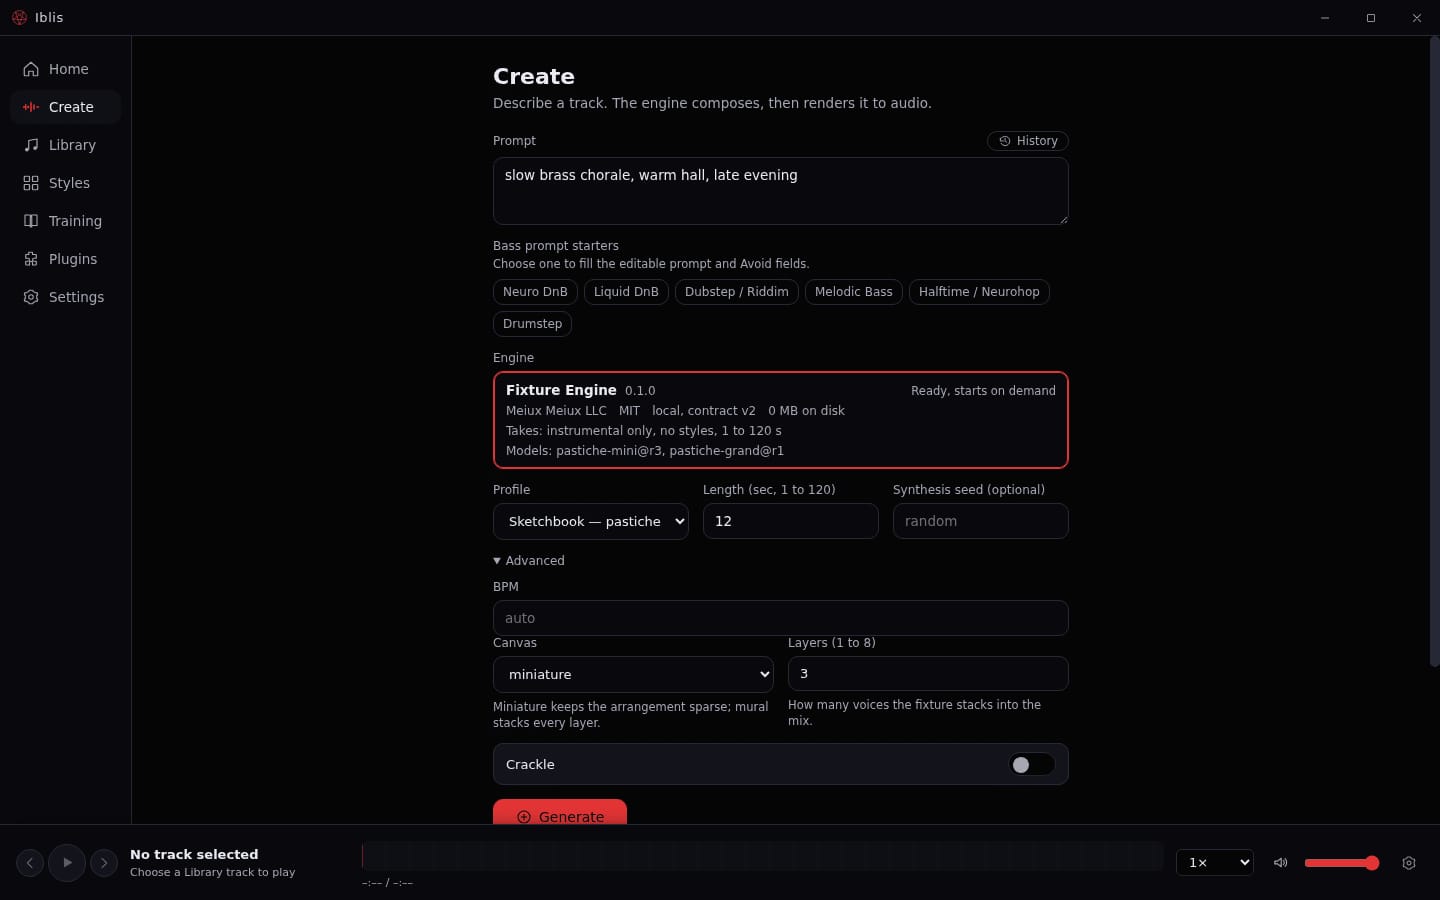
文章を書くだけで、自分のGPU上で曲を丸ごと作れるWindows用のAI音楽制作アプリ。手持ちの音源フォルダから「自分だけの音楽スタイル」を学習させる機能も付いている。インターネットに繋がなくても動き、無料で使える。
MeiuxMeiux(個人開発) / GitHub
#Audio/Music#CreatorTools
Vlo 0.3
ComfyUIを「生成エンジン」として裏で動かし、タイムラインで選んだ区間をそのままAI処理に回して編集レイヤーとして戻せる、無料・ローカル・オープンソースの動画エディタ。
PxTicks / GitHub
#CreatorTools#GenVideo
MiniMax-H3-Character-Swap-LoRA
元動画のシーンを保ったまま、指定した人物だけを参照画像のキャラクターに差し替えるMiniMax H3用の実験的LoRA。ComfyUIにサンプルワークフロー付きで公開。
akatz-ai
#GenVideo#CreatorTools
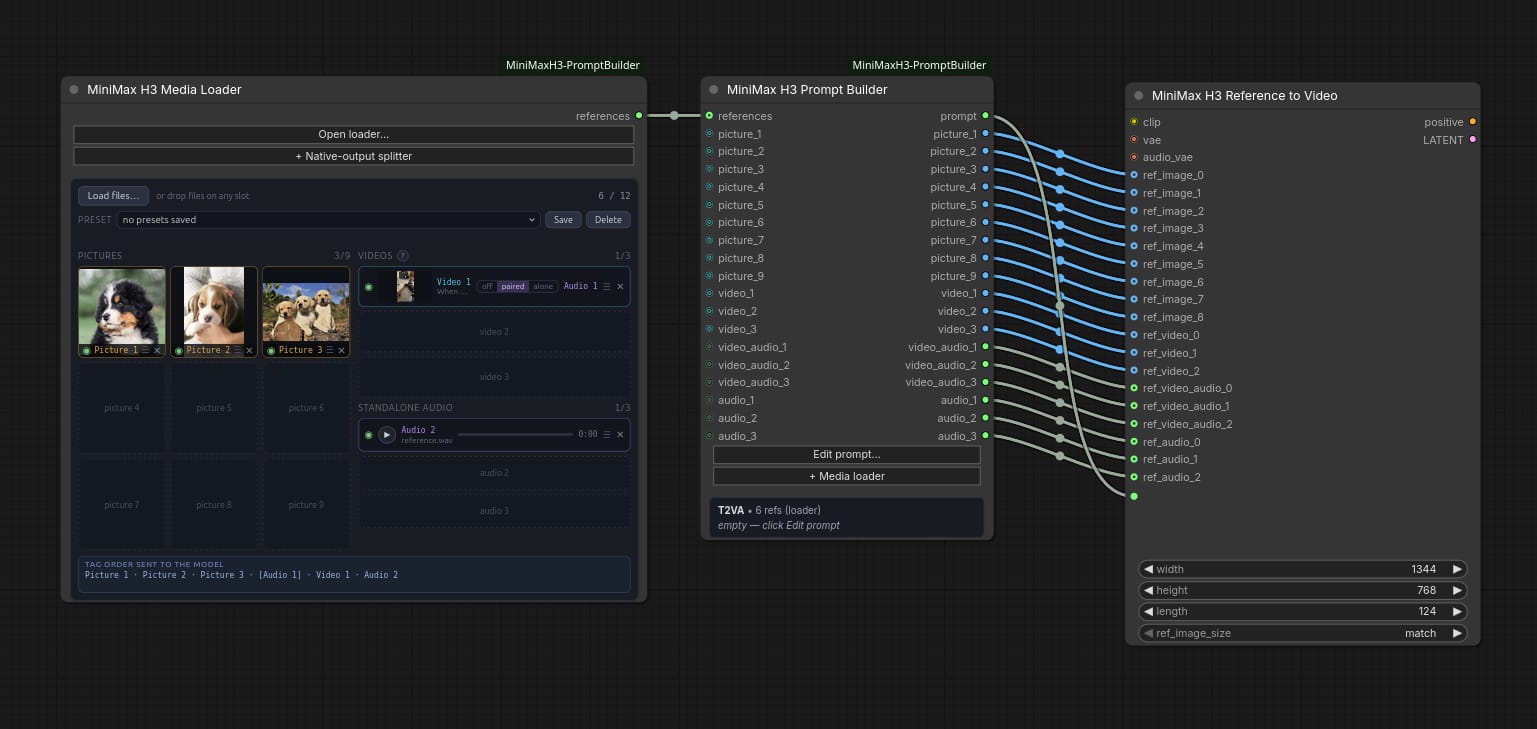
ComfyUI Fantastic H3 Prompt Builder 1.8(マスク編集対応)
MiniMax H3用の手動プロンプト作成・参照素材管理ノードに、SAM 3.1による『動画の一部だけを作り直すマスク編集』を追加したComfyUIカスタムノード集。
Adudeguyman / GitHub
#CreatorTools#GenVideo
Gausser
Cinema 4D上でGaussian Splat(実写をスキャンした点群風の3Dデータ)を読み込み、MoGraphで動かして各種レンダラーで出力できるプラグイン。
bezierking
#Spatial/3D#CreatorTools
MetalSplat
NVIDIAのGPU(CUDA)なしで、Apple SiliconのMac上でGaussian Splat(3DGS・2DGS)を学習できるOSS。Metalで書いたカーネルをPyTorchから使う。
Thibaut Chauffier / GitHub
#Spatial/3D
GAE (Geometry-Native Autoencoder)
1枚の画像やテキストから、カメラを動かせる「立体的につじつまの合う」映像を作る研究。映像と同時に奥行き(深度)や点群(.ply)も出力できる。コードと学習済み重みが公開済み。
Tencent ARC Lab / GitHub
#Spatial/3D#GenVideo
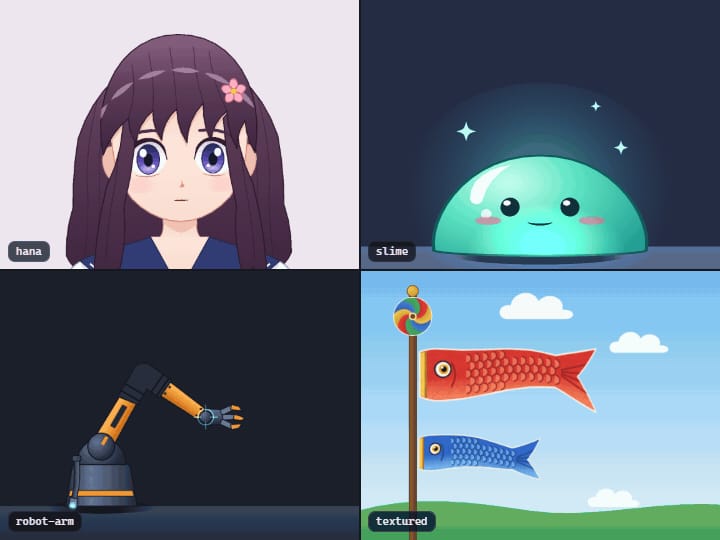
Rev2D
Live2DやSpineのような2Dキャラクターの「リグ(動かすための骨組み)」を、AIエージェントが読み書き・検証できる形で作れるOSSツールキット。9/25公開のv0.1。
RevStudio / GitHub
#Motion/Body#AI/Agents#CreatorTools
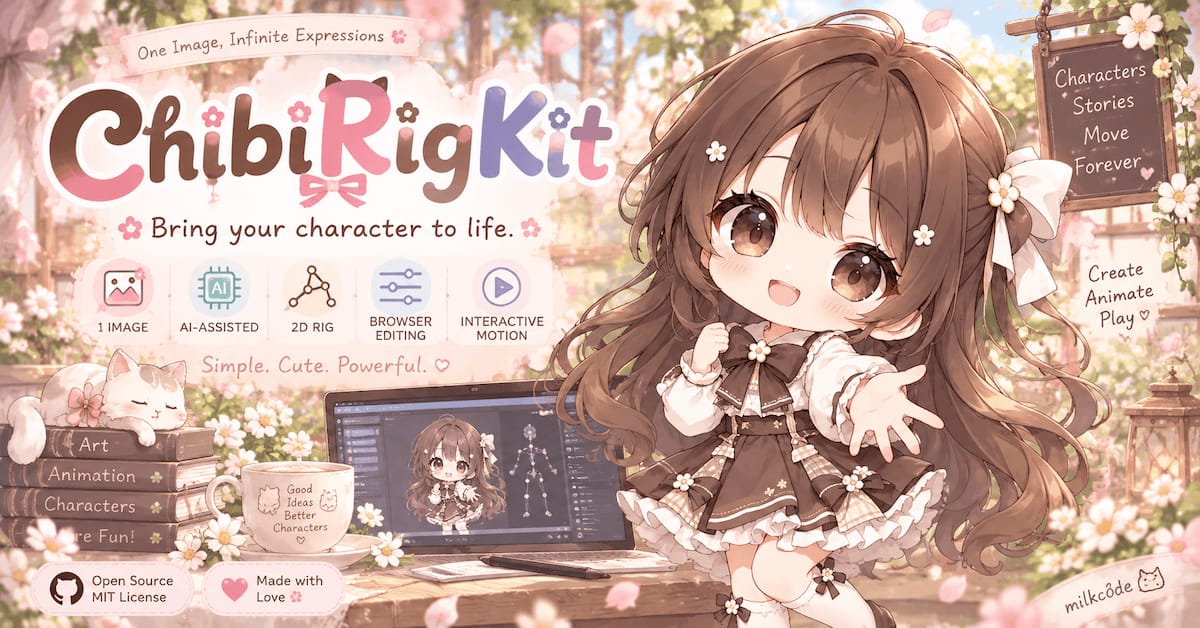
ChibiRigKit
1枚のキャラクターイラストから、まばたき・視線・首振り・揺れを持つ2Dキャラを作り、ブラウザで調整してWebMやOBS配信に使えるOSS。9/22公開のbeta。
milkc0de / GitHub
#Motion/Body#CreatorTools#HCI/MediaArt
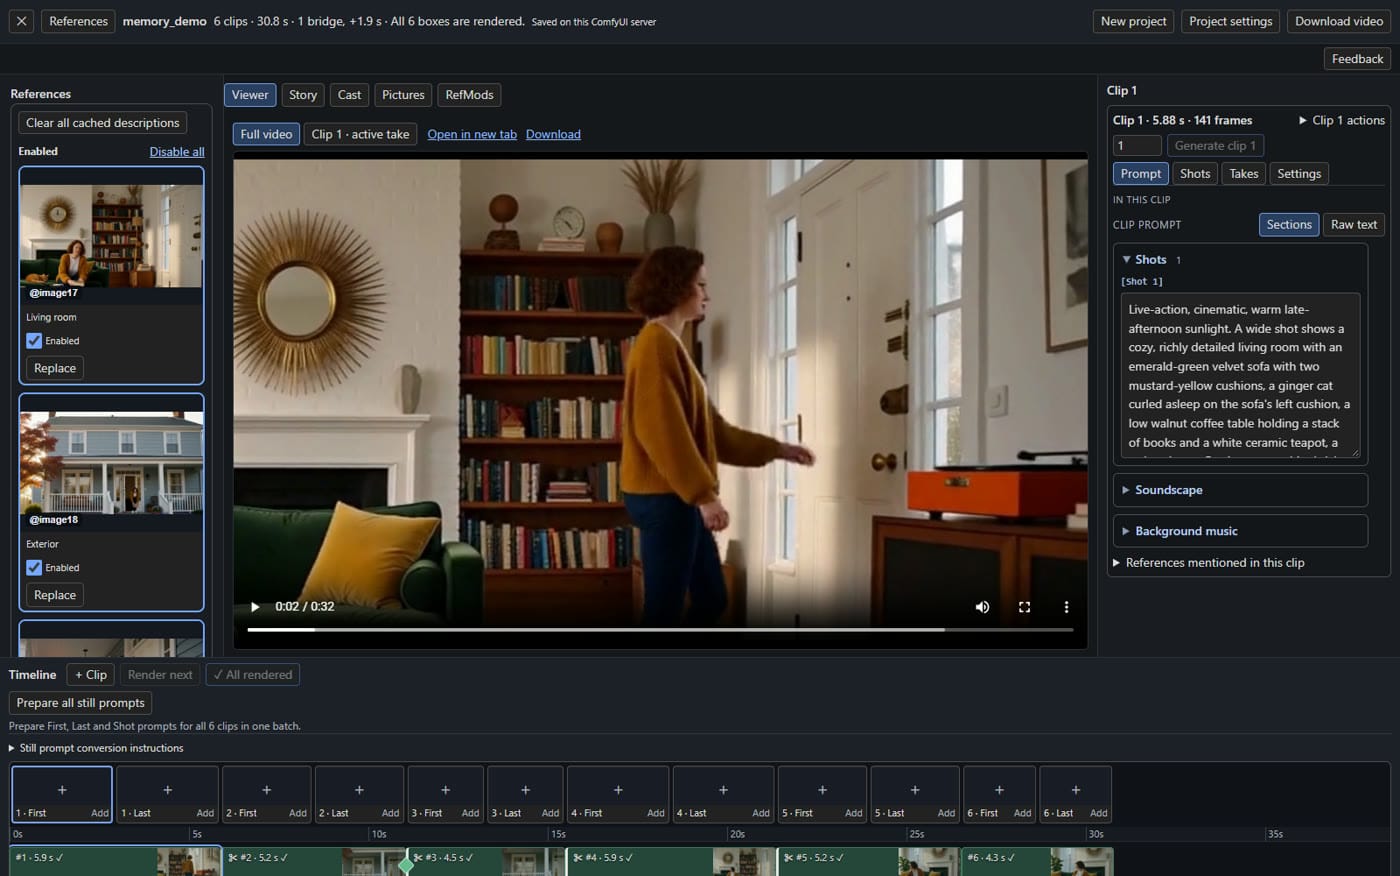
PuppetLoom
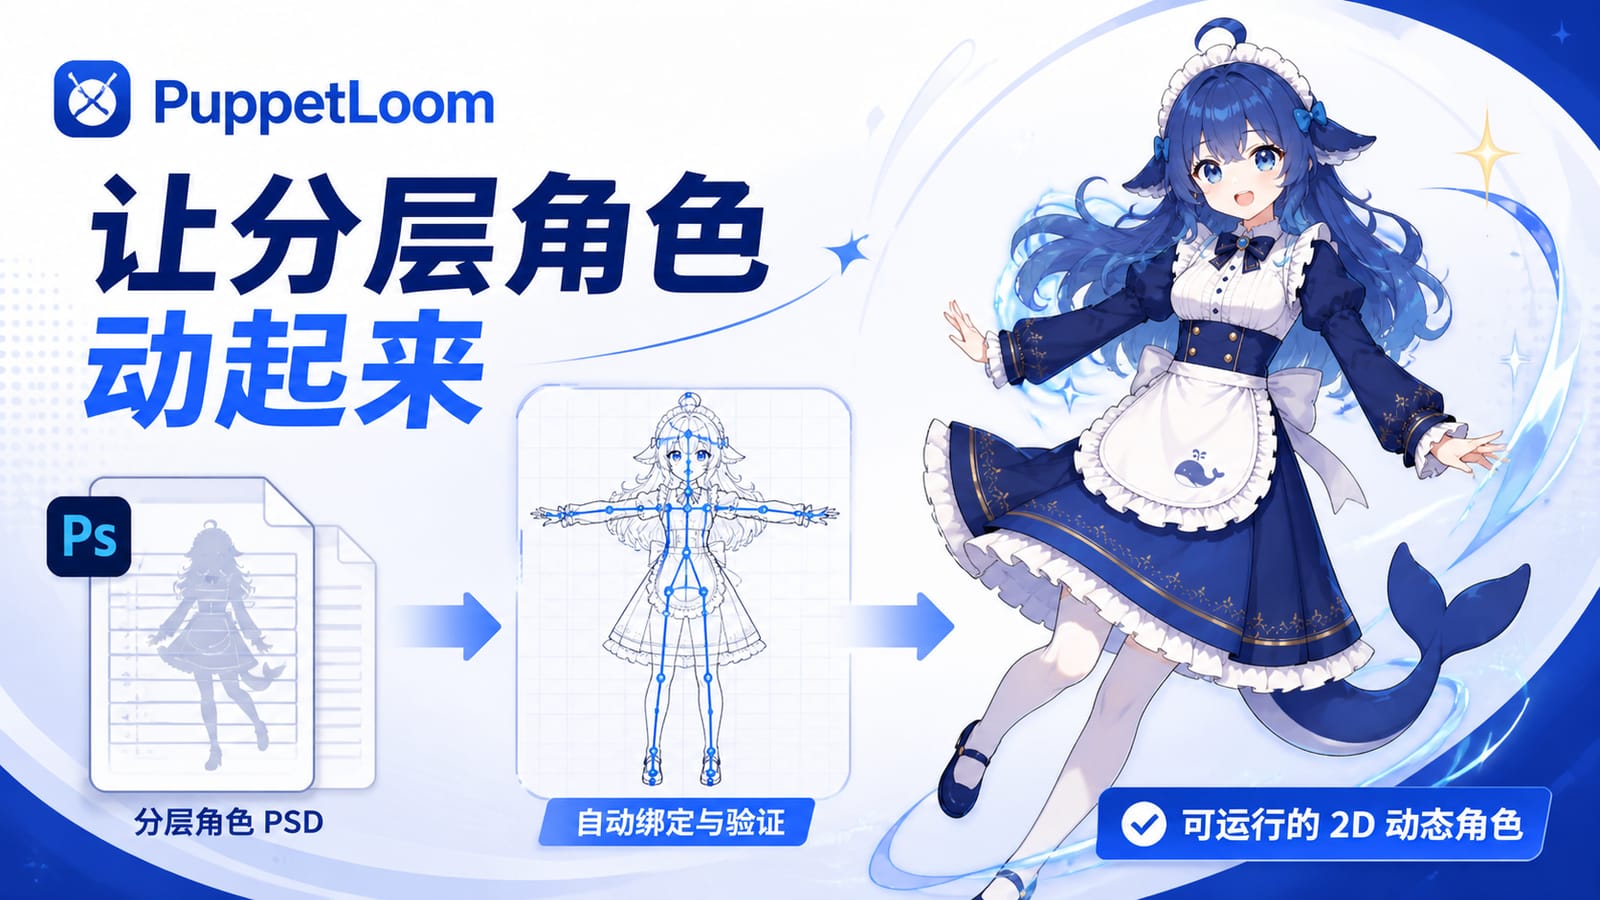
レイヤー分けされたキャラクターのPSDから、自動でリギング(動かすための骨組み作り)を行い、デスクトップ上で呼吸・視線・口パクをする2Dキャラクターに仕立てるWindows用OSSツール。外部のAIエージェントがCLI経由で作成・修正できる設計が特徴。
CheshireMew(個人開発) / GitHub
#Motion/Body#AI/Agents#CreatorTools
Open-Qwen-Music
歌詞・構成つきの文章から48kHzステレオ音楽を作る、「LLMが作曲→拡散モデルが音にする」2段構成のText-to-Musicを、学習データ・パイプライン・重みまで丸ごと公開した再現実装。
Yangbin Yu, Mingyu Yang(独立研究者による再現実装。Qwen公式ではない) / GitHub
#Audio/Music#AI/Agents
SwingScribe
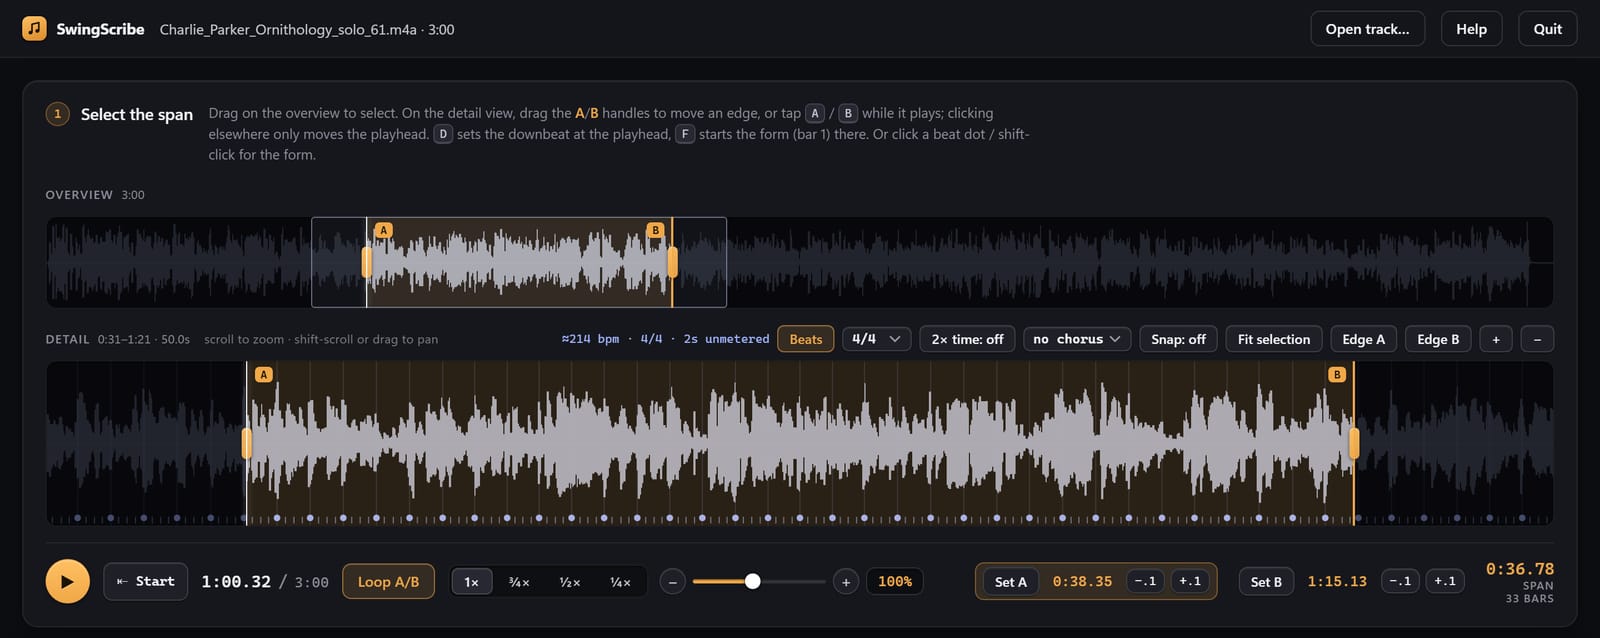
ジャズの録音からソロだけを取り出して譜面(MusicXML)に起こすWindows向け無料ソフト。スウィングの跳ねたリズムを、演奏者が読み慣れた「普通の8分音符+Swing記号」で書いてくれる。
elkayem(個人開発) / GitHub
#Audio/Music#CreatorTools
comfyui-obvpm-timeline
動画生成AI「MiniMax H3」で作った短い動画クリップを、ComfyUIの中でタイムライン上に並べ、延長・前足し・つなぎ直し・ループ化ができる編集ノード集。
chanon(個人開発) / GitHub
#GenVideo#CreatorTools
ComfyUI MiniMax H3 Extender
MiniMax H3で作った複数の動画クリップを、動きの文脈と音の連続性を保ったまま1本の長尺映像につなぐComfyUIノード。
tritant(個人開発) / GitHub
#GenVideo#CreatorTools
Minimax-h3_Third_person_view LoRA
MiniMax H3向けのLoRA(追加学習の小さな部品)。三人称・一人称視点のゲーム風カメラワークとHUD表示を映像に出しやすくする。
WarmBloodAban(個人)
#GenVideo#CreatorTools
UniQuery4R
動画中の任意の点を指定するだけで、その点の将来位置・3D座標・動きの向き・奥行きを1つのモデルでまとめて予測する4Dシーン復元技術。
Kosmo Research (Jilin University, Tsinghua University 共同) / GitHub
#Spatial/3D#Motion/Body
WorldCrafter
1枚の画像やテキストから『自由に歩き回れる3D空間』を動画として生成し、一度見た場所に戻っても景色が矛盾しないカメラ操作可能な動画生成AI。
Tencent ARC Lab (Tencent IEG) × Peking University / GitHub
#Spatial/3D#GenVideo
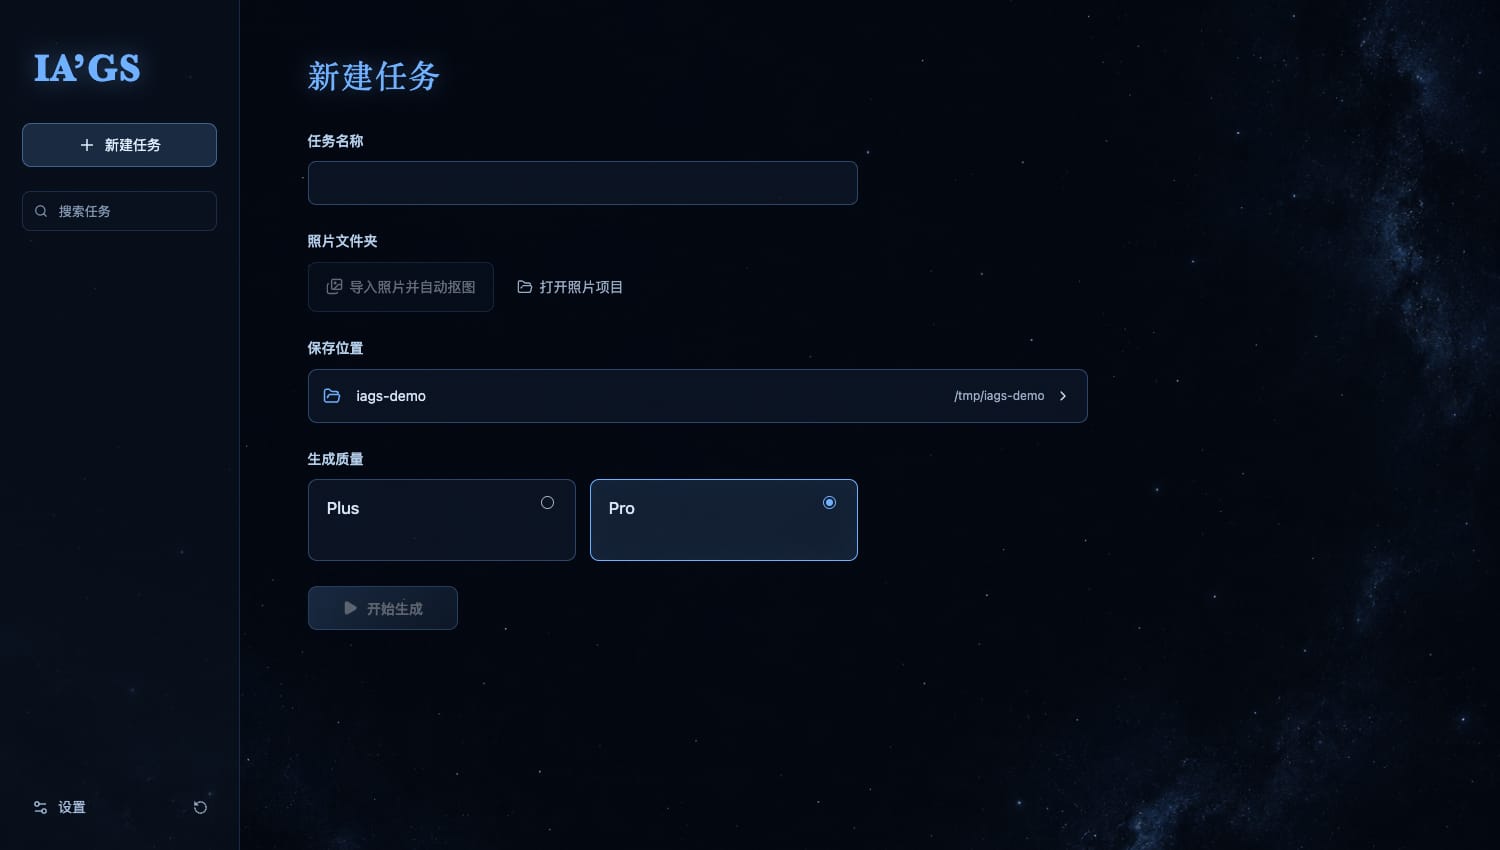
IA'GS (IA-GS)
スマホで撮った写真の束を、Macだけで自動的に『自由に見回せる立体写真(3D Gaussian Splatting)』に変換してくれる無料の専用アプリ。
by-lastime(個人開発、OOOSplat/Brushベースの独立派生) / GitHub
#Spatial/3D#CreatorTools
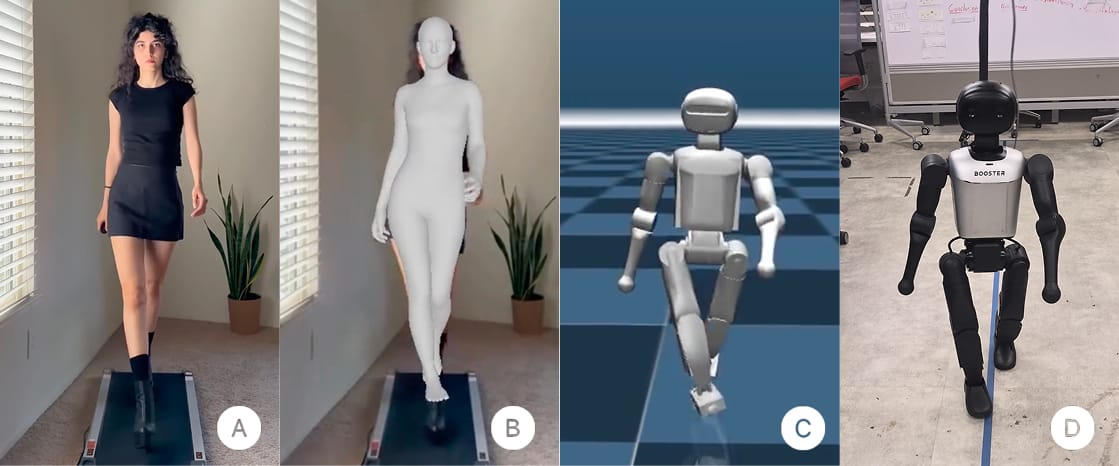
Expressive Motion (Learning Expressive Humanoid Locomotion from Monocular Runway Videos for Robot Fashion Shows)
ファッションショーのランウェイ映像1本から人間の歩き方の「らしさ」をヒューマノイドロボットBooster K1に転写し、実機で20回連続無転倒のキャットウォークを再現したパイプライン。
Advanced Telerobotics Research Lab, Kent State University / Vilnius University / GitHub
#Motion/Body#HCI/MediaArt
AX (Agent Executor)
自律型AIエージェントを何千・何百万規模で同時に走らせ、待機中は自動休止させてコストを抑える、GoogleがApache 2.0で公開したエージェント実行基盤。
Google / GitHub
#AI/Agents#CreatorTools
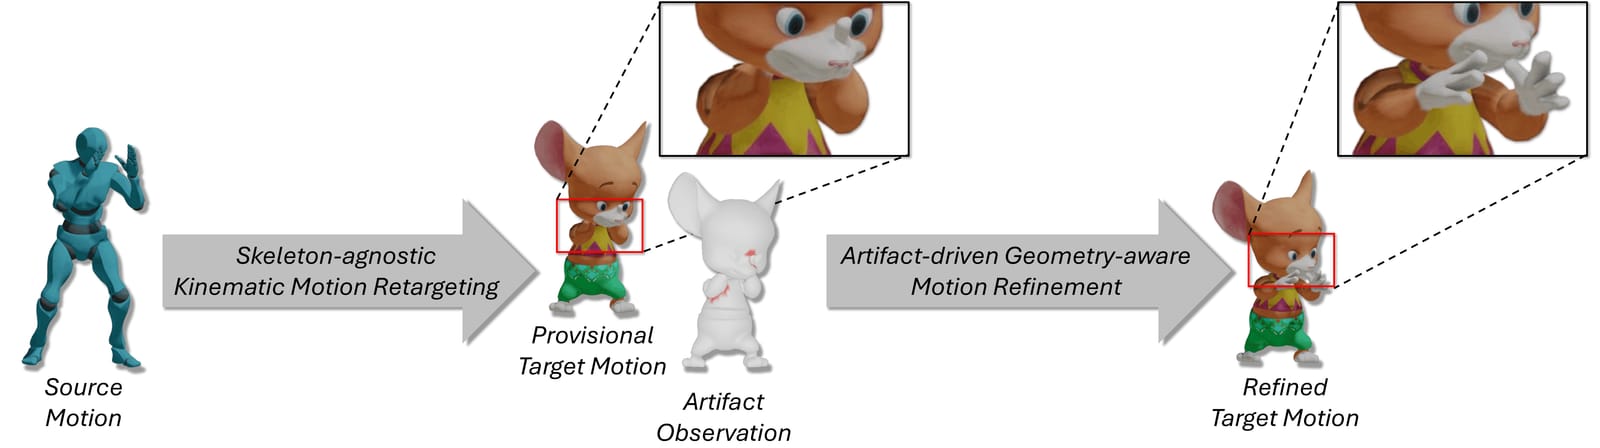
Skinned Motion Retargeting via Artifact-driven Kinematic Prior Refinement
モーションキャプチャの動きを体型の違うキャラクターに転写する際に起きる「体のめり込み」を、AIが自動検出して修正する技術。
KAIST (Seokhyeon Hong et al., SIGGRAPH Asia 2026 Journal Track) / GitHub
#Motion/Body#Spatial/3D
MuLaCover
既存曲のメロディ・コード進行の『骨格』だけを保ったまま、歌詞やジャンル・雰囲気を丸ごと差し替えてカバー曲やリミックスを自動生成できるオープンソースAI。参照音源または鼻歌代わりのMIDIから、制御可能に楽曲を作り直せる。
HeartMuLa / GitHub
#Audio/Music#CreatorTools
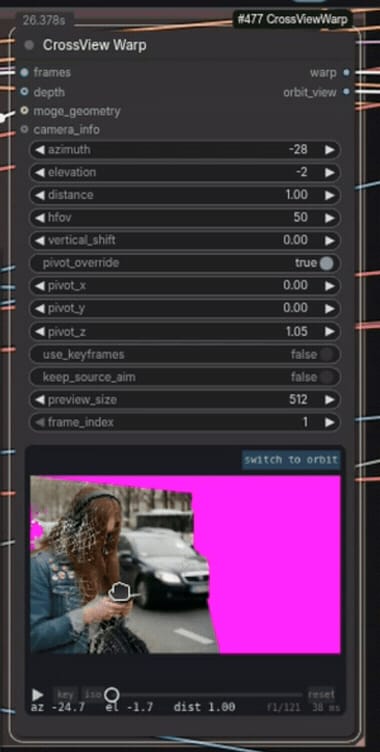
CrossView-Warp
既に撮影した動画クリップを、実際には撮っていない別のカメラアングルから見た映像に描き直す技術。奥行き情報をもとに画面を立体的に組み替え、新しいカメラ位置から見た映像をAIに生成させる。
Cseti(個人開発者) / GitHub
#GenVideo#CreatorTools#Spatial/3D
MiniMax H3 VFX Edit & Style Transfer LoRAパック
動画に『雨を降らせる』『映画風の色味にする』といった編集をテキストで指示するだけで加えられるAI用の追加学習データ(LoRA)セット。元の動きや構図を保ったまま見た目だけを変えられる。
Alissonerdx(個人開発者)
#GenVideo#CreatorTools
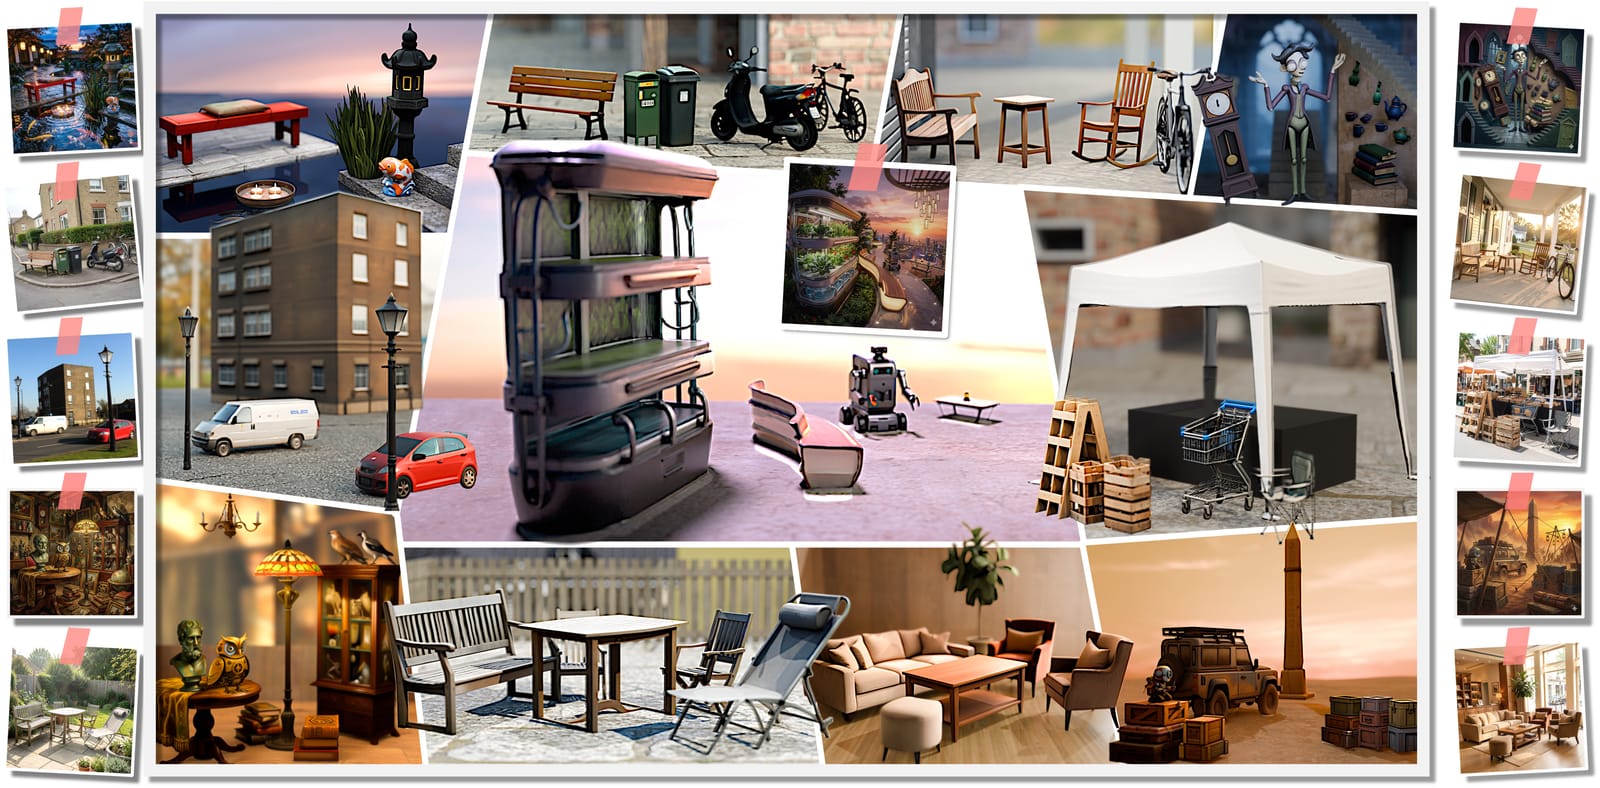
Mira-Scene
1枚の写真から、家具や物体がそれぞれ独立したパーツとして配置された『編集できる3Dシーン』を自動生成する研究。香港大学とVAST AI Researchによる。
VAST AI Research / The University of Hong Kong / GitHub
#Spatial/3D#CreatorTools
gs-object-extraction
学習済みの3D Gaussian Splattingシーンから、狙った物体だけをクリックで選んで単独の3Dデータ(PLYファイル)として切り出せる無料オープンソースツール。
07LEE(個人開発者) / GitHub
#Spatial/3D#CreatorTools
VGGT-Ω (VGGT-Omega)
複数枚の写真や動画からカメラ位置・角度・深度を数秒で一括推定するMeta×Oxfordのモデル。2026年9月に自前データで再学習できる訓練コードが新規公開された。
Meta AI (FAIR) × University of Oxford VGG / GitHub
#Spatial/3D#CreatorTools
SoL-Pi
AIコーディングエージェントのトークン浪費を自動発見・削減するNVIDIA研究の拡張機能。API利用コストを最大49%削減。
NVIDIA (NVlabs) / GitHub
#AI/Agents
Animcraft 6.0(AIリギング/テキスト→アニメーション機能)
Maya・3ds Max・Blender等をまたぐアニメーション素材ライブラリAnimcraftに、AI自動リギングとNVIDIA Kimodoベースのテキスト→モーション生成機能が9月に追加された。
Basefount / GitHub
#Motion/Body#CreatorTools
HyperFlow (MiniMax-H3 8-step LoRA)
動画生成モデルMiniMax-H3を、通常49回の計算ステップから8ステップに圧縮するLoRA。生成時間を約3分の1に短縮できる。ComfyUI用ノードも公開済み。
Video Rebirth / GitHub
#GenVideo#CreatorTools
Timeline Studio (ai-video-editor)
ブラウザ上で動く、ローカル完結型の動画編集ソフト。人間とAIエージェントが同じタイムラインを編集でき、9月にWebMCP経由の編集ツール21種が追加された。
MartinDelophy / GitHub
#CreatorTools#GenVideo#AI/Agents
FastH3 (FastVideo FastH3 8-Step V2)
音声つきの動画生成モデルMiniMax H3を、わずか8ステップで動画と音声を同時に作れるよう蒸留(軽量化)した公開チェックポイント。ComfyUI v0.36.0から標準で使え、DGX SparkやM4 Max搭載Macなど手元の機材でも動かす手順が公開された。
Hao AI Lab (UCSD) / FastVideo / GitHub
#GenVideo#CreatorTools
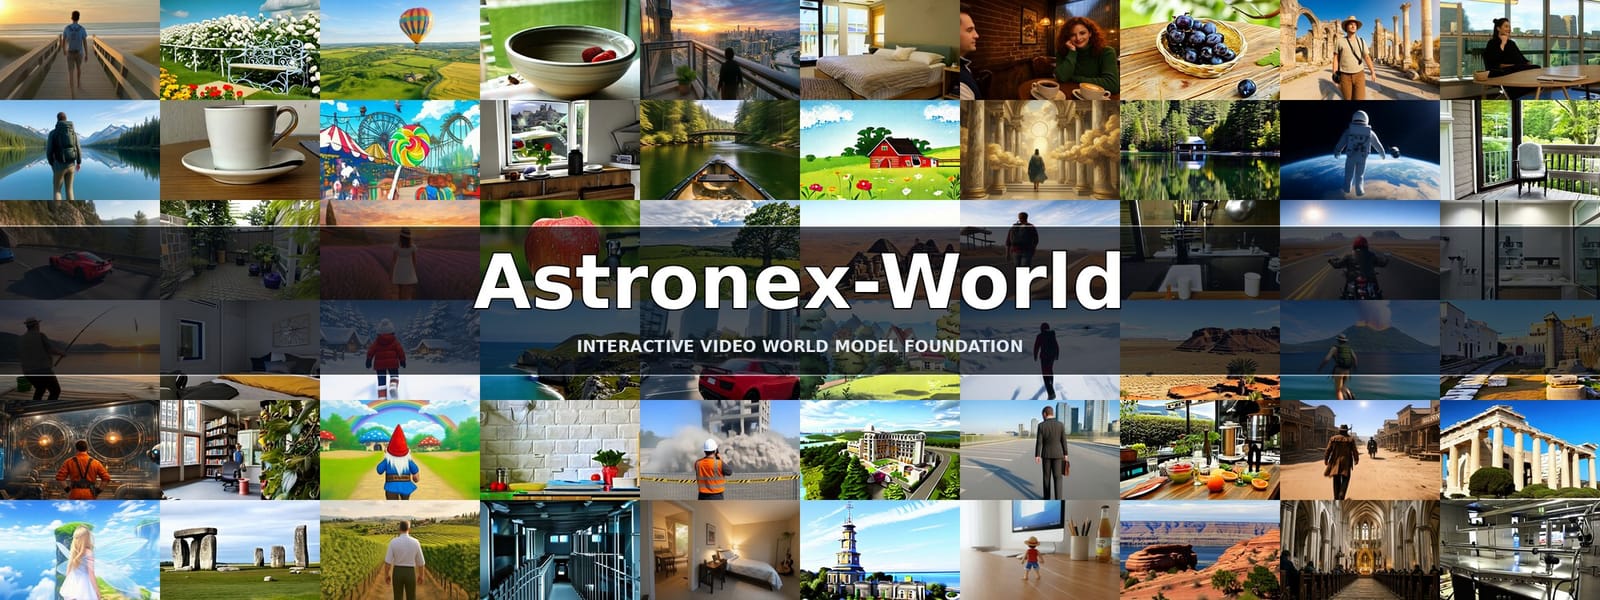
Astronex-World 1.0
カメラ・アクション・イベントの3種類で操作できる、5Bパラメータの動画生成型ワールドモデル。単一GPUでリアルタイム生成でき、Apache 2.0でコードと重みが公開されています。
Astronex Robotics / 南京信息工程大学 / GitHub
#Spatial/3D#GenVideo
RecGen3D
数枚の写真(カメラ位置不明でもOK)から、形が欠けない完全な3Dモデルを作る手法。復元AIと生成AIを共通の座標空間で協調させ、コードと重みが公開されました。
Zhisheng Huang ら(SIGGRAPH Asia 2026採択) / GitHub
#Spatial/3D
Spirula Studio
写真・動画から3Dガウシアンスプラット、さらにテクスチャ付きメッシュまでを、Python/COLMAP不要の単体アプリで作れる無料の3D学習ツール。NVIDIA以外のGPU(AMD/Intel等)でも動く。
harry7557558(個人開発) / GitHub
#Spatial/3D#CreatorTools
AgentSTAR (Agentic Shape Tracking and Reconstruction)
コーディングエージェント(Claude Code / Codex)に1本の動画を見せると、Blenderスクリプトを自分で書いて「はさみ」などの可動物体を3Dで組み立て、フレームごとの動きまで復元してくれる研究。出力はGLBと関節つきの姿勢データ。
Amazon FAR (Frontier AI and Robotics) / GitHub
#AI/Agents#Motion/Body#Spatial/3D
kimodo.cpp
NVIDIAのテキストから3D人物モーションを作る「Kimodo」を、C++/GGMLで自分のPC(CPU/Vulkan GPU)で動かせるようにしたオープンソースの移植版。「歩いて手を振る」のような文章から骨格アニメ(GLB)を生成できる。
LocalAI(localai-org)コミュニティ / 元モデル: NVIDIA Kimodo / GitHub
#Motion/Body#CreatorTools
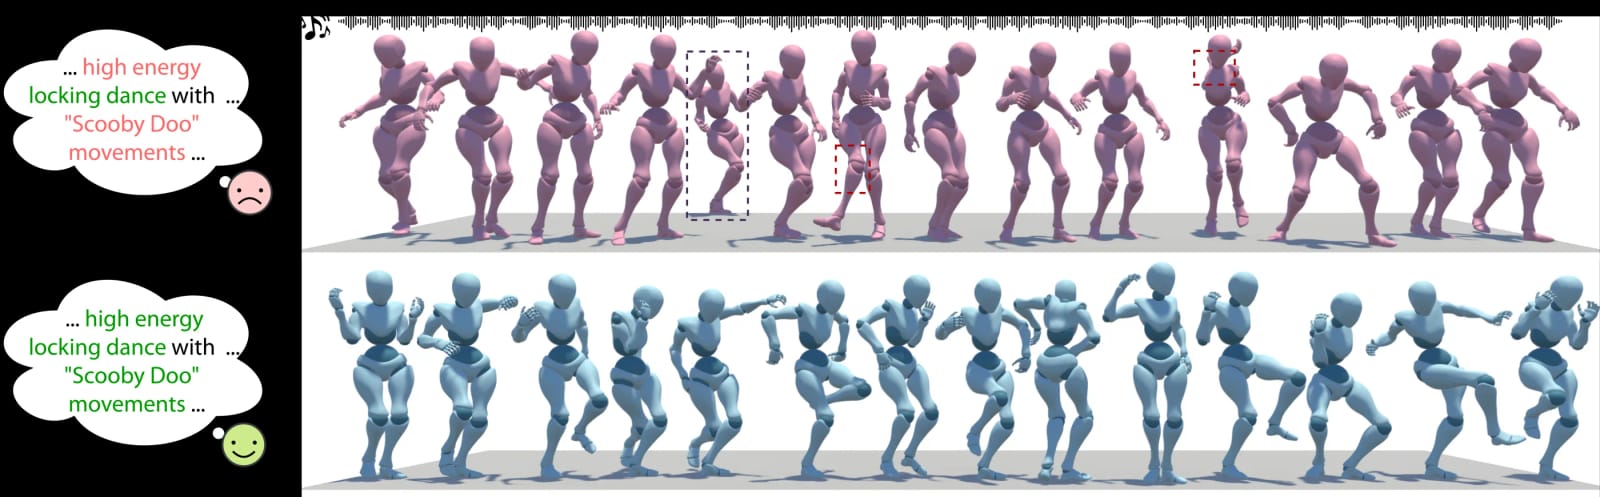
CustomDance
音楽と文章の指示から、AIが「振付家のように」ダンスを段階的に作り上げる3Dダンス生成システム。全自動ではなく、候補を選びながら人が振付を仕上げていく対話型のコードが公開された。
Xulong Tang ほか(SIGGRAPH Asia 2026 採択) / GitHub
#Motion/Body#AI/Agents#Audio/Music
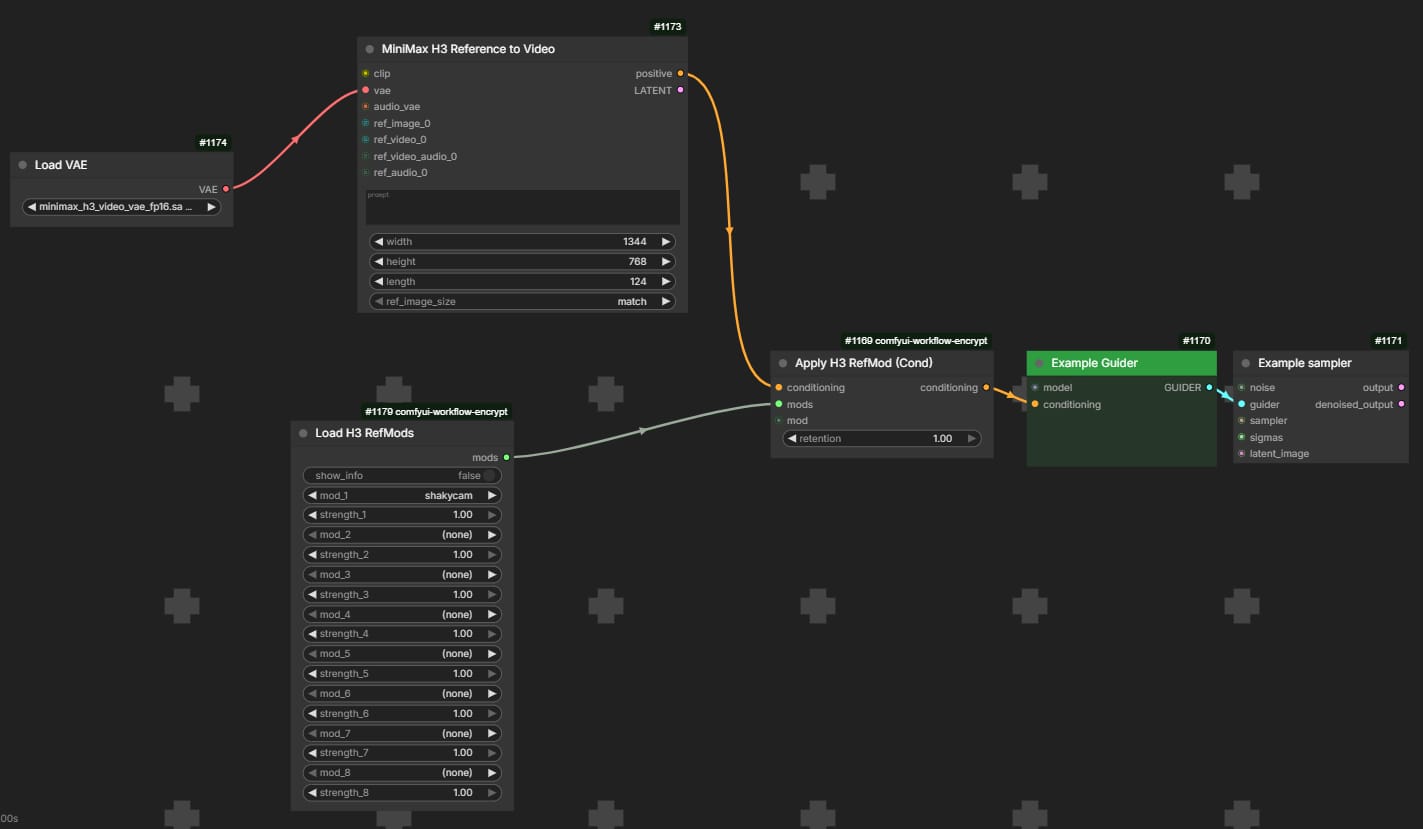
RefMods (MiniMax H3 Reference Latent Adapters)
動画生成AI「MiniMax H3」向けに、キャラクターの見た目を毎回学習し直さずに何度でも再現できる、1〜1.6MBの軽量な参照データ形式。
OSSコミュニティ(Luisa / ComfyUI-MiniMaxH3Mod) / GitHub
#GenVideo#CreatorTools
Block Sparse Attention & Comfy Compiler
長尺・高解像度のAI動画生成を大幅に高速化・省メモリ化する、ComfyUIに標準搭載された新しい計算最適化機能。
Comfy-Org(コミュニティ実装: kijai ほか) / GitHub
#GenVideo#CreatorTools
MSR (Multiple Subject Reference) for LTX-2.5
1本の動画に登場する複数の人物・服・小物・背景を、5枚までの参照画像から混同せずに再現する動画生成AI向けの新しい条件付け技術。
LiconStudio / GitHub
#GenVideo#CreatorTools
PPISP (Physically-Plausible Compensation and Control of Photometric Variations)
NVIDIAが開発した、3Dスキャン映像の露出ムラや色ズレを物理的に正しいかたちで補正するオープンソースのAIモジュール。
NVIDIA / GitHub
#Spatial/3D
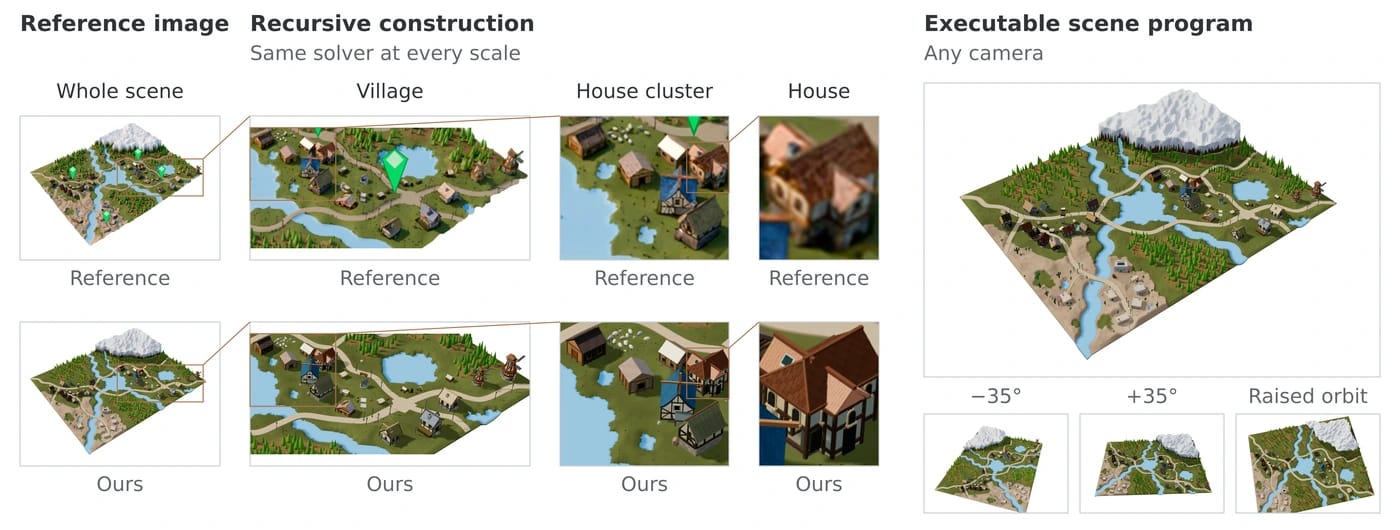
Recursive Code World Models (RCWM)
1枚の絵から、建物や部屋のパーツまで作り込まれた『編集できる3D世界』を、AIが自分でプログラムコードを書きながら再帰的に組み上げる研究。
Georgia Institute of Technology / GitHub
#Spatial/3D#CreatorTools
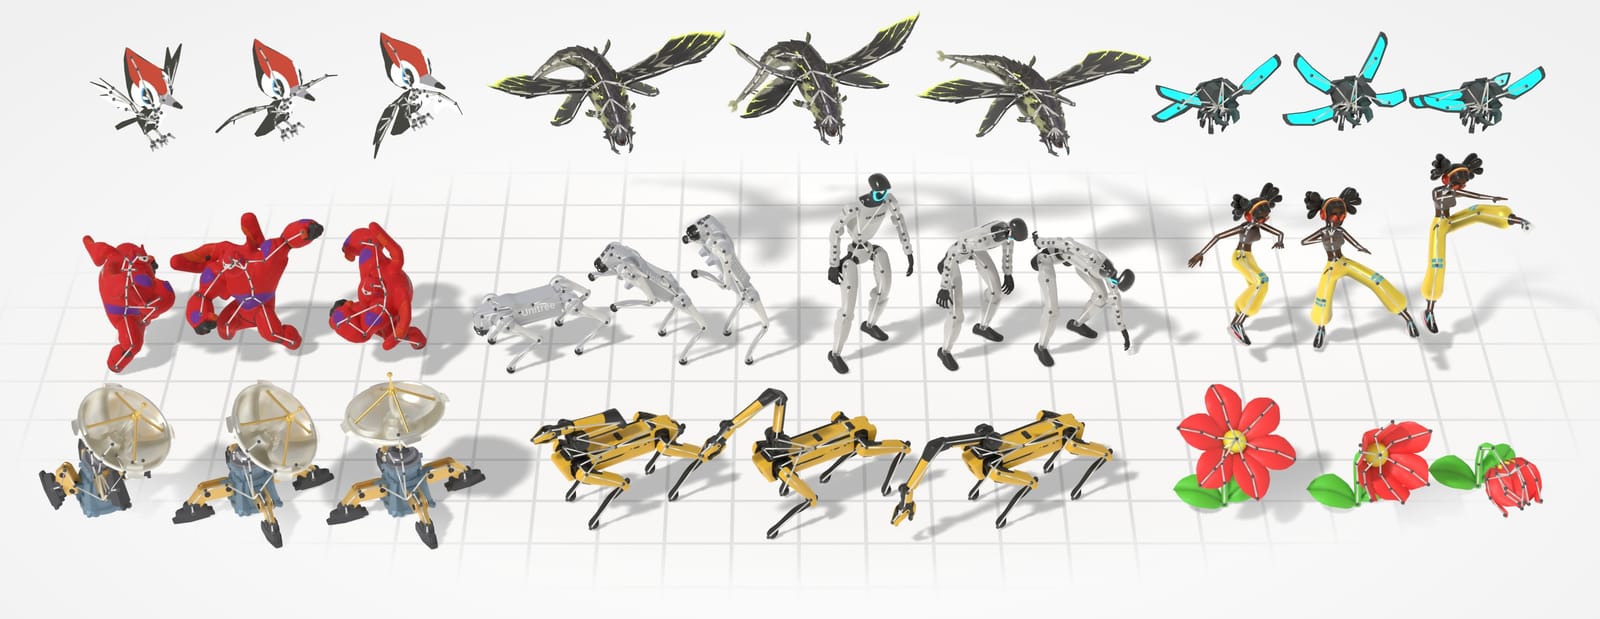
UniMate
テキストで指示するだけで、人間・四足動物・鳥・魚・昆虫など骨格の形がまったく違うキャラクターを、たった1つのAIモデルでアニメーションさせられる技術です。
Princeton University / UC Berkeley / MIT / GitHub
#Motion/Body#Spatial/3D
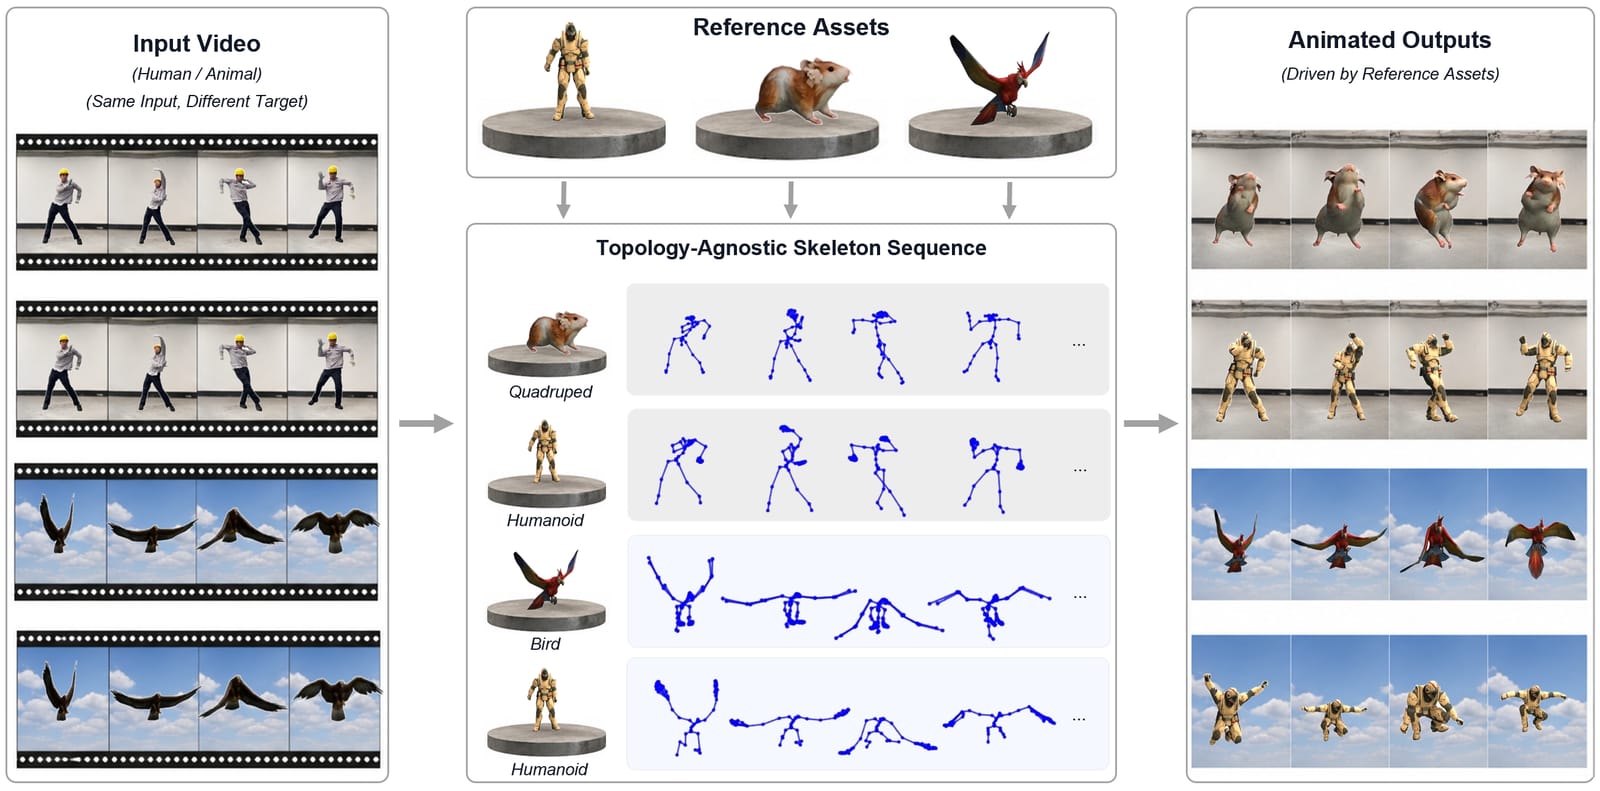
MoCapAnything V2
1台のカメラで撮った動画から、人間・動物・オブジェクトを問わず、どんな骨格の3Dキャラクターにもそのまま使えるモーションデータを自動生成する研究。
Huawei (AniMotionLab / Huawei Central Research Institute, Singapore) / GitHub
#Motion/Body#Spatial/3D
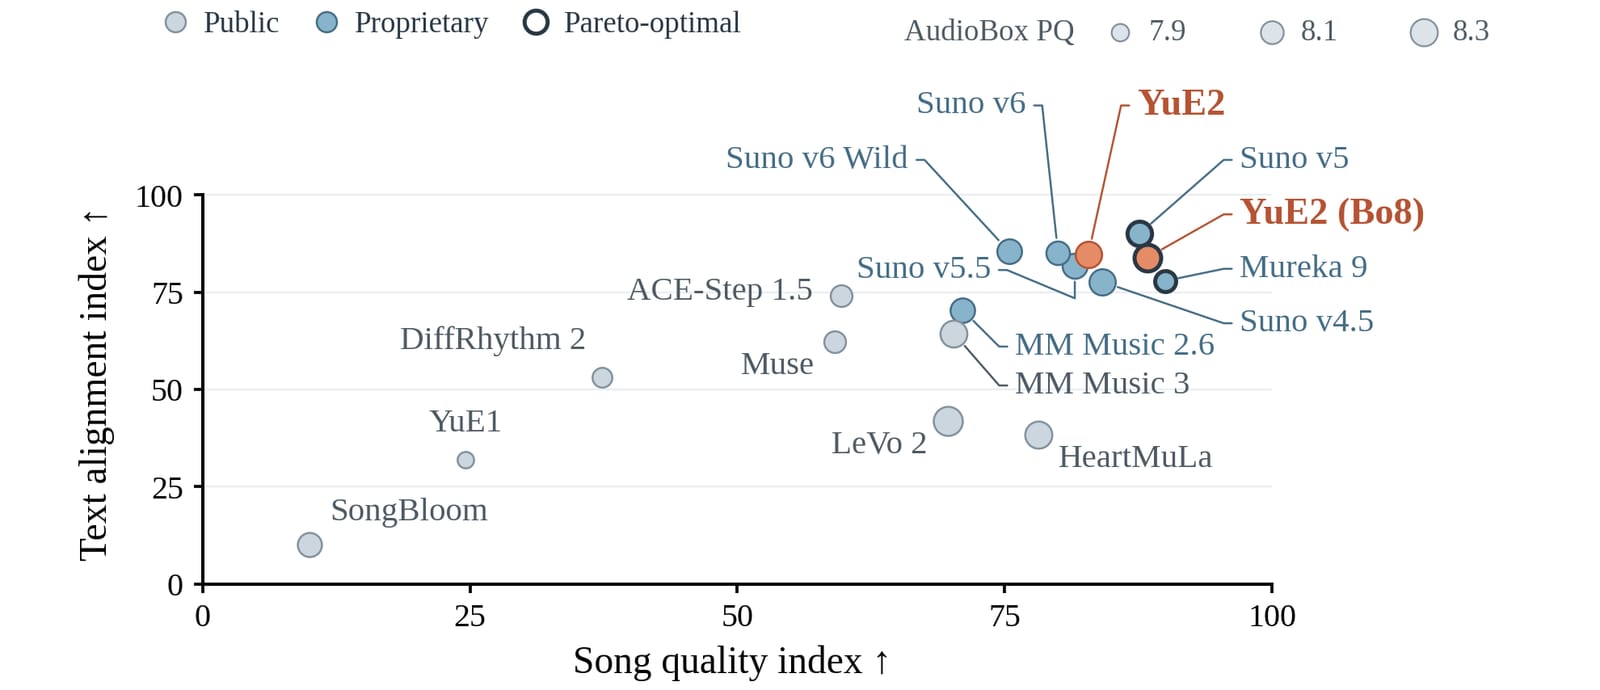
YuE2
歌詞とスタイル指定から、人間が読んで直せる「楽譜」を経由して本格的な楽曲を作る音楽生成AI。日本語ボーカルにも対応し、無料でローカル実行しながら有料サービスSuno 5に匹敵する品質を狙う。
Multimodal Art Projection (M-A-P) / GitHub
#Audio/Music#CreatorTools#AI/Agents
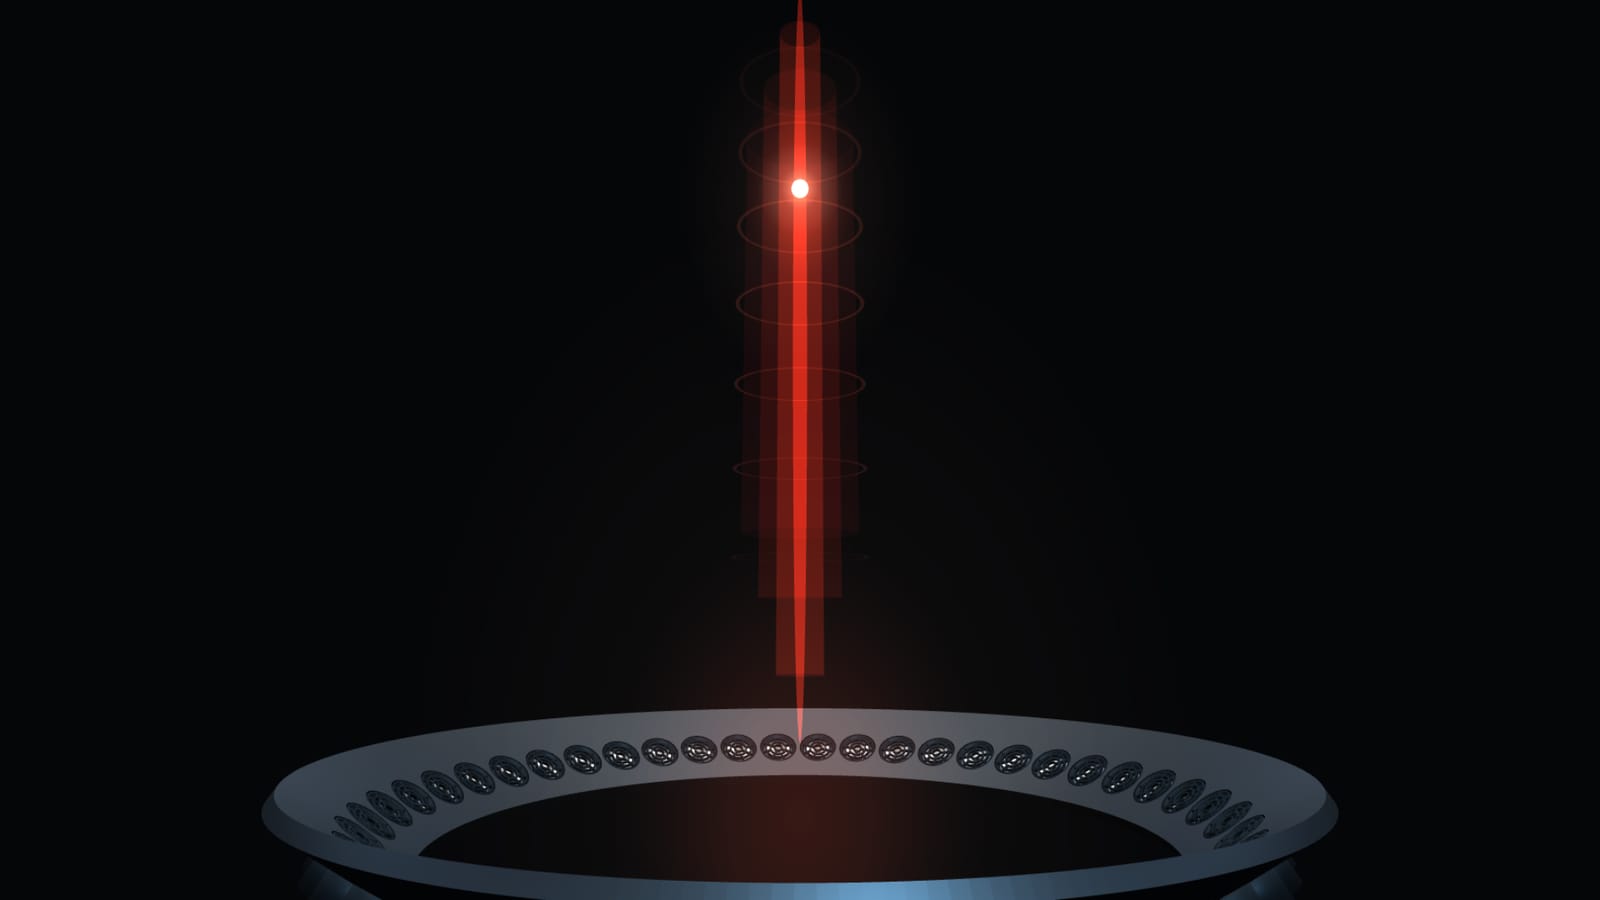
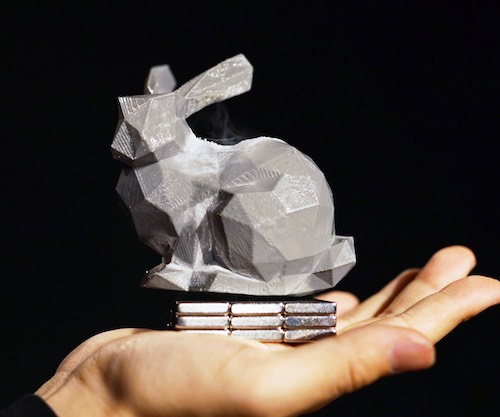
Single-Sided Bessel-Beam Acoustic Levitation(ゼロ次ベッセルビームによる片側音響浮揚)
超音波の特殊なビーム(ゼロ次ベッセルビーム)を使い、スピーカー装置から約40cmも離れた場所で発泡スチロール球などの軽い物体を非接触で空中に浮かせ、3次元的に動かす技術。片側の装置だけで、従来方式の約6倍の距離から操作できる。
筑波大学 Digital Nature Group(落合陽一研究室) / ブリストル大学
#HCI/MediaArt#Spatial/3D
AuK
声の生成・声質変換・ノイズ除去・話者分離までを1つのAIモデルと自然言語の指示だけでこなす、Tencent発のオープンソース音声基盤モデル。
Tencent Hunyuan / GitHub
#Audio/Music#CreatorTools
SelfLift
追加学習なしで画像・動画生成AIの処理速度を大幅に高速化する、解像度を段階的に引き上げる新しいサンプリング手法。
研究コミュニティ実装(論文著者+facok氏によるComfyUI移植) / GitHub
#CreatorTools#GenVideo
EditVid
1つのAIだけで、スタイル変更・物体の追加・特定人物の入れ替えなど多様な動画編集を追加学習なしにこなす研究フレームワーク。
PLAN Lab, University of Illinois Urbana-Champaign / GitHub
#GenVideo#CreatorTools
Three.js Native Gaussian Splat Renderer
ブラウザで3D表現をつくる定番の無料ライブラリ「Three.js」が、写真から作った点の集合で実写の立体空間をリアルに描く技術『Gaussian Splatting』を、外部ライブラリ無しの標準機能としてついに搭載した。
three.js (mrdoob / OpenJS Foundation, 実装: Ben Houston 氏ら) / GitHub
#Spatial/3D#CreatorTools
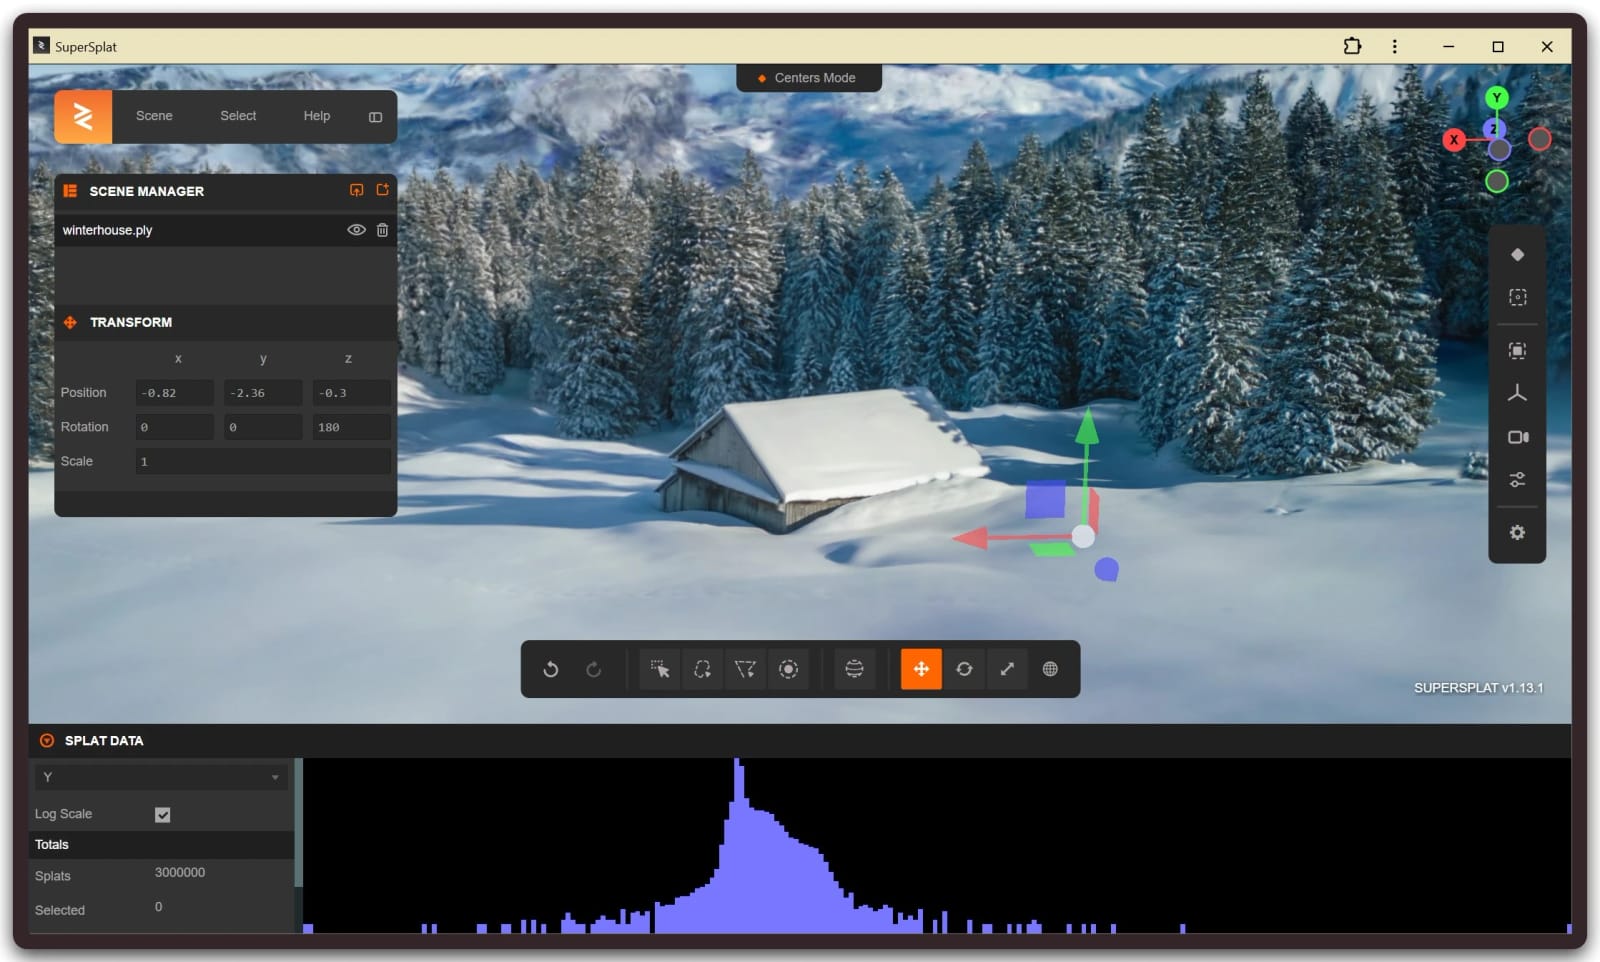
SuperSplat Editor 3.0
実写を点群で再現する『Gaussian Splatting』の無料オープンソース編集ソフト『SuperSplat』が全面刷新され、大容量シーンでも動作が大幅に軽量・高速になった。
PlayCanvas / GitHub
#Spatial/3D#CreatorTools
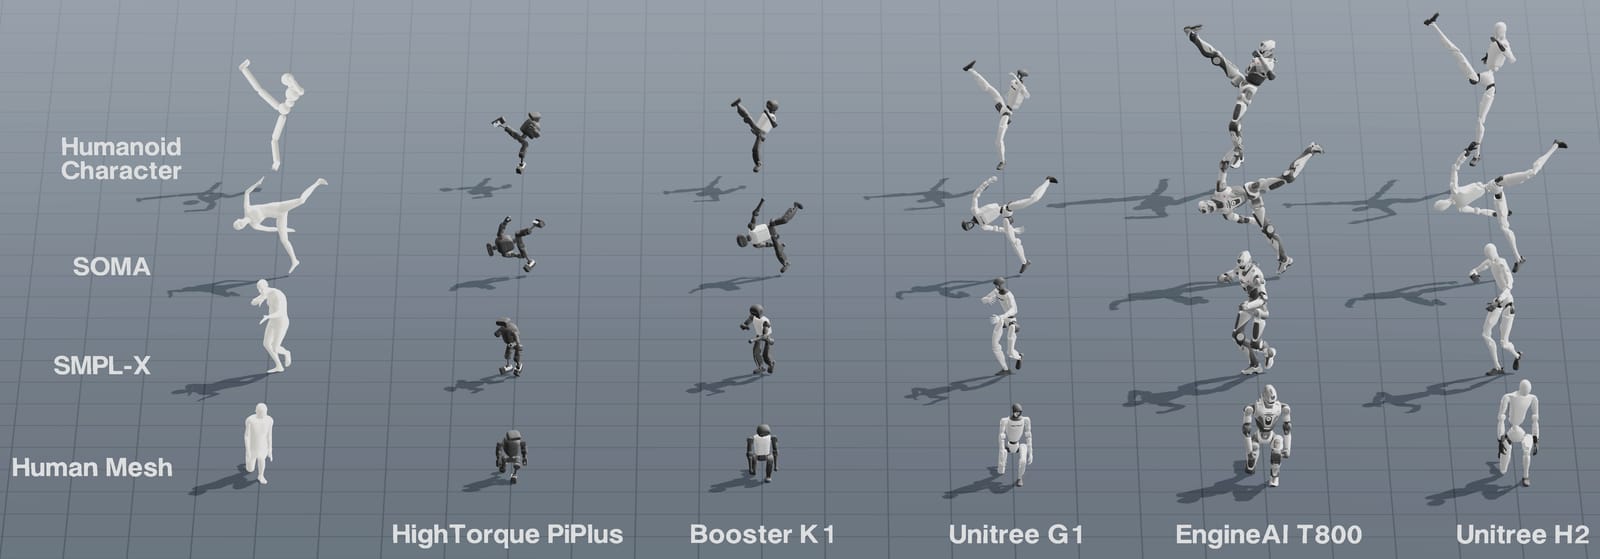
UMR (Unified Motion Retargeting)
モーションキャプチャした人間の動きを、体格も関節数も異なるヒューマノイドロボットへ、手作業の対応づけなしで自動転送できるAI技術。
HKUST(Guangzhou) / Hanyang University / HKU / Noitom Robotics / GitHub
#Motion/Body#Spatial/3D
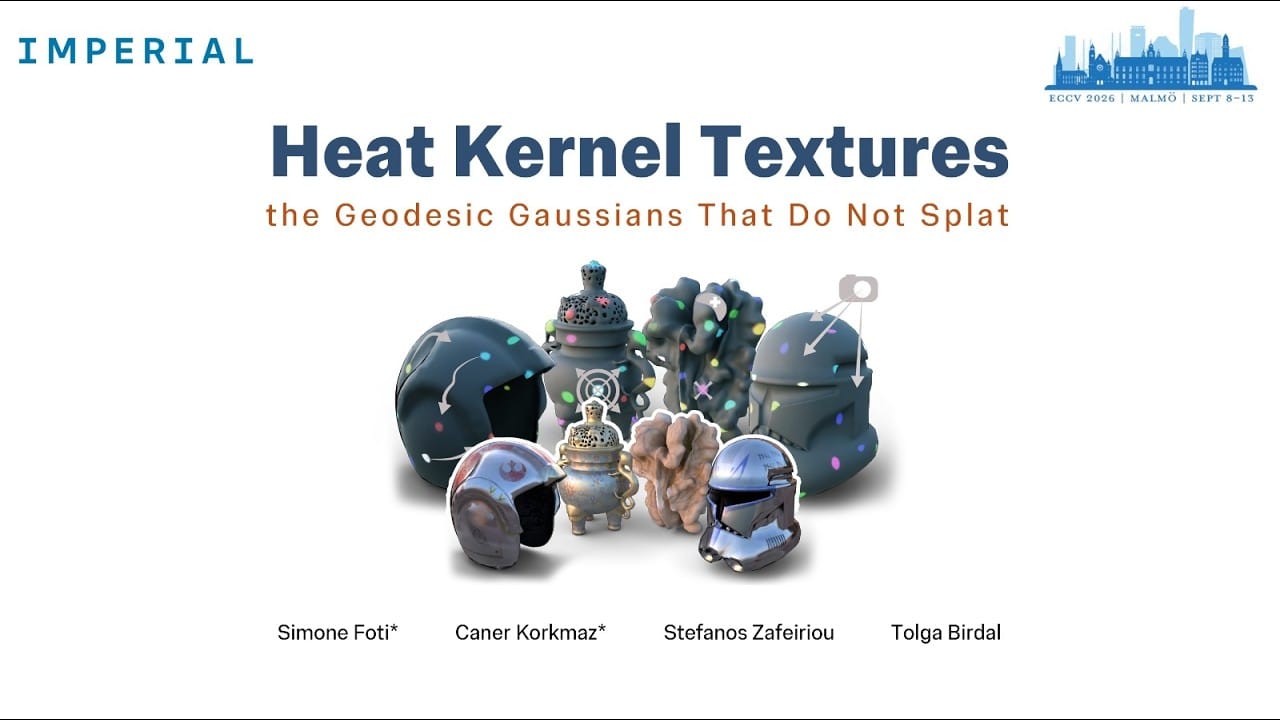
HKTex (Heat Kernel Textures)
3DモデルにテクスチャCG絵柄を貼る際に必須だった「UV展開」という下準備作業を丸ごと不要にする新手法。ECCV 2026ベストペーパー受賞。
Imperial College London / GitHub
#Spatial/3D#CreatorTools
SA3 Browser Tools (mucking_around_time_with_stable_audio_3)
AIオーディオモデル「Stable Audio 3」を、プロンプト一発生成の道具から、生成過程を手で触って作り込めるブラウザ制作環境へと拡張するオープンソースツールキット。
little-scale (Sebastian Tomczak) / GitHub
#Audio/Music#CreatorTools
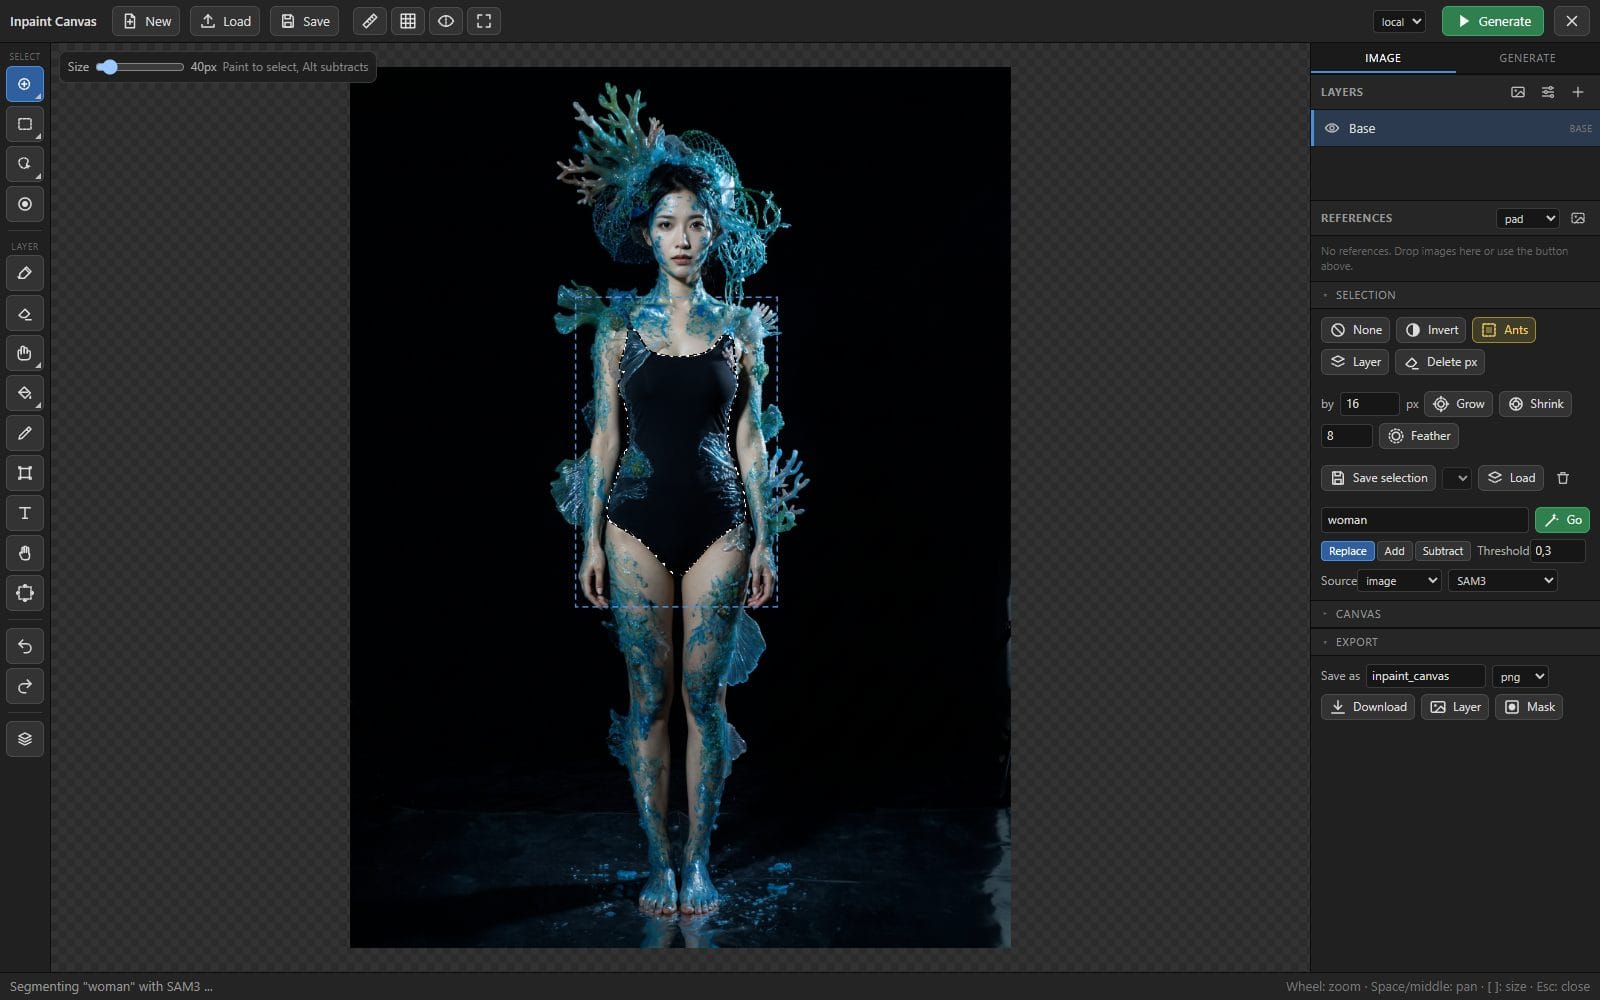
Inpaint Canvas (ComfyUI-InpaintCanvas)
ComfyUIの中に、写真編集ソフトのような『レイヤー編集キャンバス』を1個のノードとしてまるごと持ち込むツール。選択範囲を切り出してAI修正にかけ、結果を新しいレイヤーとして重ねる、を繰り返せる。
DenRakEiw(個人開発者 Eiw / Dennis) / GitHub
#CreatorTools#GenVideo
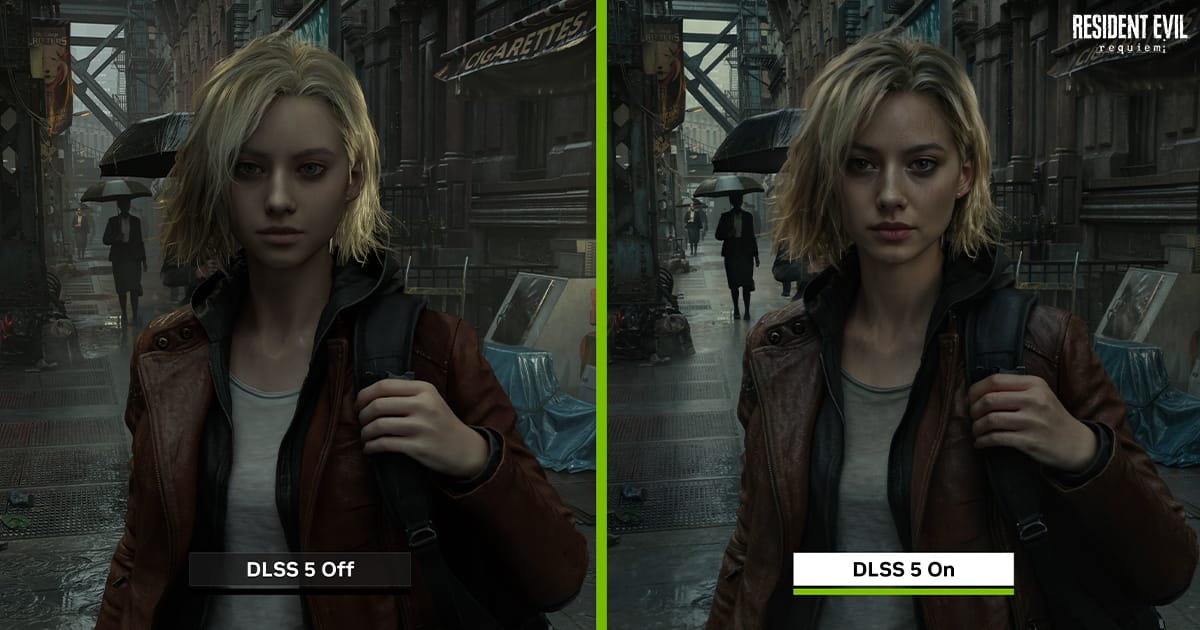
DLSS5 Enhancer (ComfyUI-DLSS5-Enhancer)
ゲーム向け最新AI高画質化技術『DLSS 5』のニューラルレンダリングエンジンを、ComfyUIのノードとして動画・画像バッチにそのままかけられるようにした非公式ツール。
Blueforcer(個人開発、NVIDIA非公式) / GitHub
#GenVideo#CreatorTools
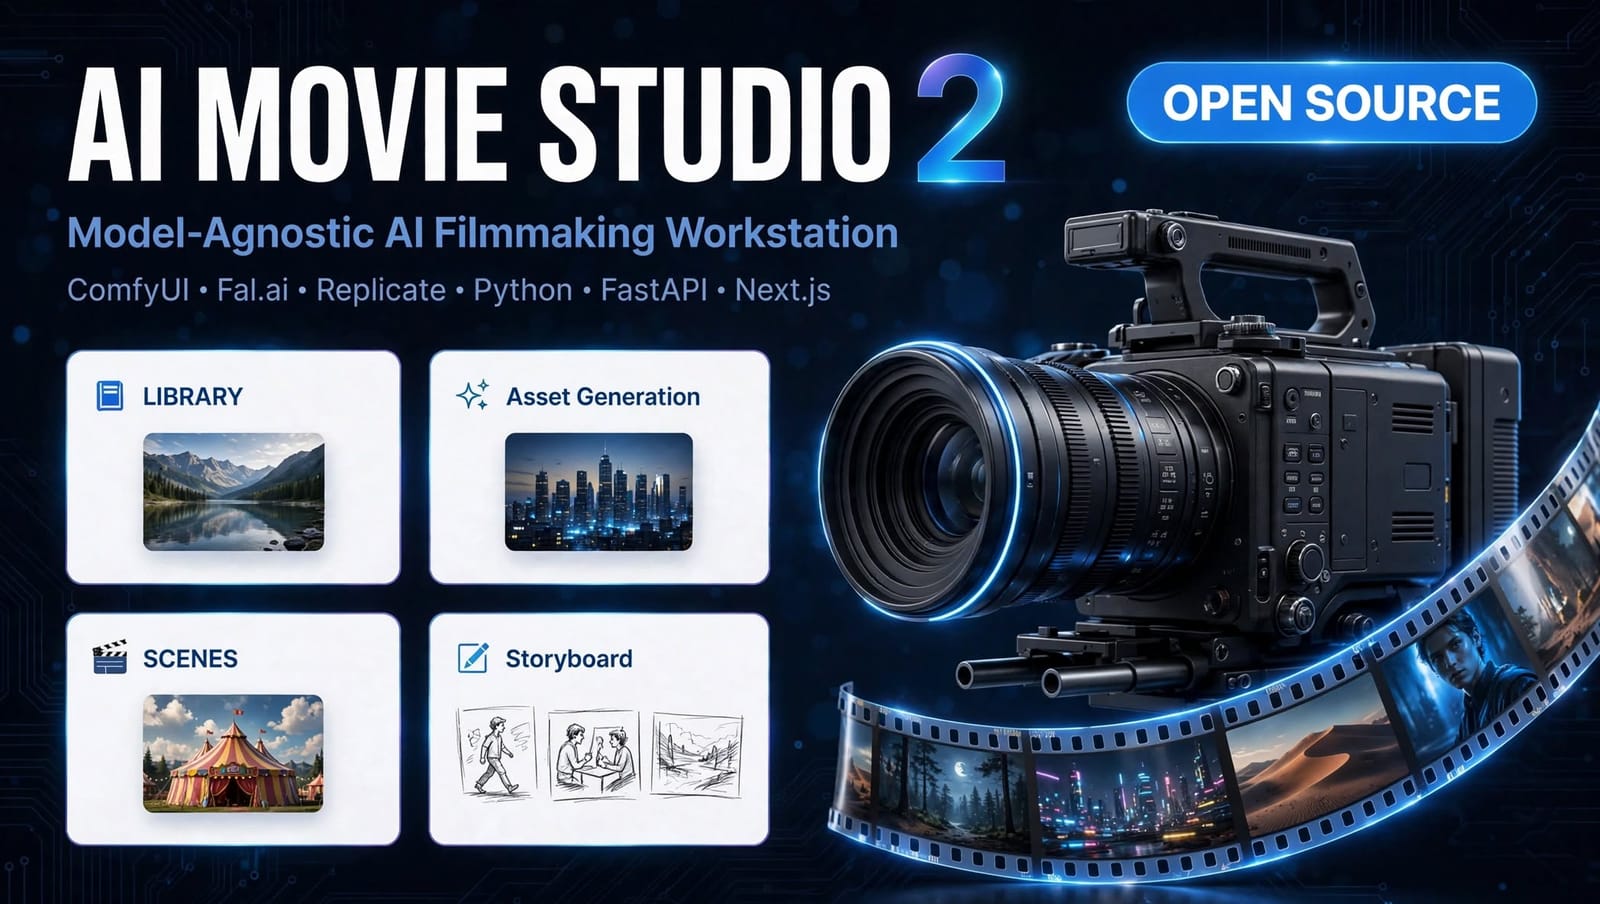
AI Movie Studio v2
3Dカメラでカット割りを設計し、AIで絵コンテから映像・音声まで作って編集ソフトへ書き出せる、ブラウザで動く『AI映画制作ワークステーション』。
Heroesjouney(Sandbox Entertainment、個人/小規模開発) / GitHub
#CreatorTools#GenVideo
FlashRender
撮影済みの動画に対して、後から好きなカメラアングル(パン・チルト・ズームなど)で撮り直した映像を数秒で生成できる技術。従来手法の25倍の速さで動作する。
EverEx / Yonsei University / Korea University / GitHub
#Spatial/3D#GenVideo#CreatorTools
Puffin-World
1枚の画像やテキストから、カメラの向き・奥行きなど物理的な整合性まで理解した3D空間を生成し、自由な視点で歩き回れる映像を作れる統合モデル。
S-Lab (Nanyang Technological University) / University of Michigan / Beijing Jiaotong University / ACE Robotics / GitHub
#Spatial/3D#AI/Agents
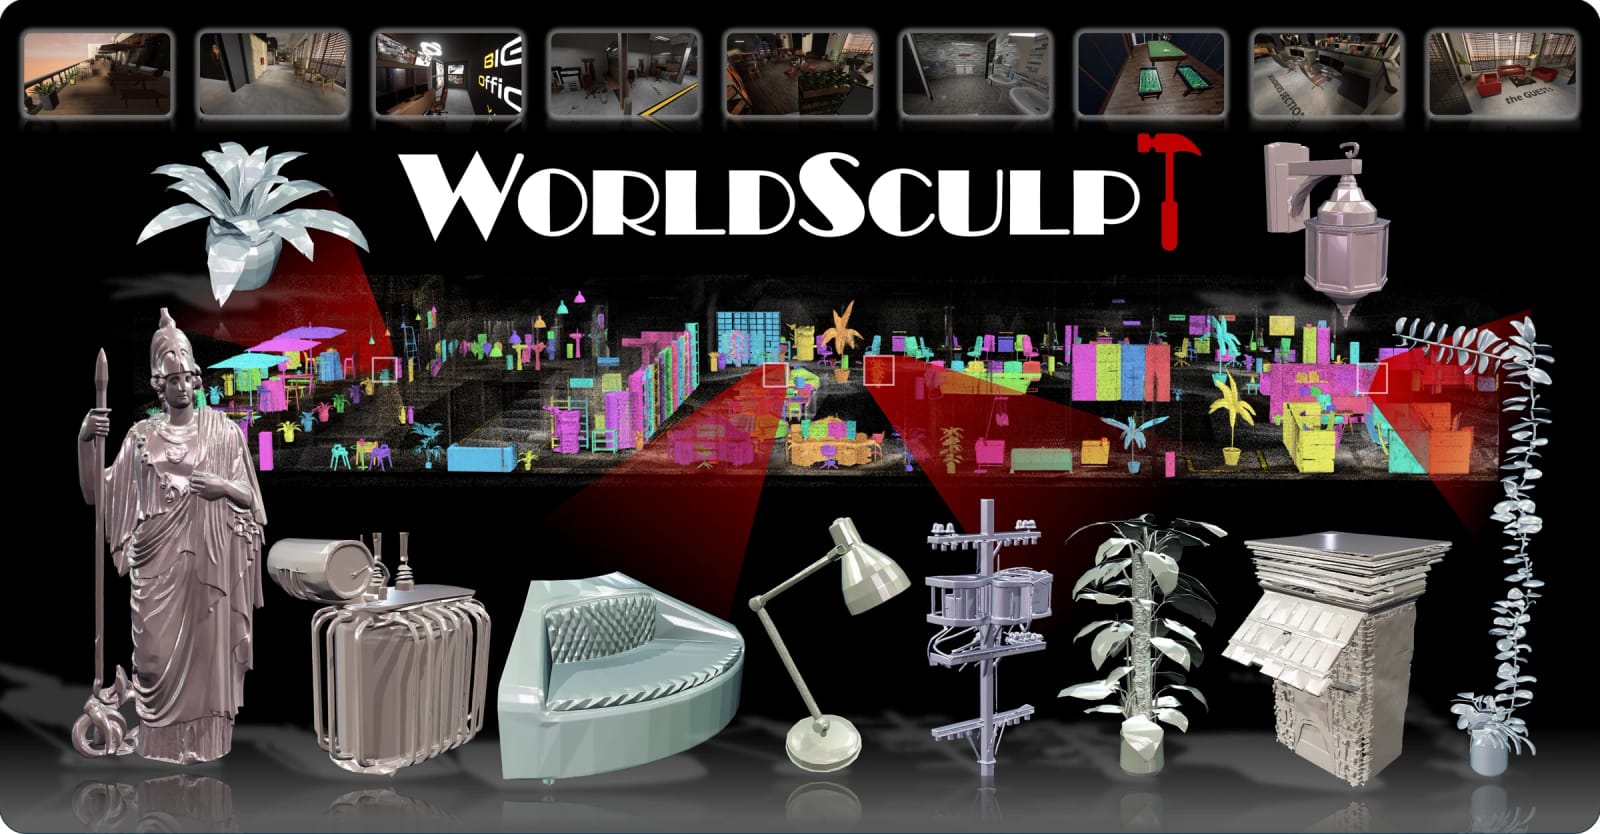
WorldSculpt
物がぎゅうぎゅうに詰まった雑然としたシーンの映像から、重なり合う物体1つひとつを個別の3Dデータ(メッシュ)として切り出し、同じ空間座標上に配置し直せる技術。
Alaya Lab / The University of Tokyo / GitHub
#Spatial/3D#CreatorTools
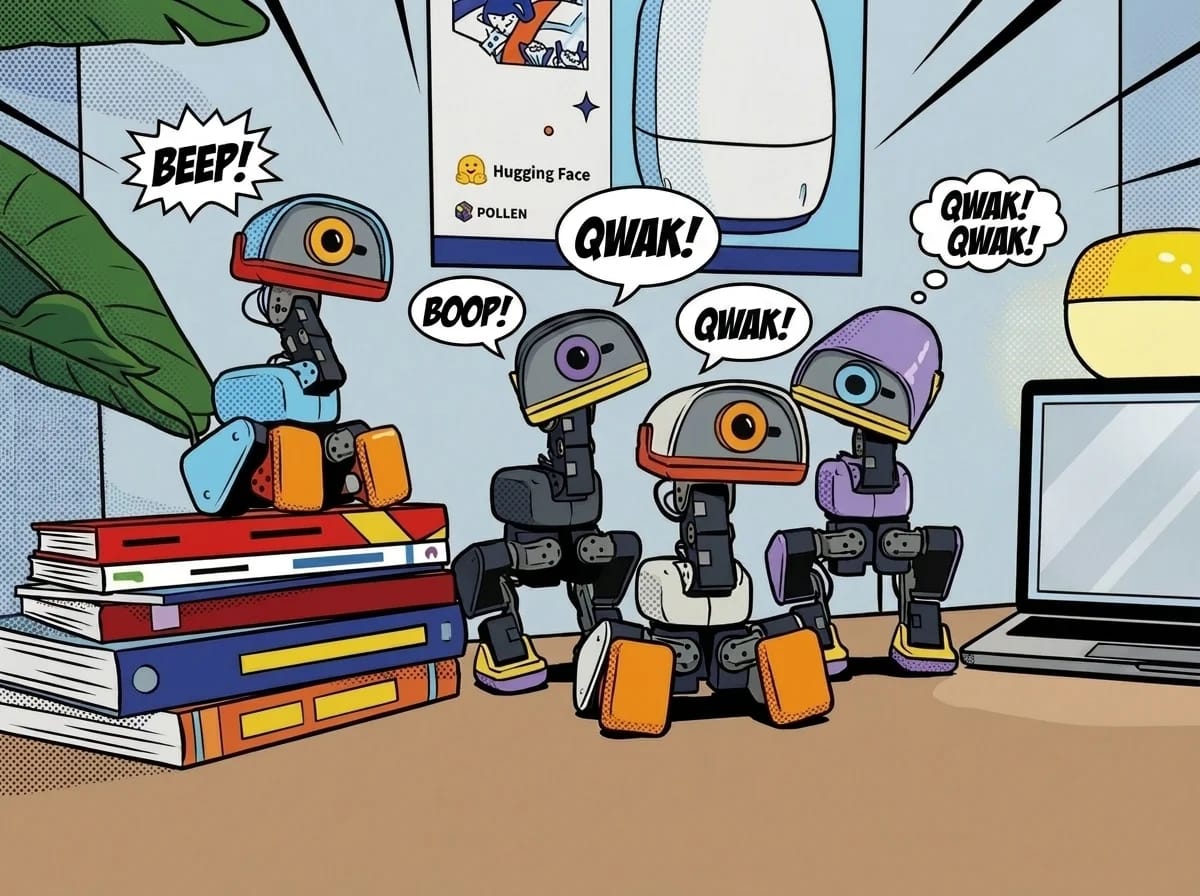
Microduck
Hugging Face傘下のPollen Roboticsが発表した、体重800g・全長25cmの二足歩行ロボット「Microduck」。歩行やボール蹴り、転倒からの起き上がりまで、すべての動きを強化学習でシミュレーション訓練し実機へ転送するソフトウェア一式がオープンソース公開された。
Pollen Robotics(Hugging Face傘下) / GitHub
#Motion/Body#HCI/MediaArt
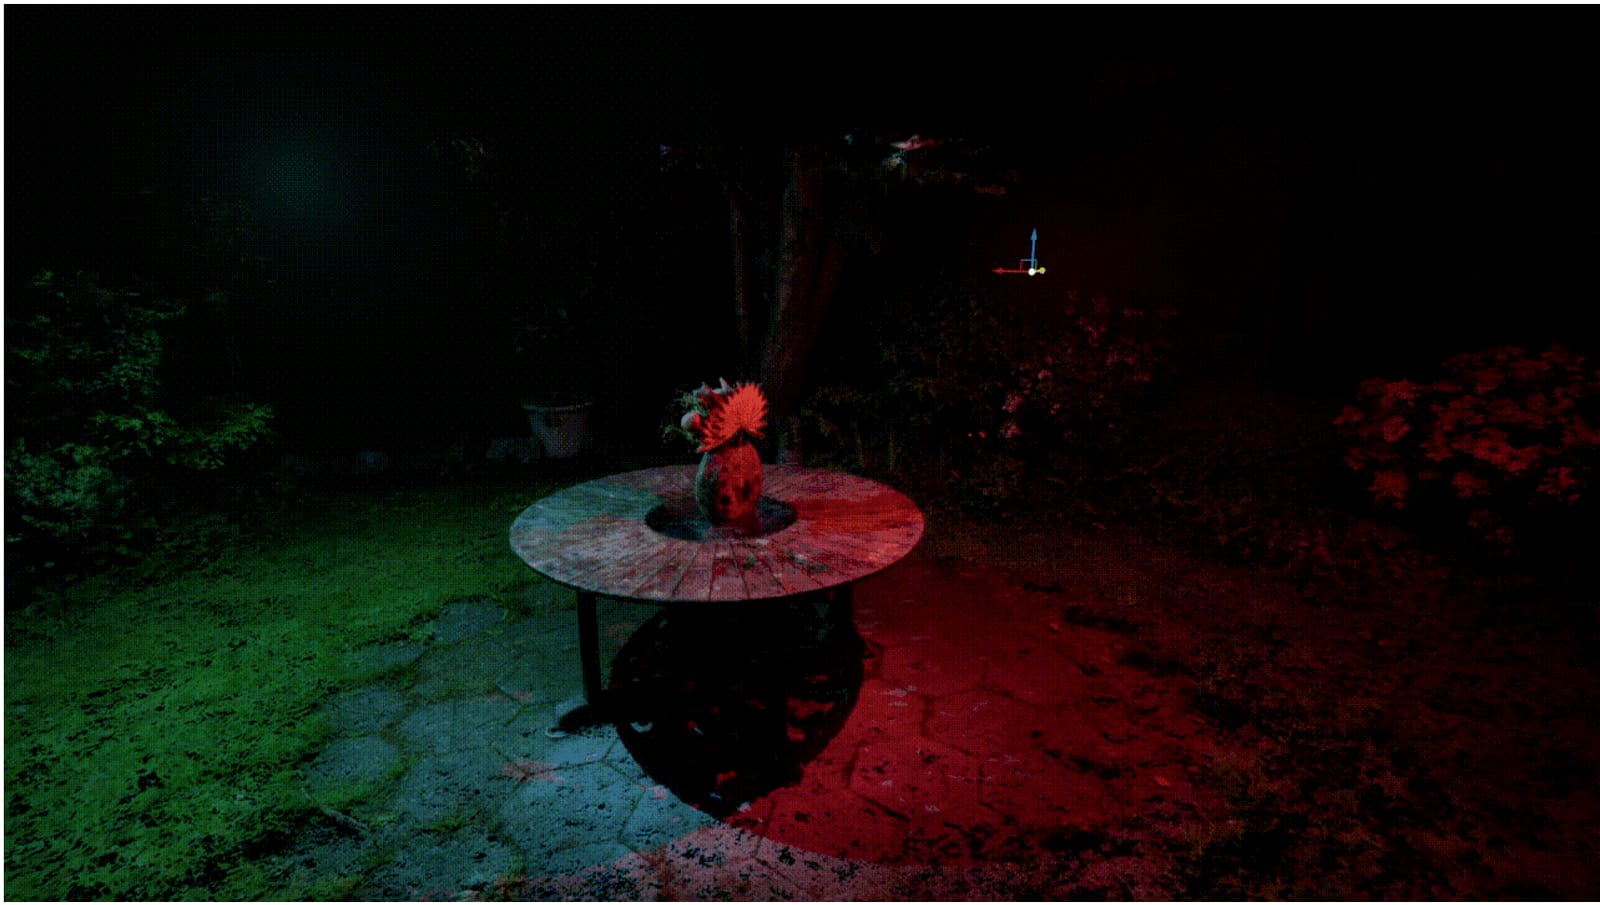
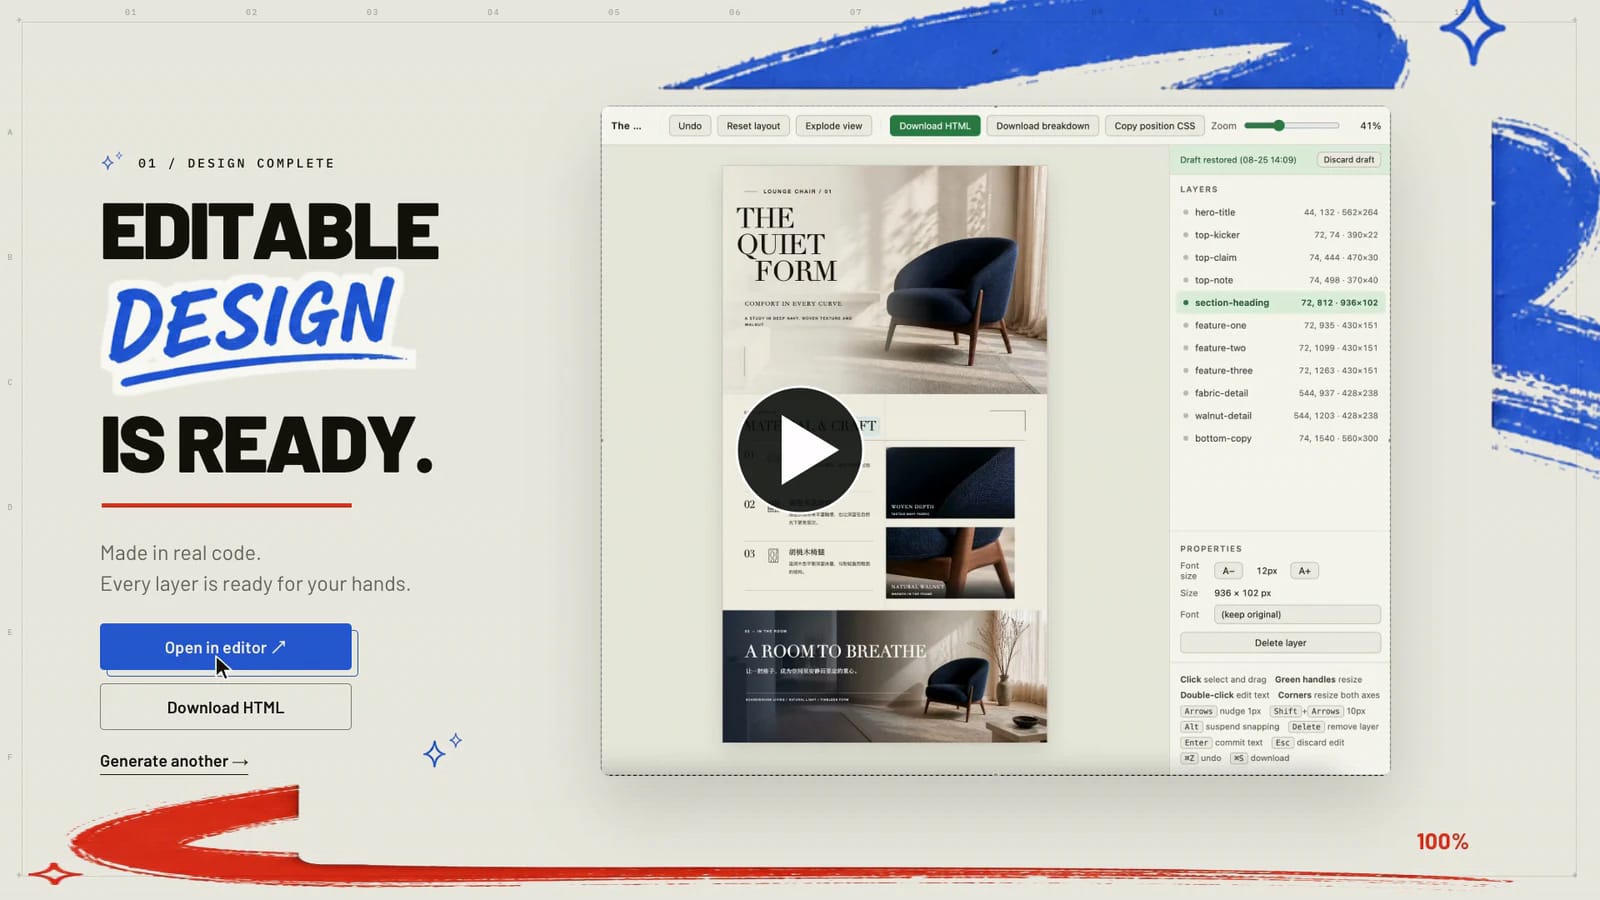
Editable Visual Design(Editable-Design)
AIエージェントが画像生成とHTML/CSSコーディングを組み合わせ、あとから文字やレイアウトを編集できるポスター・チラシを作る研究「Editable Visual Design」。GitHubでコードが公開されている。
Sun Yat-sen University ほか(Junyan Ye氏らの共同研究) / GitHub
#AI/Agents#CreatorTools
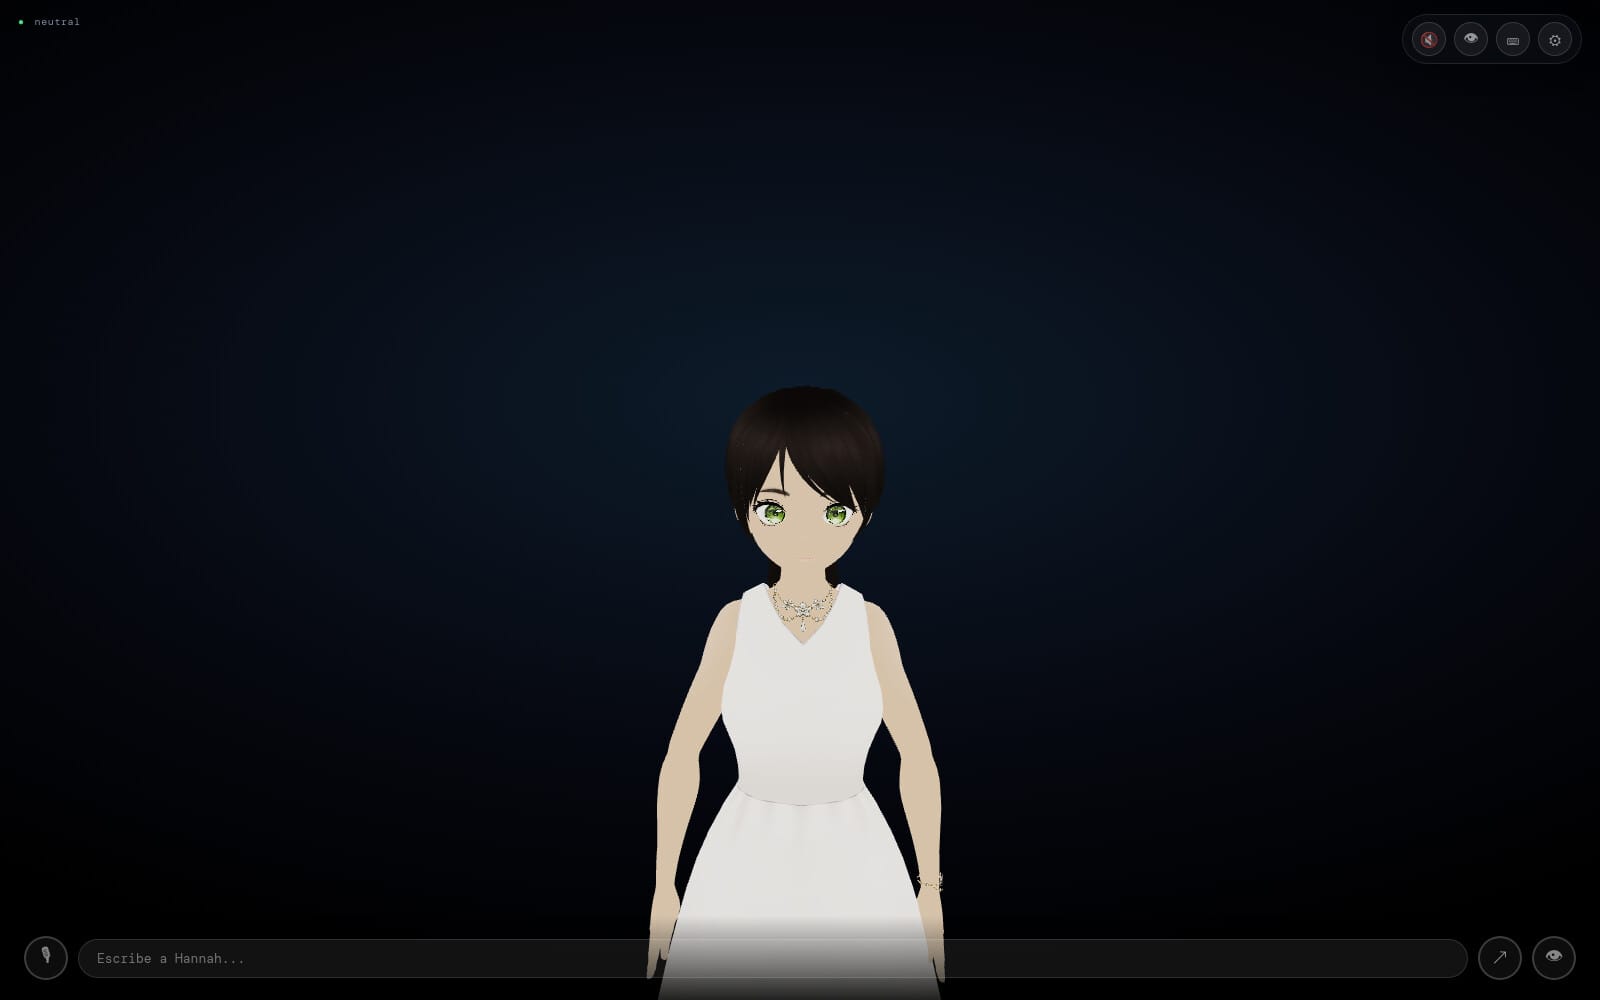
Hannah Motion Model (motionlab)
AIアシスタント「Hannah」のために開発された、しゃべる文章のテキストからその場で3D body languageの動き(身振り手振り)を直接生成する研究用モデル。
Vanth Labs / GitHub
#Motion/Body#AI/Agents
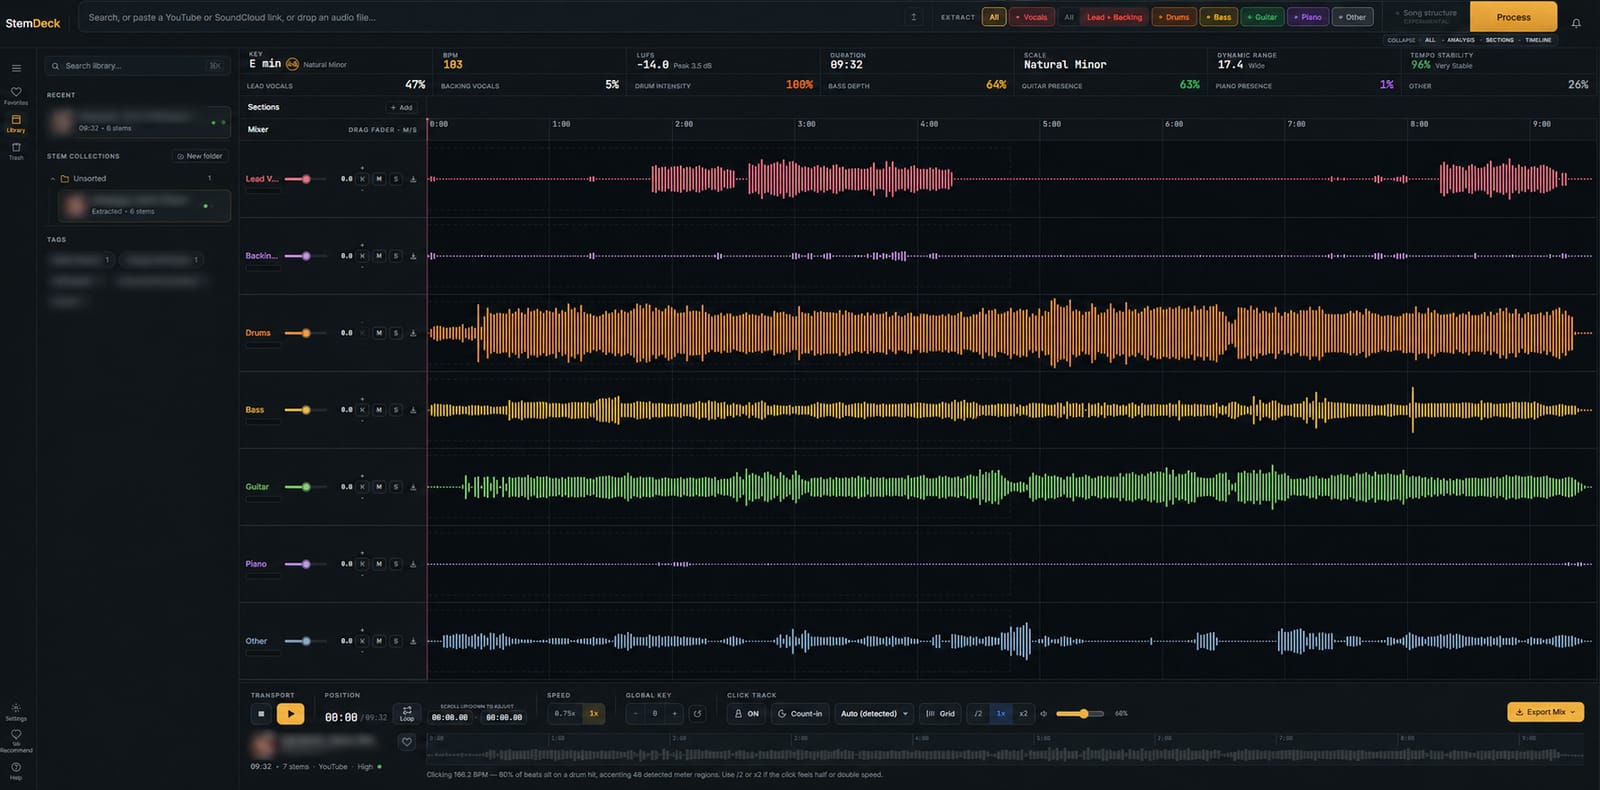
StemDeck
1つの音楽ファイルをボーカル・ドラム・ベース・ピアノ・ギターなど最大6パートに自動分離できる、アカウント登録不要・完全ローカル動作の無料アプリ。
stemdeckapp / GitHub
#Audio/Music#CreatorTools
JAS-I Khorlo
ガラスの円筒の周りに最大8本の弦を円形に配置し、リング状の「ばち」が回転しながら弦を弾いて音を出す、無料の物理モデリングシンセサイザー。
JASI (Aaron Jasinski)
#Audio/Music#CreatorTools
Video Delta Net (VDN-H3)
動画生成AI「MiniMax H3」の計算を高速化する新しい注意機構。8割以上を占めていた計算コストを線形に置き換え、14秒・768pの動画をGPU8枚で11秒、再生時間より速く生成できるようにした。
UC Berkeley / Impossible, Inc.(Haocheng Xi ほか) / GitHub
#GenVideo#CreatorTools
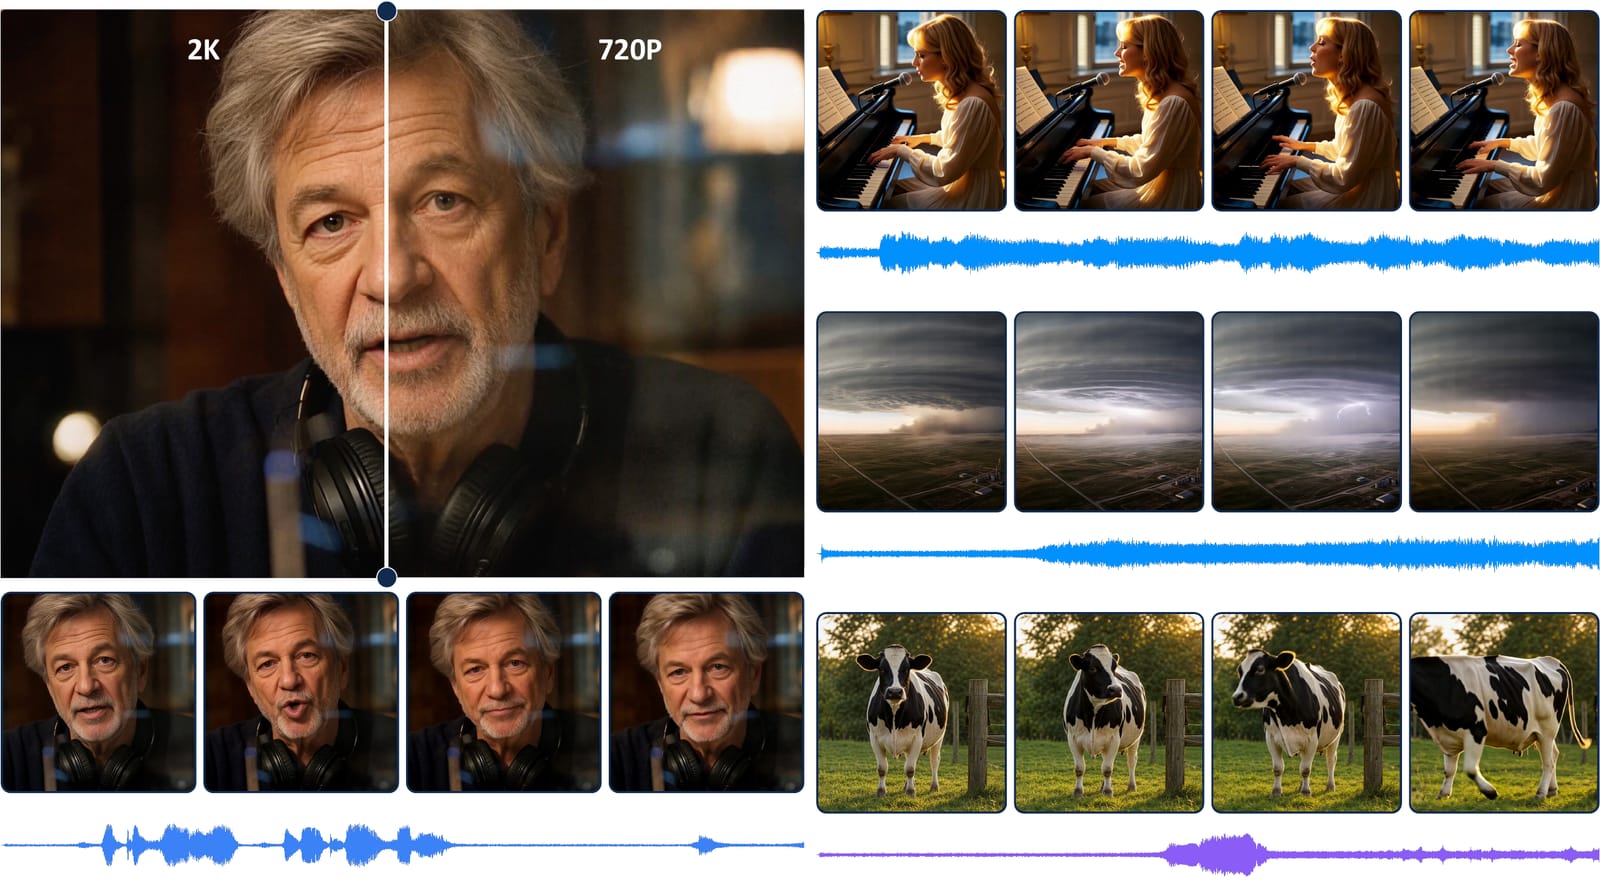
DreamX-Creator 1.0
1枚の最初のコマとテキストだけから、映像と音声を“同時に”生成できる7Bの軽量モデル。仕上げ用の5Bモデルと組み合わせて2K画質まで引き上げられる。
AMAP-ML(アリババ系研究チーム) / GitHub
#GenVideo#Audio/Music#CreatorTools
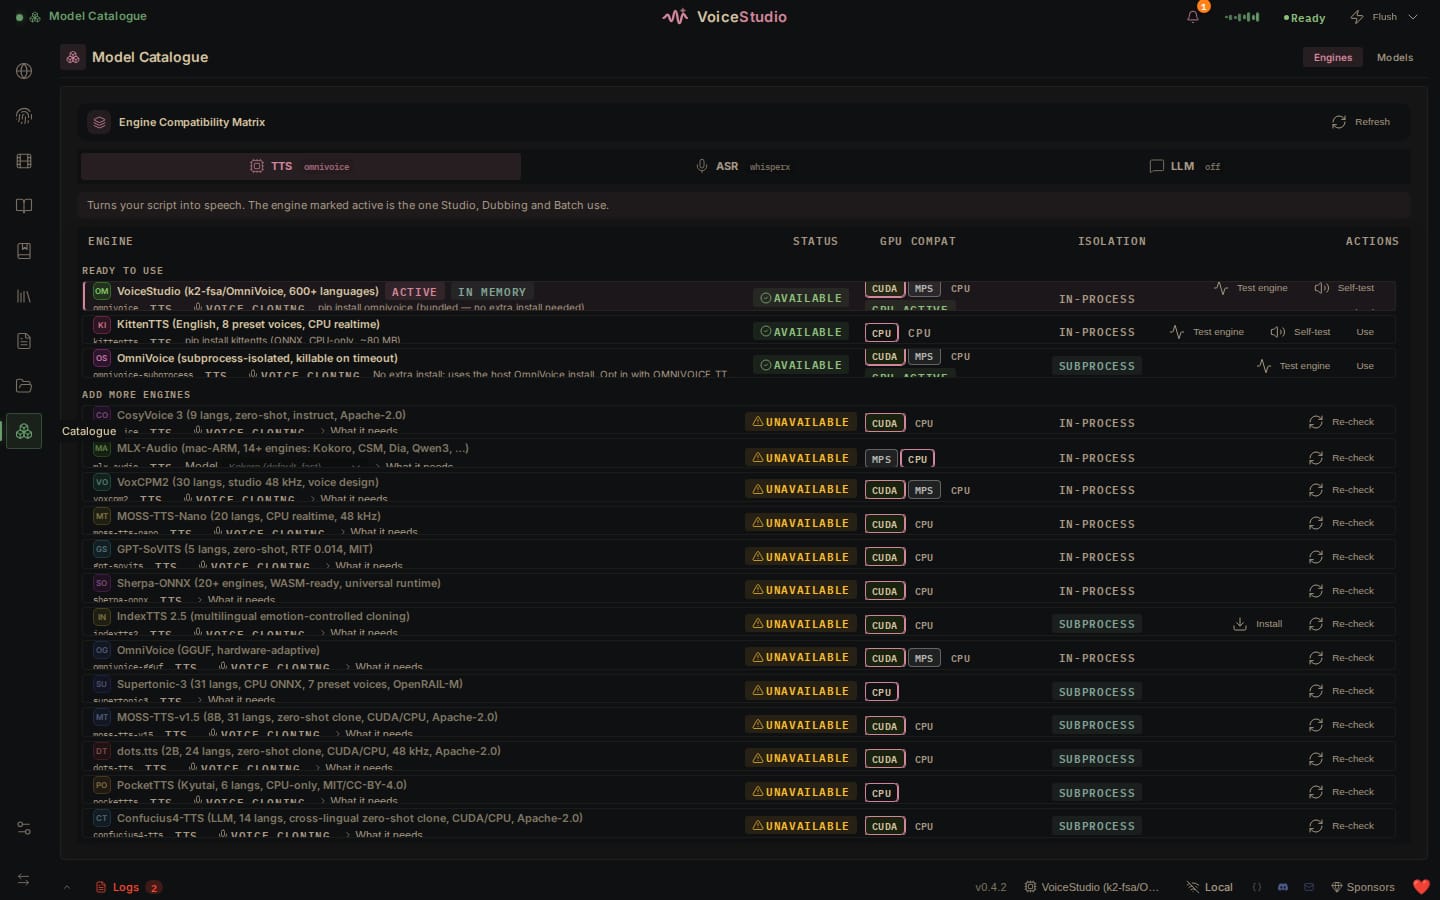
VoiceStudio
ElevenLabsのような有料音声AIサービスの機能を、完全ローカル・無料で使えるOSSツール。声のクローン作成・動画の多言語吹き替え・文字起こしなどを1つのアプリでまとめて行える。
debpalash(個人開発/OSSコミュニティ) / GitHub
#CreatorTools#Audio/Music
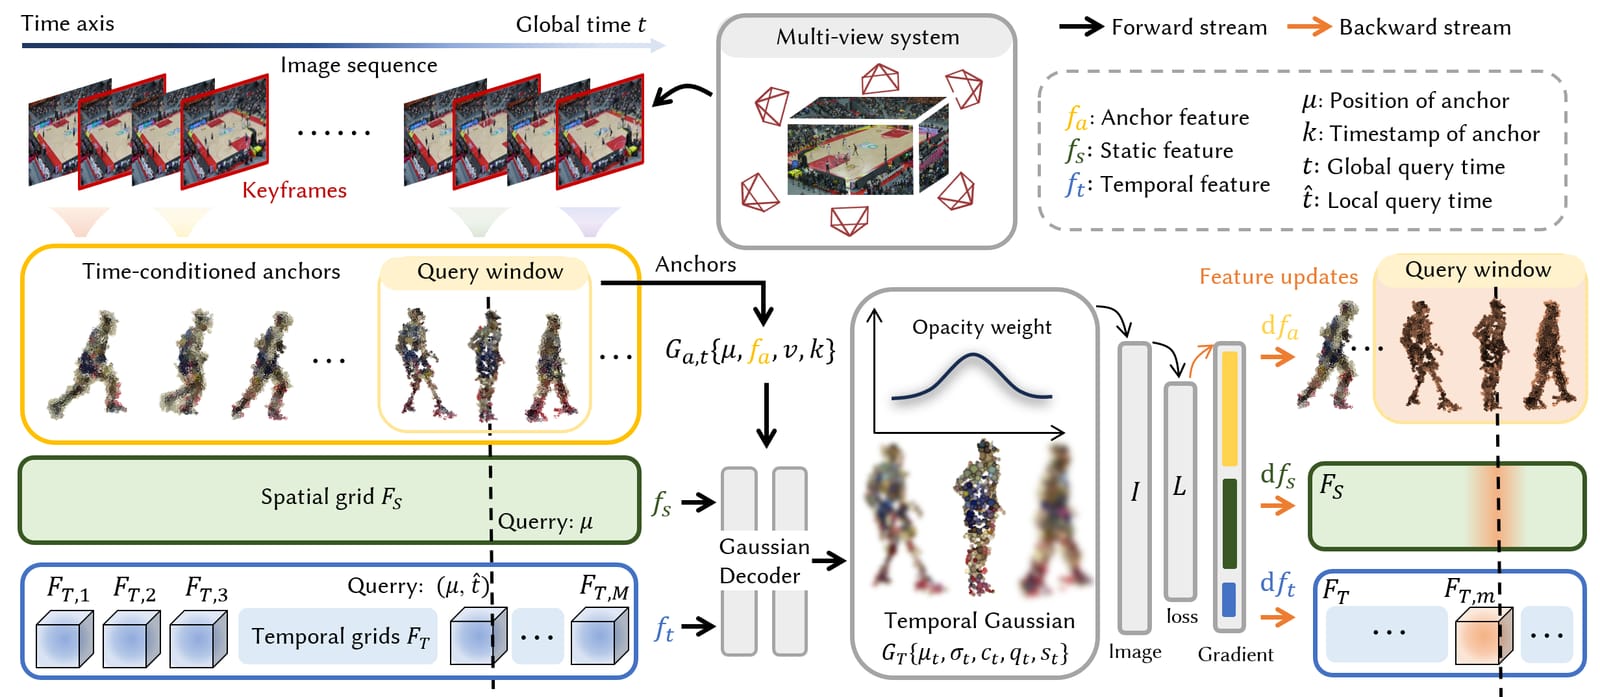
ATGS(Anchored Temporal Gaussian Splatting)
長時間・複雑な動きの多視点映像を破綻なく3Dガウシアン群として再構成する新手法。バスケットボールの試合や長尺の会議シーンなど、これまで難しかった長尺ボリュメトリック映像の高品質な自由視点再生を可能にする。
北京大学 / 鹏城実験室(Pengcheng Laboratory) / GitHub
#Spatial/3D
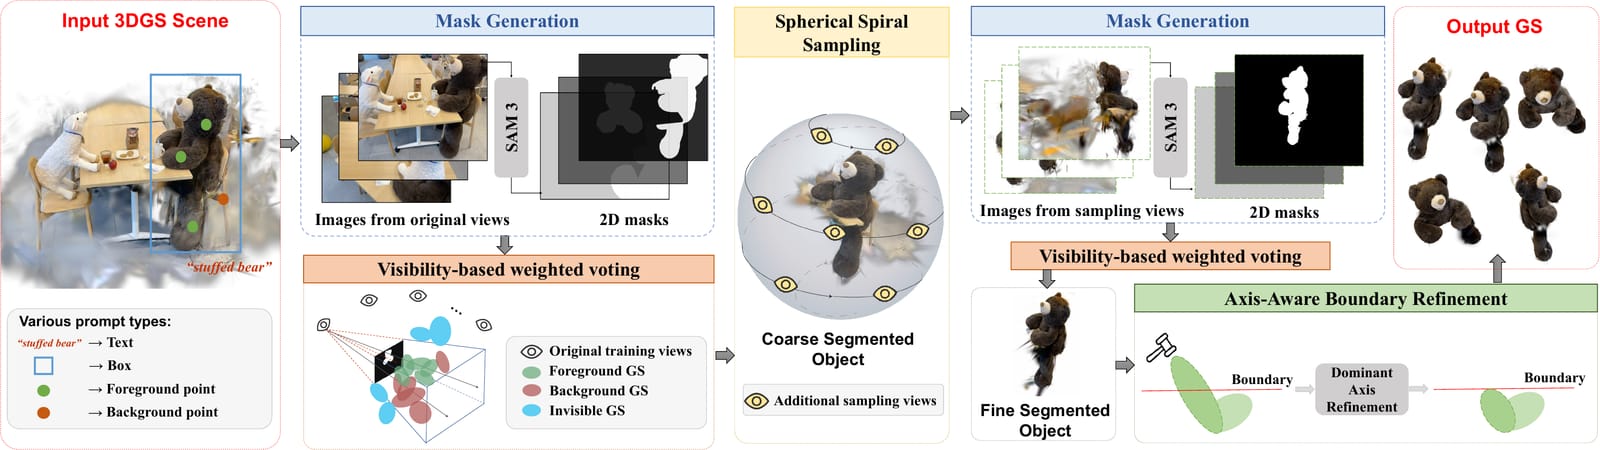
VCAR
すでに完成した3Dガウシアンスプラッティングのシーンから、追加学習なしで狙ったオブジェクトだけを切り出せるセグメンテーション手法。境界のにじみを抑えた高精度な抜き出しが可能。
暨南大学(Jinan University) / GitHub
#Spatial/3D#CreatorTools
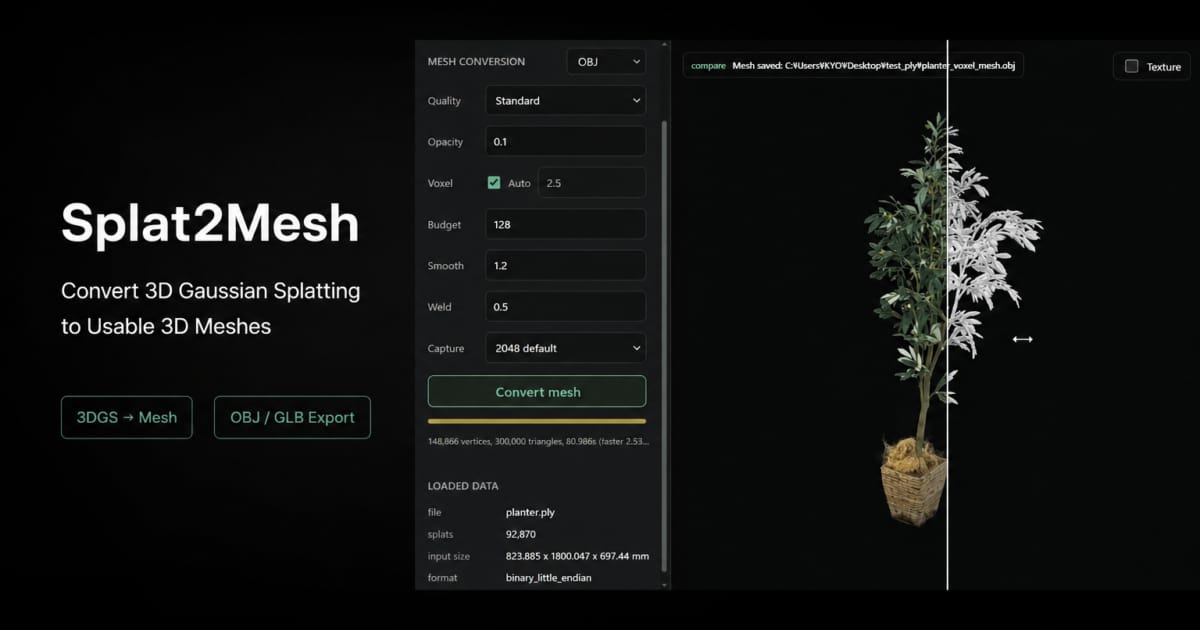
Splat2Mesh
3Dガウシアンスプラッティングのデータ(PLY)を、Blenderやゲームエンジンでそのまま使えるポリゴンメッシュ(OBJ/GLB)に変換するWindows向けの無料デスクトップツール。
株式会社Arcana製作所(Arcana Mfg.)
#Spatial/3D#CreatorTools
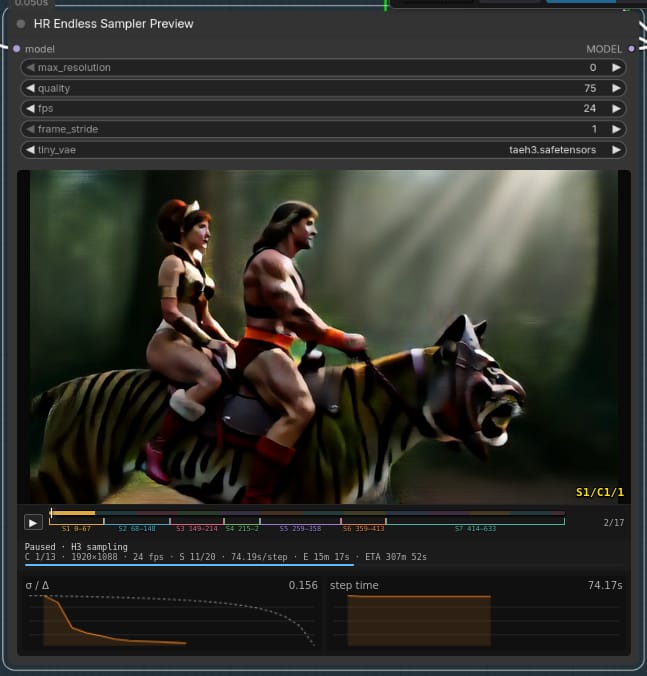
HR Endless Sampler (ComfyUI-HR-Endless-Sampler)
ComfyUIで、AI動画を「何分でも」自然に破綻なく作り続けられるようにする新しいサンプラー。長尺化のたびに人物や背景がズレる問題を、AIに台本を書かせ続けることで解決する。
hradec(個人開発者) / GitHub
#GenVideo#CreatorTools
RAVEN Streaming LoRA for MiniMax-H3 (MiniMax-H3-RAVEN-Streaming-LoRA)
動画生成AIを「作ってから見せる」から「見せながら作る」へ変える研究。動画全体を一括計算するのではなく、直前の映像を見ながら次の一区切りをリアルタイムに生成し続ける「ストリーミング型」動画生成を実現した。
Imperial College London(mvp-ai-lab) / GitHub
#GenVideo#CreatorTools
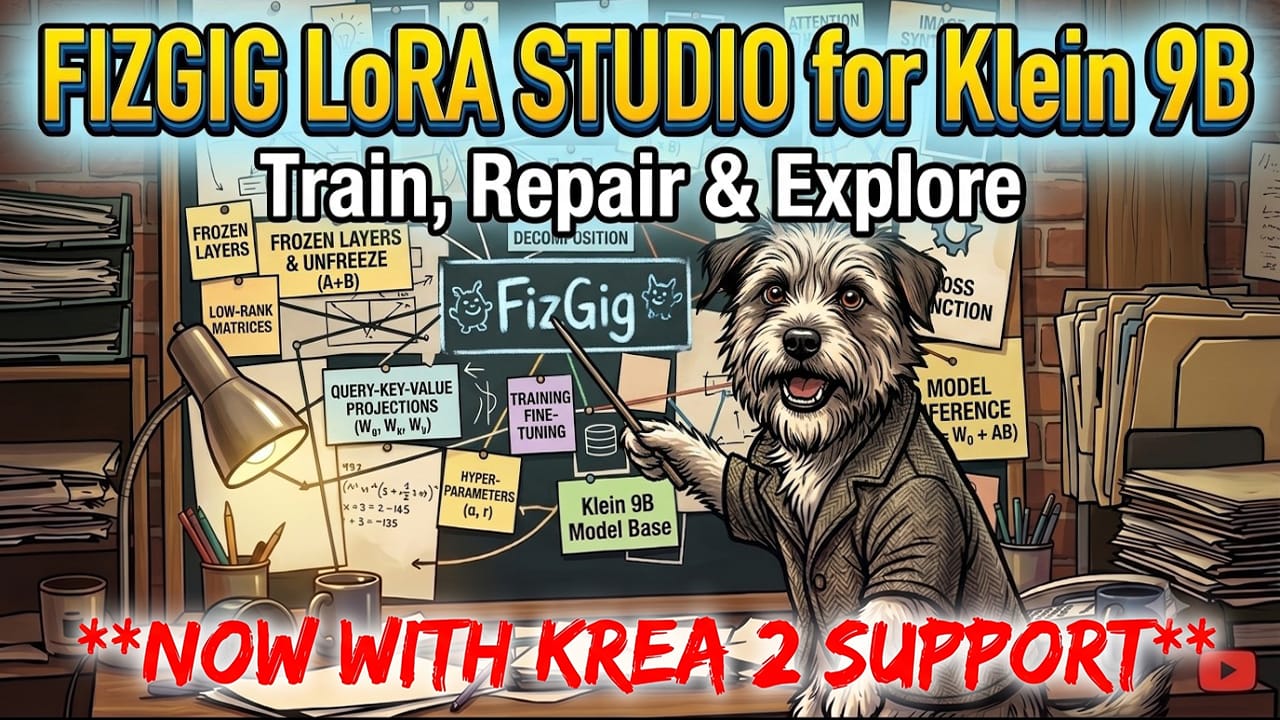
Fizgig v5
一般的なゲーミングPC程度のGPU(16GB〜)だけで、動画生成AI「MiniMax H3」や画像生成AI「Krea 2」などのモデル本体そのものを丸ごと学習し直せる、無料のオープンソース学習ツール。
shootthesound (Peter Neill) / GitHub
#GenVideo#CreatorTools
@luma.gl/splats (luma.gl 9.4.0 beta)
ブラウザで動くGaussian Splatting(3D点群による写実的3D表現)を、他の重いライブラリに依存せずGPU上で直接描画できる新モジュール。
vis.gl / OpenJS Foundation (旧Uber発OSS) / GitHub
#Spatial/3D#CreatorTools
Gaussian Splat Cleanup HDA
3Dソフト大手Houdini向けに、Gaussian Splattingデータのゴミ(重複点・ノイズ・浮遊物)を自動で掃除してくれる無料ツール。
Nodeconnector
#Spatial/3D#CreatorTools
Insta360 X6 Spatial Capture
360度カメラで撮るだけで、その場をグルグル歩き回れる3D空間(Gaussian Splat)に自動変換してくれる新機能。
Insta360(バックエンド処理:Remy Innovation Technology/KIRI Engine開発元)
#Spatial/3D#CreatorTools
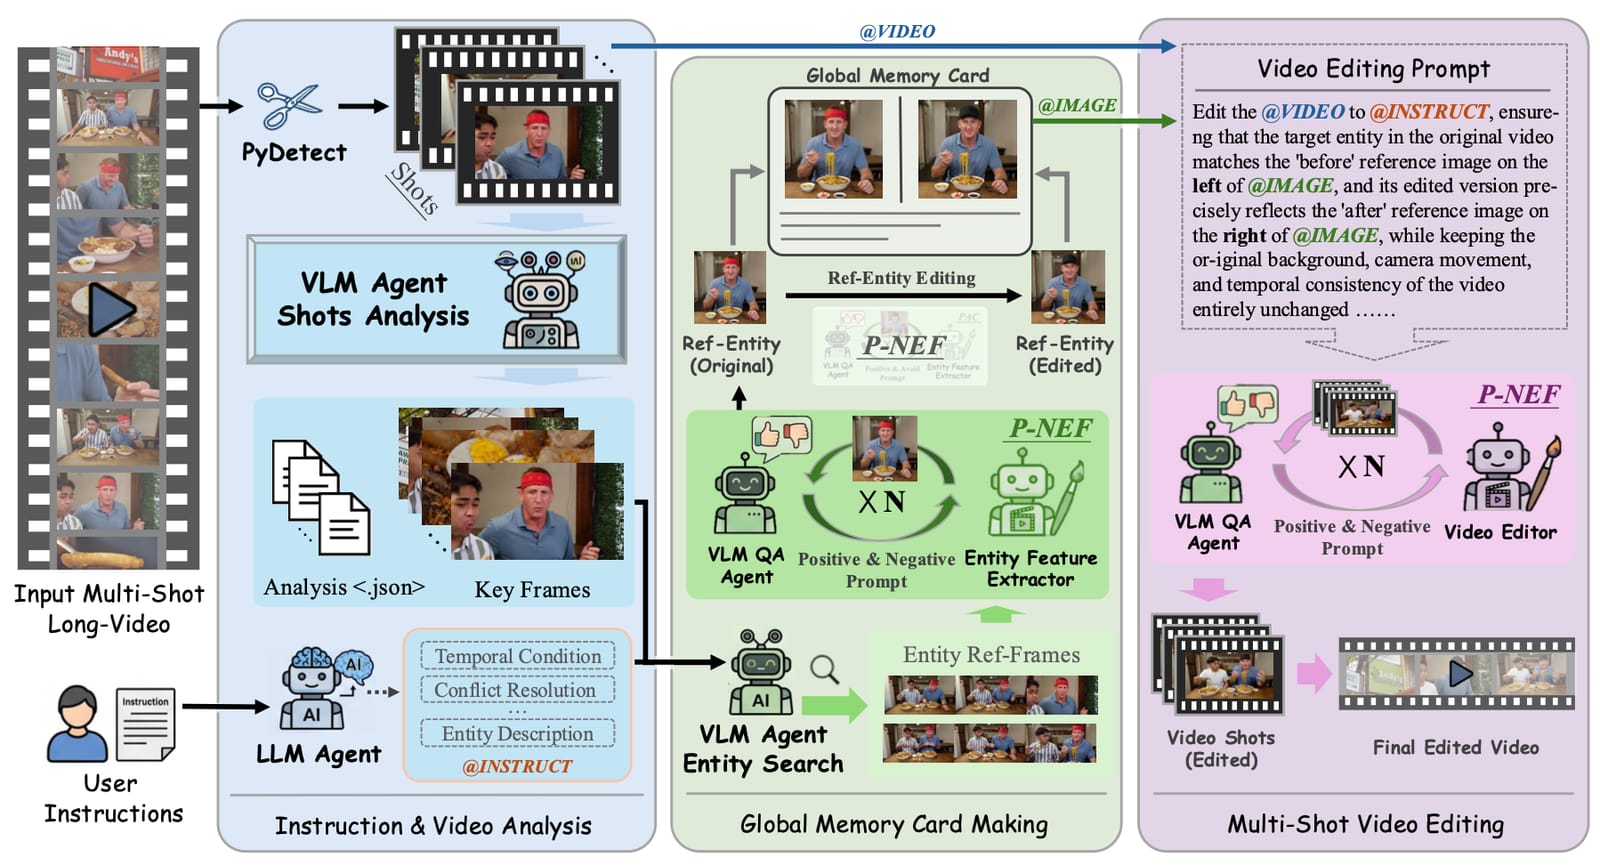
MMLVE (Thinking on Shots)
複数カットからなる長尺動画を、人物の同一性・背景・カメラワークを保ったまま自然言語の指示だけで一括編集できるAIエージェント。
Nankai University (VCIP) / Tencent Smart Creation Platform / GitHub
#AI/Agents#GenVideo#CreatorTools
audio.cpp
音声・音楽まわりのAIモデル60種類以上を、Pythonなしで手元のパソコン上で軽快に動かせるオープンソースの推論エンジン。
0xShug0(OSSコミュニティプロジェクト) / GitHub
#Audio/Music#CreatorTools
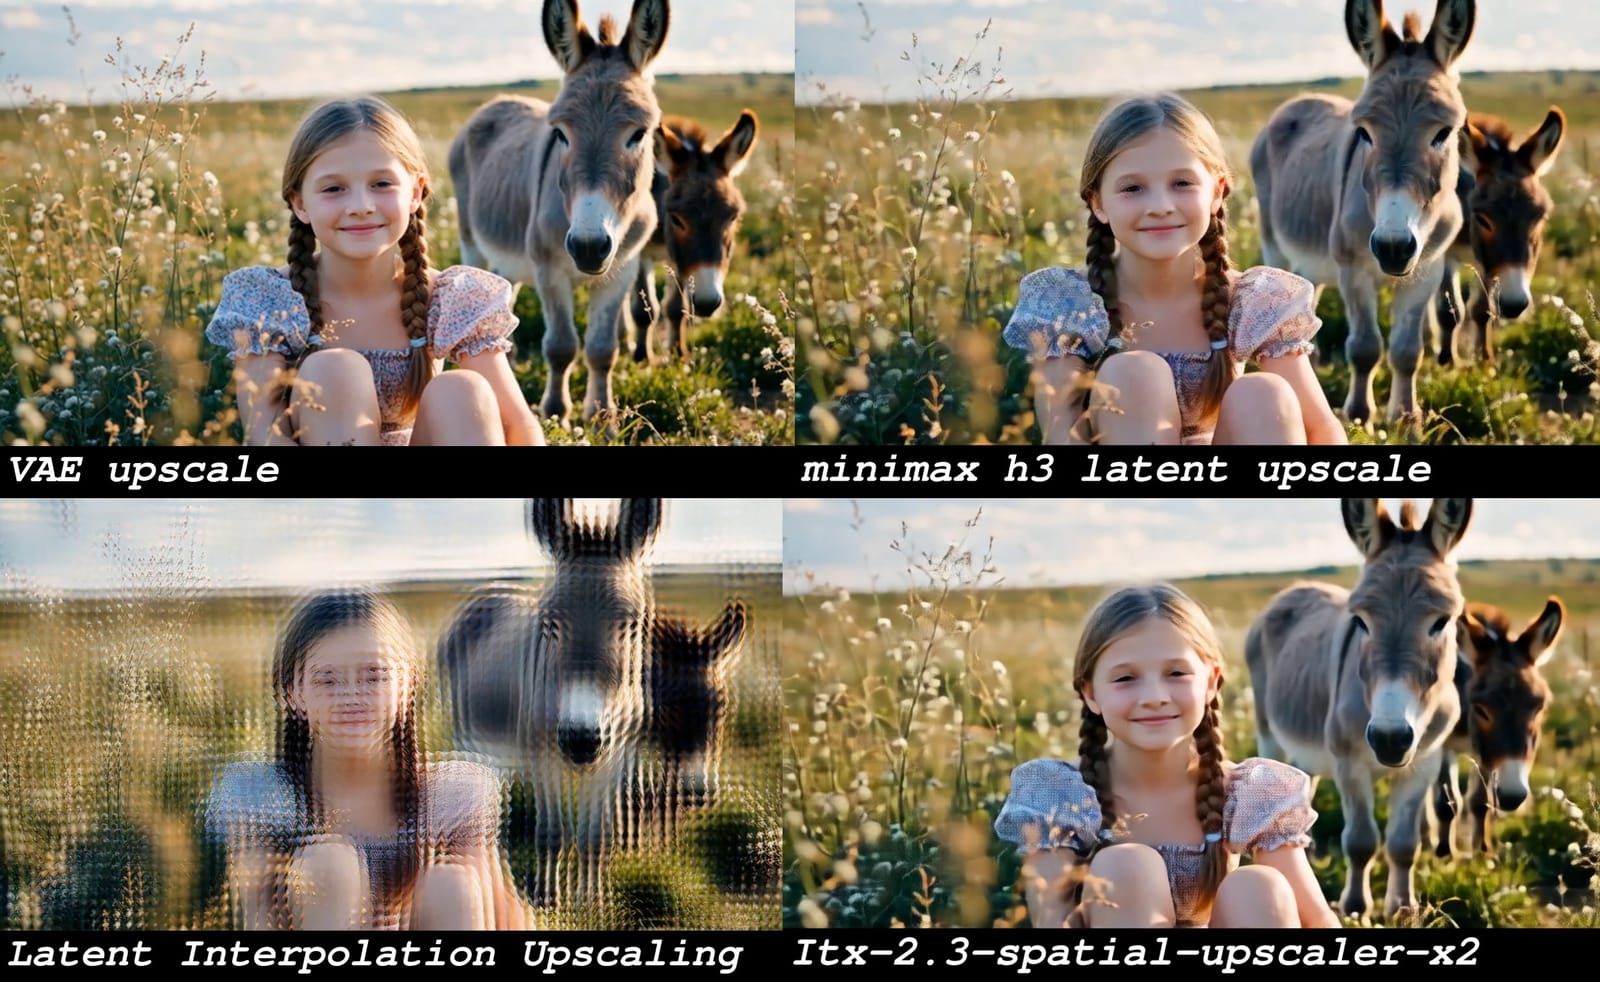
Minimax H3 Latent Upscaler
MiniMax H3が動画を生成する際の内部データ(潜在表現)を、映像に戻さず直接高解像度化するComfyUI拡張ノード。
LBH-123-AI(コミュニティ開発) / GitHub
#GenVideo#CreatorTools
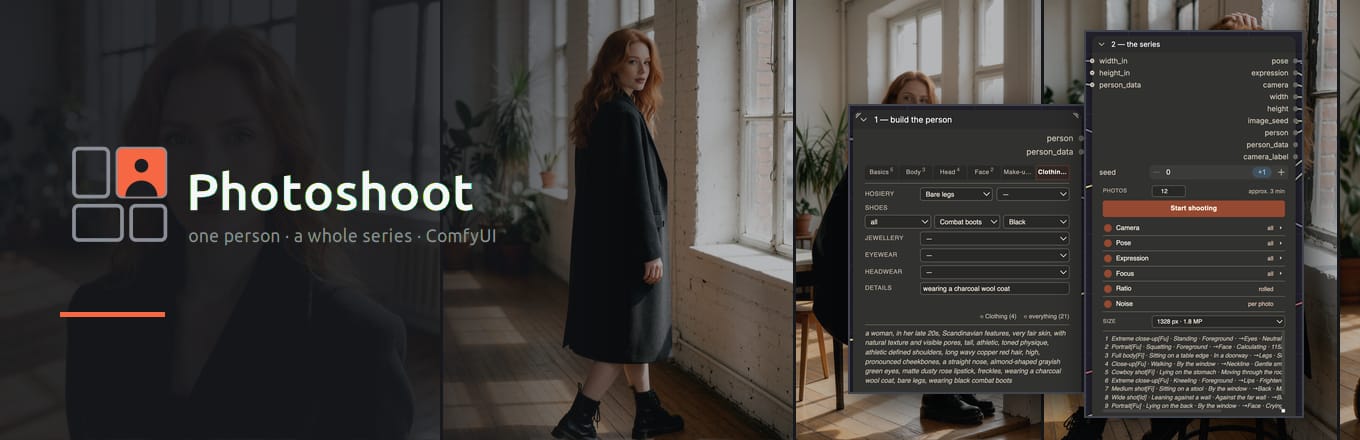
ComfyUI-Photoshoot
1人のキャラクターを一度作り込めば、構図・ポーズ・表情違いの写真を一貫性を保ったまま大量生成できるComfyUI拡張。
ralksta(個人開発) / GitHub
#CreatorTools
ComfyUI-OrbitSheets
動画生成AI「MiniMax H3」のカメラワークを利用し、同一キャラクター・同一ロケーションを崩さずに複数アングルの参考シートを作るComfyUI拡張。
lumosai8(個人開発) / GitHub
#GenVideo#CreatorTools
PCD Splatter (Point Cloud Density Splatter)
レーザースキャンの点群データを、AI学習の工程を一切挟まずにその場でガウシアンスプラットに変換するBlenderアドオン。
Punto de Ancla Studio
#Spatial/3D#CreatorTools
Point Cloud Merger for Blender (PCM)
地上撮影・ドローン空撮など別々に作った複数のCOLMAP点群データを、Blender上でクリックするだけで位置合わせして1つに統合できるアドオン。
Olli Huttunen(ToppiNappi)
#Spatial/3D#CreatorTools
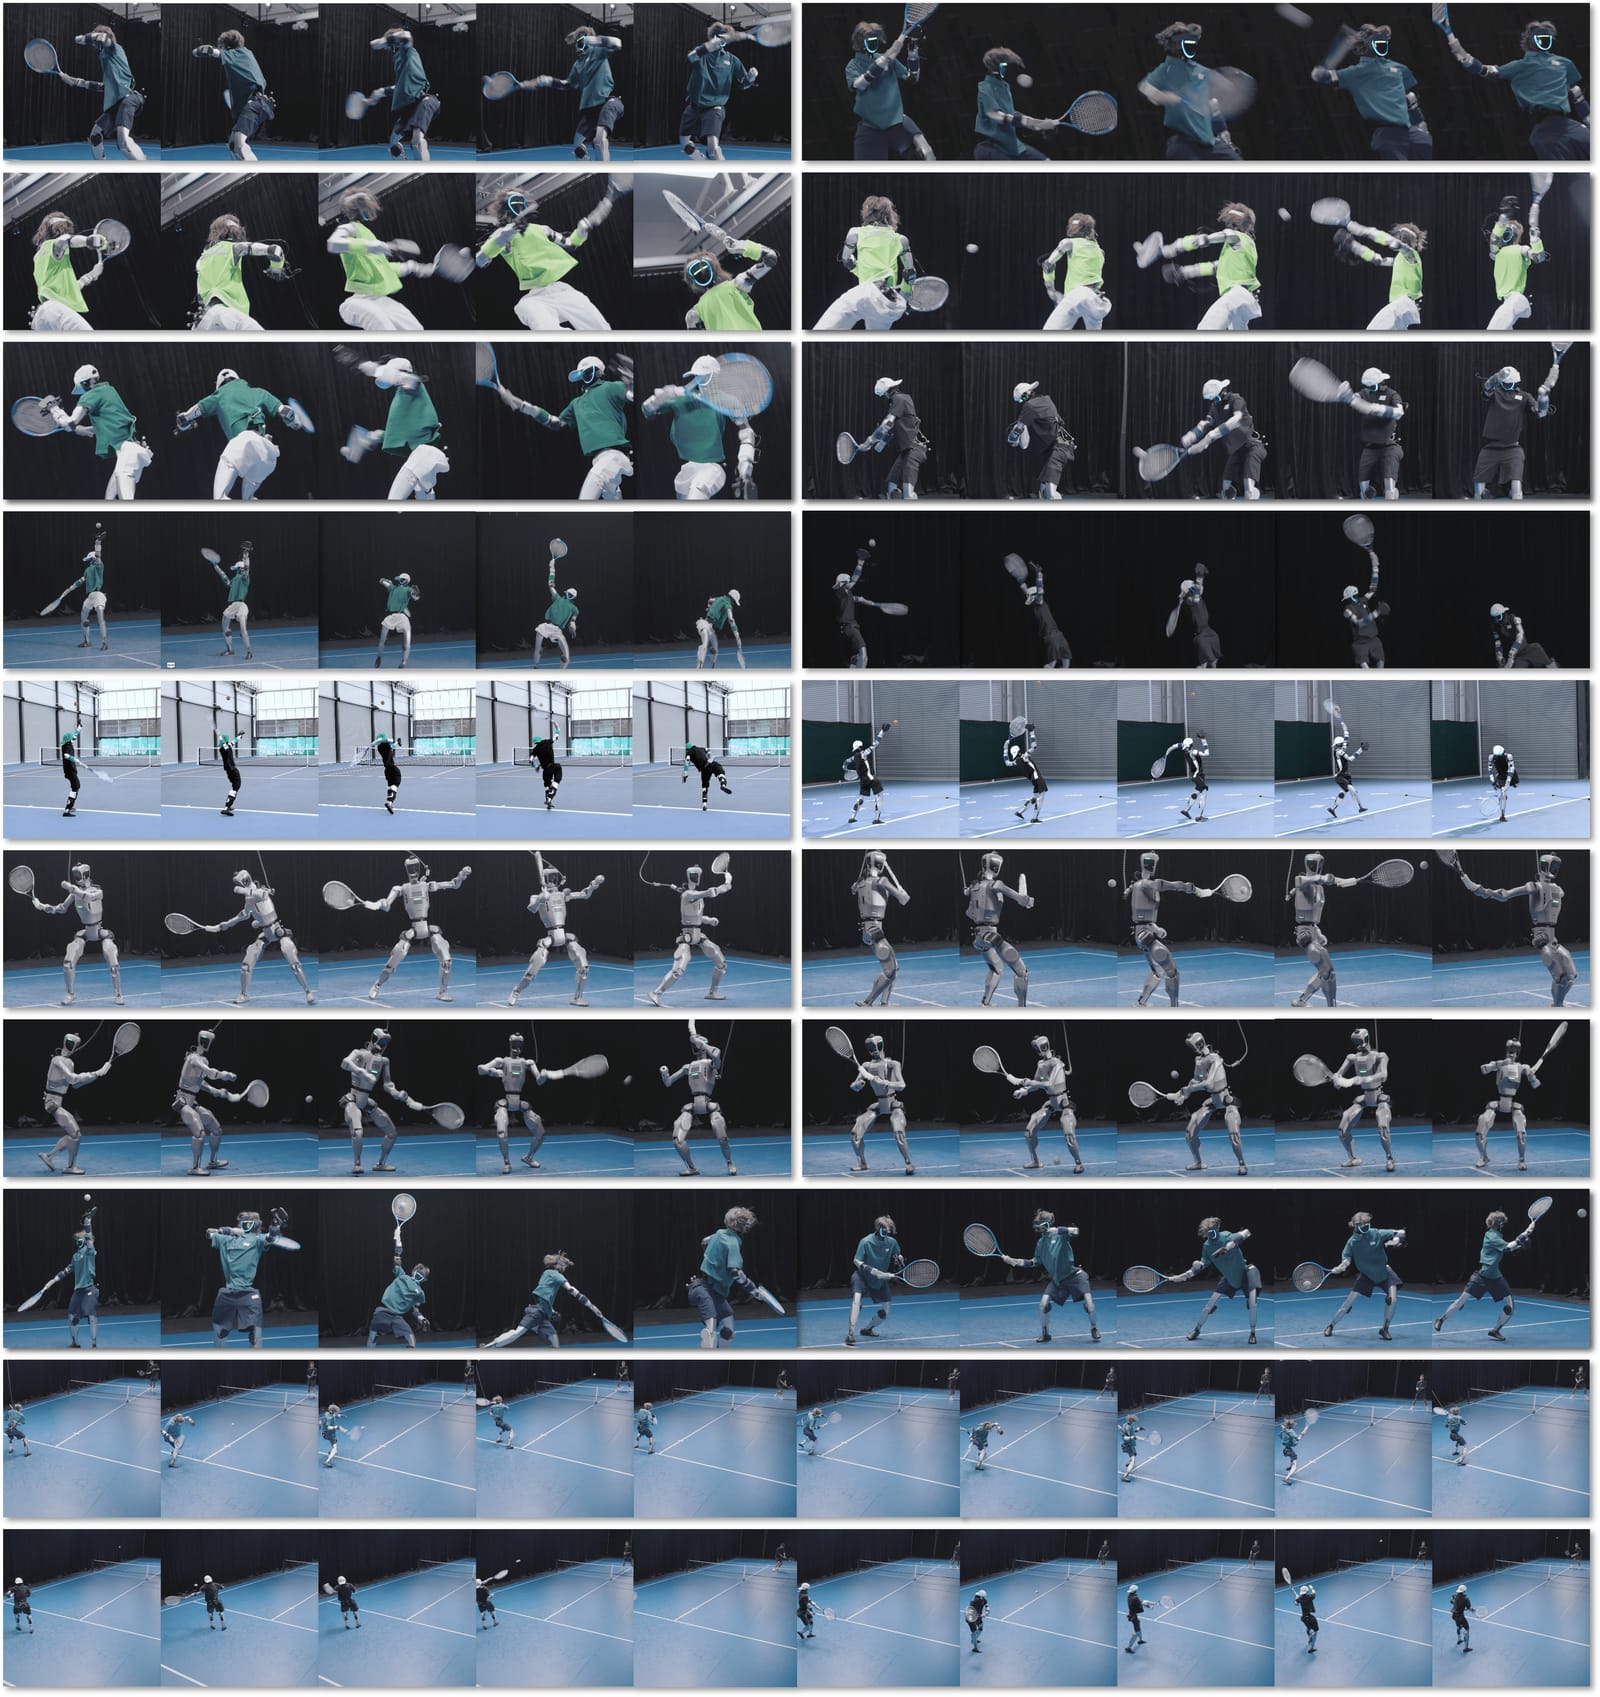
AdaPT
モーションキャプチャ機器メーカーNoitomのロボティクス部門が、ヒューマノイドロボットにフェデラー・ナダル・ジョコビッチ風のテニスサーブ/ラリーを『その選手らしいフォームのまま』打たせる技術を、コードと論文付きで無償公開。
Noitom Robotics(上海AIラボ・Dobot Robotics・上海交通大学と共同) / GitHub
#Motion/Body#HCI/MediaArt
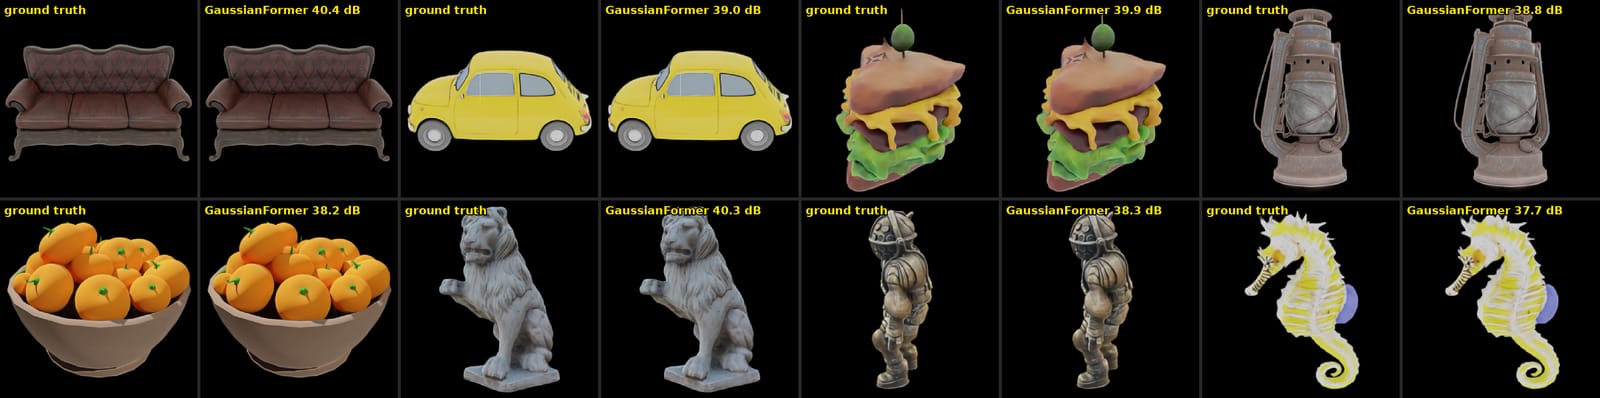
Mocara for Unreal Engine
「キャラクターが3歩進んで振り返り、体をひねって走り出す」といった文章を打ち込むだけで、Unreal Engine 5.8の中に直接キャラクターアニメーションを生成できるエディタ拡張プラグイン。
Conalh(個人開発・NVIDIA Kimodoモデルを利用) / GitHub
#CreatorTools#Motion/Body#AI/Agents
MotionMind
ダンス動画を1本渡すだけで、3Dアバターがその動きを再現し、AIが振り付けの意味を理解してステップごとに分解し、さらに音声で動き方を教えてくれるコーチにまでなる一気通貫パイプライン。
Rohit Acharya(個人開発) / GitHub
#Motion/Body#AI/Agents#CreatorTools
Qwen-Video-Edit
動画を指示文だけで編集できるAI。画像編集モデルを流用し、動画のコマを1枚の巨大画像のように並べ替えることで実現した。
Yunpeng Bai, Yossi Gandelsman, Michaël Gharbi, Qixing Huang (UT Austin / Adobe Research) / GitHub
#GenVideo#CreatorTools
Comfy MCP
Claude CodeやCursorなどのAIエージェントから、自分のPC上のComfyUIを直接操作できる公式ツール。
Comfy-Org / GitHub
#CreatorTools#AI/Agents
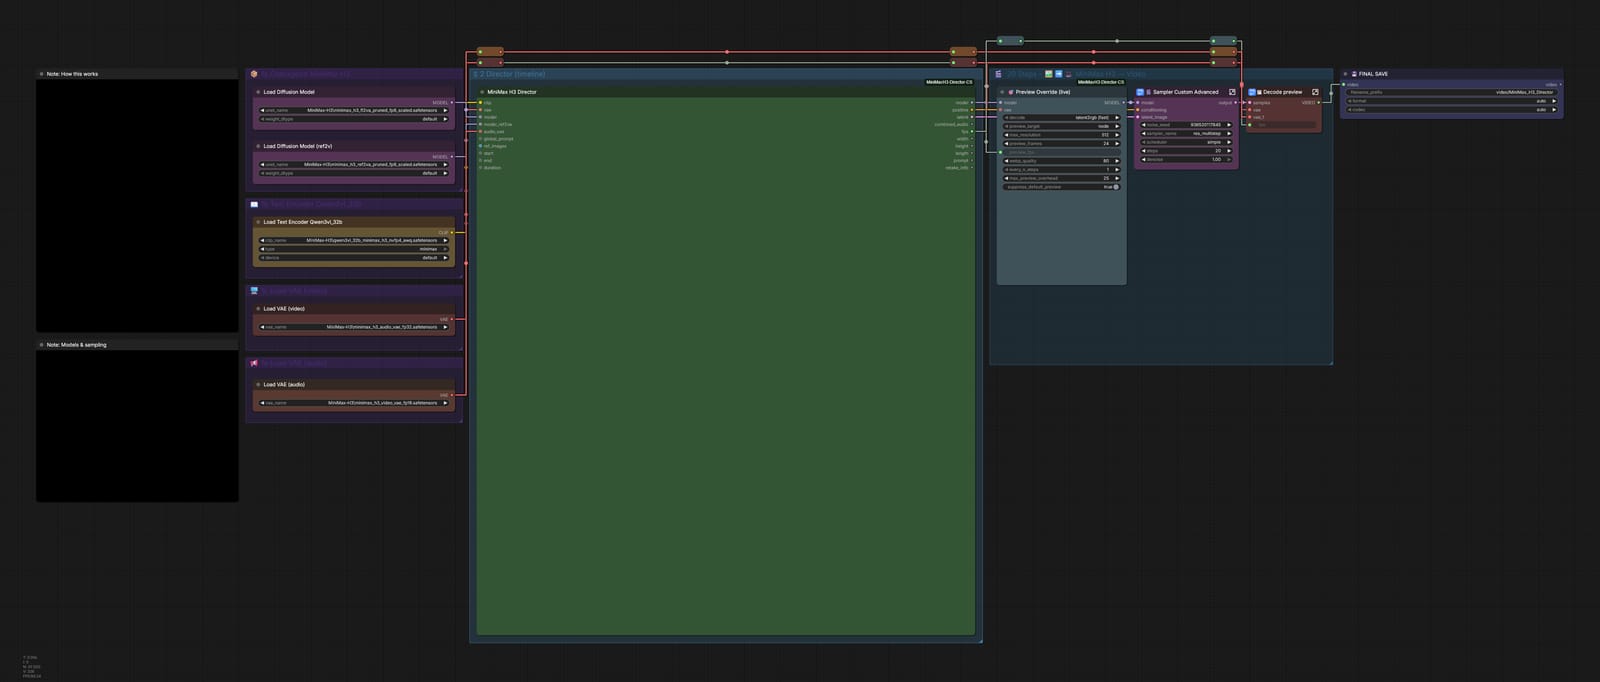
MiniMax H3 Director
ComfyUI上で動画生成AI「MiniMax H3」を、動画編集ソフトのようなタイムライン画面で演出できるツール。
seesee75(原型: WhatDreamsCost、対象モデル: MiniMax / Comfy-Org) / GitHub
#CreatorTools#GenVideo
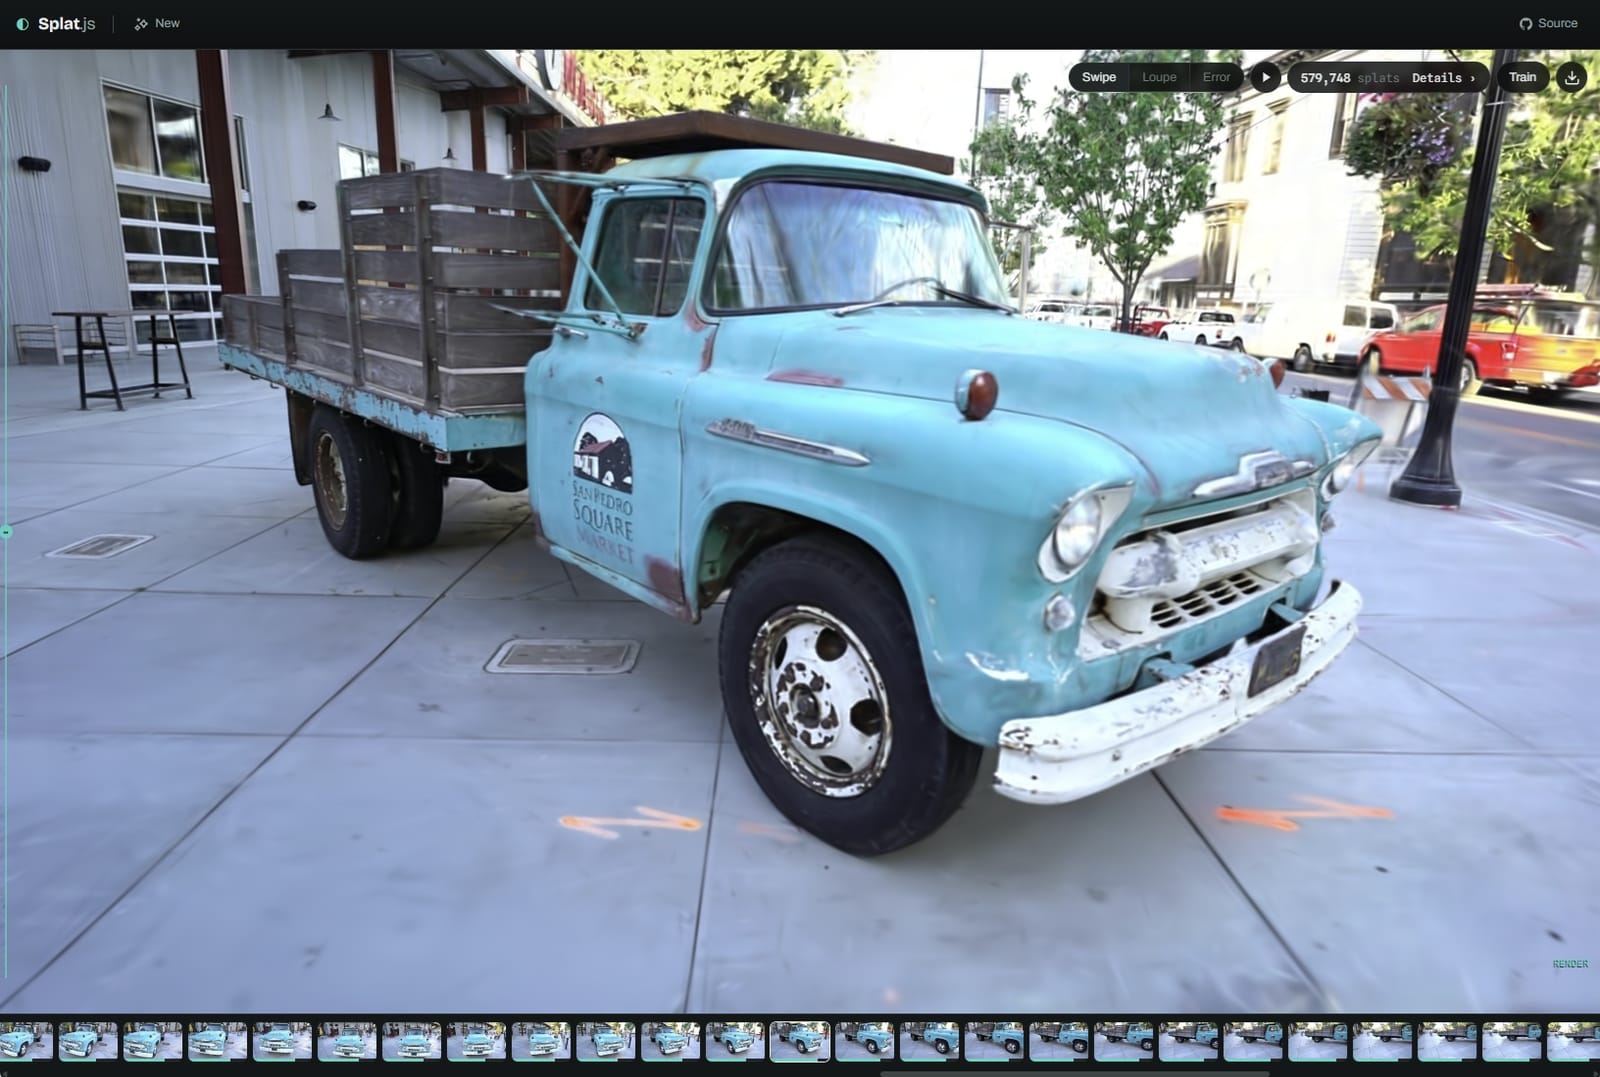
Splat.js
写真をアップロードもクラウドも使わず、ブラウザのタブだけでGaussian Splatting(立体を無数の光の粒の集合として表現する技術)に変換できるツール。
Arrival.Space (Stratum1 GmbH) / GitHub
#Spatial/3D#CreatorTools
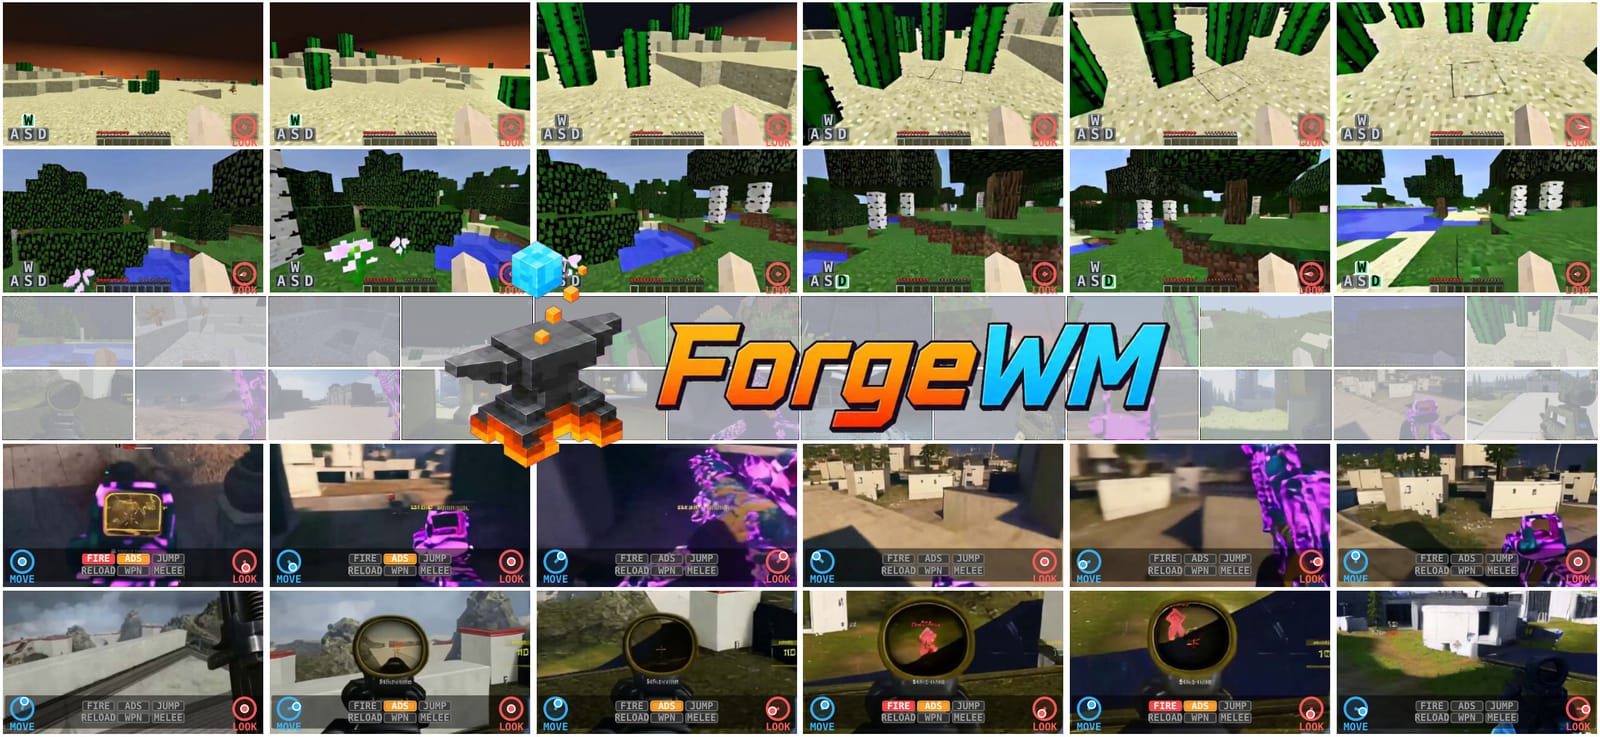
ForgeWM
キーボードやゲームパッドの操作にリアルタイムで反応し、次に見える映像をAIが直接生成し続ける『操作可能な動画世界モデル』。コード・学習済みモデル・論文すべて公開済み。
asdfo123(著者: Xinye Liほか、所属機関は論文上に明記なし) / GitHub
#Spatial/3D#GenVideo
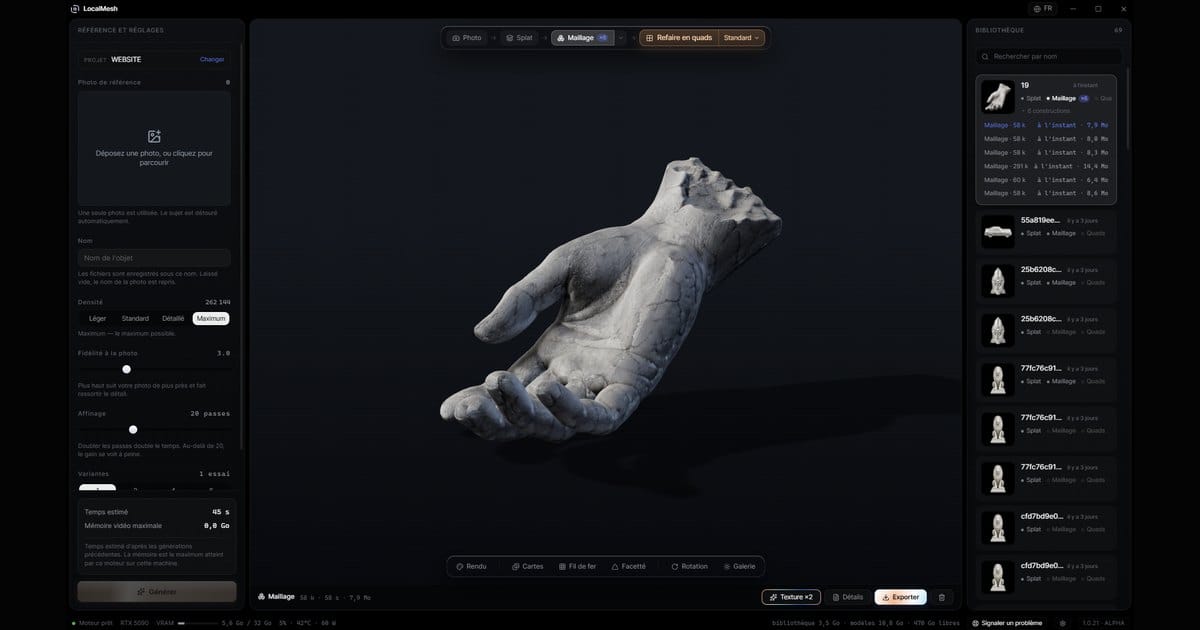
LocalMesh
写真1枚から3Dガウシアンスプラットとテクスチャ付き3Dメッシュを自動生成するWindows向けローカルアプリ。クラウド不要でGPU上で完結する。
不明(開発者名の明記なし。Tripo AIのTripoSplatモデルを内部利用)
#Spatial/3D#CreatorTools
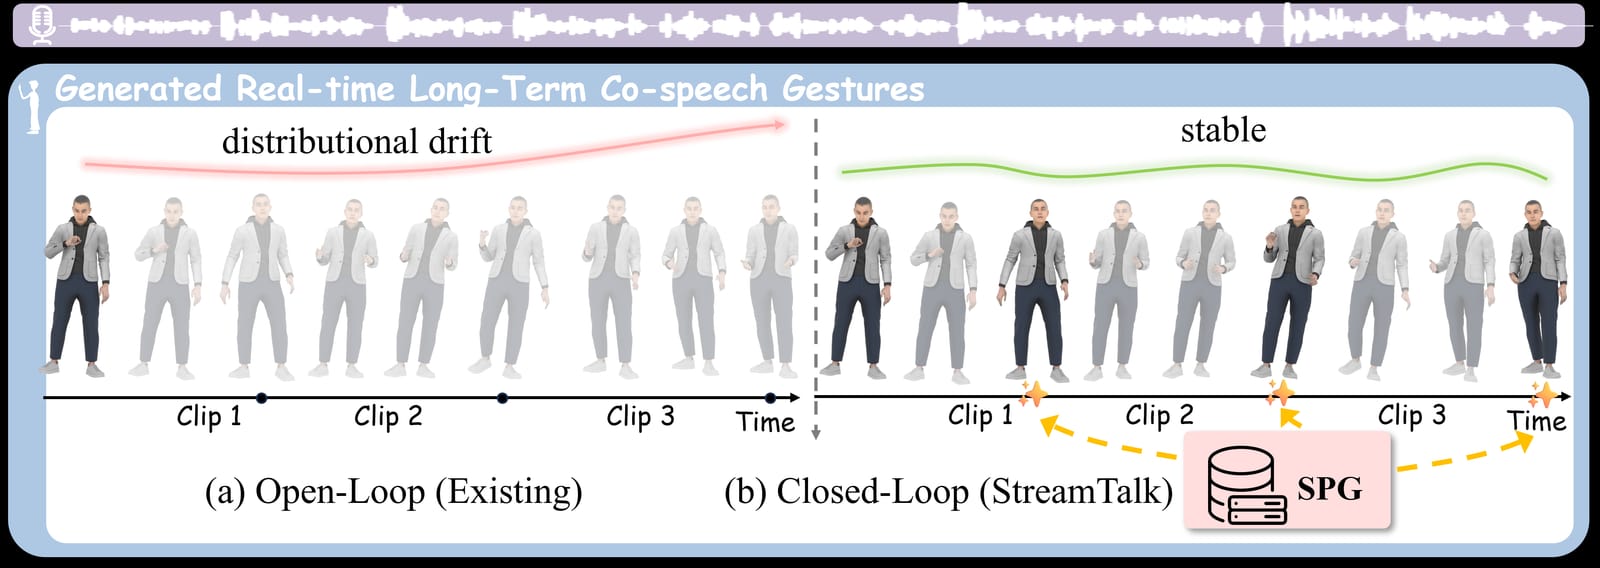
StreamTalk
スピーチ音声に合わせてリアルタイムで自然な身振り(ジェスチャー)を生成し続けるAI技術。長時間再生でも動きが徐々にズレていく問題を、要所ごとに姿勢を検算・修正する仕組みで抑えた。
東京大学 / Alibaba Tongyi Lab / 南洋理工大学 / 中国人民大学(国際共同研究) / GitHub
#Motion/Body#HCI/MediaArt
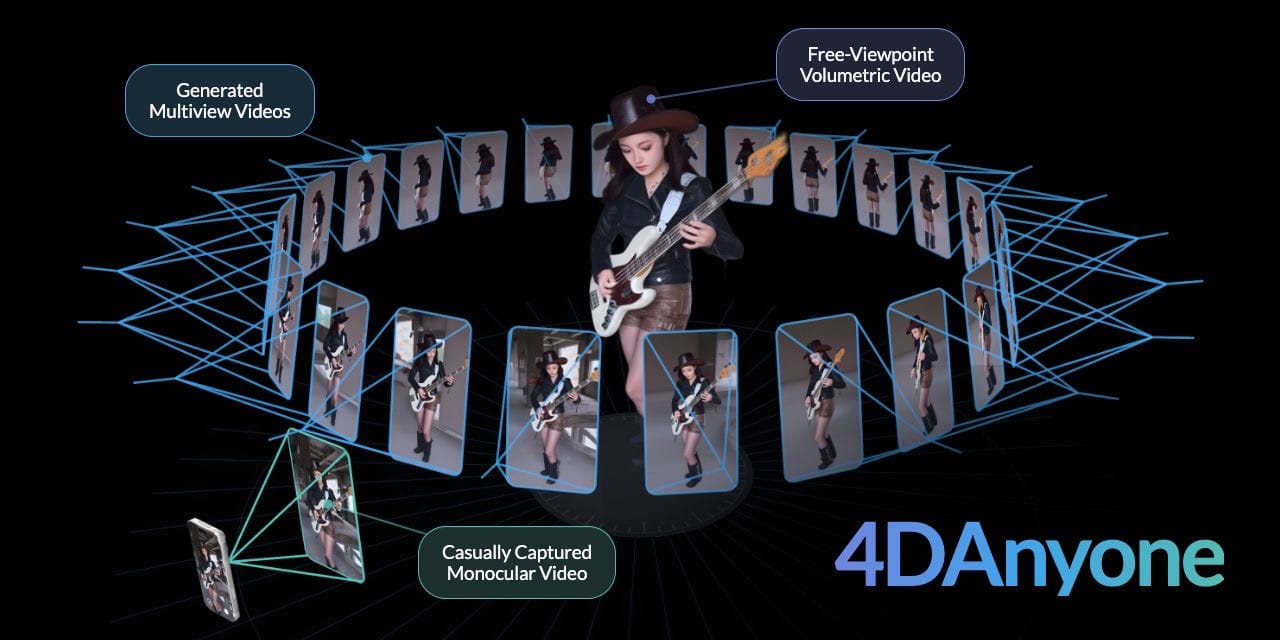
4DAnyone
1台のスマホで撮った普通の動画から、その場の人物を「4D(時間変化する3D)」データとして復元し、好きな角度から見返せるようにする技術。専用スタジオや複数カメラは不要。
Ant Research(浙江大学と共同研究) / GitHub
#Spatial/3D#Motion/Body
OpenVideo
ローカルAIチャットツール「Ollama」と同じ操作感で、自分のPCのGPU上に動画生成AI「MiniMax H3」を一行コマンドでインストールして動かせるオープンソースのCLIツール。
open-video-ai(OSSコミュニティ) / GitHub
#GenVideo#CreatorTools#AI/Agents
ComfyUI-H3-FaceRefine
動画生成AIが苦手とする「画面の中で小さく映る顔」だけを検出・拡大して描き直し、元の映像に自然に貼り戻すComfyUI用の拡張ツール。
Carasibana(個人開発者) / GitHub
#GenVideo#CreatorTools
MiniMax H3 Realism People LoRA
動画生成AI「MiniMax H3」に後から追加で読み込ませるだけで、人物の顔や肌の質感をぐっと写実的に近づける追加学習データ(LoRA)。
fal / GitHub
#GenVideo#CreatorTools
Onesplat
1枚の画像から数秒でGaussian Splat(半透明の粒の集合で立体を表す3D表現)を生成し、そのままHoudini内で使えるプラグイン。
TACTYC Studio
#Spatial/3D#CreatorTools
GaussianSplatting.jl v2.0.0
Julia言語だけで書かれたGaussian Splatting(3D点群レンダリング)の実装ライブラリ。MCMCによる高精度な点群制御と、空をきれいに分離する「Sky Dome」機能を追加。
JuliaNeuralGraphics / GitHub
#Spatial/3D#CreatorTools
360 Gaussian Pro
360度カメラの映像から自動でGaussian Splat(立体点群)を生成する有償デスクトップアプリ。COLMAPを独自に組み直し、Meta製の最新セグメンテーションAI「SAM3」による自動マスキングを搭載。
Laskos (Laskos Virtuals)
#Spatial/3D#CreatorTools
LEGO
3D空間を撮影した写真群から、「花瓶→花束→つぼみ→花びら」のように部分と全体の関係を自動で階層的に理解し、言葉で3D空間の物や場所を指し示せるようにする研究技術。
武漢大学 (Wuhan University) / 香港科技大学 (HKUST), USI-3DV Group / GitHub
#Spatial/3D#AI/Agents
LatentDance
1枚の参照キャラクター画像とお手本のポーズ動画から、キャラクターの見た目を保ったまま自然でダイナミックな動きのアニメーションを生成する研究モデル。
Nanjing University of Science and Technology / GitHub
#Motion/Body#GenVideo
Anymotion
テキストで指示するだけでプロダクト紹介・SaaS解説動画のモーショングラフィックスをAIエージェントが自動生成し、1080pのMP4として書き出せるオープンソースのCLIツール。
Ali Usman(個人開発・OSS) / GitHub
#AI/Agents#CreatorTools
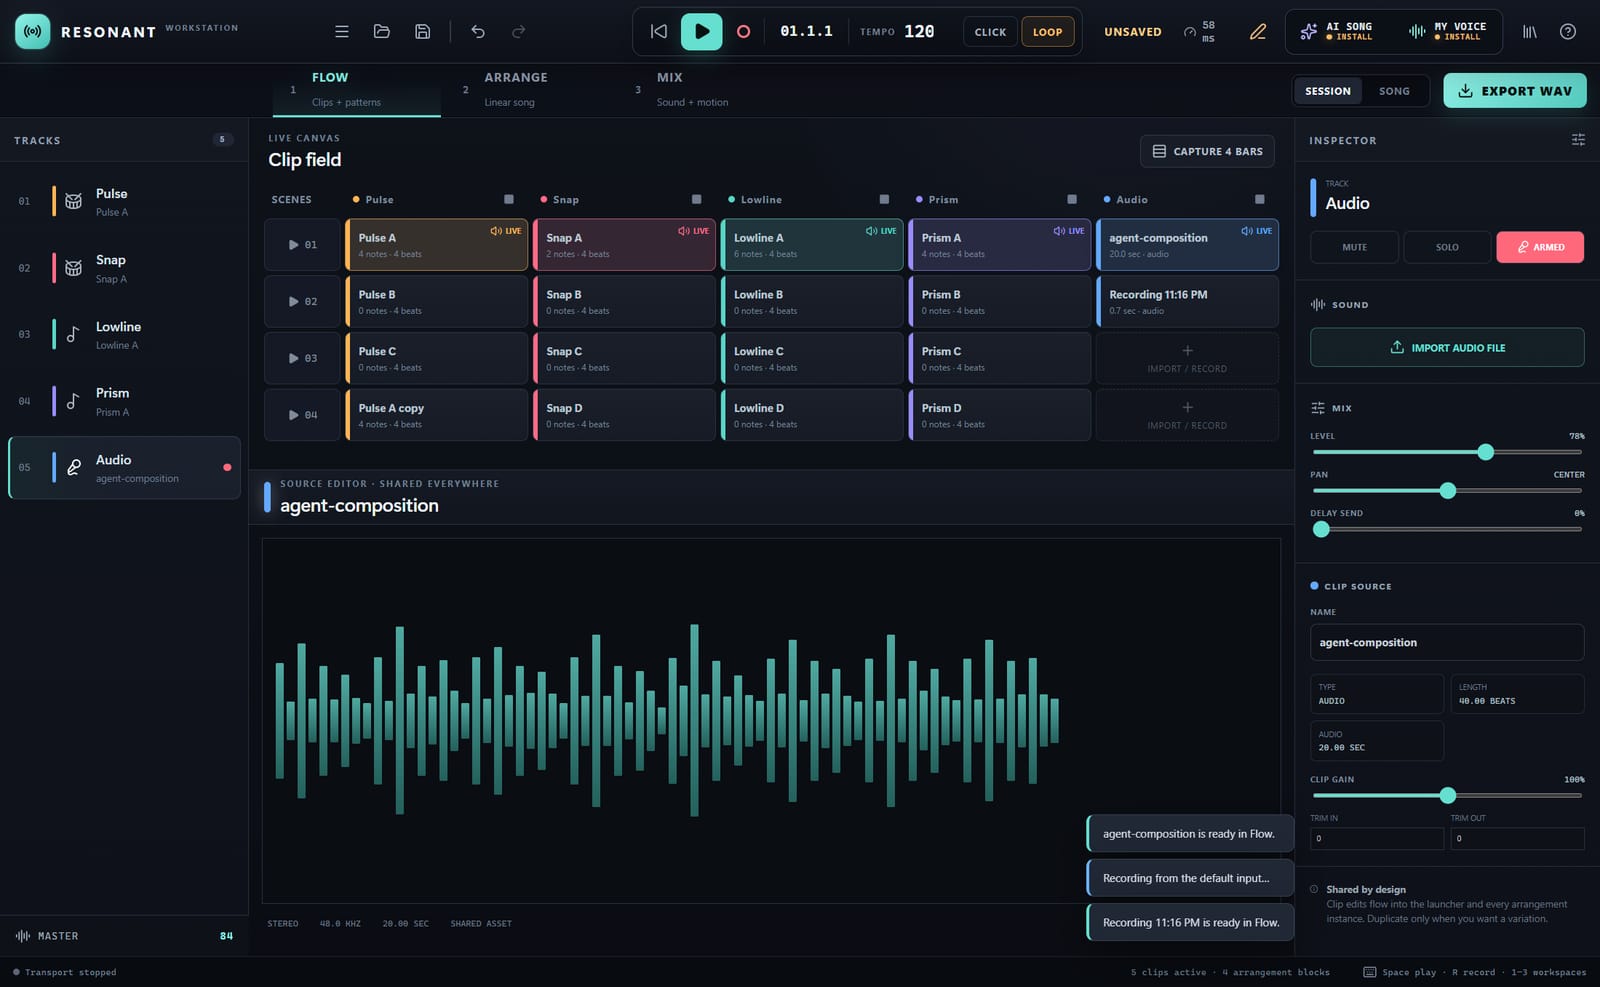
Resonant
Windows上で完結するローカルAI音楽制作スタジオ。作詞からAI作曲、自分の声への変換、DAW編集・書き出しまでを1台のPCだけで行え、Claude等のAIアシスタントにも自然言語で操作させられる。
Calesthio / GitHub
#Audio/Music#CreatorTools#AI/Agents
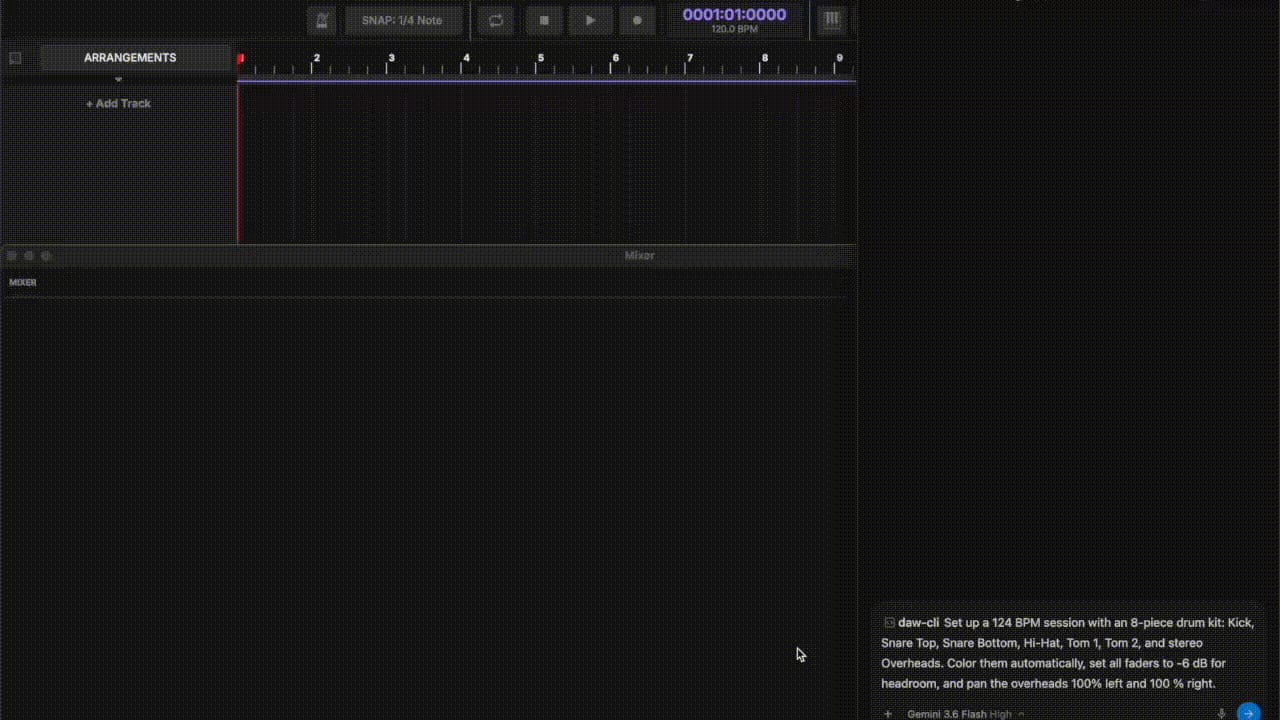
Stratawright
Claude CodeやCursorなどのAIコーディングエージェントが自然言語だけで直接操作できる、C++製の「エージェント制御前提」のDAW(音楽制作ソフト)。
Goldwaterfung (Kam Kiu Fung) / GitHub
#Audio/Music#CreatorTools#AI/Agents
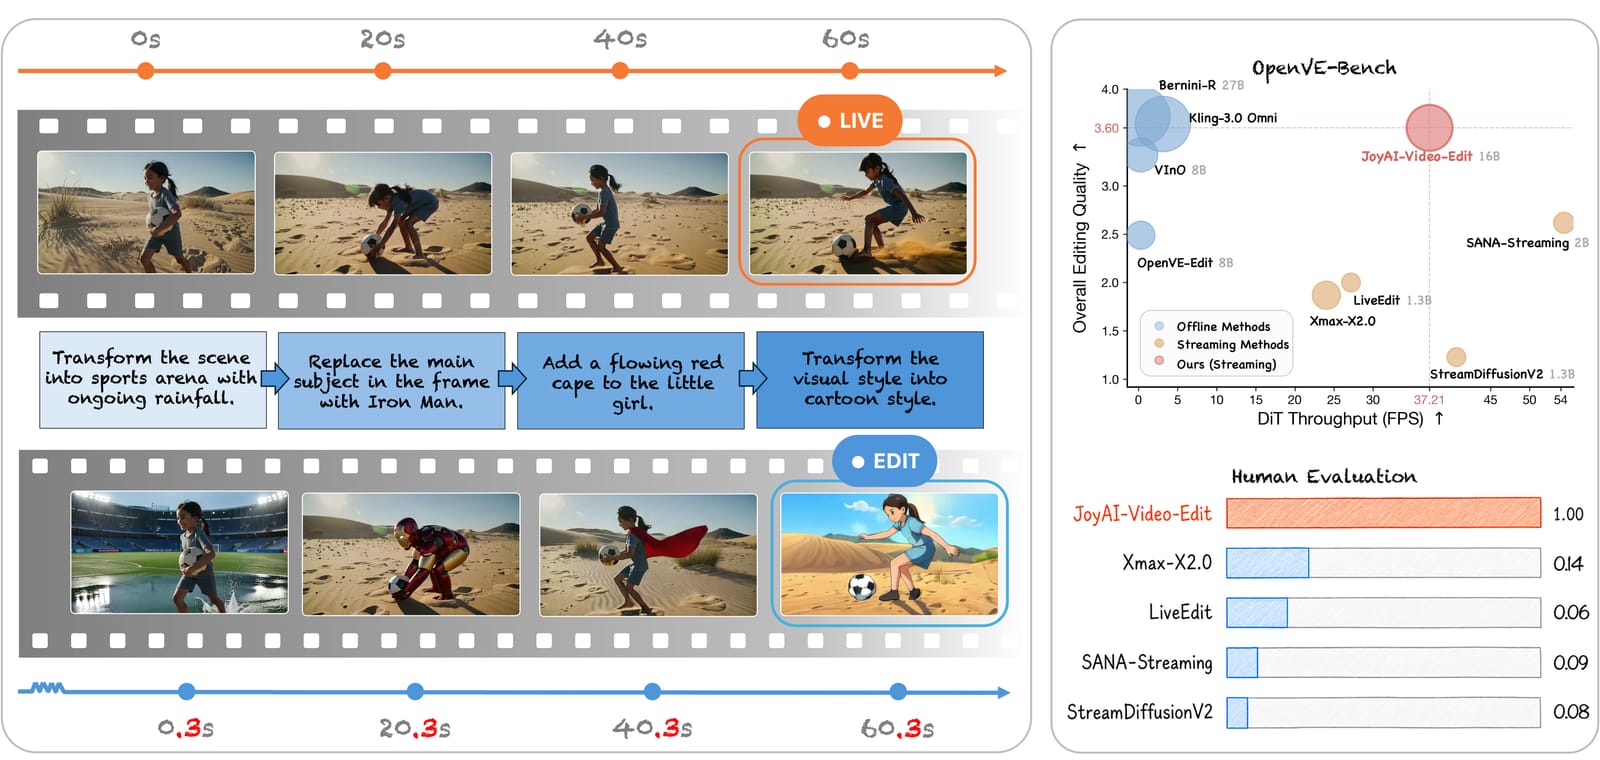
JoyAI-Video-Edit
テキスト指示だけで動画をリアルタイム編集できる160億パラメータの生成AI。JD.com(京東)が開発し、コード・学習済みモデル・技術レポートを無償公開した。
JD.com (JD Open Source / JoyAI Labs) / GitHub
#GenVideo#CreatorTools
OpenChatCut
会話しながら本物のマルチトラックタイムラインを編集できる、オープンソースのAI動画編集ソフト。ClaudeなどのAIエージェントが実際の編集操作を行う。
0xsline (独立開発・OSSコミュニティ) / GitHub
#CreatorTools#GenVideo#AI/Agents
FlexSplat
カメラの位置・角度をあらかじめ測っておかなくても、複数枚の物体写真から一発(1回の推論)で3Dガウシアンスプラットを組み立てるフィードフォワード型の3D再構成手法。
Georgia State University / Duke University / University of Tennessee, Knoxville / GitHub
#Spatial/3D#CreatorTools
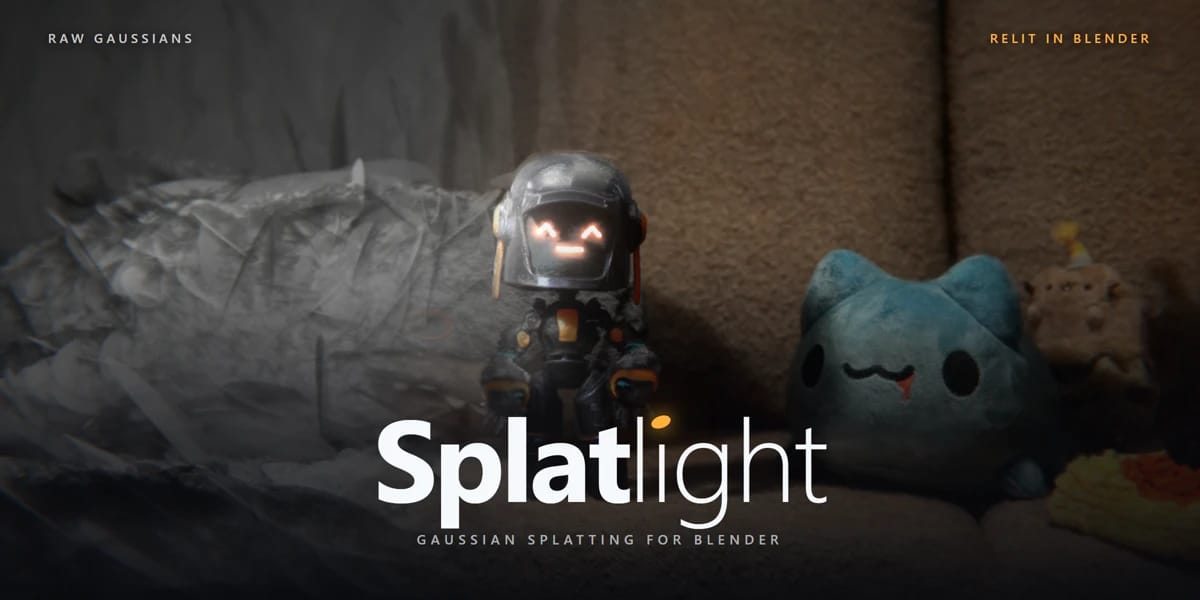
Splatlight
実写を3Dスキャンしたガウシアンスプラットに、Blenderのシーンライトに反応する自己遮蔽(セルフシャドウ)を後付けできるBlenderアドオン。
Javier Herrera
#Spatial/3D#CreatorTools
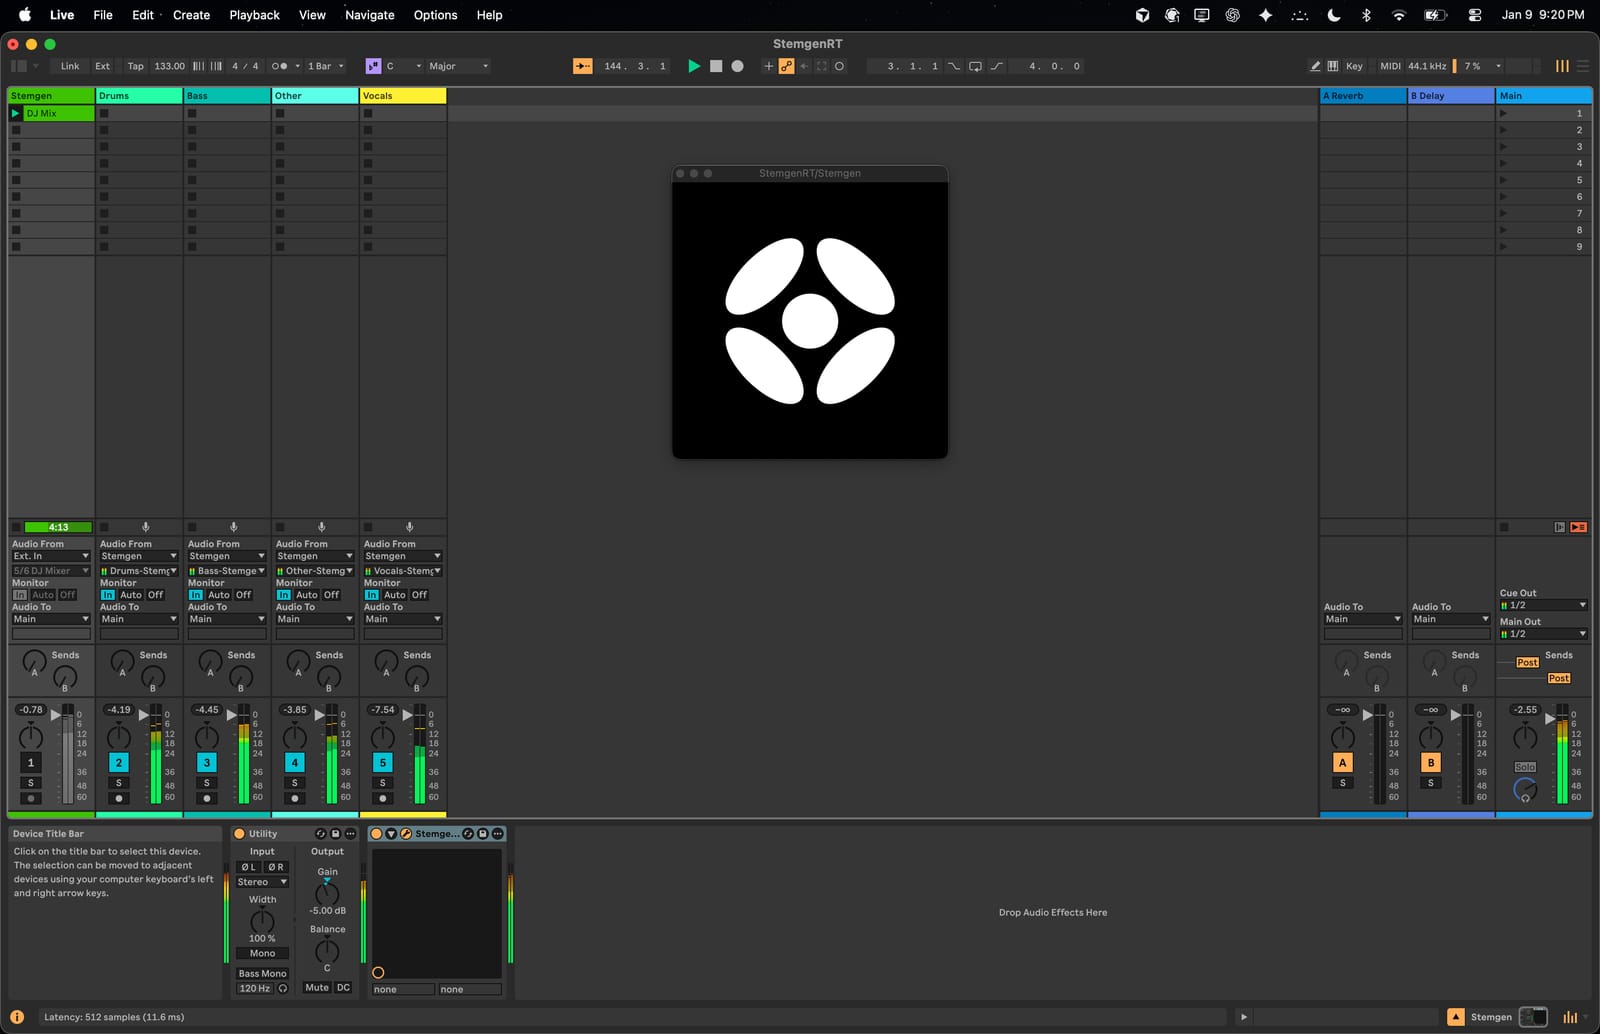
StemgenRT
曲を再生しながら「ボーカル」「ドラム」「ベース」「その他」の4トラックにわずか11.6ミリ秒の遅延でリアルタイム分離するオープンソースのDJ/DAW用プラグイン。
Sweet Spot Sound System / GitHub
#Audio/Music#CreatorTools#HCI/MediaArt
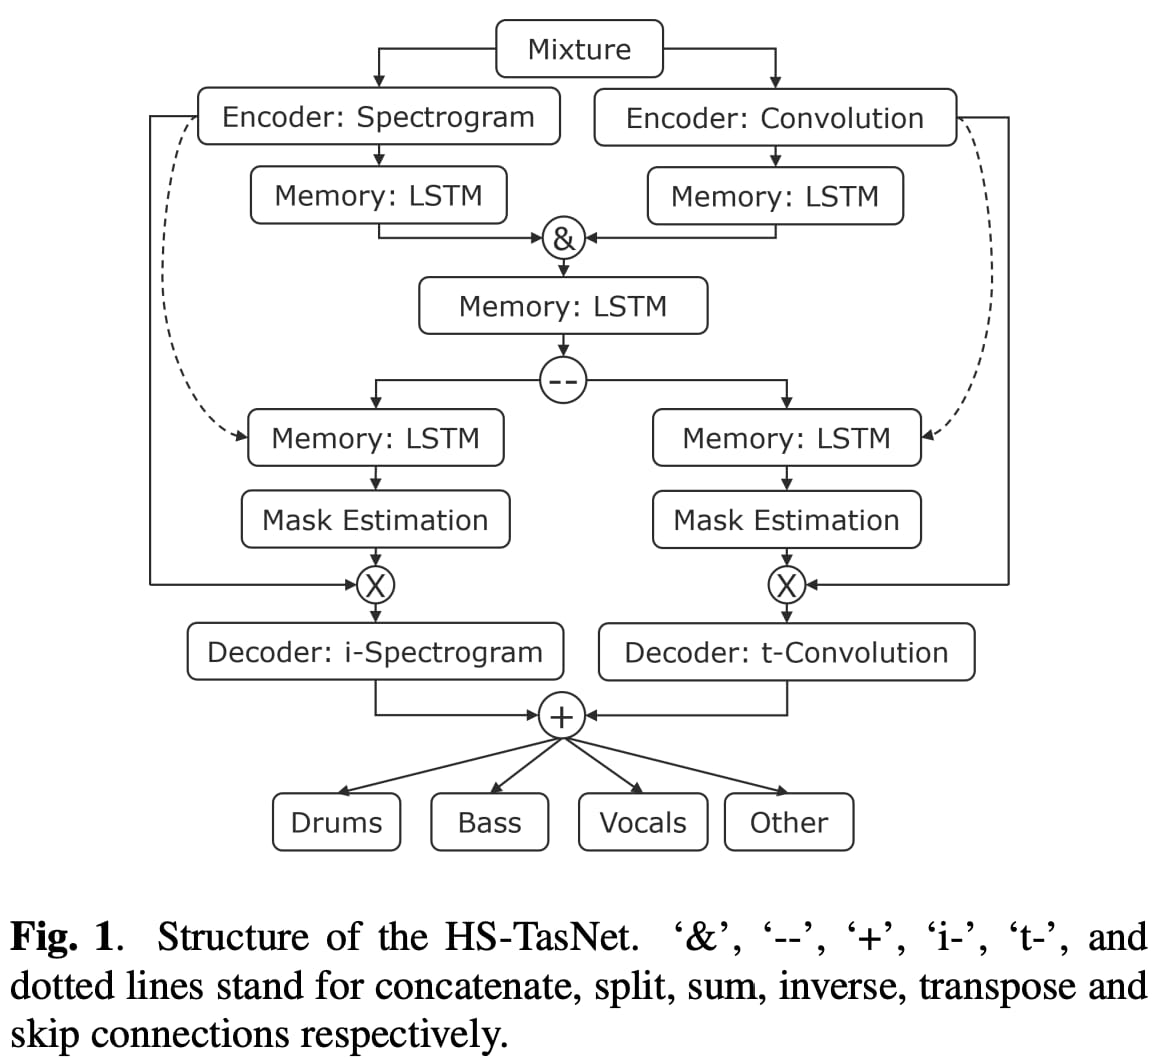
HS-TasNet
音声のスペクトログラムと波形の両方を同時に扱うハイブリッド型ニューラルネットワークで、23ミリ秒という極小フレームでボーカル・ドラム・ベース・その他をリアルタイムに分離する音源分離モデル。
L-Acoustics(原論文)/コミュニティ実装(lucidrains ほか) / GitHub
#Audio/Music#CreatorTools
Basic Pitch
音楽ファイルをアップロードするだけで、ボーカルや複数の楽器が同時に鳴っていても、ピッチベンドまで含めてMIDIファイルに変換できる、Spotify製の軽量な自動採譜AI。
Spotify (Audio Intelligence Lab) / GitHub
#Audio/Music#CreatorTools
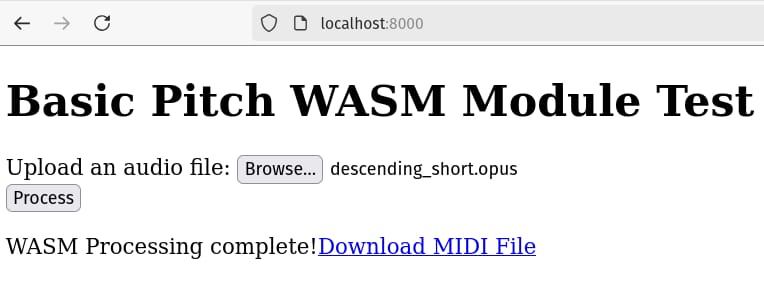
basicpitch.cpp
SpotifyのBasic PitchモデルをC++20で再実装し、ONNX RuntimeとWebAssemblyでネイティブアプリやブラウザ上でも高速に動かせるようにした軽量版音声→MIDI変換ツール。
Sevag Hanssian(個人開発) / GitHub
#Audio/Music#CreatorTools
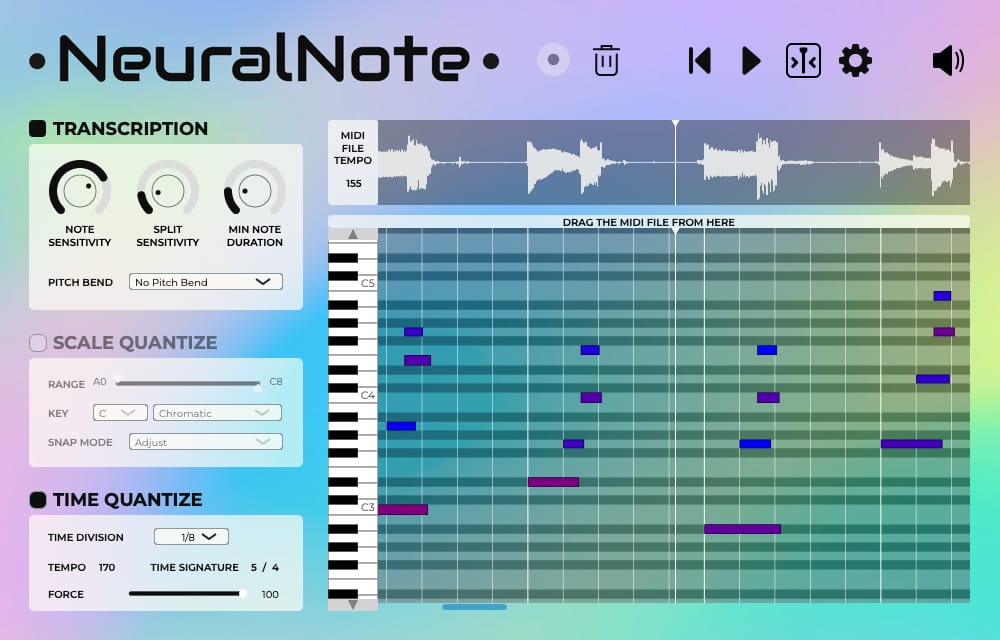
NeuralNote
DAW上で演奏や録音をした音声をほぼその場でMIDIノートに変換できる無料のオーディオプラグイン。Spotify製Basic Pitchモデルを内部で利用。
Damien Ronssin (DamRsn) / GitHub
#Audio/Music#CreatorTools
MT3 (Multi-Task Multitrack Music Transcription)
1本の音源ファイルから、ピアノだけでなくドラムやギター、管楽器など複数の楽器パートを同時に、それぞれ別のMIDIトラックとして書き起こせるTransformerベースの自動採譜モデル。
Google Magenta / GitHub
#Audio/Music
Omnizart
1曲の音声から、メロディ楽器の採譜だけでなくドラムのイベント検出、ボーカルメロディ、コード進行、ビート位置までまとめて書き起こせる、コマンド一つで使えるオープンソースの自動採譜ツールキット。
Music and Culture Technology Lab, Academia Sinica / GitHub
#Audio/Music#CreatorTools
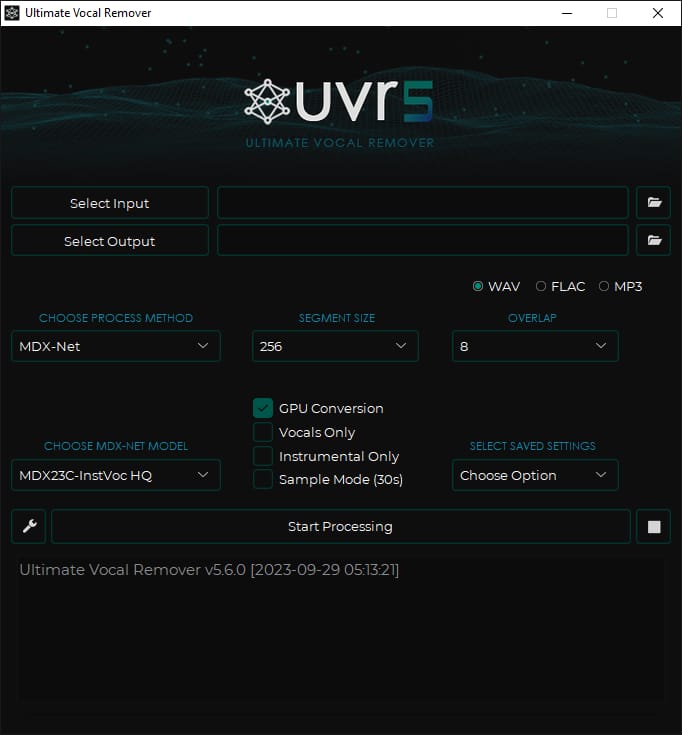
Ultimate Vocal Remover (UVR)
MDX-NetやDemucs、VRアーキテクチャなど複数の最先端AIモデルを切り替えながら使える、無料でWindows/Mac/Linux対応のボーカル・楽器分離デスクトップアプリ。
Anjok07 ほか(UVR開発チーム) / GitHub
#Audio/Music#CreatorTools
python-audio-separator (audio-separator)
UVRで培われた数百種類の学習済み音源分離モデルを、CLIコマンド一発またはPythonのAPIとして呼び出せるようにした開発者向けのステム分離ツール。
Nomad Karaoke / GitHub
#Audio/Music#CreatorTools
mlx-audio-separator
MacのApple Silicon専用機械学習フレームワーク「MLX」だけで動くように書き直された音源分離ツール。PyTorch不要で、既存ツールの最大2.5倍の速度でステムを書き出せる。
ssmall256(個人開発) / GitHub
#Audio/Music#CreatorTools
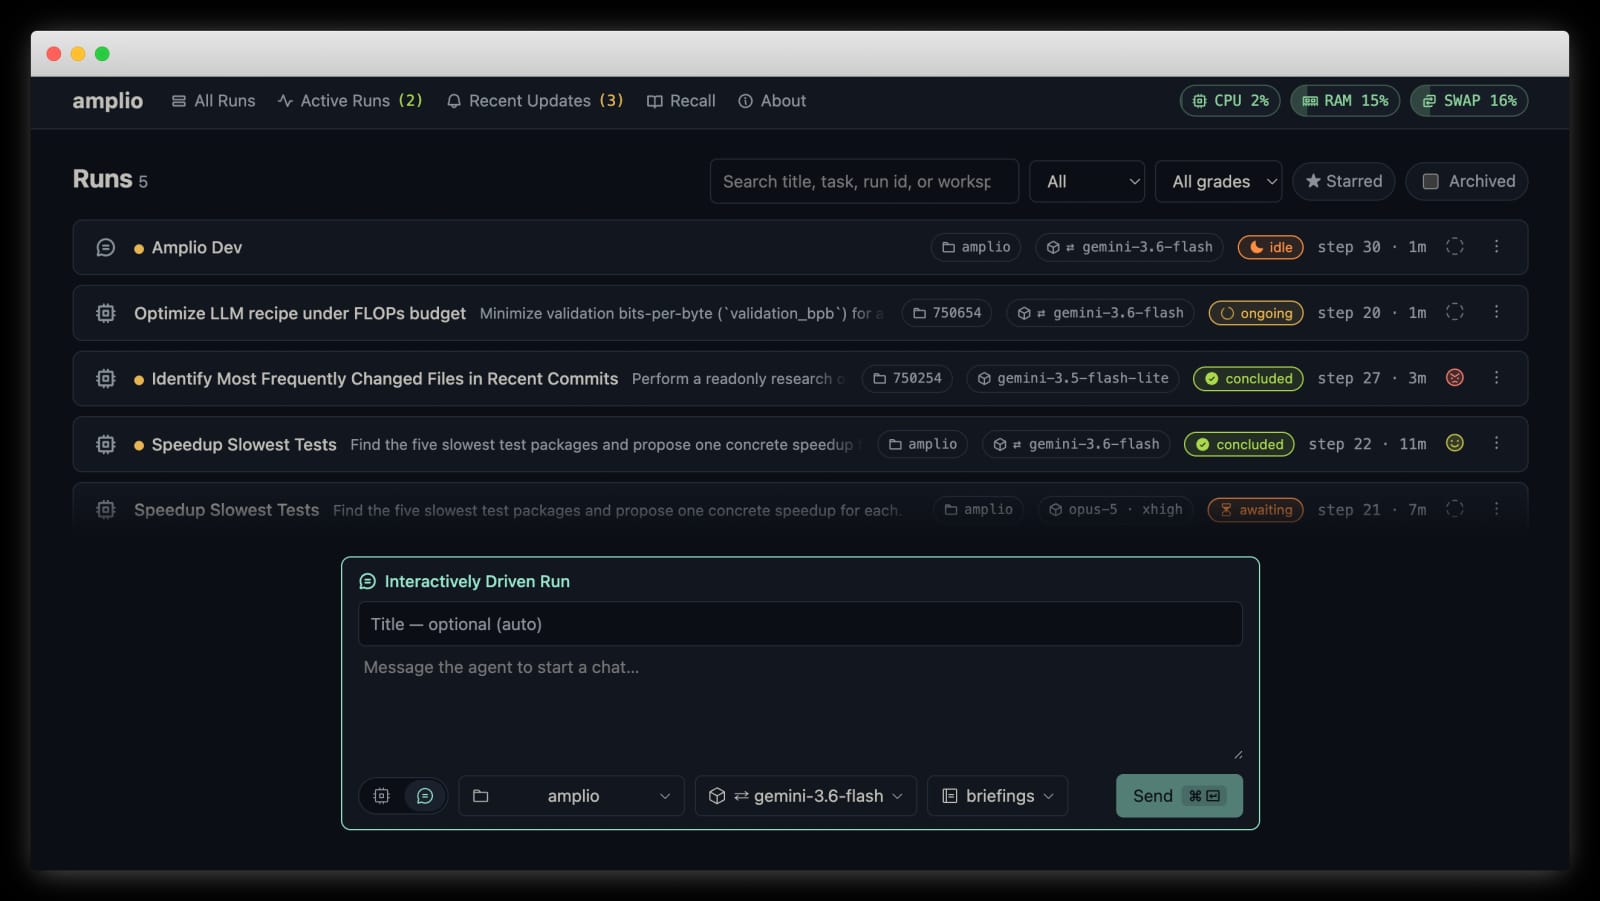
Amplio
Google DeepMindが公開した、長時間動き続けるAIエージェントを「落ちても必ず続きから再開できる」形で動かすための軽量な実行基盤(ハーネス)。
Google DeepMind / GitHub
#AI/Agents
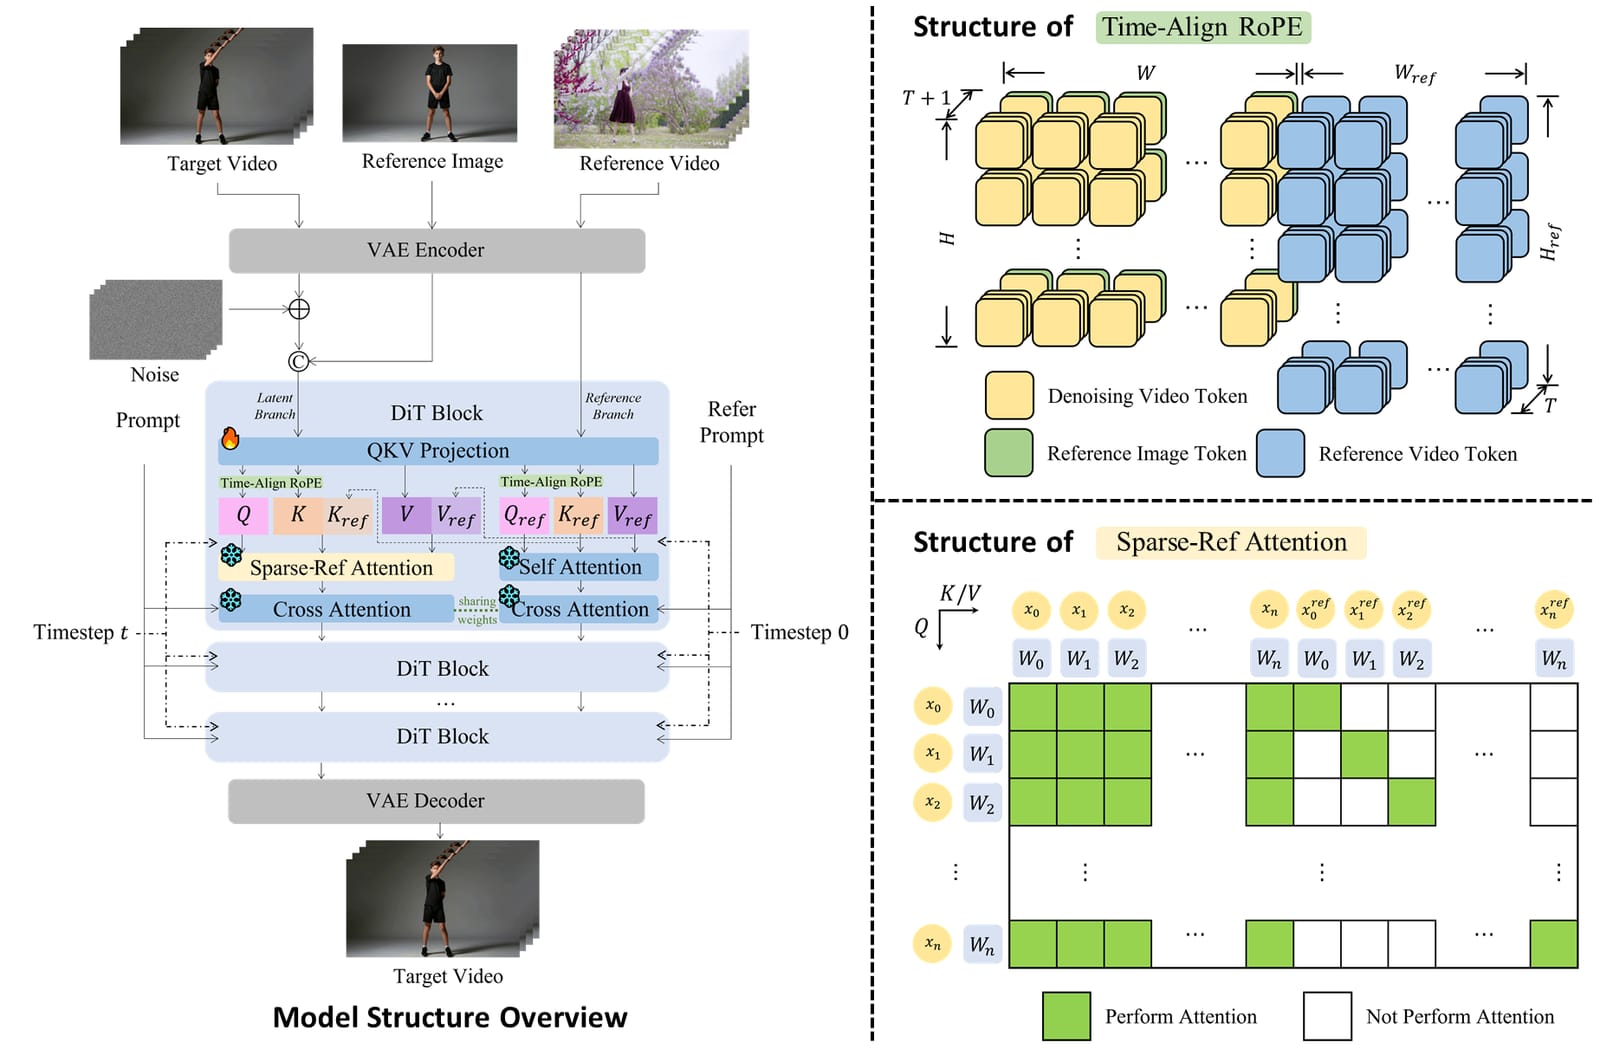
Wan-Animate-2
1本の動画から人物の動き・表情・カメラ視点までまるごと転写できる、Alibaba発の高精度キャラクターアニメーション生成AI。推論コードと学習済みモデルが無料公開された。
Alibaba Group Tongyi Lab(通義研究所) / GitHub
#Motion/Body#GenVideo#CreatorTools
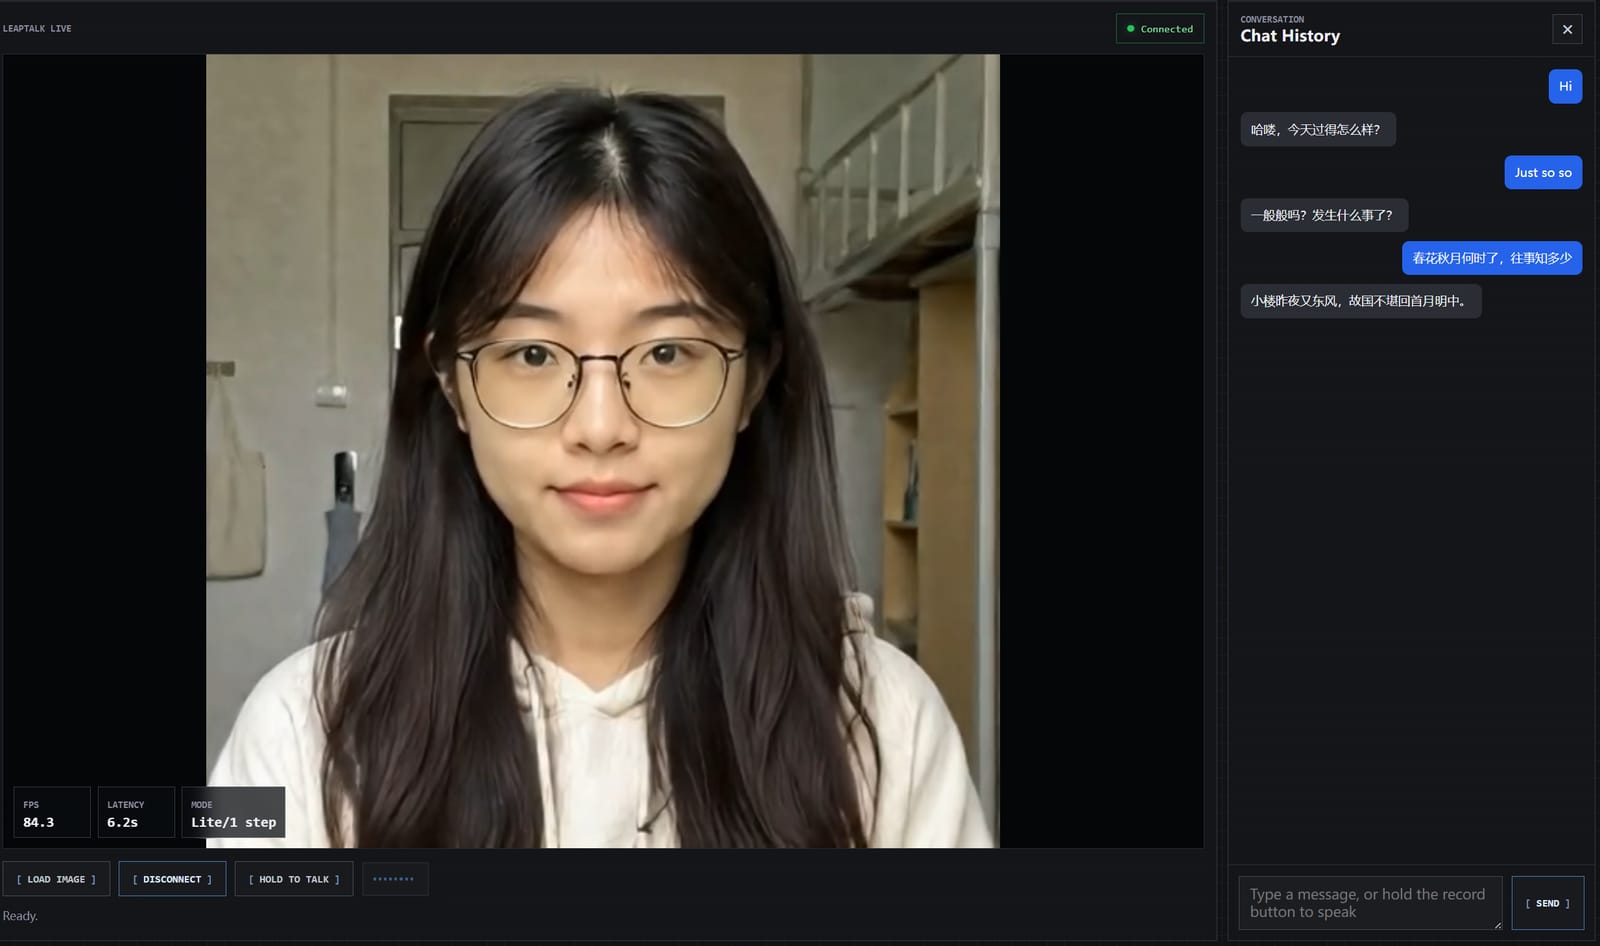
LeapTalk
話す顔を1回の計算ステップ・最大200FPSで生成できる高速な「トーキングヘッド」技術。写真1枚と音声だけで、途切れないリアルタイムのしゃべるアバター映像を作れる。
Rongxiang Zhang, Songhua Liu(個人研究者。基盤モデルはSoul AI Lab発のSoulX-FlashHead) / GitHub
#GenVideo#Motion/Body#CreatorTools
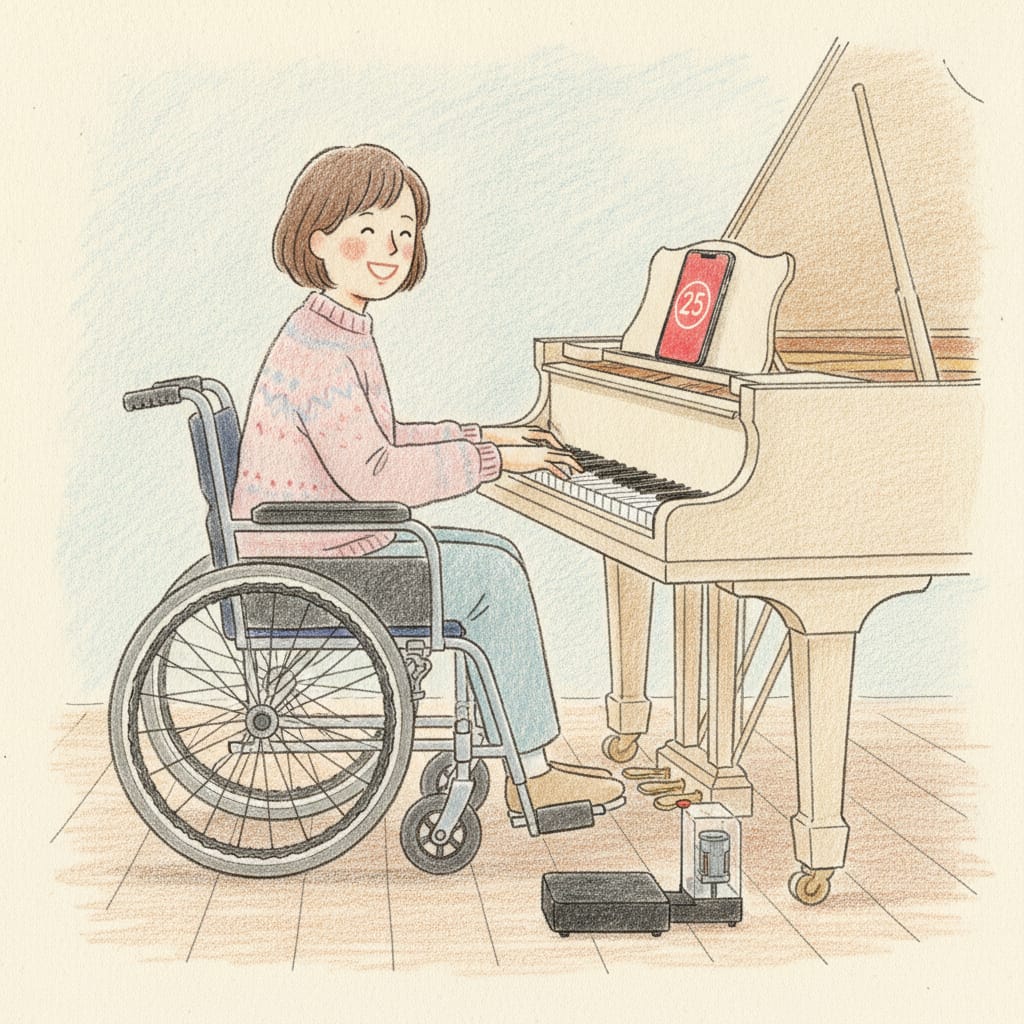
bFaaaP (barrier-Free assist as a Pedal)
頭の傾きだけでピアノのサスティンペダルを操作できる、日本発のオープンソース支援楽器システム。iPhoneの顔認識で頭の角度を読み取り、Bluetoothでペダル装置を動かす。
bFaaaP Project(Tomoyuki Shishido / Shishido & Associates ほか, 日本) / GitHub
#HCI/MediaArt#Audio/Music
MAGI-2-preview
音声と映像を同じモデルで同時に生成する、Sand.aiのオープンソース大規模動画生成モデルのプレビュー版。
Sand.ai (SandAI-org) / GitHub
#GenVideo#Audio/Music
ComfyUI-Spectrum-MiniMax-H3
MiniMax H3の動画生成を、画質をほぼ落とさず約3割速くするComfyUI用の追加ノード。
xmarre(個人開発者) / GitHub
#GenVideo#CreatorTools
MiniMax-H3-Turbo-Lora
MiniMax H3の動画+音声生成を、通常20ステップ必要なところをわずか4ステップまで短縮する高速化用LoRA。
larryvrh(個人開発者・コミュニティ) / GitHub
#GenVideo#CreatorTools
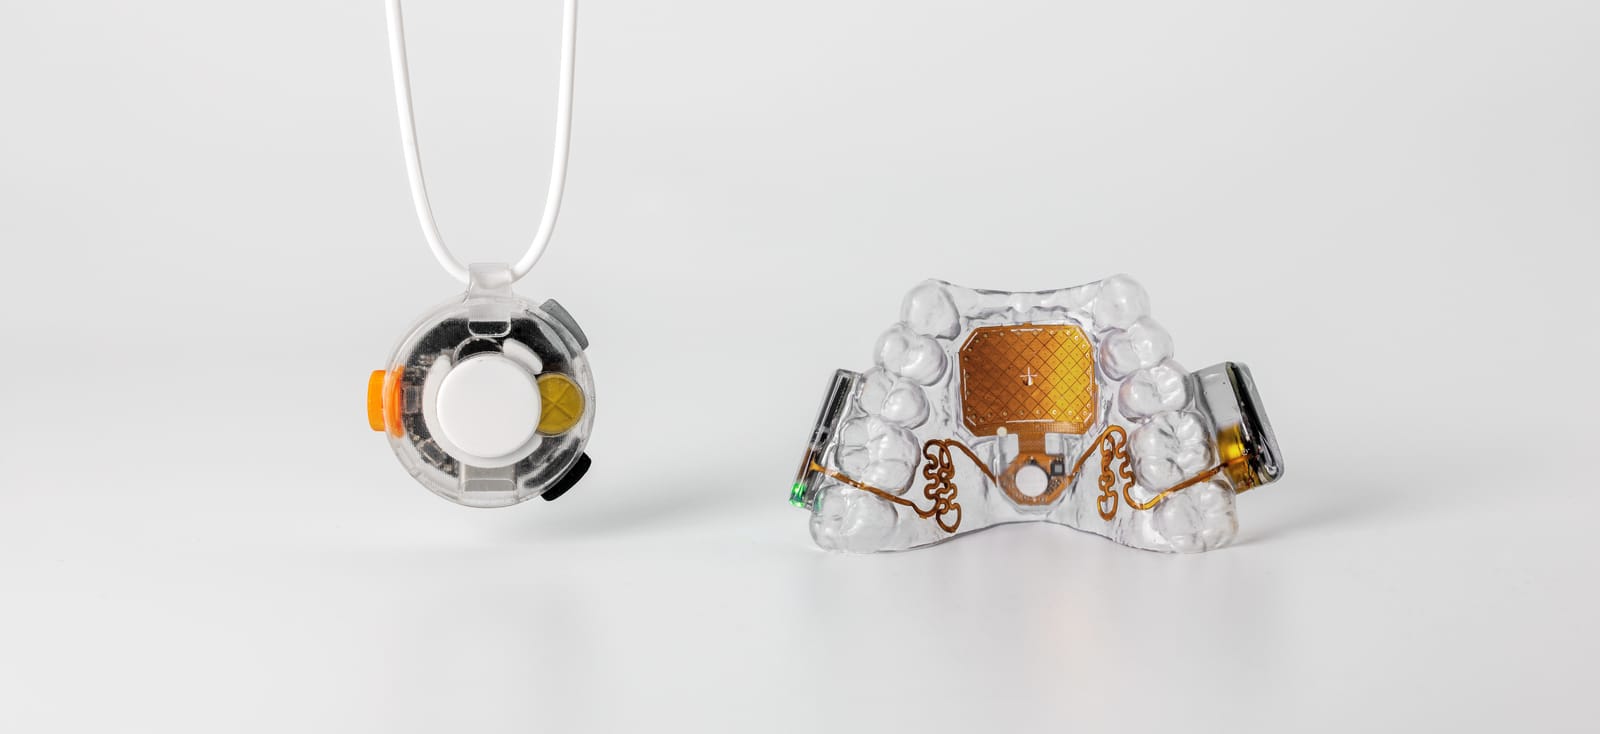
MouthPad (第2世代) / VOX
Augmentalが開発した舌で操作するマウスピース型デバイス「MouthPad」の第2世代と、皮膚装着型の音声入力デバイス「VOX」。2026年7月22日に米国で一般販売を開始した。
Augmental
#HCI/MediaArt#Motion/Body
Runnit
Runnitは、社内マーケティングチームやクリエイティブエージェンシー向けに開発されたAIネイティブの運用プラットフォーム。ブリーフやブランド資産、過去のプロジェクト履歴、チームのスキル情報などの組織内知識を活用し、プロジェクト計画の自動生成やリソース配分の最適化を行う。
Runnit (Null Theory, Australia / 創業者 Mark Tolson)
#CreatorTools#AI/Agents
Wan-Dancer-14B
1枚の人物写真と音楽ファイルから、曲の構成に合わせて1分を超えるダンス動画を720p/30fpsで生成するオープンソースモデル。
Alibaba Tongyi Lab / GitHub
#GenVideo#Motion/Body#Audio/Music
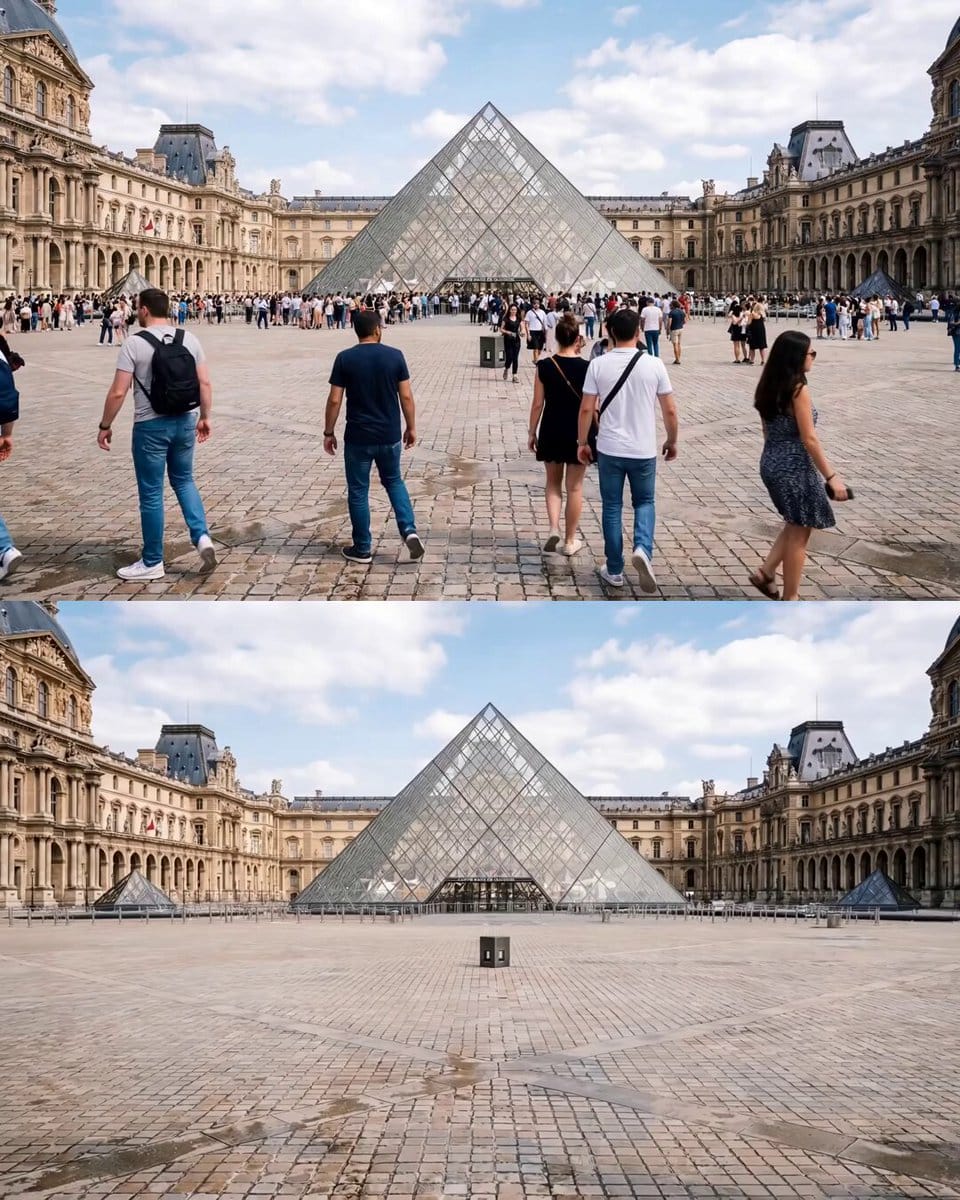
LTX-2.3 Clean Plate IC-LoRA
動画から人物や車などの動く被写体を消し、影や反射ごと背景を自動再構築して「クリーンプレート」を作るLTX-2.3用の公式LoRA。ブラウザデモあり。
Lightricks
#GenVideo#CreatorTools
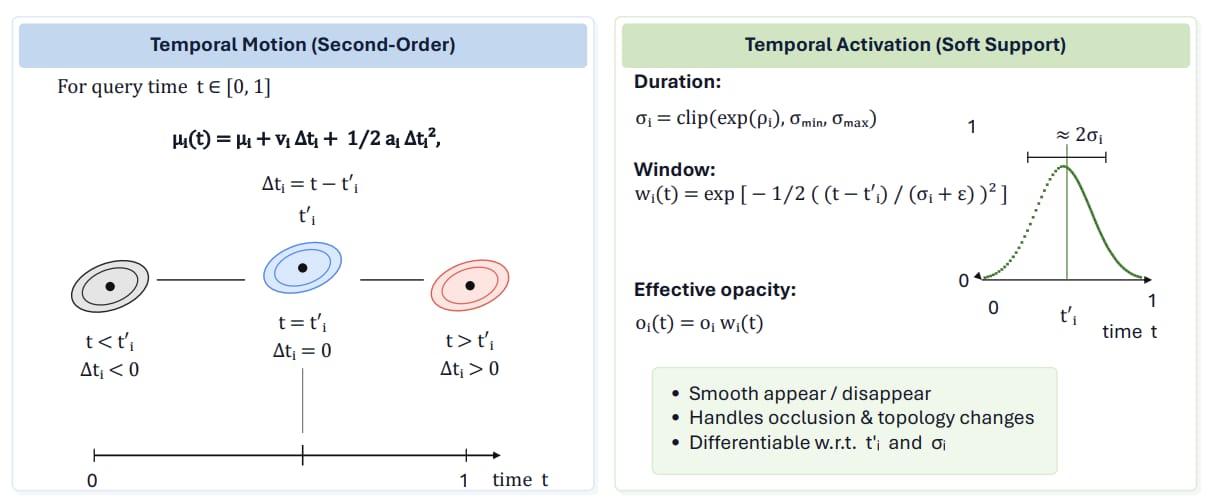
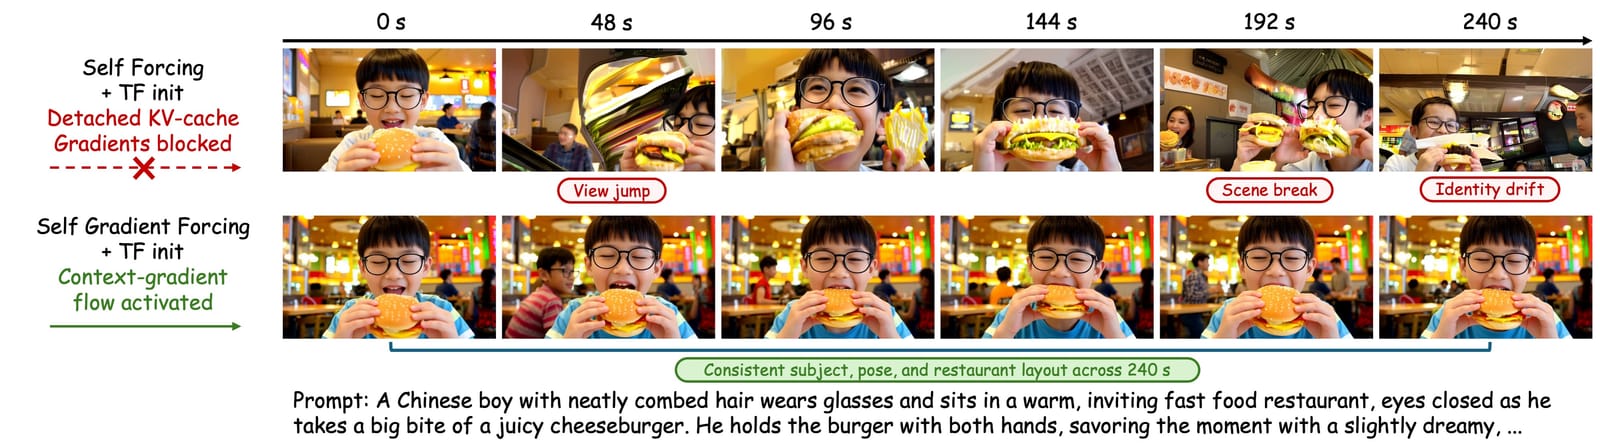
Self Gradient Forcing (SGF)
5秒クリップでしか学習していない動画生成モデルを、2パス方式の追加学習で最長約4分まで一貫性を保って生成できるようにする学習手法。コード・重み・学習スクリプトまで全公開。
清華大学 / JD Joy Future Academy / GitHub
#GenVideo
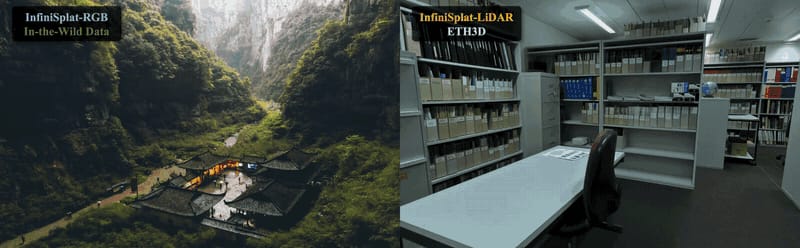
InfiniSplat
1枚の写真から、視点を大きく動かしても破綻しない3Dガウシアンスプラット(立体シーン)を生成する研究。ZJU3DVら開発、SIGGRAPH Asia 2026採択。
Zhejiang University (ZJU3DV) / UDeer.ai / Shenzhen University / GitHub
#Spatial/3D#CreatorTools
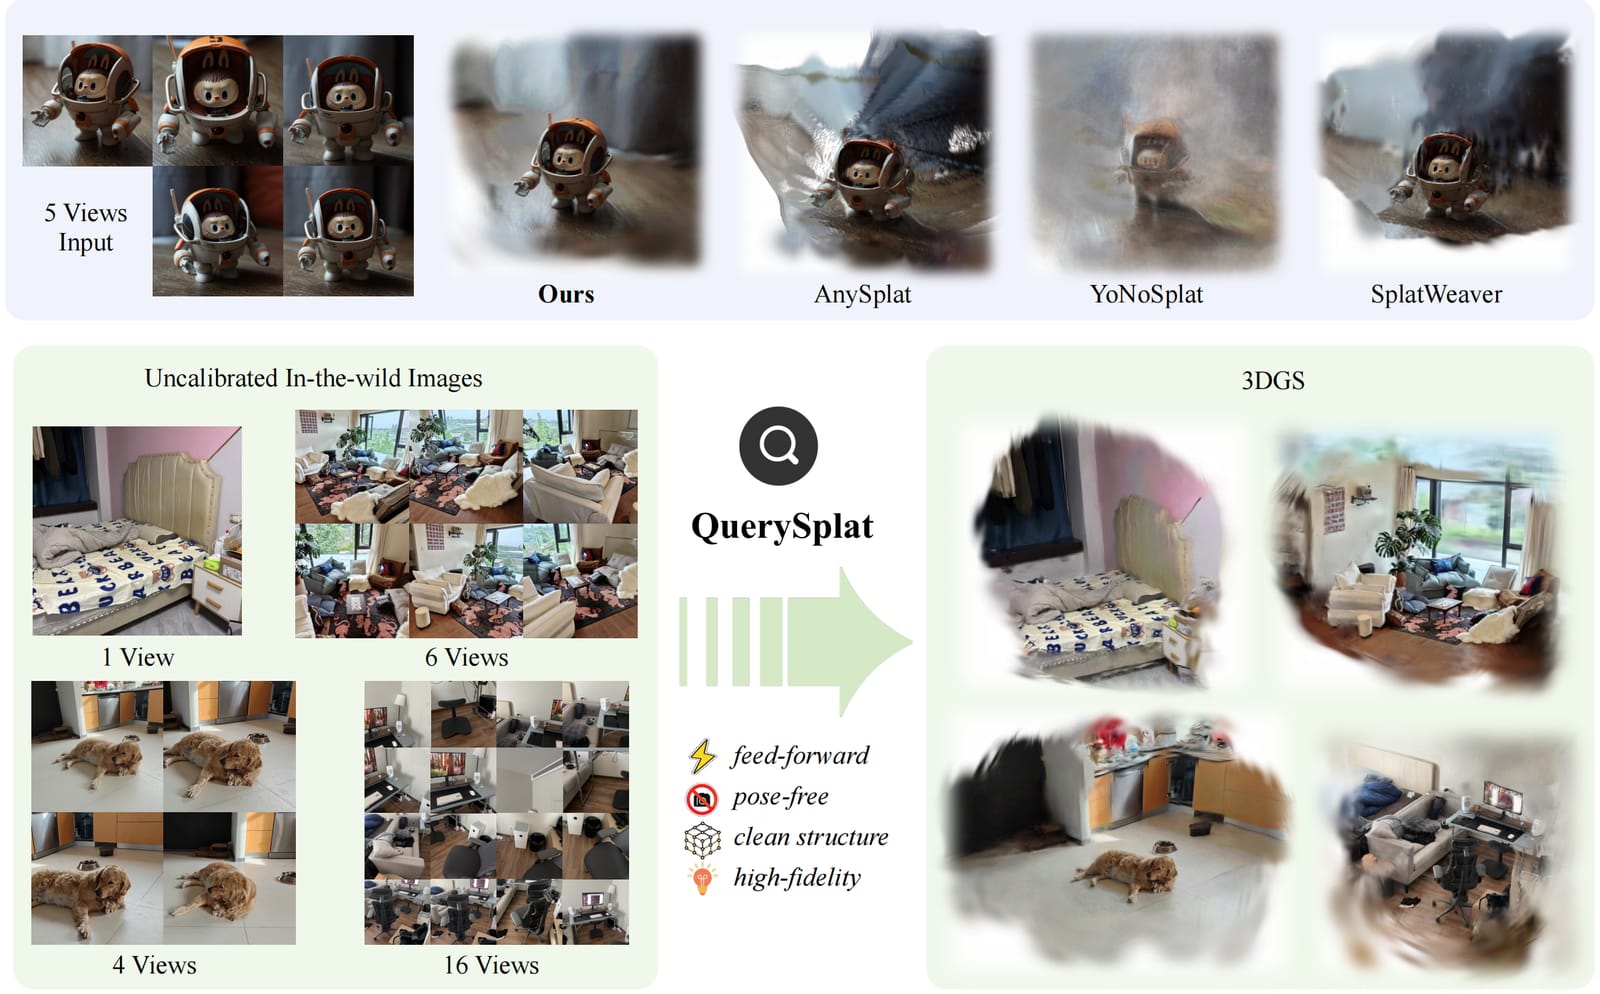
QuerySplat
複数枚の写真から、輪郭のにじみが少ない高精細な3Dガウシアンスプラットを生成する研究。InSpatio Research開発、2026年8月公開。
InSpatio Research(北京航空航天大学・浙江大学等) / GitHub
#Spatial/3D
Lyra 2.0
1枚の画像や短い動画から、歩き回って探索できる3D空間をまるごと自動生成するNVIDIAの技術。指定したカメラの動きに沿って映像を生成し、それを3Dガウシアンやメッシュとして書き出す。
NVIDIA (Spatial Intelligence Lab / Toronto AI Lab) / GitHub
#Spatial/3D#GenVideo#CreatorTools
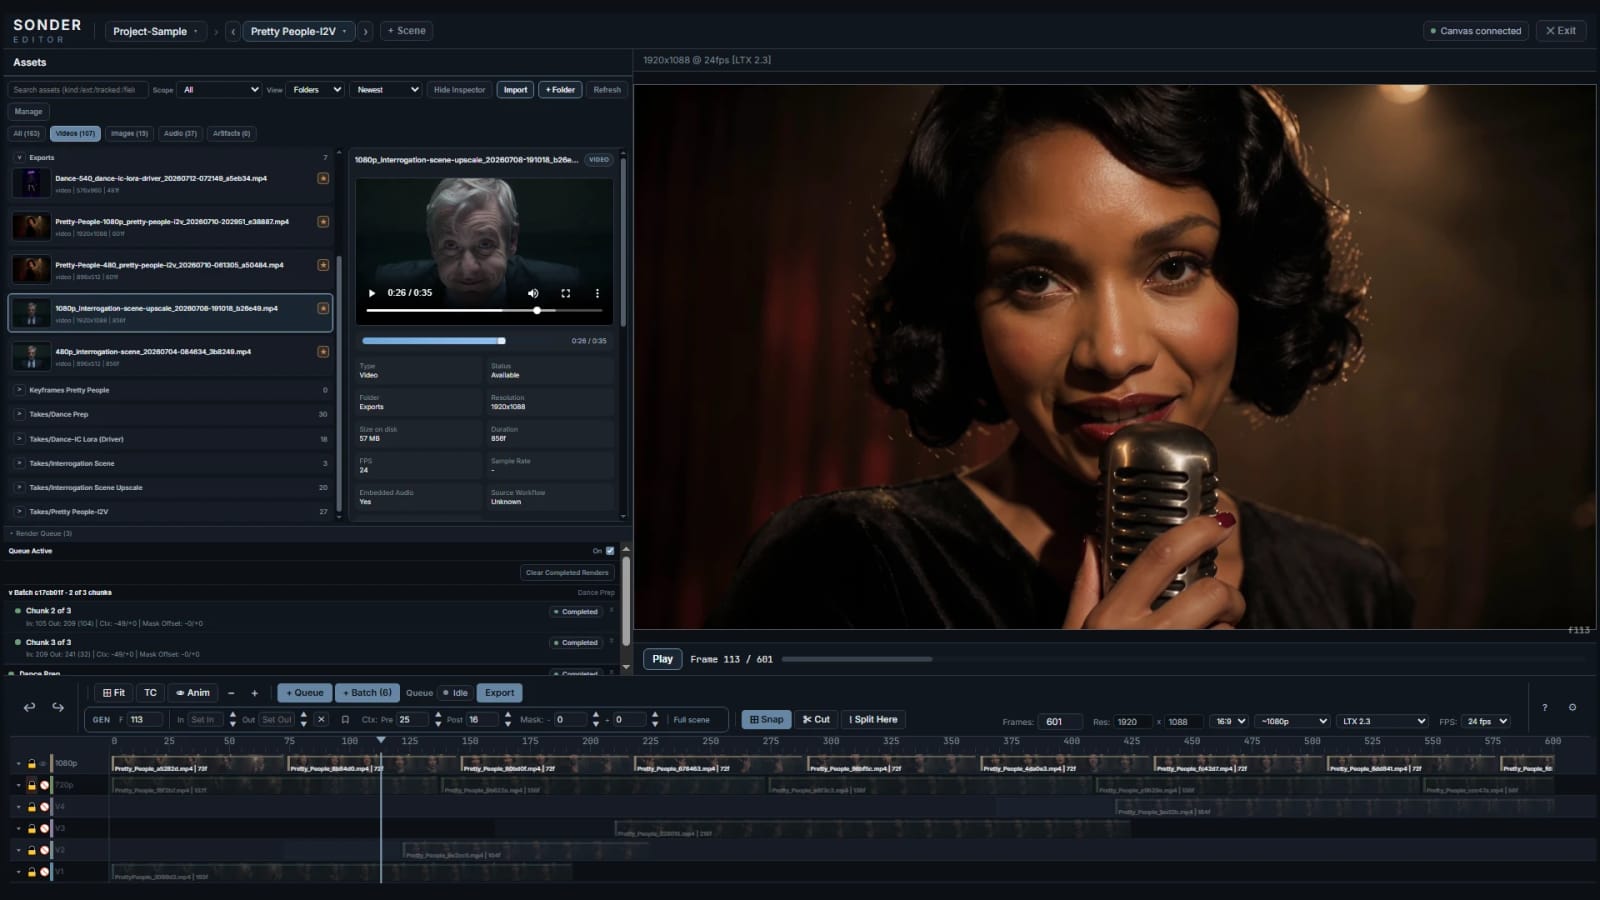
ComfyUI-Sonder-Editor
ComfyUIの中に「動画編集ソフトのタイムライン」を丸ごと組み込んだ拡張機能。生成AIでの長尺・連続動画づくりを、ノードをいじらずに編集画面から行えるようにする。
SonderSaid(個人開発) / GitHub
#GenVideo#CreatorTools
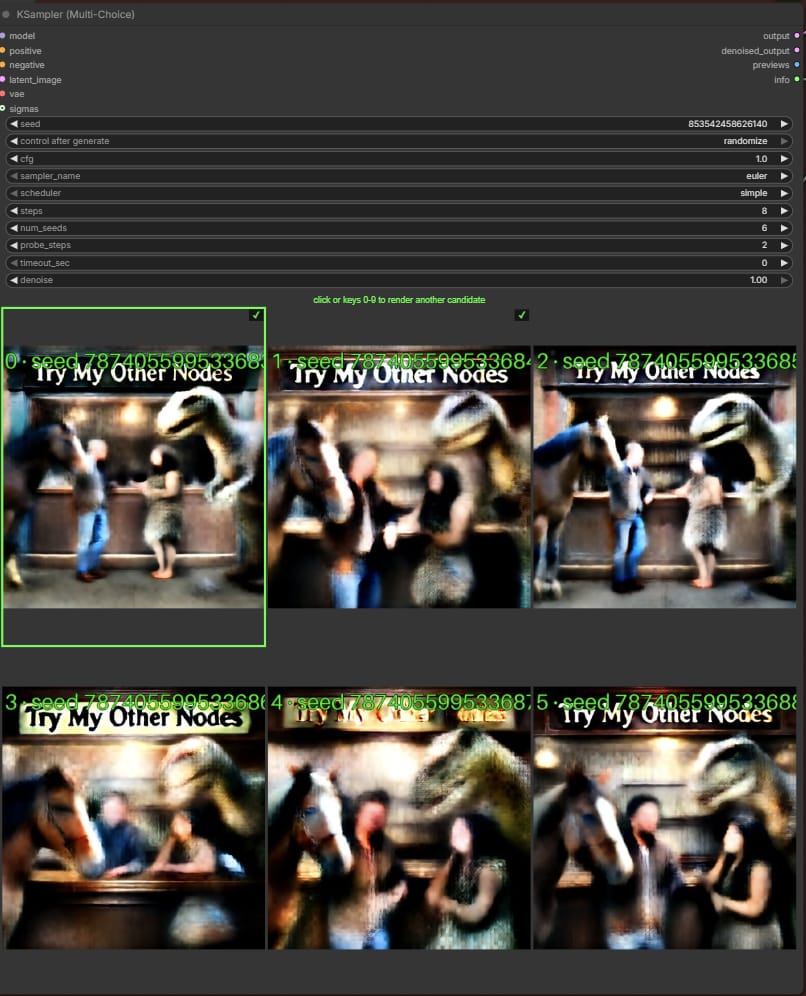
ComfyUI-KMS(Multi-Choice KSampler)
画像・動画生成の「どのシード(乱数の種)が良い構図になるか」を、フル生成せずに安いプレビューだけで確認し、選んだ1つだけを最後まで仕上げるComfyUIの拡張ノード。
Peter Neill(ShootTheSound.com) / GitHub
#CreatorTools#GenVideo
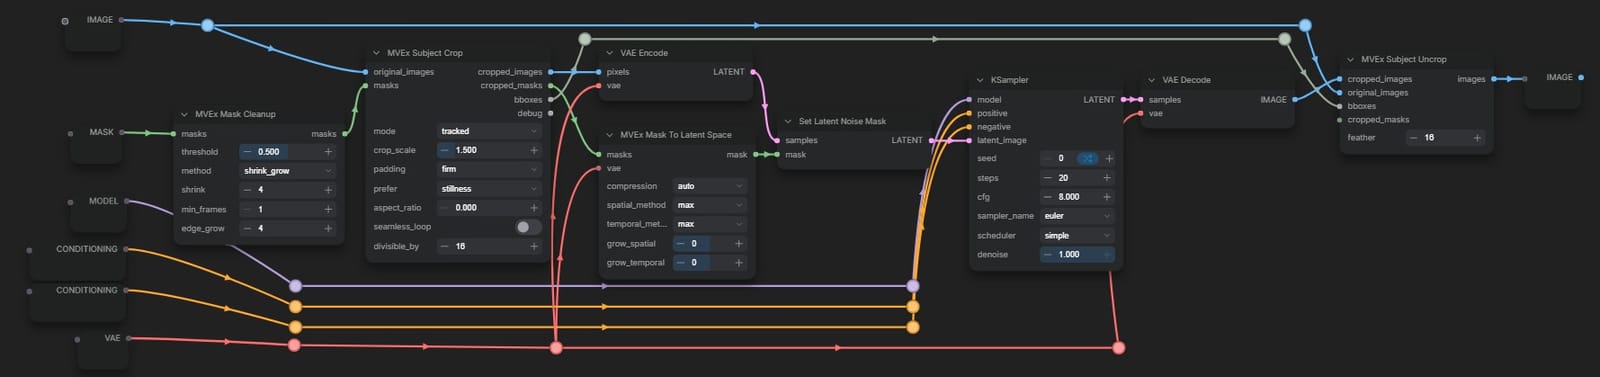
MaskVidExperiments
動く被写体だけをマスクで切り出して高解像度で加工し、元の映像にジッター(ガクガクした揺れ)や継ぎ目なしで貼り戻すComfyUI向け動画マスク処理ツール。
drozbay(個人開発) / GitHub
#GenVideo#CreatorTools
4DGS
動く3Dガウシアンスプラット(4D Gaussian Splatting)映像と空間オーディオを1本のファイルにまとめ、途中再生(シーク)もできる新しいオープンなファイル形式。動画で言うMP4のような存在を、揺れ動く3D点群の世界に持ち込む試み。
Avala AI / GitHub
#Spatial/3D#CreatorTools
BlendCap
1本のビデオを撮るだけで、Blenderの中で体・手・顔を同時にモーションキャプチャできるアドオン「BlendCap」。マーカーもスーツもモーションキャプチャスタジオも不要です。
Arcomade
#CreatorTools#Motion/Body
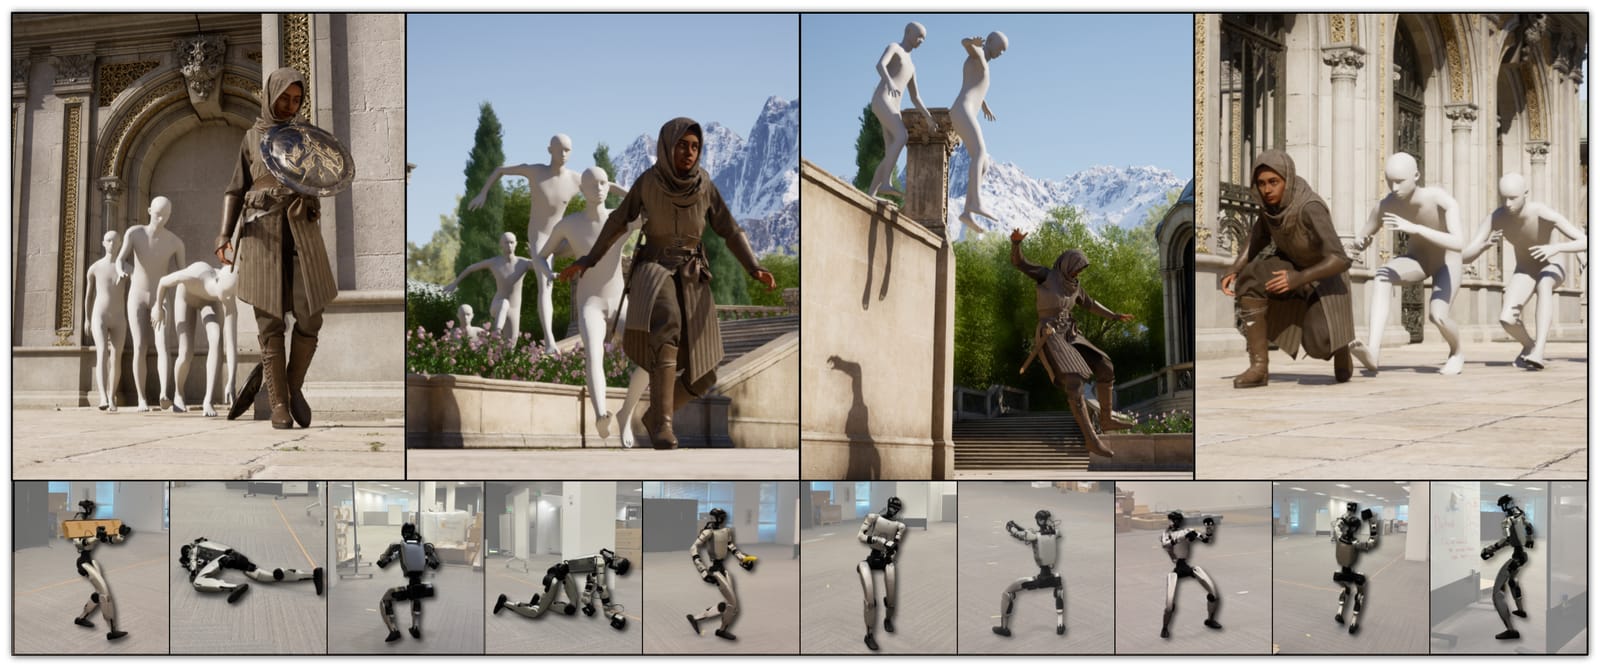
MotionBricks
1つのAIモデルだけで、ゲーム内キャラクターと実在の二足歩行ロボット(Unitree G1)の両方をリアルタイムに動かせるNVIDIAの新しいモーション生成システム。SIGGRAPH 2026で発表。
NVIDIA Research(GR00T Whole-Body Control) / GitHub
#Motion/Body#Spatial/3D
JarvisHub
チャットへの逐次的な指示ではなく、編集可能な「キャンバス」を作業台としてAIエージェントに与え、画像・動画・コード・スライドなど複数の成果物をまたぐ長時間の創作作業を任せられるオープンソースの創作エージェント基盤。
香港中文大学(CUHK) MMLab・Tencent Hunyuan 共同研究チーム / GitHub
#AI/Agents#CreatorTools
Dissectible Anatomy
実在する人体の輪切りデータから作った3Dモデルを、GPU上でリアルタイムに自由に切ったり裂いたりできる仮想解剖シミュレーション。SIGGRAPH 2026 Real-Time Live!観客賞を受賞。
Purdue University (Tim McGraw, Jack Myers) / GitHub
#HCI/MediaArt#Spatial/3D
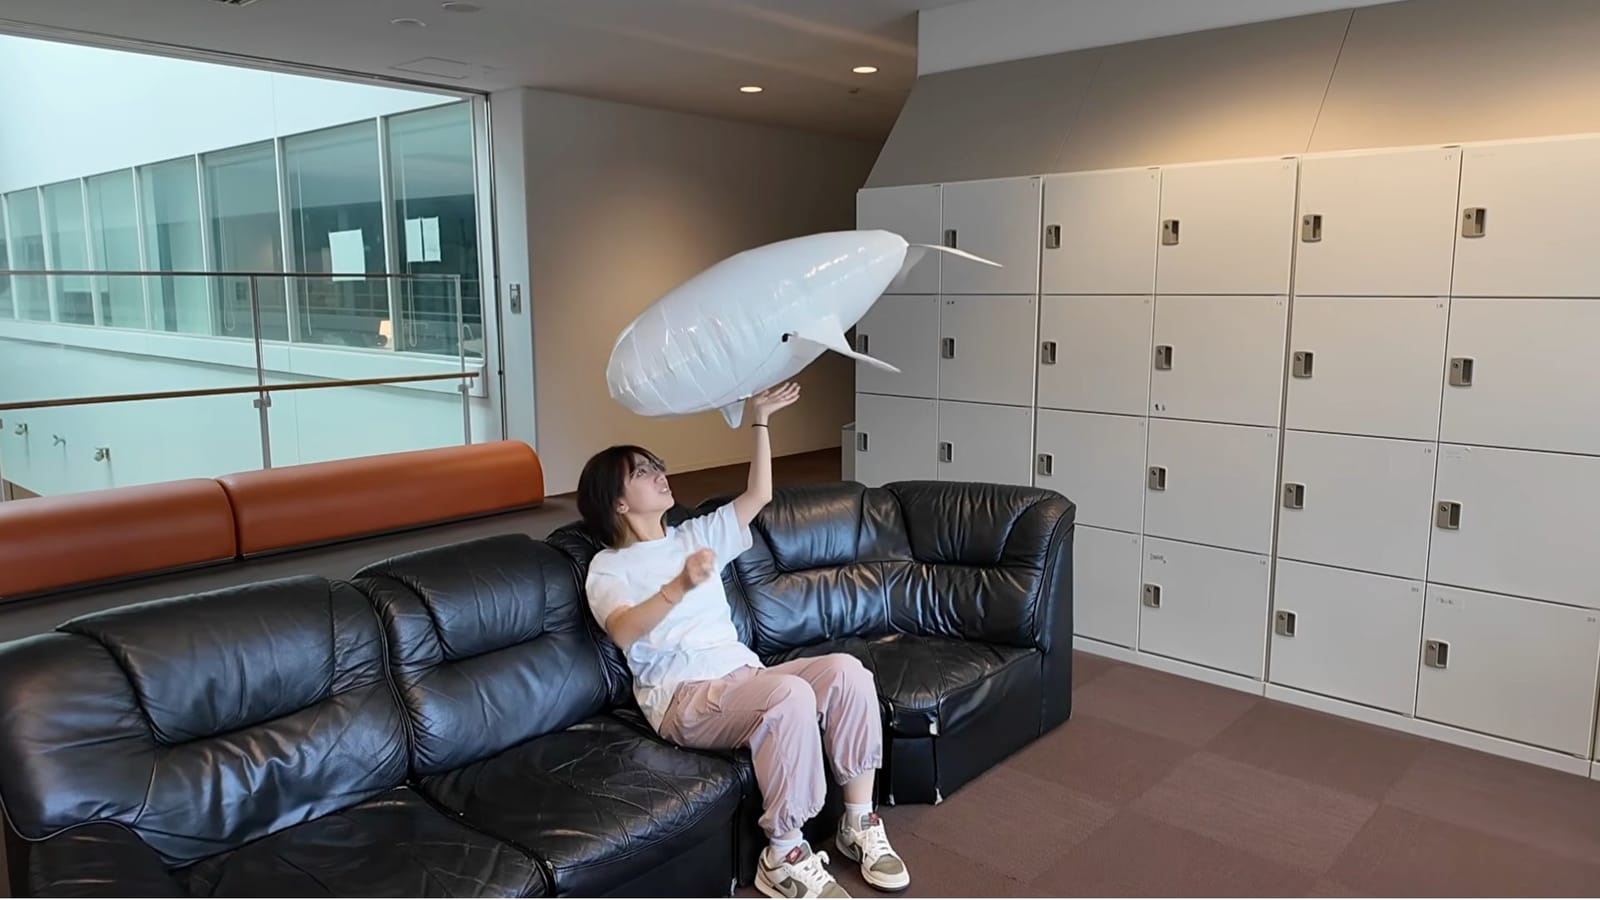
Cuddle-Fish(Floating Companion)
ヘリウムガスと柔らかい羽ばたきヒレで浮遊移動するソフトロボット。プロペラを使わず静音・軽量・接触しても安全な設計で、人について歩いたりリマインダーを伝えたり、勉強のお供になったりする。慶應義塾大学とMITメディアラボの研究チームがACM DIS 2026(2026年6月、シンガポール開催)で発表した。
慶應義塾大学(MITメディアラボと共同)
#HCI/MediaArt#Motion/Body
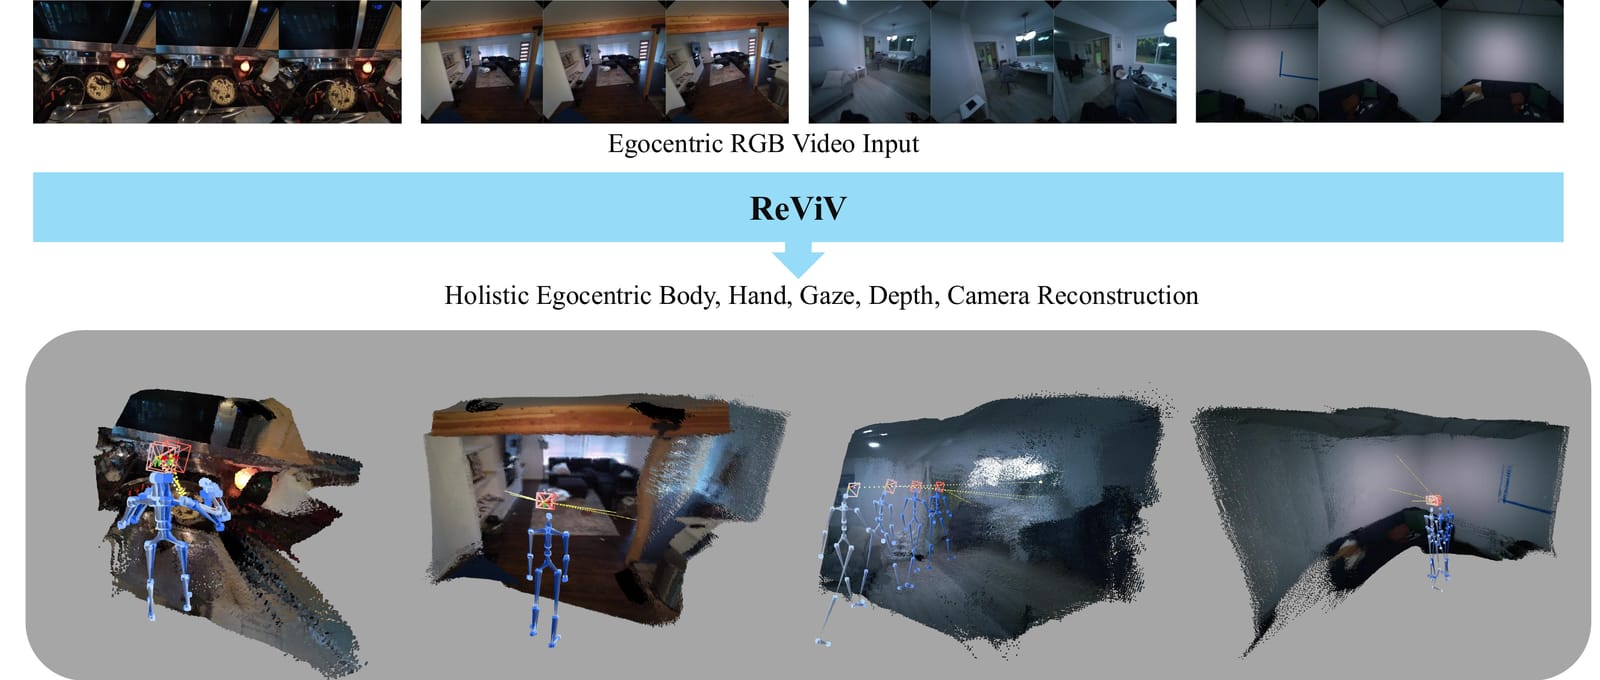
ReViV (Reconstructing the Viewer and the View in 4D from Monocular Egocentric Video)
単眼のエゴセントリック(一人称視点)RGB動画1本だけから、装着者の全身・手・視線の動きと、周囲シーンのカメラ軌跡・深度を同時に4D復元する統合フレームワーク。ECCV 2026採択。
ETH Zürich, Delft University of Technology, Microsoft / GitHub
#Spatial/3D#Motion/Body
Gaussian Point Splatting
1億個を超える大量のGaussian Splat(点群ベースの3D表現)を、並べ替え処理なしでリアルタイム描画できる新しいレンダリング手法。SIGGRAPH 2026で発表。
TU Delft (Joris Rijsdijk, Christoph Peters, Michael Weinmann, Ricardo Marroquim) / GitHub
#Spatial/3D#CreatorTools
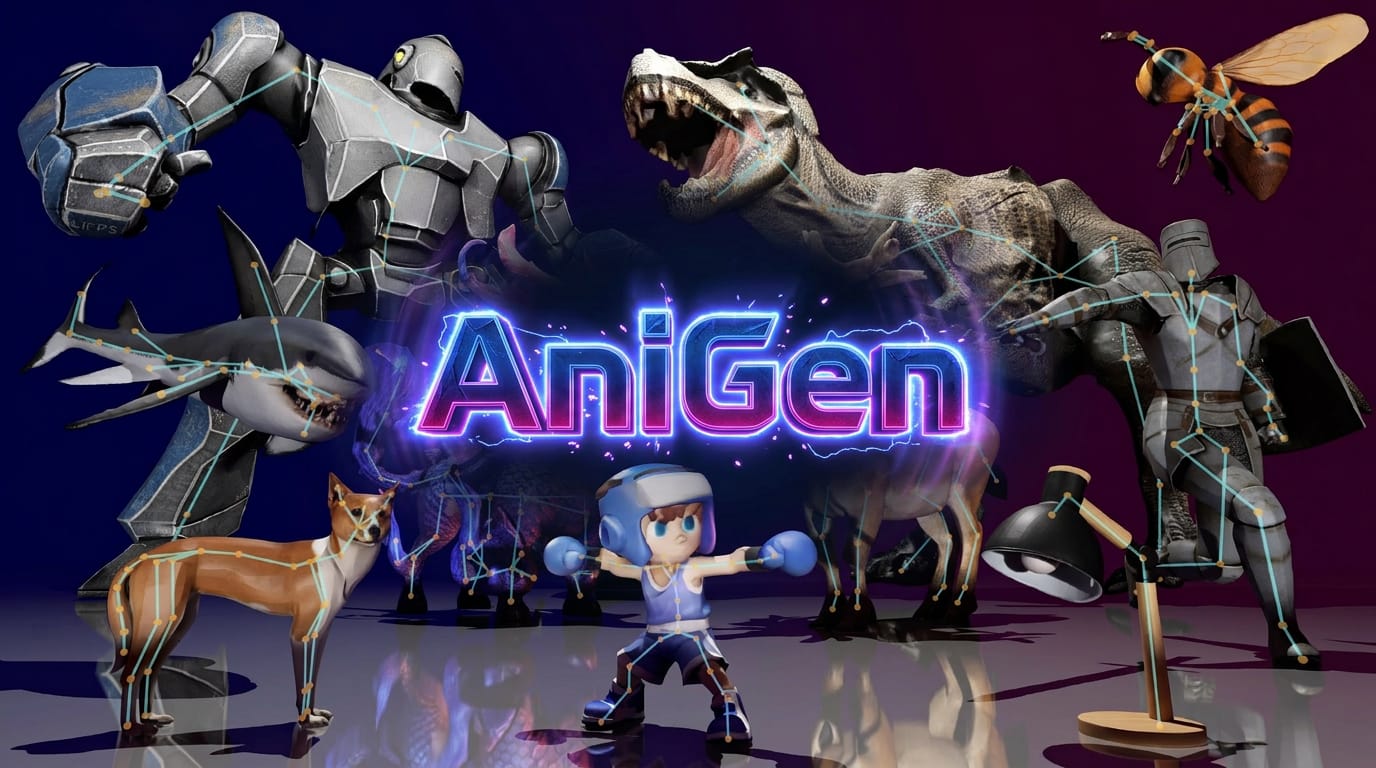
AniGen
1枚の画像から、動かせる骨格(ボーン)とスキン(皮膚の伸縮)まで含んだ「アニメーション可能な3Dキャラクター」を自動生成する技術。SIGGRAPH 2026発表、Real-Time Live!のベストインショー実演のベースにもなった。
VAST / The University of Hong Kong / 清華大学 ほか / GitHub
#Spatial/3D#Motion/Body#CreatorTools
ABot-World / ABot-3DWorld
1枚の画像やテキストから、実際に歩き回ったり操作したりできる「探索可能な3D世界」をその場で生成し続けるAI。デスクトップGPU1枚でリアルタイム動作し、屋内・街路・都市上空まで幅広いシーンに対応する。
Alibaba Amap (アリババ傘下・高徳地図) / amap-cvlab / GitHub
#Spatial/3D#GenVideo#CreatorTools
bioLogic
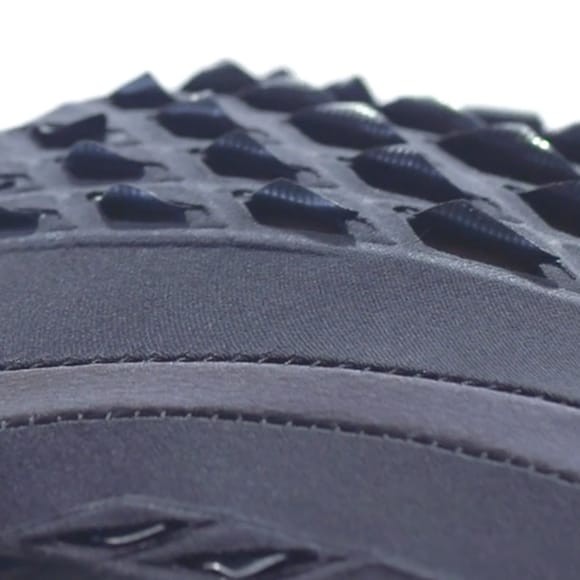
納豆菌(Bacillus subtilis natto)の湿度に応じた伸縮運動を利用し、生きた微生物をナノアクチュエーターとして生地に印刷、汗や体温に反応して開閉する「セカンドスキン」型スポーツウェアを作った研究プロジェクト。
MIT Media Lab Tangible Media Group(Royal College of Art、New Balance、MIT化学工学科と共同)
#Motion/Body#HCI/MediaArt
Fungal Computer(菌糸体メムリスタ/きのこコンピューティング)
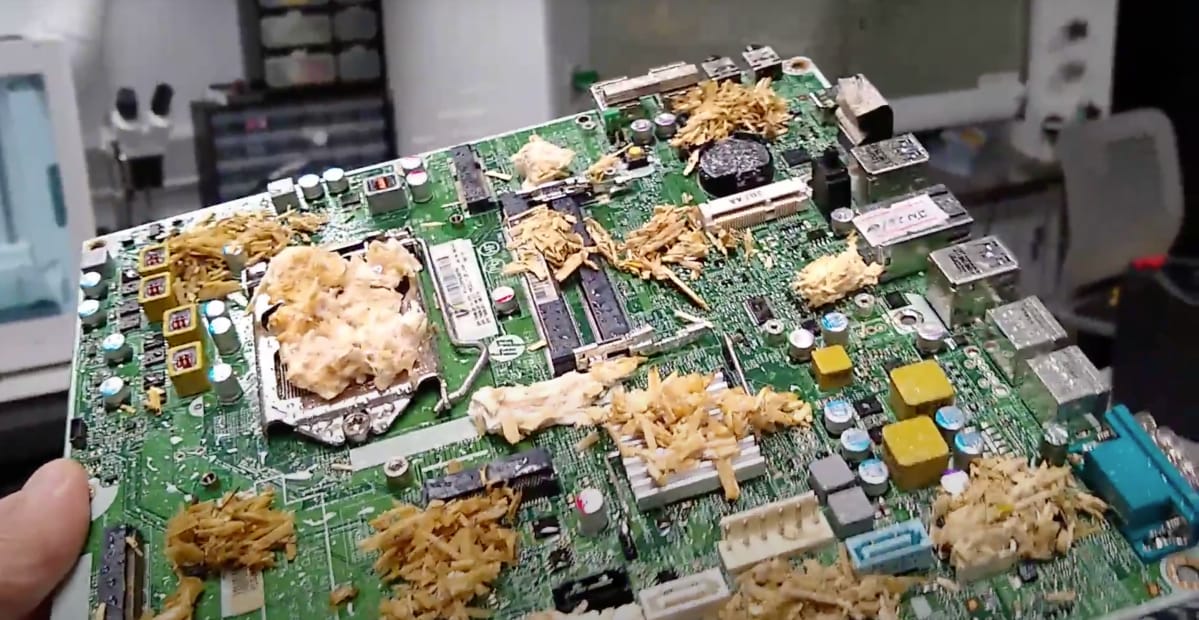
菌糸体(キノコの根状組織)に電極を刺して神経細胞のようなスパイク電位を記録・刺激し、論理ゲートやメモリ(メムリスタ)として使う「菌類コンピュータ」の研究。2018年の論文『Towards fungal computer』を起点に、UWE BristolのUnconventional Computing Labが継続研究している。
Unconventional Computing Laboratory, University of the West of England Bristol(Andrew Adamatzky教授)
#HCI/MediaArt
Physarum polycephalum(真正粘菌)による東京鉄道網再現実験
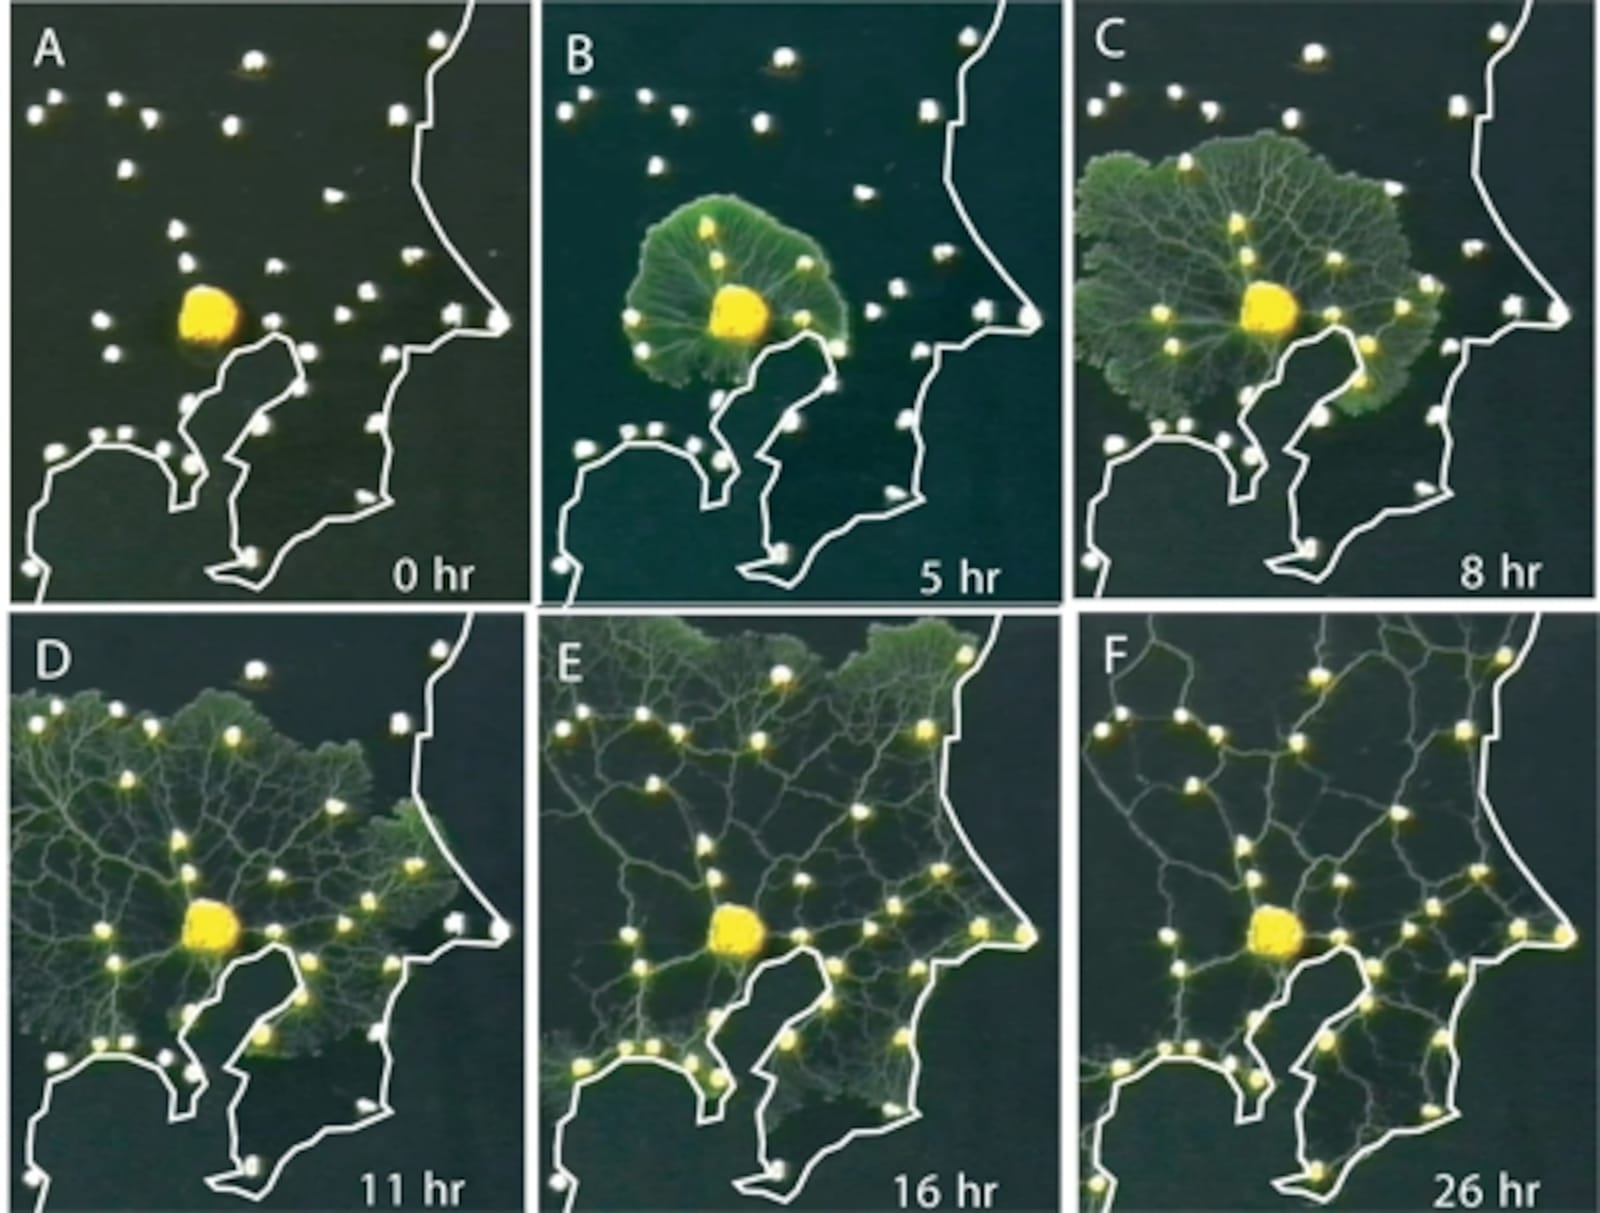
脳を持たない単細胞生物・真正粘菌(Physarum polycephalum)を、東京を中心に周辺36都市の位置に見立ててオートミールを配置した培地の上で育てたところ、実際の東京圏鉄道網とよく似た効率的なネットワークを自律的に形成した研究。2010年にScience誌に掲載された。
北海道大学(中垣俊之・手老篤史ら、英ウエストイングランド大学らと共同)
#HCI/MediaArt
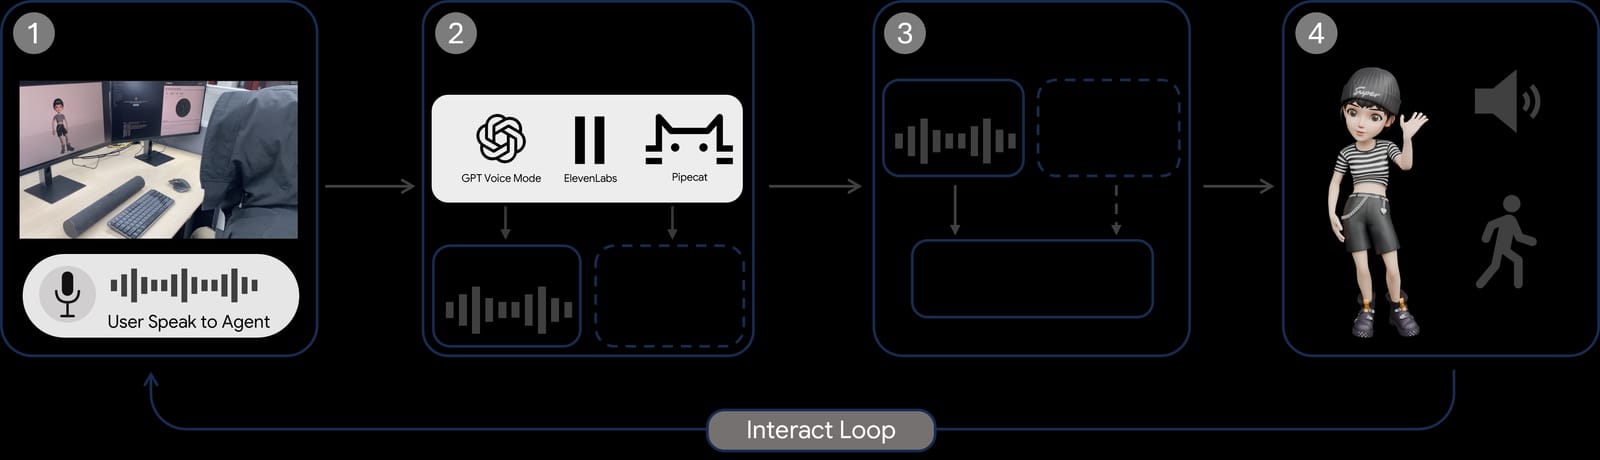
EchoAvatar
話し声や音楽をリアルタイムに聞き取りながら、全身が自然に動く3Dアバターをその場で生成する研究。会話にもダンスにも同じ仕組みで対応する。
Zhejiang University (State Key Lab of CAD&CG) / GitHub
#Motion/Body#AI/Agents#GenVideo
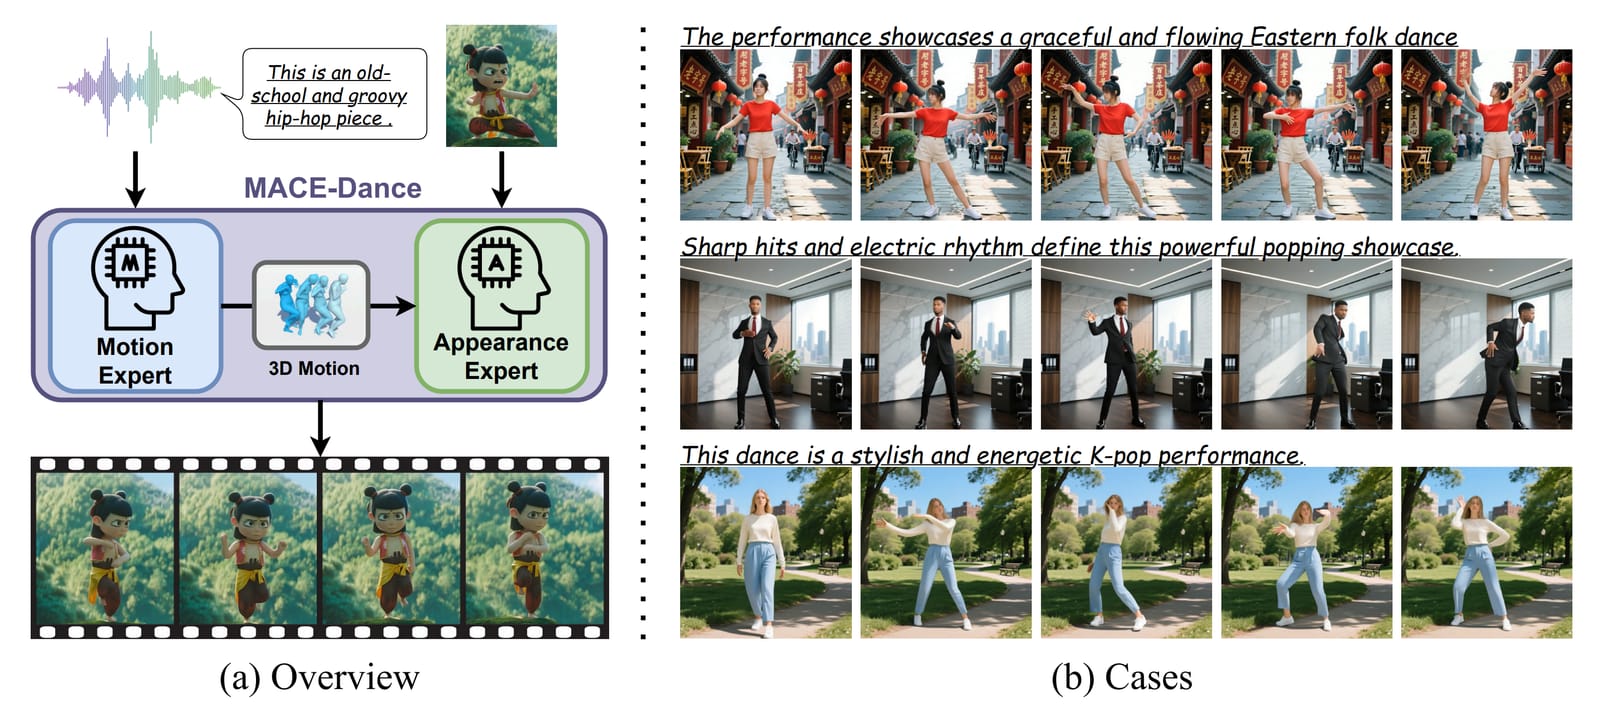
MACE-Dance
1枚の人物写真と1曲の音楽を渡すだけで、その人がリズムに合わせて踊る高品質なダンス動画を自動生成する技術。
AMap (Alibaba) / Renmin University of China / GitHub
#Motion/Body#GenVideo
ovrtx / ovphysx (NVIDIA Agent Toolkit — Omniverse Libraries)
NVIDIAが公開した、AIエージェントが3Dシーンをカメラ・センサー視点でシミュレーションしたり、Blenderなど既存の制作ツールの中で物理挙動を自動検証したりできるようにするSDK群。
NVIDIA / GitHub
#AI/Agents#CreatorTools#Spatial/3D
VRChat Gaussian Splatting v4
ソーシャルVRプラットフォームVRChatのワールド内で、Gaussian Splattingをリアルタイム描画できるOSSツール。v4で「LODピラミッド」を追加し、1億スプラット規模の大規模シーンでも動作するようになった。
Mykhailo Moroz(個人開発者) / GitHub
#Spatial/3D#CreatorTools#HCI/MediaArt
Masked Visual Actions for Unified World Modeling (MVA)
1つのモデルで「ロボットの動きを与えると未来の映像をシミュレート」「物体の動きを与えると必要なロボット動作を生成」の両方をこなす、動画の一部を隠して復元させるだけの学習方法で作られた統一世界モデル。
Stanford University / University of Maryland, College Park / Harvard University / GitHub
#Spatial/3D#AI/Agents#Motion/Body
ComfyUI Native Gaussian Splat Nodes(GAUSSIAN型 / v0.23.0)
画像・動画生成のノードエディタComfyUIに、3D Gaussian Splatを扱うネイティブなデータ型「GAUSSIAN」と、読み込み・変換・レンダリング・メッシュ化のノード群が外部依存なしで標準搭載された。
Comfy-Org / GitHub
#Spatial/3D#CreatorTools
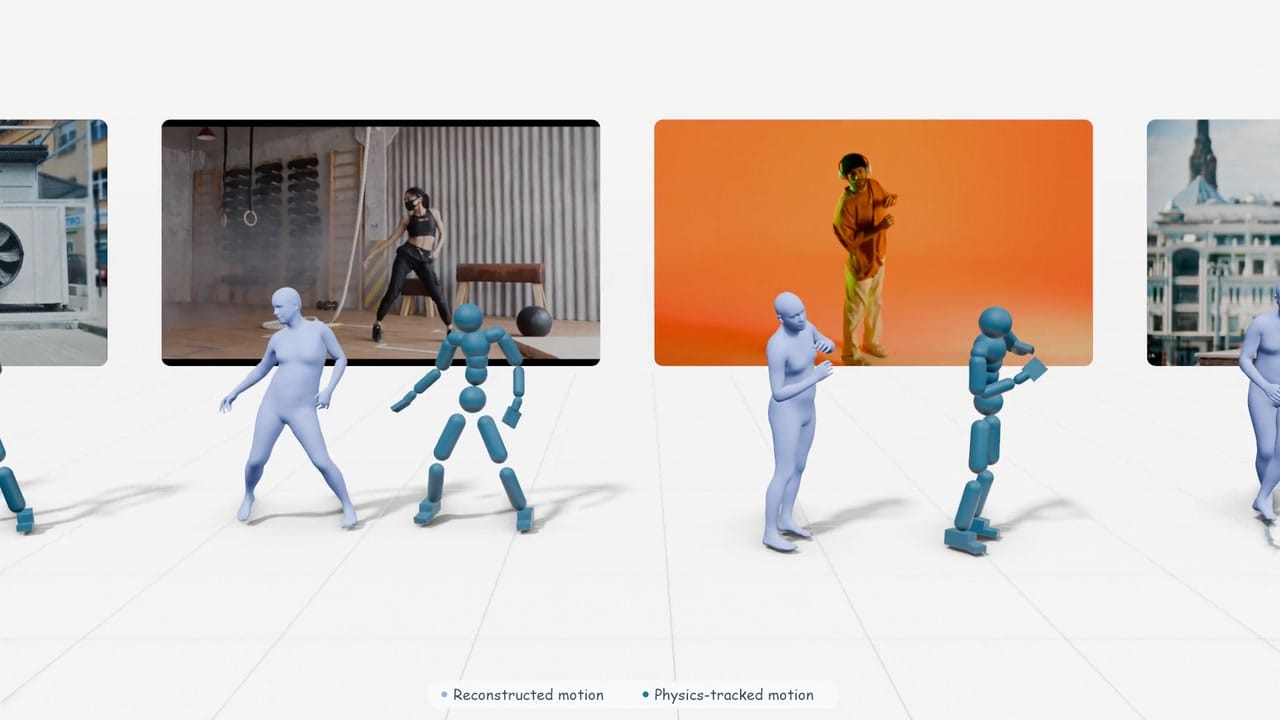
GPC (Generative Pretraining for Transferable Motor Control)
大量のモーションキャプチャーデータで一つのAIコントローラーを事前学習し、GPTが次の単語を予測するのと同じ要領で『次の瞬間の体の動き』を予測し続けることで、物理シミュレーション上のキャラクターやロボットを自然に動かすNVIDIAの研究フレームワーク。
NVIDIA / Simon Fraser University / GitHub
#Motion/Body#Spatial/3D
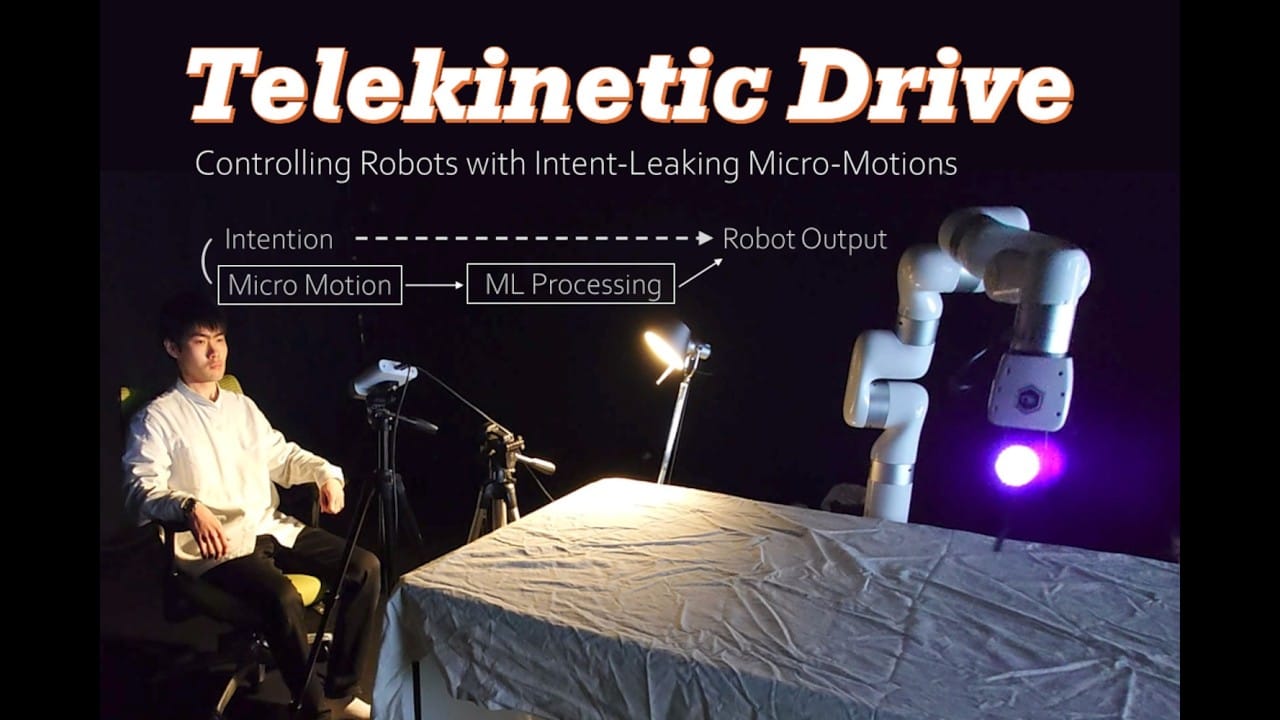
Telekinetic Drive
顔に現れるごくわずかな無意識の動きをカメラで読み取り、装着物なしでロボットを「念力」のように操作できるインターフェース。東京大学発、SIGGRAPH 2026・Augmented Humans 2026で発表。
東京大学 先端科学技術研究センター 稲見昌彦研究室(Information Somatics Lab)
#HCI/MediaArt#Motion/Body#AI/Agents
Marble x Nuke
テキストや画像から生成した3D世界を、そのまま映像業界定番の合成ソフト「Nuke」の3D空間に読み込める無料プラグイン。
Patrick Crucke(個人開発、World Labs非公式連携) / GitHub
#Spatial/3D#CreatorTools
Spatialography
実在する公園や滝をGaussian Splattingで記録し、VR空間の中を歩いて鑑賞できる“作品”に仕立てたVRChatワールド。ヴェネチア国際映画祭のVR部門に選出。
VoxelKei(個人クリエイター)
#Spatial/3D#HCI/MediaArt
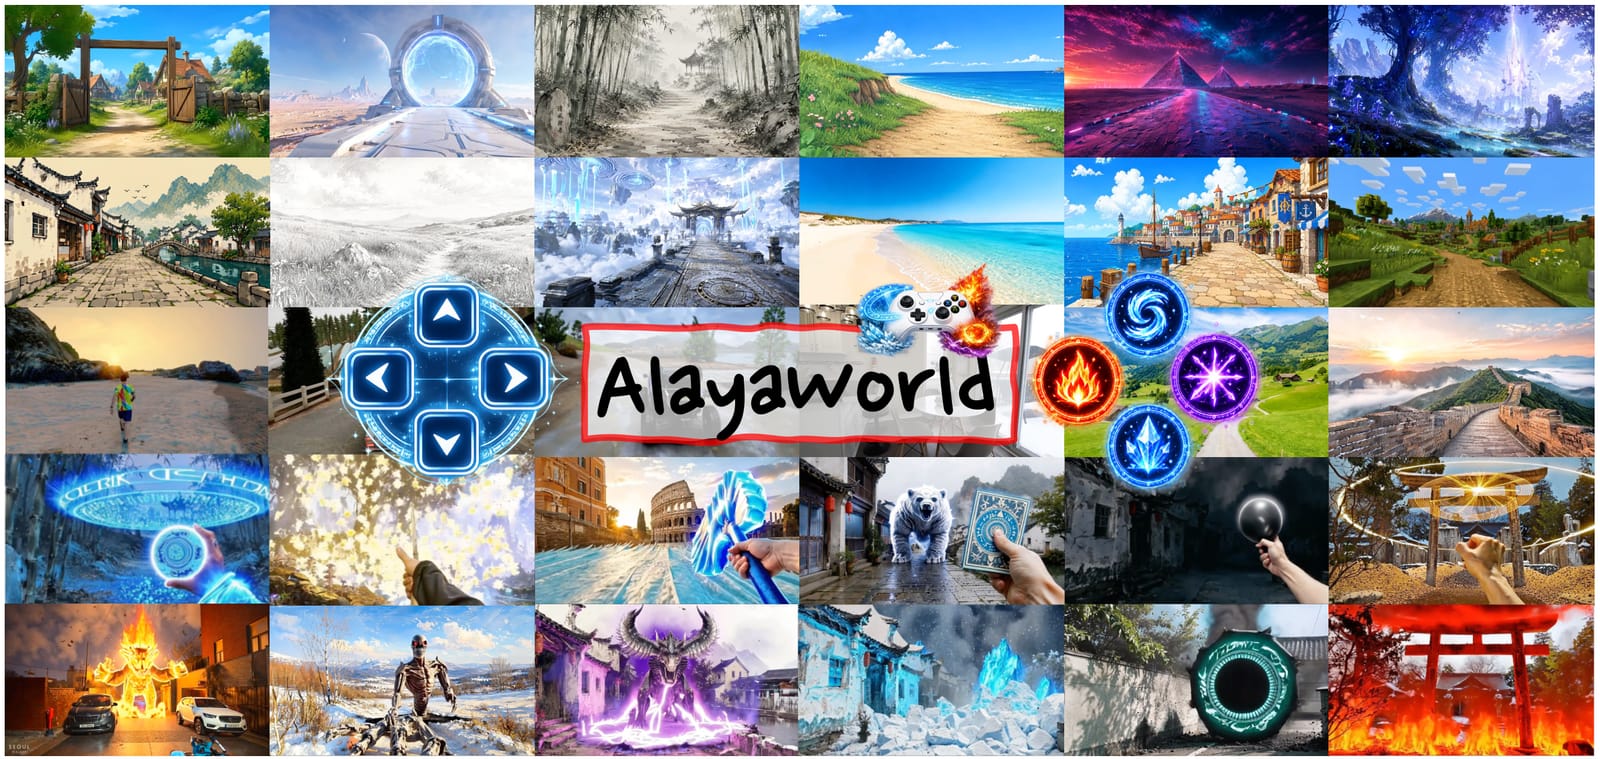
AlayaWorld
1枚の画像とカメラの動き、テキスト指示だけから、1分以上遊び続けられる「動く映像世界」をリアルタイム生成し続けるオープンソースの世界モデル。
ALAYA Lab (Shanda AI) / GitHub
#Spatial/3D#GenVideo#AI/Agents
Decoy Font
人間には正しく読めるのに、AI(OCR/画像認識モデル)には別の単語に誤読されてしまう文字を作れるフォント「Decoy Font」。
Mixfont(Eric Lu)
#CreatorTools#HCI/MediaArt
ARDY
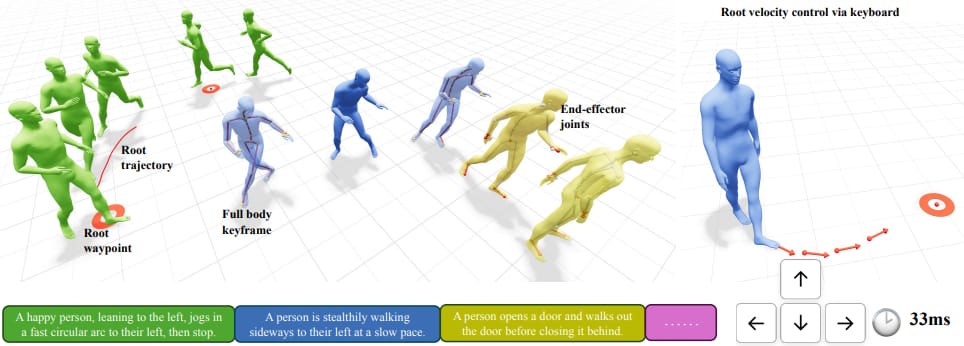
NVIDIAとETH Zürichが開発した、テキストの指示だけでリアルタイムに人体の3Dモーションを生成し続けられるAIモデル。1コマの生成がわずか約33ミリ秒で、動かしながら指示を変えられる。
NVIDIA (ETH Zürich共同研究) / GitHub
#Motion/Body#CreatorTools
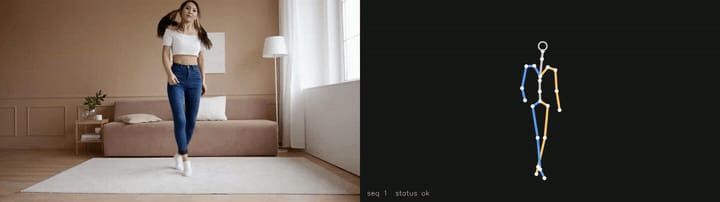
PoseCap
映像制作集団Corridor Digitalと共同開発された、Webカメラ1台だけでBlenderにリアルタイムでモーションキャプチャを流し込める無料オープンソースツール。
Corridor Digital / GitHub
#Motion/Body#CreatorTools
EmoMime
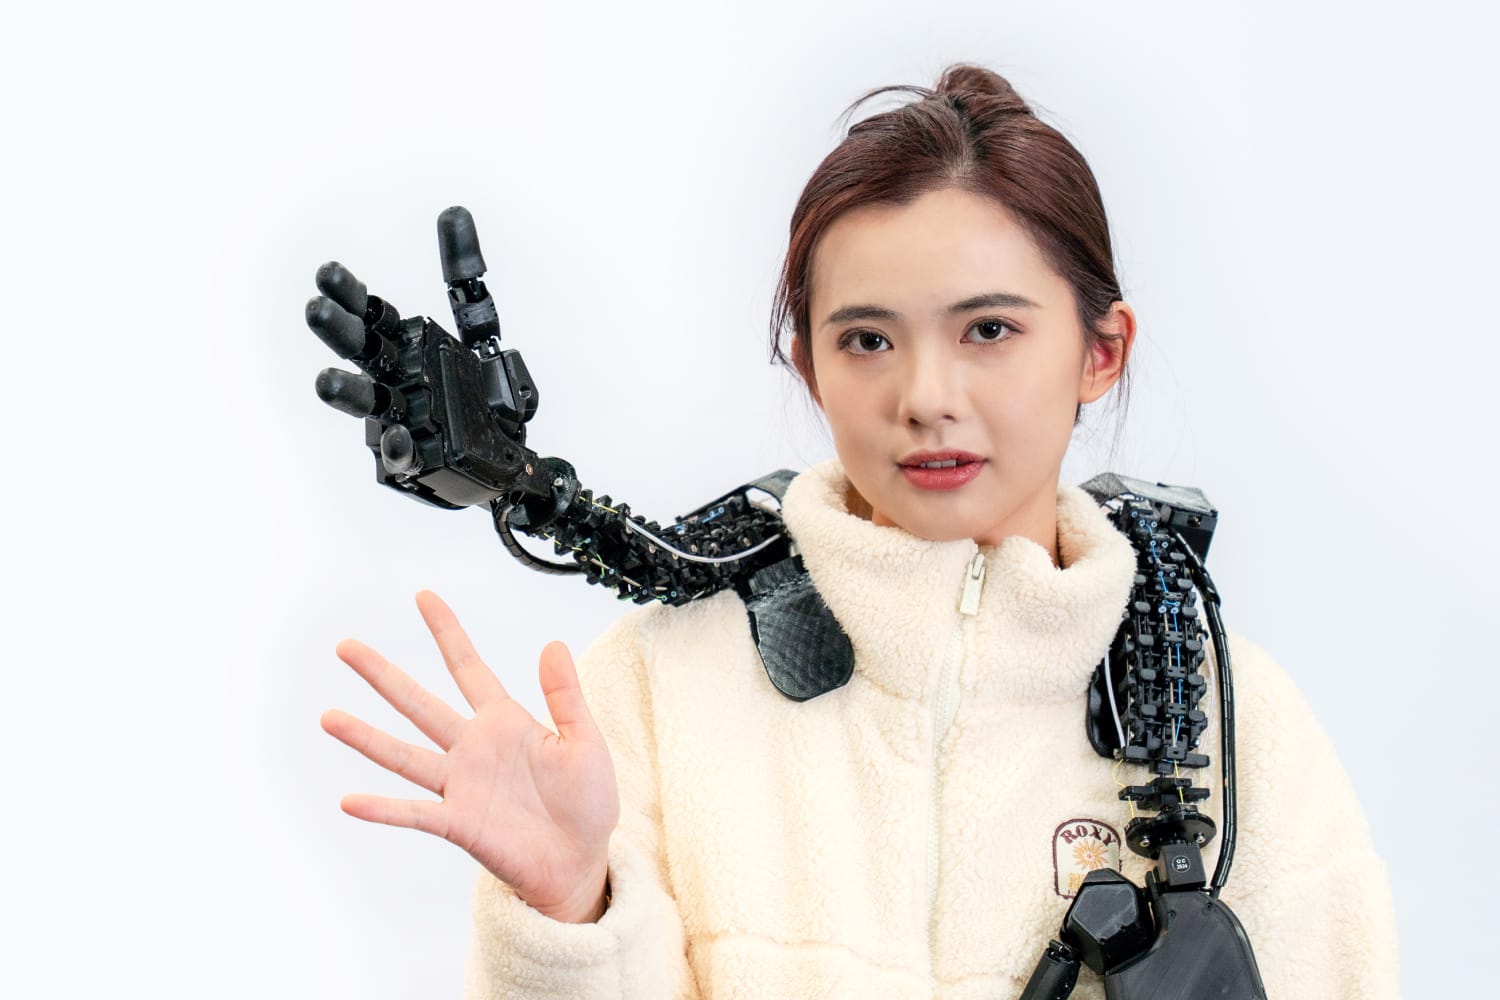
顔のすぐそばでも安全に動かせる、人間の手のかたちをしたウェアラブルロボットアーム。表情やしぐさを増幅して伝える新しい身体拡張デバイス。
東京大学 先端科学技術研究センター 稲見研究室(Information Somatics Lab, RCAST, The University of Tokyo)
#HCI/MediaArt#Motion/Body
LingBot-Video
ロボットなど「体を持つAI」が動きを学ぶための教材としても使える、大規模な動画生成AIモデル。見た目の美しさだけでなく物理的な正しさを重視して作られている。
Robbyant / GitHub
#GenVideo#AI/Agents
Frontstage
ブラウザとWindowsで動く無料・オープンソースの「AIネイティブ」動画編集ソフト。本格的なタイムライン編集の中に、AIによる映像生成とチャット型の自動編集エージェントが組み込まれている。
x777(個人開発者) / GitHub
#CreatorTools#GenVideo
ComfyUI-OCIO
映画・VFX業界標準の色空間管理システム「OpenColorIO」を、ComfyUIの中でNuke並みの精度で使えるようにするカラーマネジメント拡張ノード集。
Slava Sexton(AI VFX NEWS) / GitHub
#CreatorTools
GRAIL
3Dアセットと動画生成AIから人型ロボット向けの全身動作データを自動合成し、実機のUnitree G1に転移させるNVIDIA/UCLAの研究パイプライン。
NVIDIA / UCLA / GitHub
#Motion/Body#Spatial/3D
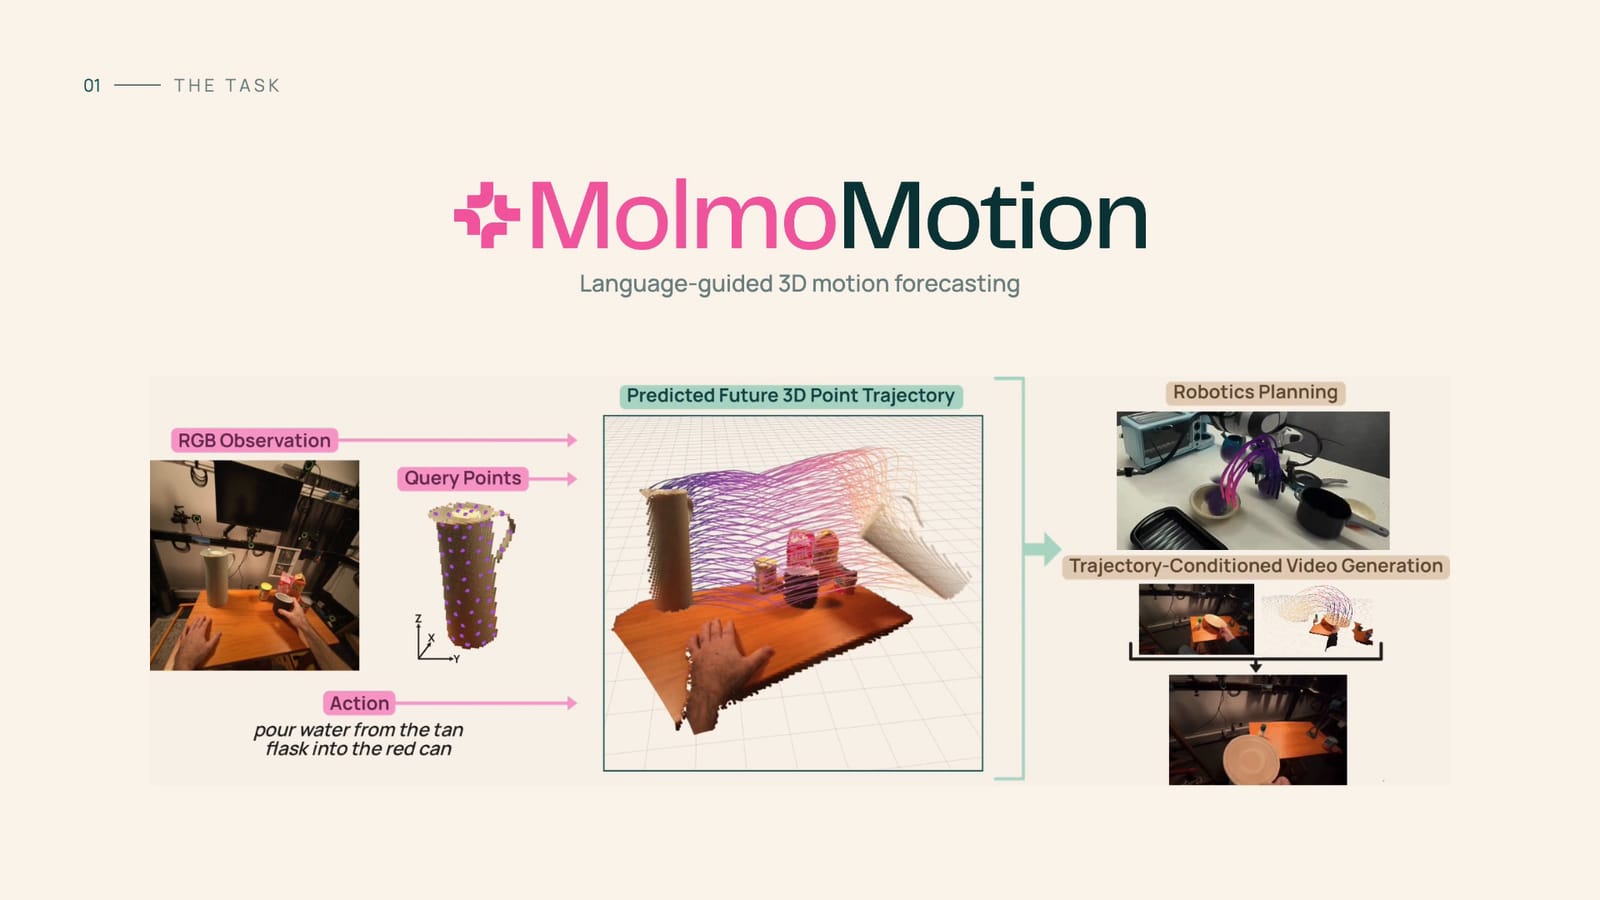
MolmoMotion
1枚の画像と自然言語の指示だけで、物体の3D上の動き(数秒先までの軌跡)を予測するAi2の基盤モデル。ロボットの動作計画や動画生成の精度向上に使える。
Allen Institute for AI (Ai2) / GitHub
#AI/Agents#Motion/Body#GenVideo
Live Avatar
1枚の顔写真と音声だけから、何時間でも破綻せずしゃべり続けるリアルタイム映像アバターを生成するAI。オンライン会議用ではなく、ライブ配信・大画面演出向けの生成速度と持続性を狙って設計されている。
Alibaba Quark / 中国科学技術大学 (USTC) / GitHub
#Motion/Body#GenVideo#AI/Agents
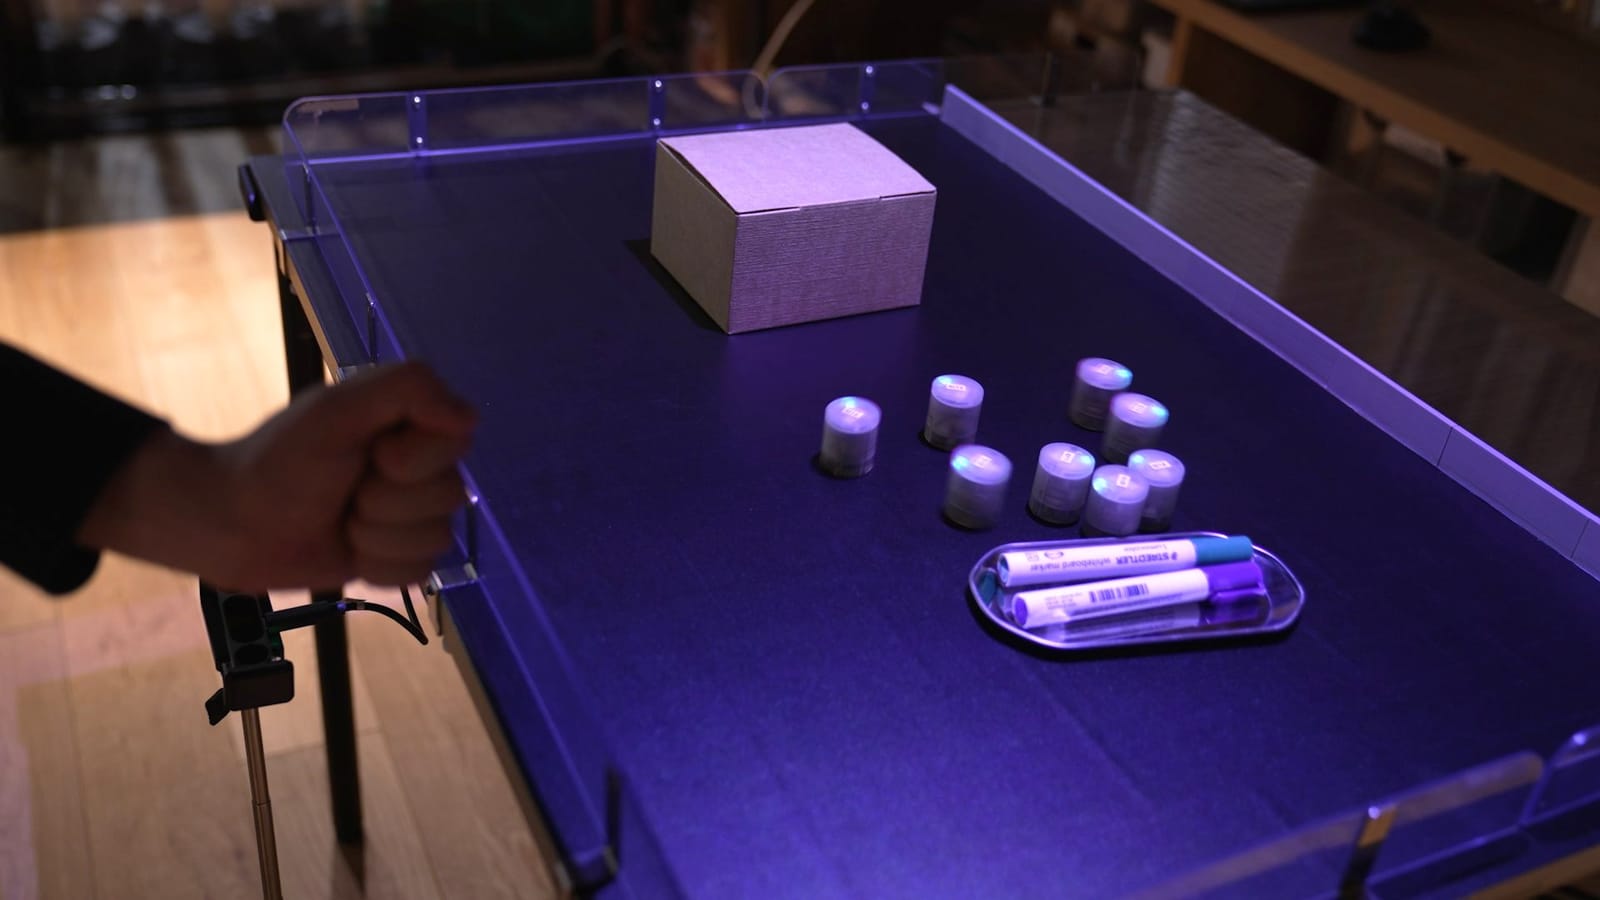
FluidicSwarm
手のジェスチャーだけで、複数の小型ロボット群を「水のような一つの生き物」のように自在に操れる操作システム。握る・開くといった動作で群れの硬さや形が変わる。
筑波大学 Metaverse Media Lab(Eguchi, Yoshida, Nishimura, Hiraki)
#HCI/MediaArt#Motion/Body#Spatial/3D
Palmier Pro
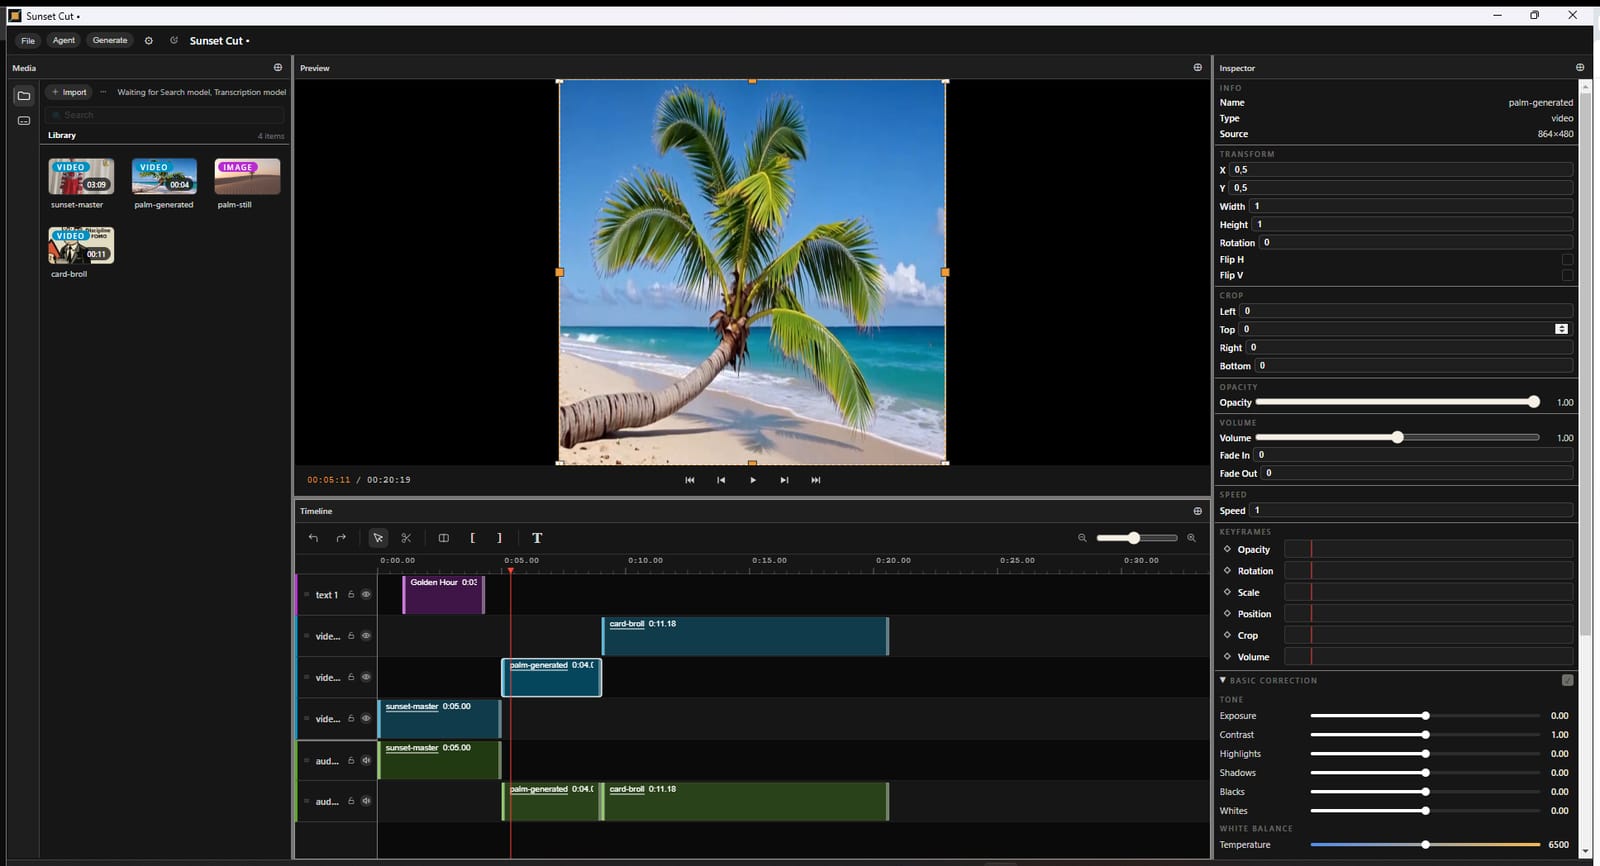
AIエージェントが人間と同じタイムラインで動画を操作できる、Mac向けオープンソース動画編集ソフト。
Palmier, Inc.(Y Combinator S24) / GitHub
#CreatorTools#GenVideo#AI/Agents
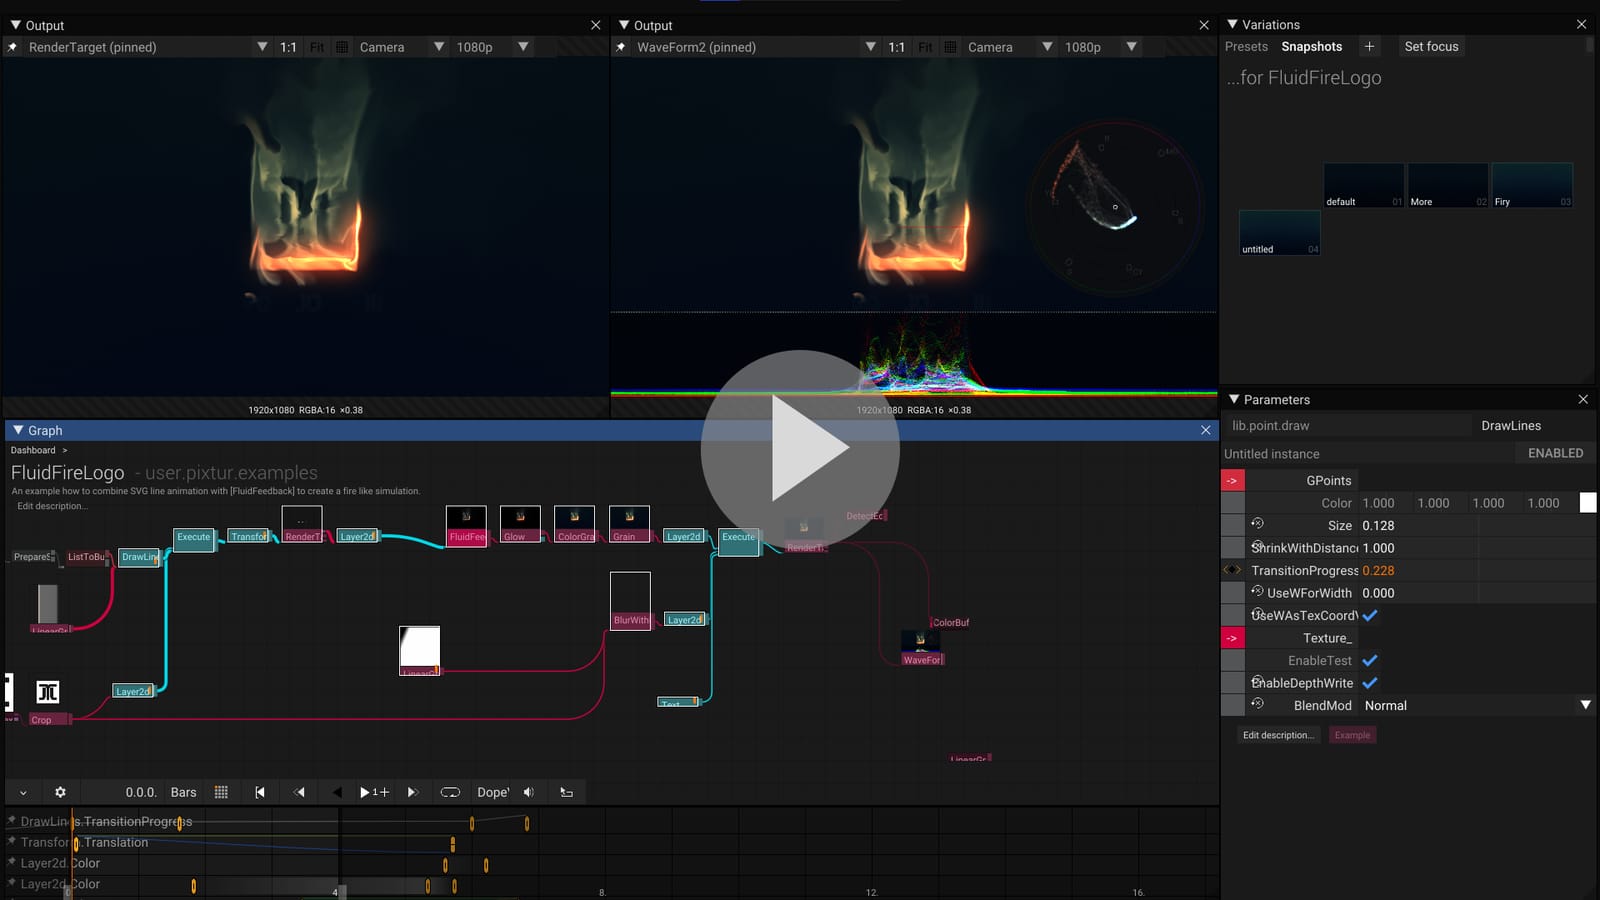
TiXL(旧称 Tooll3)
音楽やMIDIに反応して映像がその場で変化する、無料のリアルタイム・モーショングラフィックス制作ツール。
TiXLオープンソースコミュニティ / GitHub
#CreatorTools#HCI/MediaArt#Audio/Music
RotoAI
「赤いシャツの人」のような自然言語の指示だけで、動画から人物や物体をきれいに切り抜けるオープンソースのロトスコープ・スタジオ。
sPappalard(個人開発) / GitHub
#CreatorTools#GenVideo
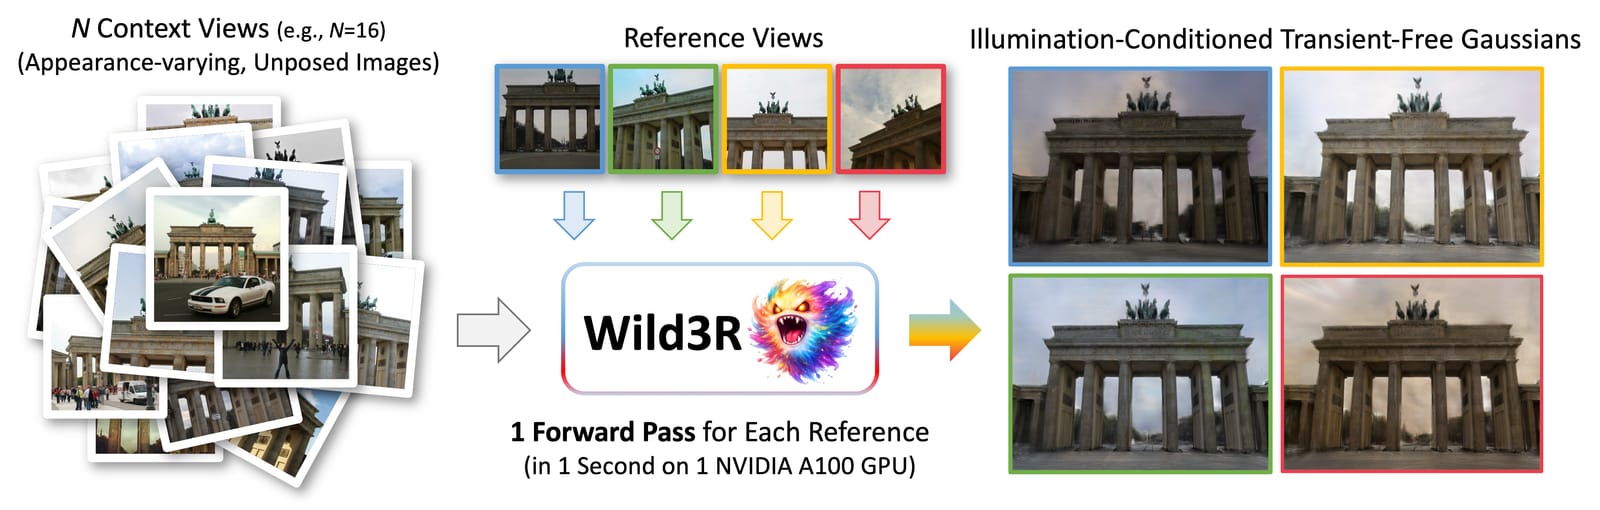
Wild3R
観光地などで不特定多数がバラバラの日時・条件で撮った“寄せ集めの写真”だけから、一度のAI推論で3D空間を復元する技術。
東京大学 山崎研究室 / GitHub
#Spatial/3D
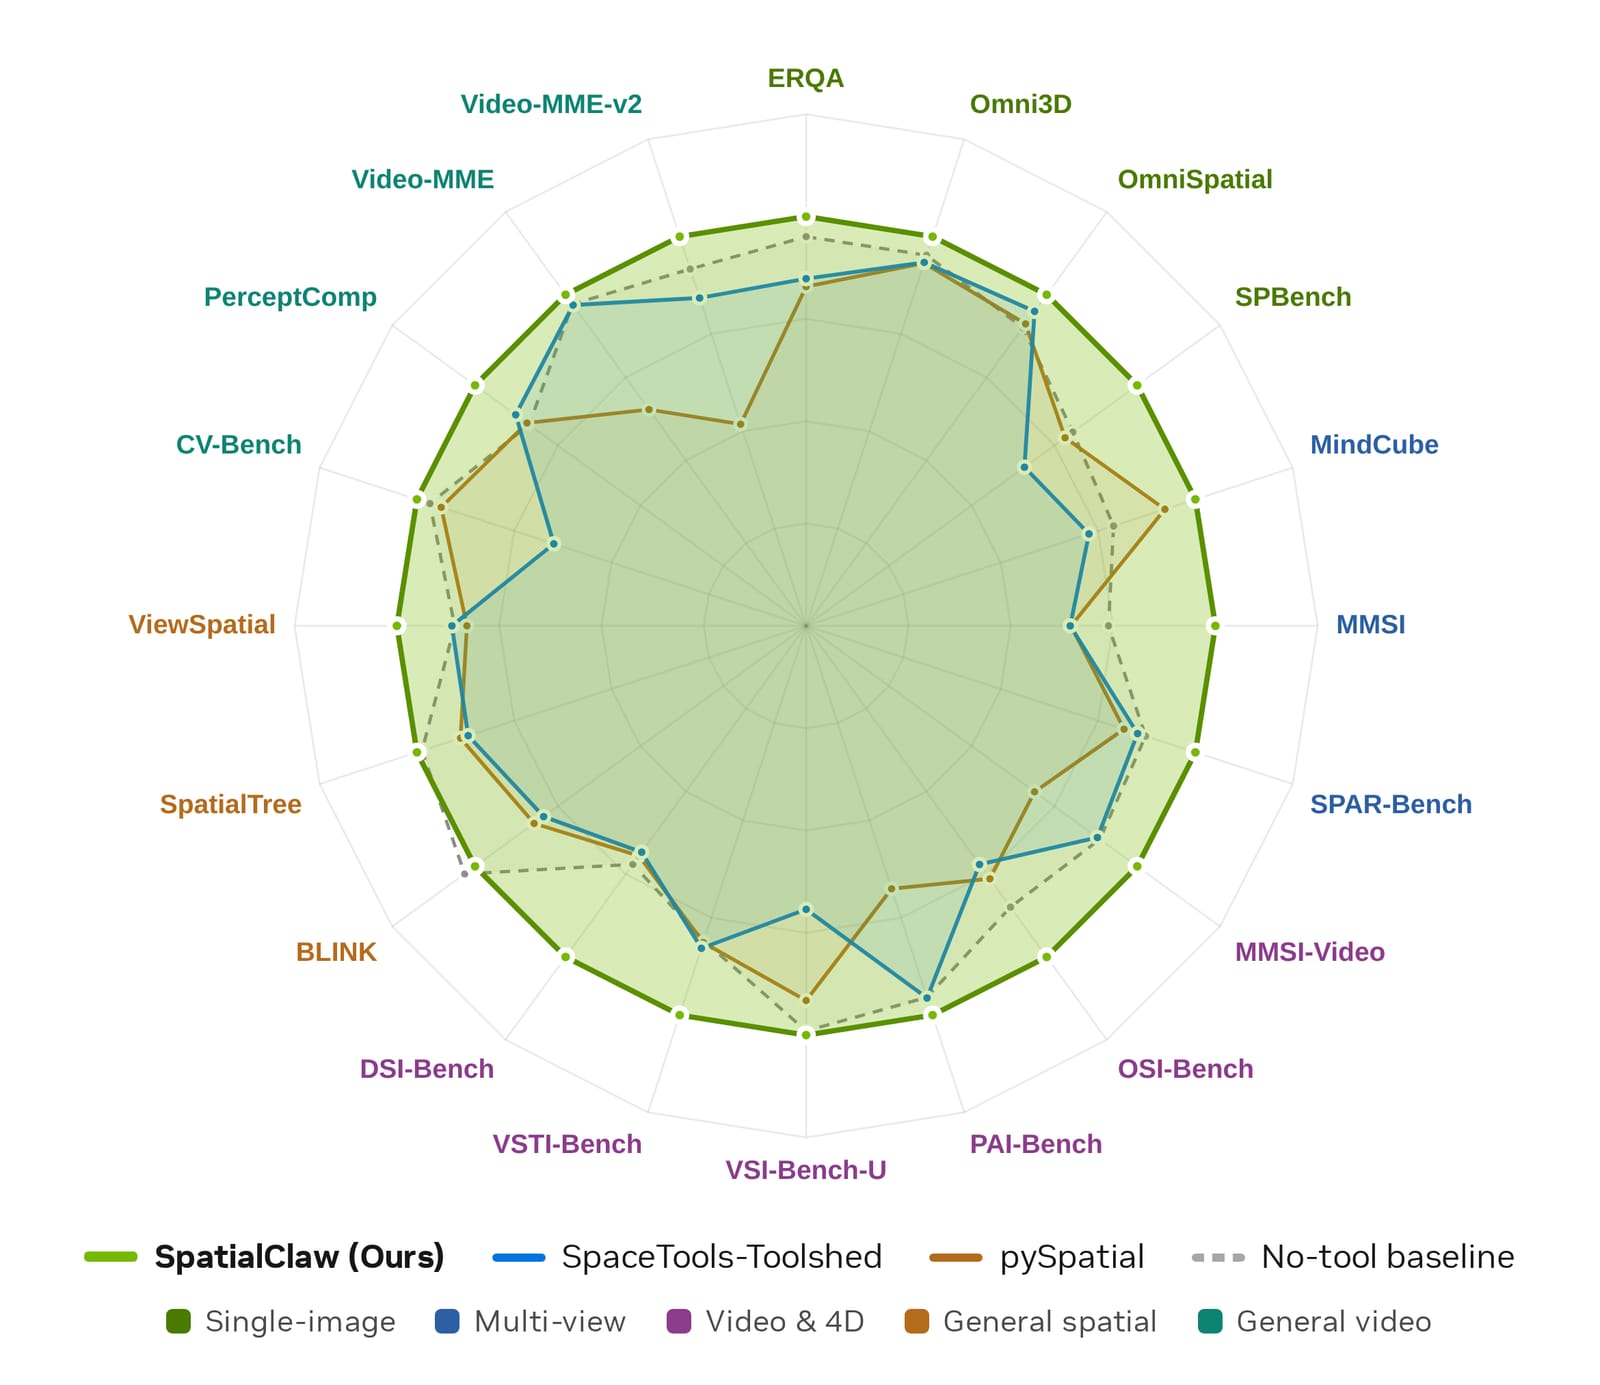
SpatialClaw
画像・映像・4Dシーンについて「どこに何がどれだけ離れてあるか」を、AIが自らPythonコードを書きながら考えて答える空間推論エージェント。
NVIDIA Research / GitHub
#Spatial/3D#AI/Agents
YaGS
Unreal Engine上でGaussian Splatting(実写風の点群3D表現)を、通常の3Dモデルと同じように“奥行きで正しく重ならせる”ことができる無料プラグイン。
Yandex / GitHub
#CreatorTools#Spatial/3D
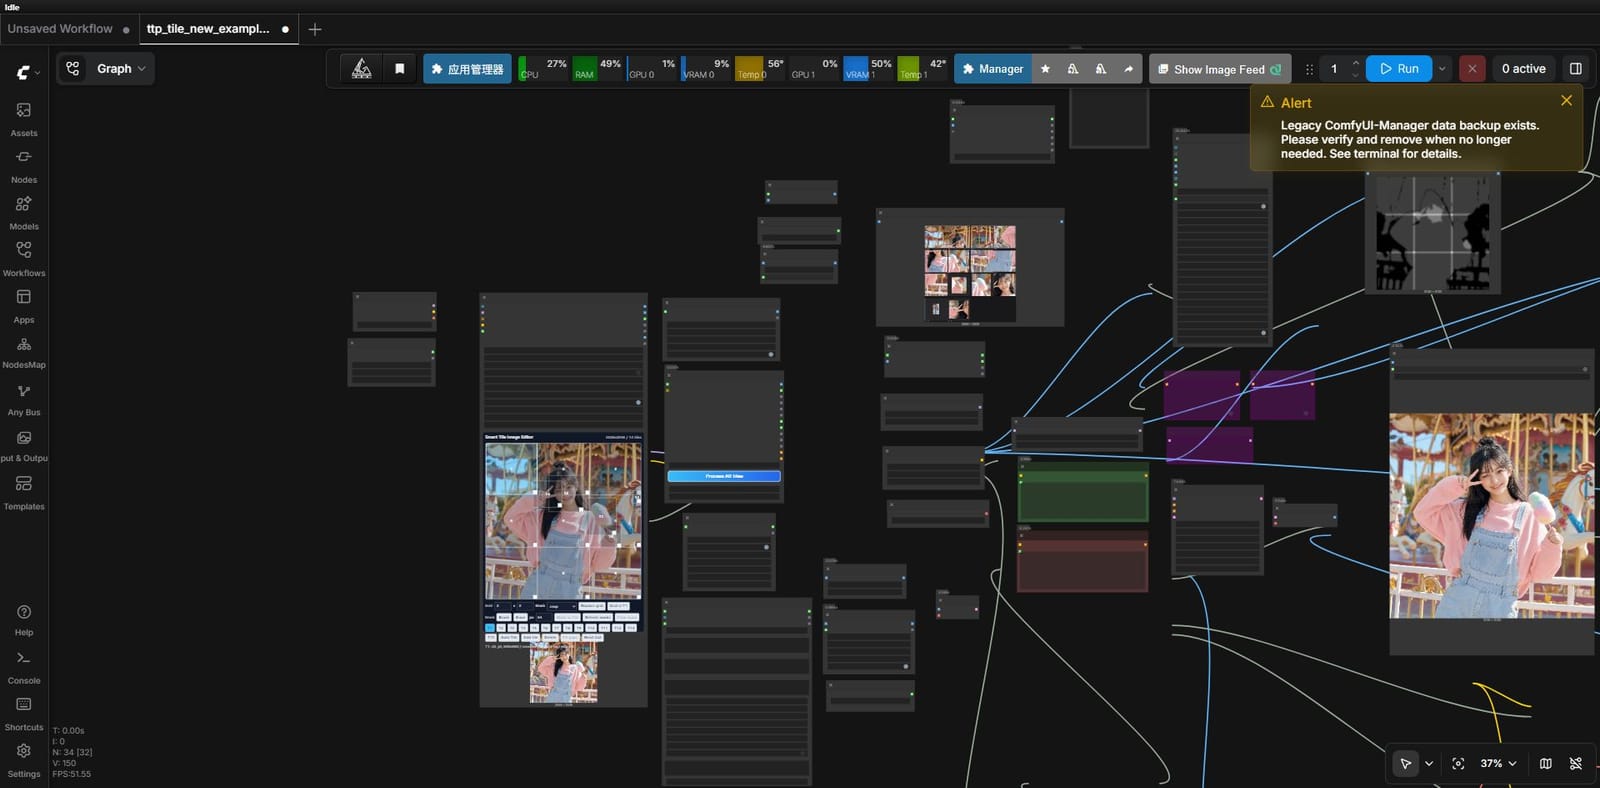
ComfyUI TTP Toolset – Smart Tile 2.0
画像の「どこが顔で、どこが背景か」をAIに認識させてから必要な場所にだけ細かいタイルを敷いて高解像度化・部分編集できるComfyUI拡張機能。2026年7月に大型アップデートし「Smart Tile 2.0」として生まれ変わった。
TTPlanetPig(個人開発者) / GitHub
#CreatorTools
fVDB v0.5.0
NVIDIAのオープンソース3D深層学習基盤「fVDB」がv0.5.0でGaussian Splattingの中核処理を強化。広大な空間を複数GPUで高速・省メモリに3Dデータ化できるようになった。
NVIDIA / GitHub
#Spatial/3D#CreatorTools
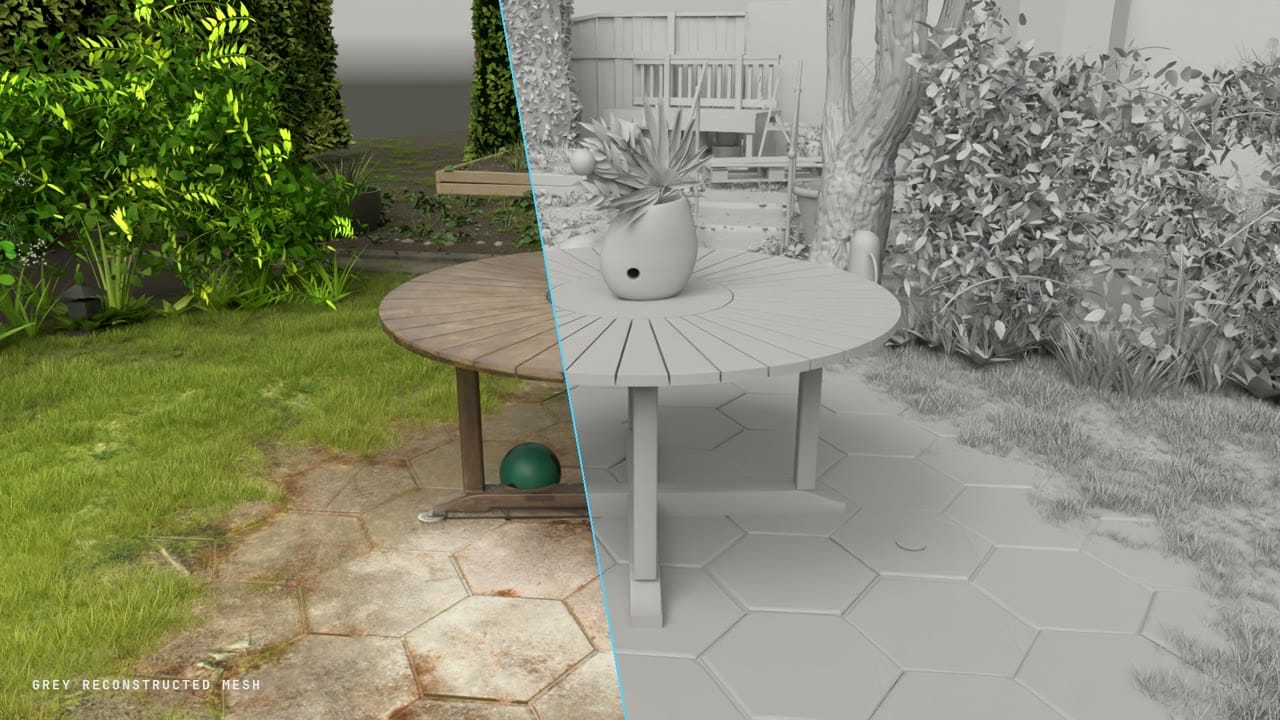
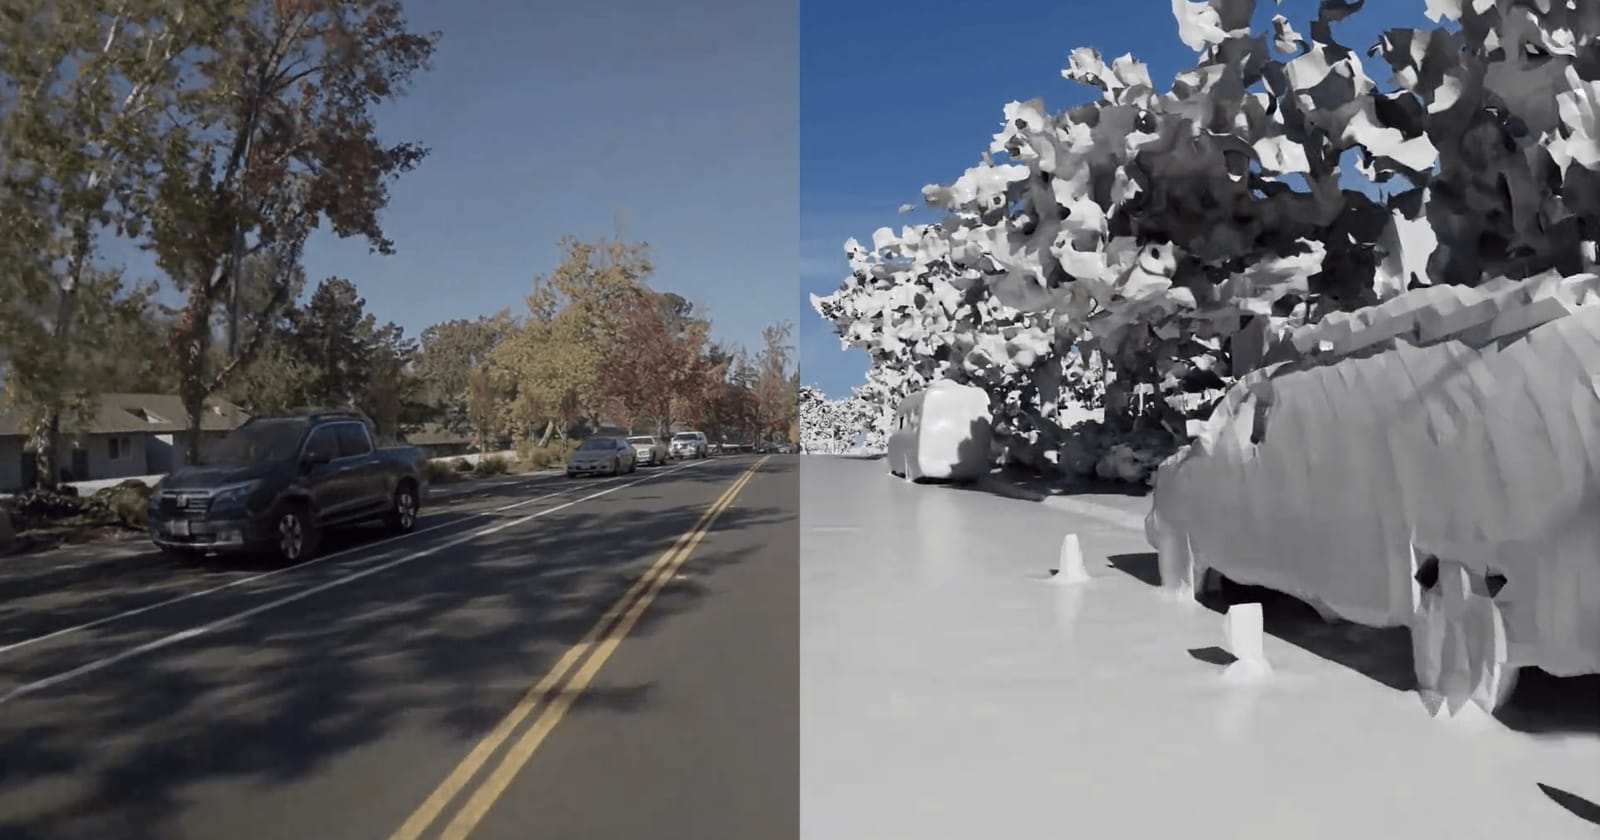
GRay
実写を3D化するGaussian Splattingを、正確な反射・屈折・影ごと「レイトレーシング」で描画できる新手法。従来のラスタライズ描画に迫る速さを実現した。
Inria (GraphDeco) / Université Laval / GitHub
#Spatial/3D#CreatorTools
robot_retargeter
人の動きを撮影したモーションキャプチャのデータを、体格や関節の数がまったく違う人型ロボットの動きに自動で変換できる、無料で使えるオープンソースの変換ツール。
個人開発者(GitHub: ccrpRepo) / GitHub
#Motion/Body#CreatorTools
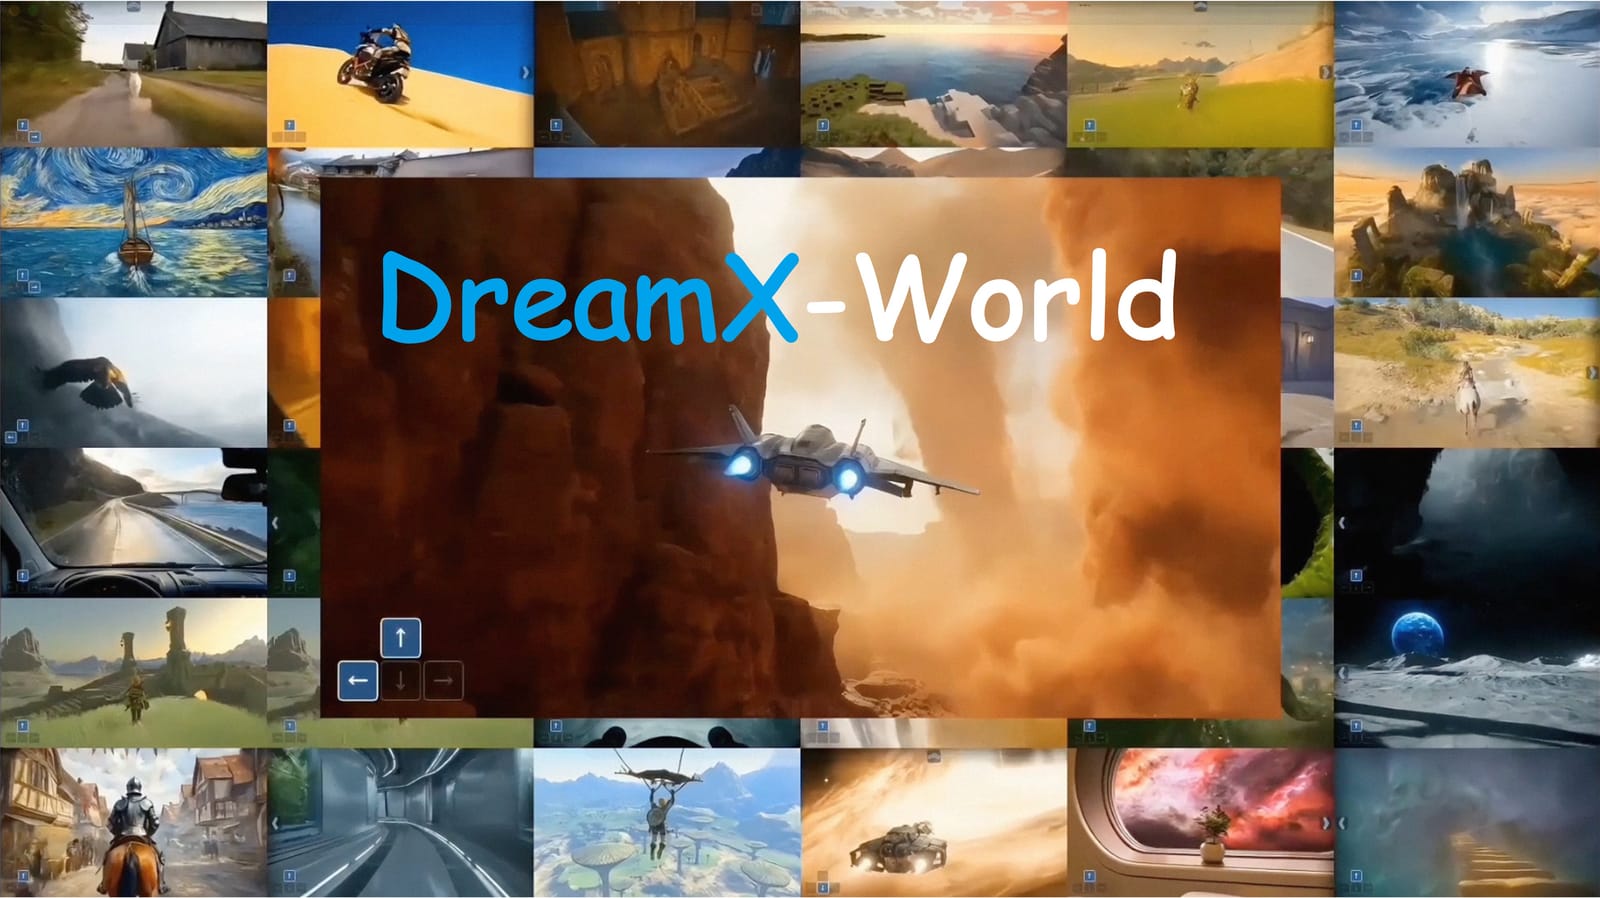
DreamX-World 1.0
テキスト指示だけで、視点を動かしても矛盾なく繋がり続ける「歩き回れる3D世界」の映像を生成できるAIモデル。
AMAP-ML (Alibaba AutoNavi) / GitHub
#Spatial/3D#GenVideo
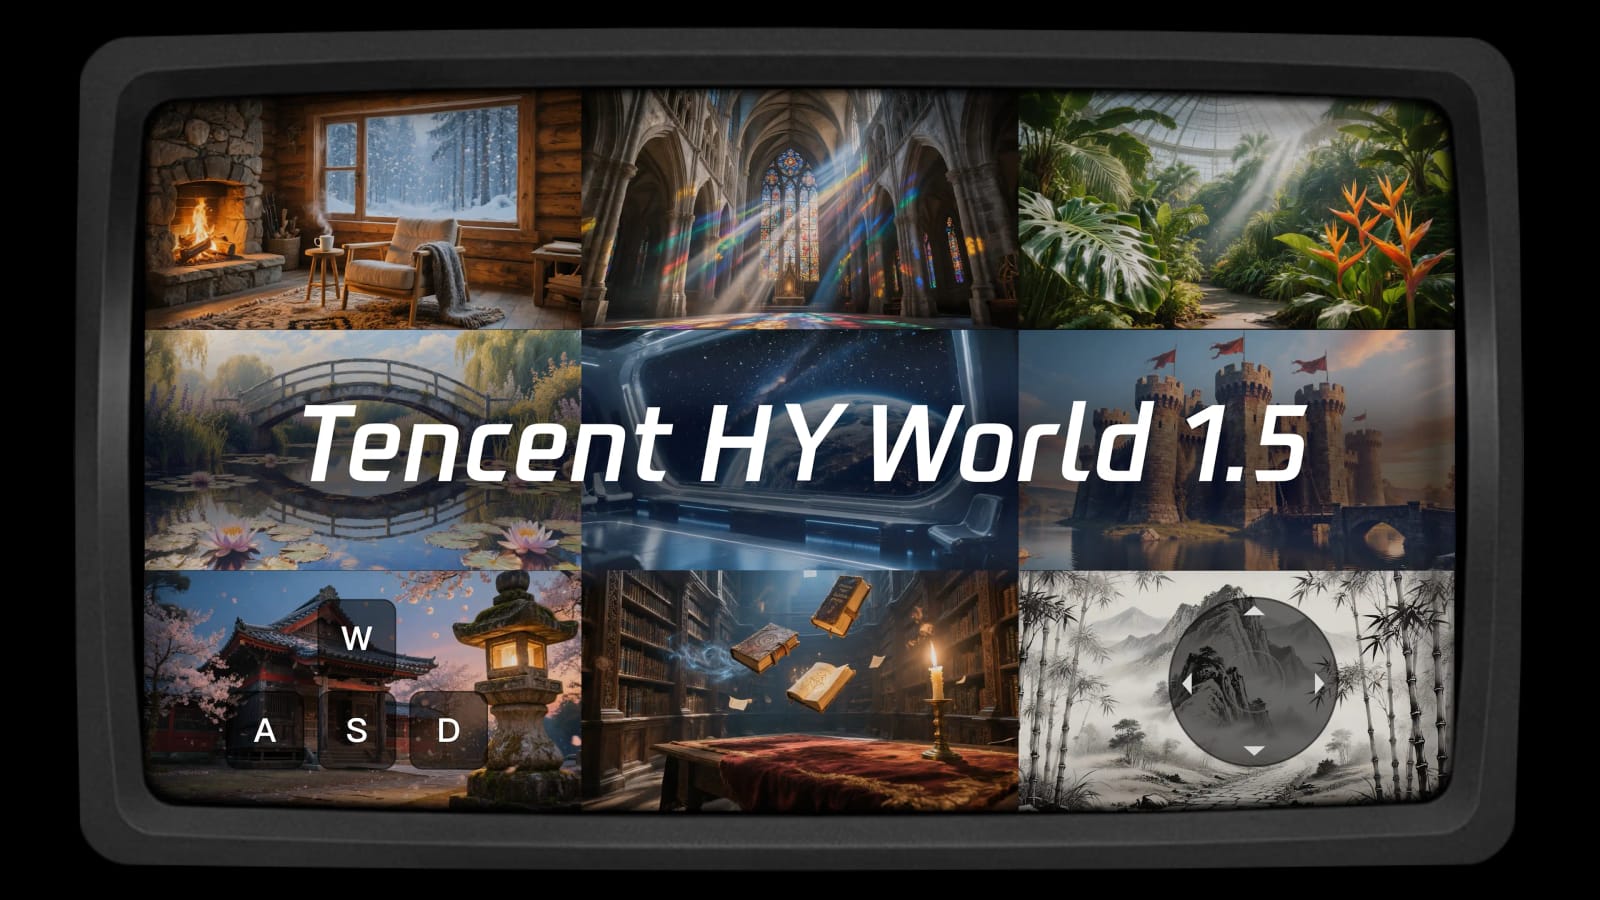
HY-World 1.5 / WorldPlay
1枚の画像やテキストから、ユーザーの操作に24fpsでリアルタイム反応する“歩き回れる映像世界”を生成するオープンな世界モデル。
Tencent Hunyuan / GitHub
#Spatial/3D#GenVideo
Aholo Viewer
インストール不要のブラウザだけで、最大10億スプラット級の巨大な3D空間をなめらかに表示できるOSSレンダラ。
Manycore Tech (Kujiale / 酷家乐) / GitHub
#Spatial/3D#CreatorTools
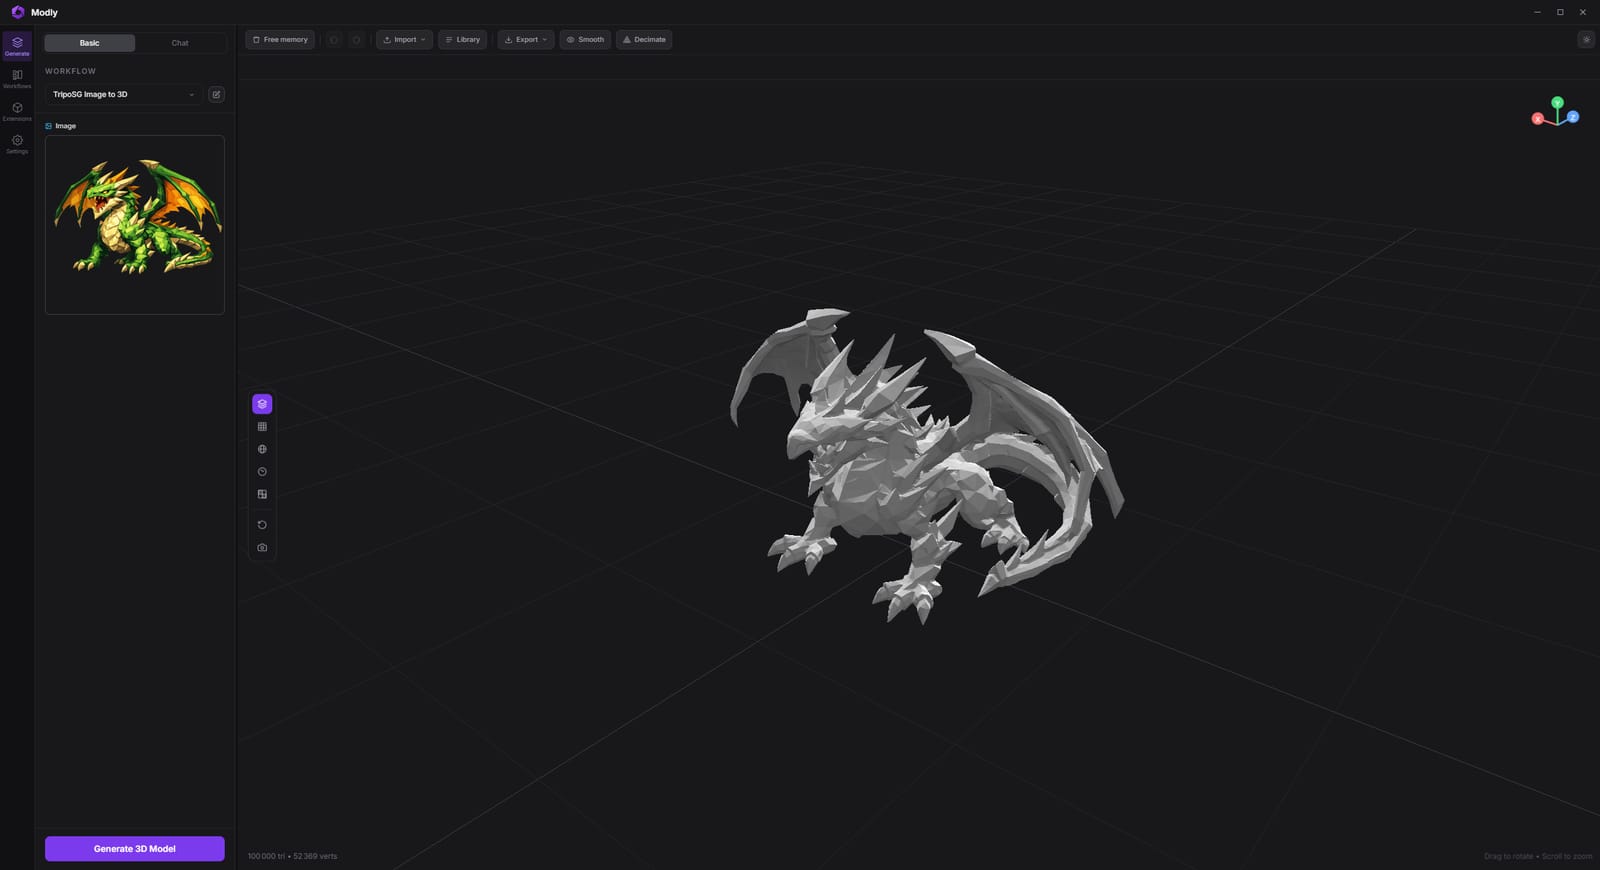
Modly
写真をクラウドに送らず、自分のPCのGPUだけで3Dメッシュ化できる完全ローカルの画像→3Dデスクトップアプリ。
lightningpixel (OSSコミュニティ) / GitHub
#Spatial/3D#CreatorTools
Gaussian SplatKing
iPhoneのデュアルレンズとLiDARで、ガウススプラッティング向けの高品質な撮影データを無料で取得できるiOSアプリ。
Radiance Fields
#Spatial/3D#CreatorTools
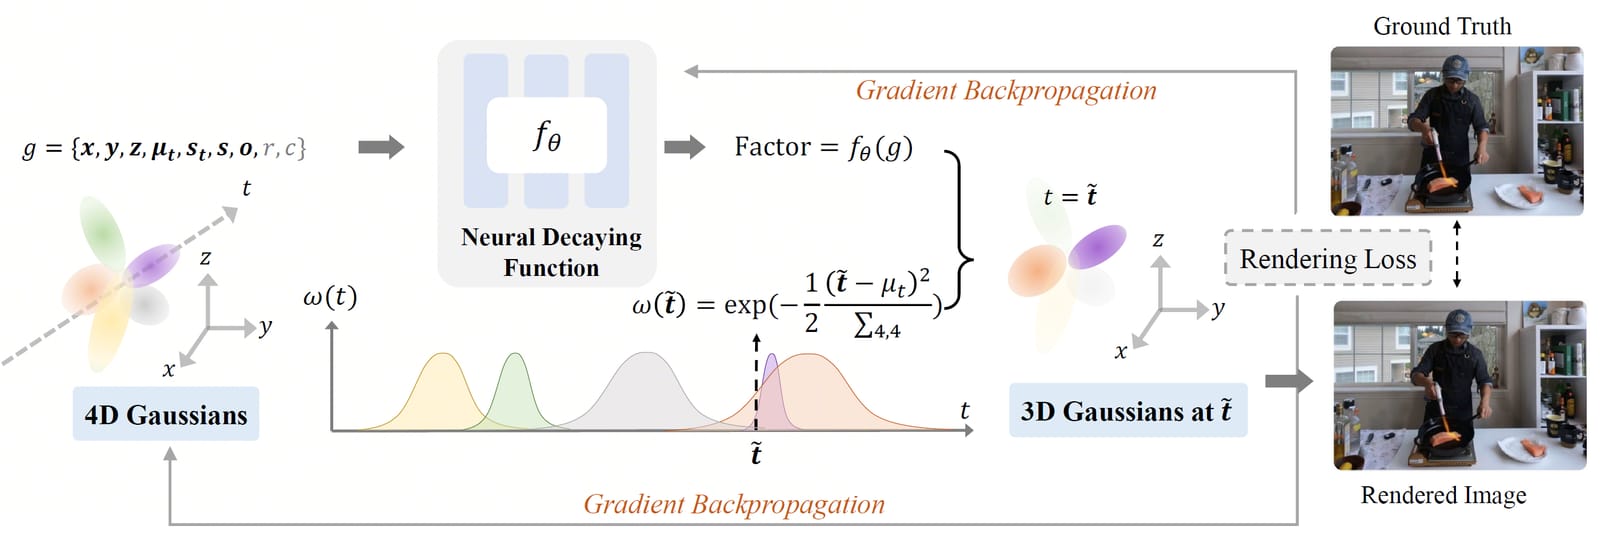
4C4D
たった4台のカメラ映像から、動く3D空間(4D)を高精細に復元するCVPR 2026の研究。
Junsheng Zhou ほか(学術, CVPR 2026) / GitHub
#Spatial/3D
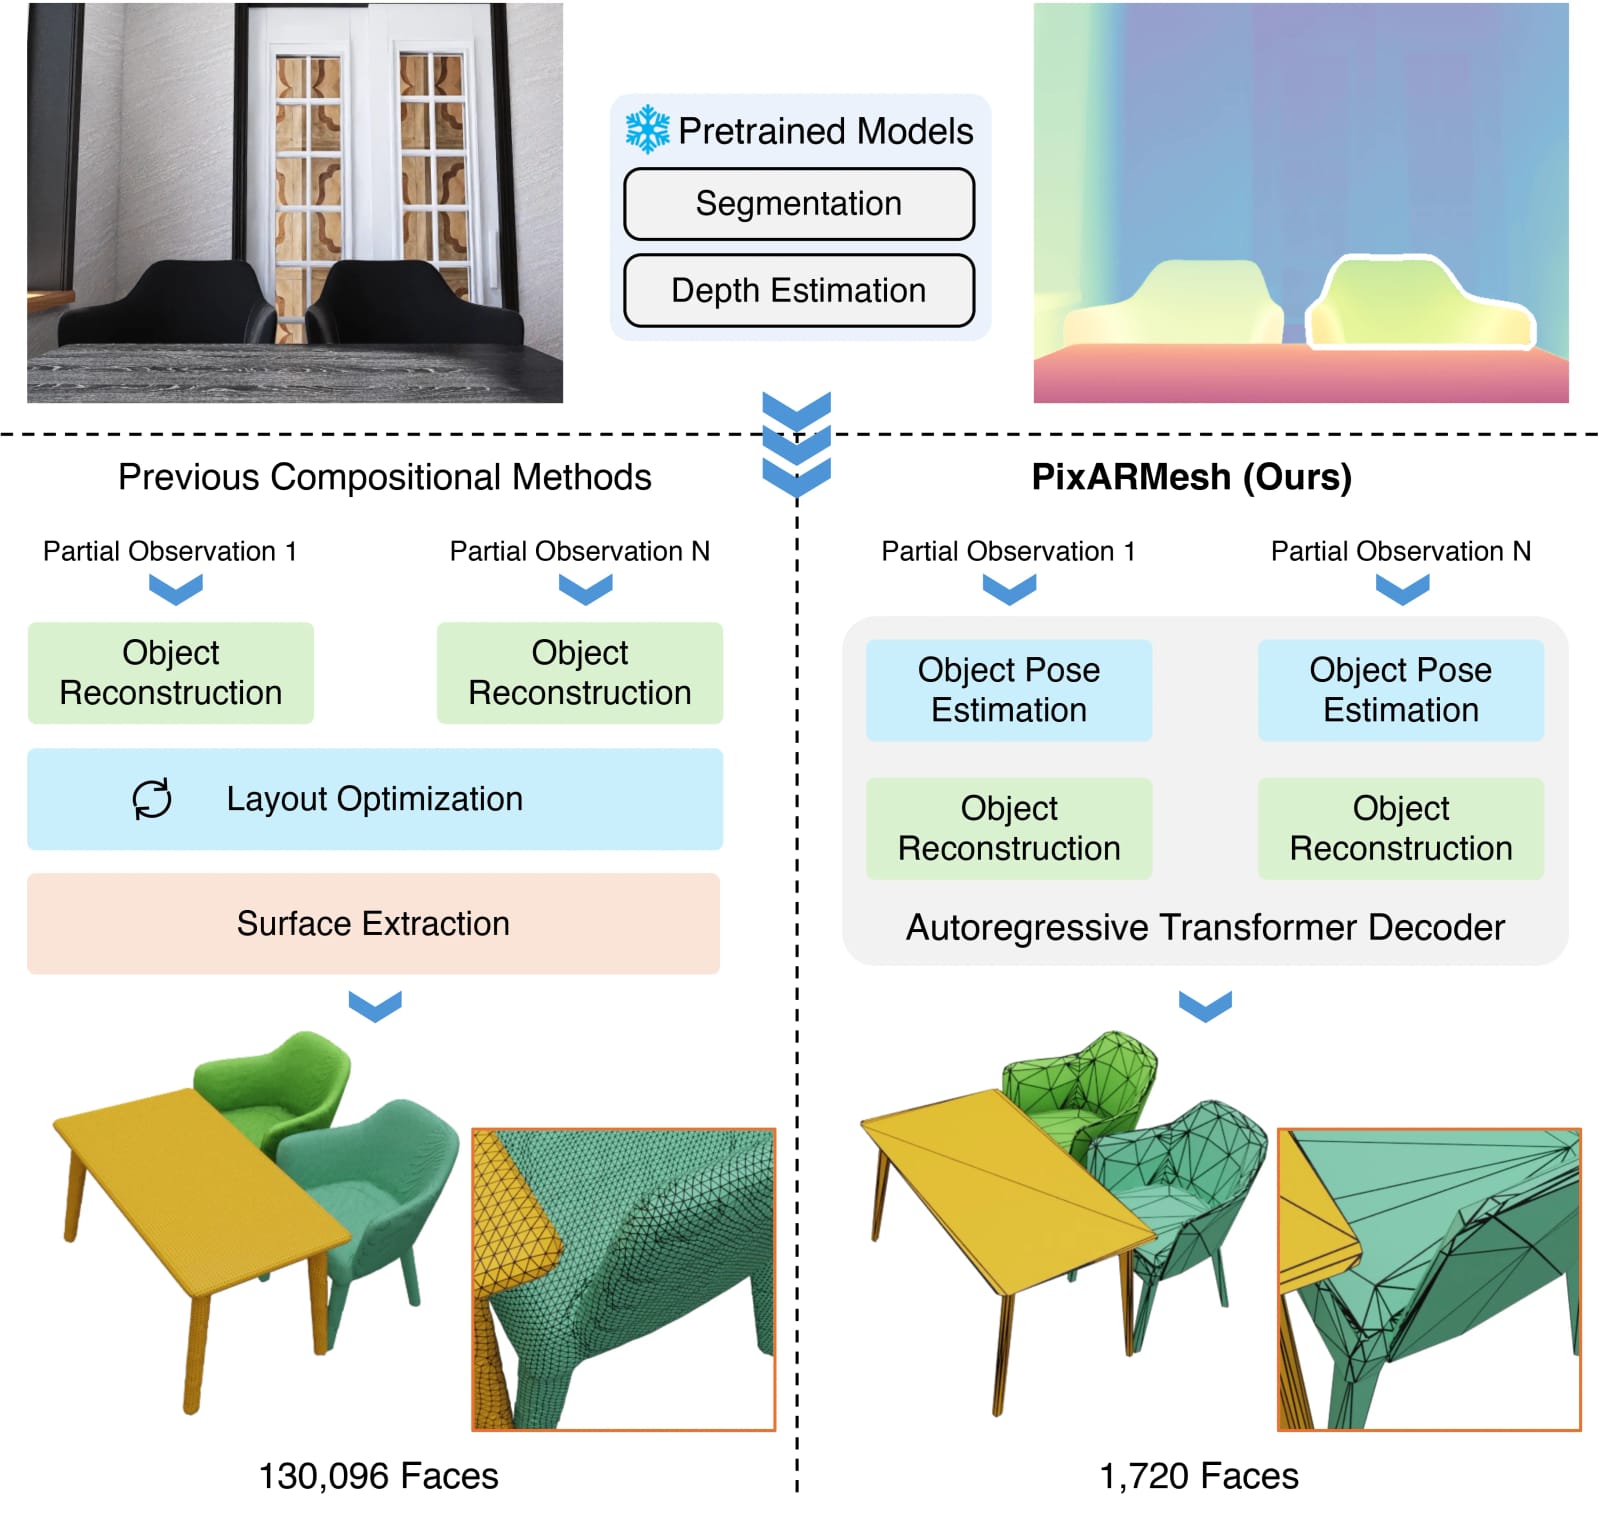
PixARMesh
1枚の室内写真から、部屋全体の配置と編集可能な3Dメッシュを一括生成する自己回帰フレームワーク。
UC San Diego MLPC / GitHub
#Spatial/3D#CreatorTools
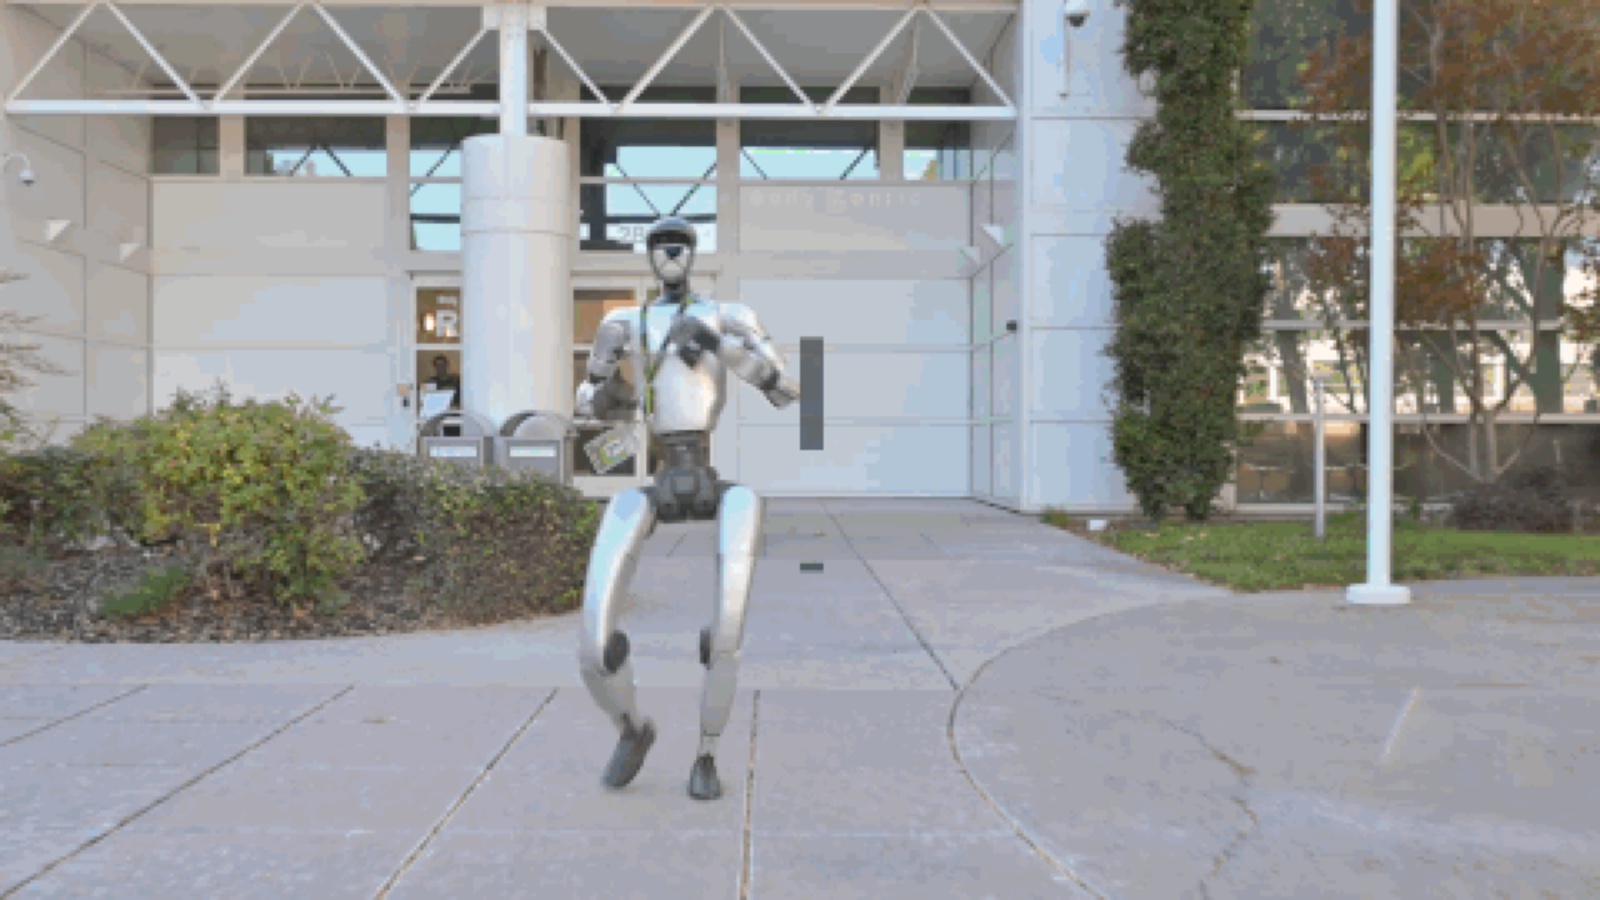
SONIC(GR00T Whole-Body Control)
歩行・走行・忍び足・格闘・跳躍・両手での物体受け渡しまで、人型ロボットの全身動作を一体で担う『動きの基盤モデル』。テキスト指示・VRなりきり操作・ゲームパッドやキーボードで操作でき、ブラウザ体験デモも公開。
NVIDIA(GEAR / NVlabs) / GitHub
#Motion/Body#AI/Agents
SCAIL-2
動画に写った人物の動きを、骨格抽出を経ないEnd-to-Endモード(姿勢駆動モードも選択可)で別キャラクターへそっくり乗り移らせる。ダンスも宙返りも、人物置き換えや動物への変換も1モデルで実行。
Z.ai(智譜AI / Zhipu AI) / GitHub
#Motion/Body#CreatorTools#GenVideo
Bernini
自然な言葉の指示で画像も動画も生成・編集できる統合モデル。指示を読み解く『演出担当』AIと映像を描く『作画担当』AIが分業し、触らない領域を保ったまま編集する。
ByteDance(Seed / ByteDance Research) / GitHub
#GenVideo#AI/Agents#CreatorTools
FireRed-OpenStoryline
話しかけると編集ディレクターのように段取りを組み、素材選び・カット・つなぎまで自動化する動画編集エージェント。人が途中で介入できる対話的な共同編集と、ブランド固有スタイルの再利用が特徴。
FireRedTeam(小紅書 / Xiaohongshu 研究チーム) / GitHub
#AI/Agents#CreatorTools#GenVideo
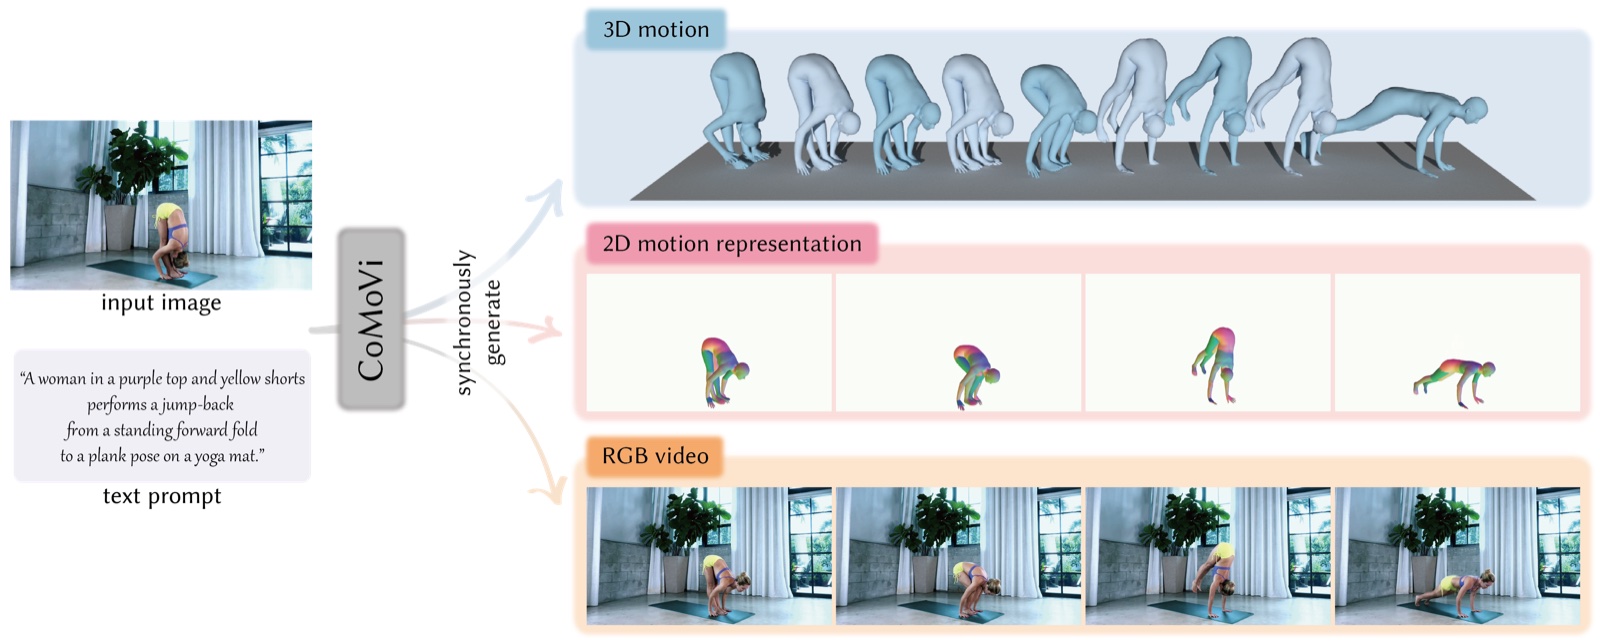
CoMoVi
文章から『3Dの人の動き』と『写実的な映像』を一つの生成ループの中で同時に作る。3Dが映像に構造の正しさを、事前学習済みの映像モデルが3Dの動きに汎化力(多様でもっともらしい動きを生む力)を互いに与え合って品質を底上げする。
HKUST(香港科技大学 IGL) / GitHub
#Motion/Body#GenVideo
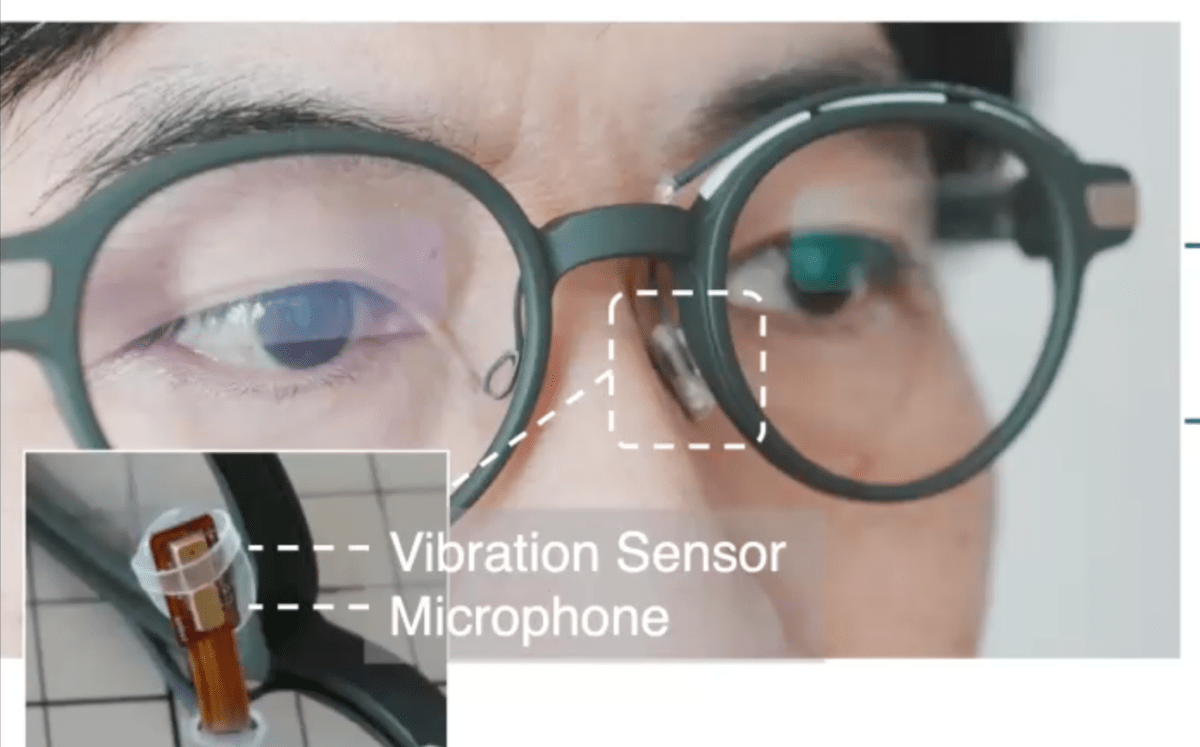
NasoVoce
スマートグラスの鼻当て部分にマイクと振動センサを仕込み、ほとんど声を出さない“ささやき”からでもクリアに音声を認識する、常時使える発話インターフェース(CHI 2026)。
東京大学 暦本研究室(Rekimoto Lab)
#HCI/MediaArt#AI/Agents#Audio/Music
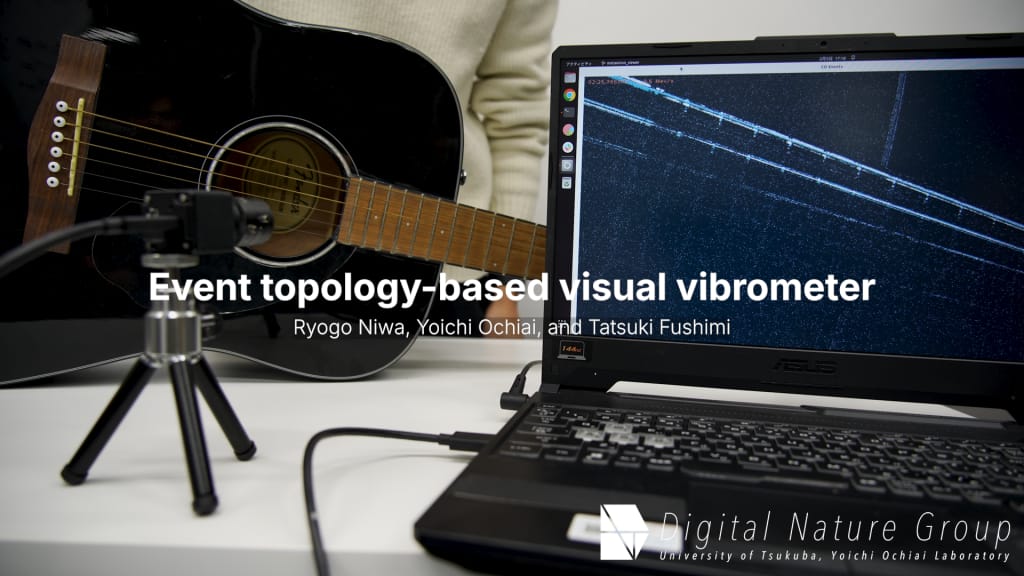
Event Topology-based Visual Vibrometer
高速の「イベントカメラ」の生データから、物体の微細な振動(=音)を光源なしで復元する計測手法。映像から複数の音を同時に“見て”取り出せる(Applied Physics Letters掲載)。
筑波大学 Digital Nature Group(落合陽一研究室)
#HCI/MediaArt#Audio/Music#Spatial/3D
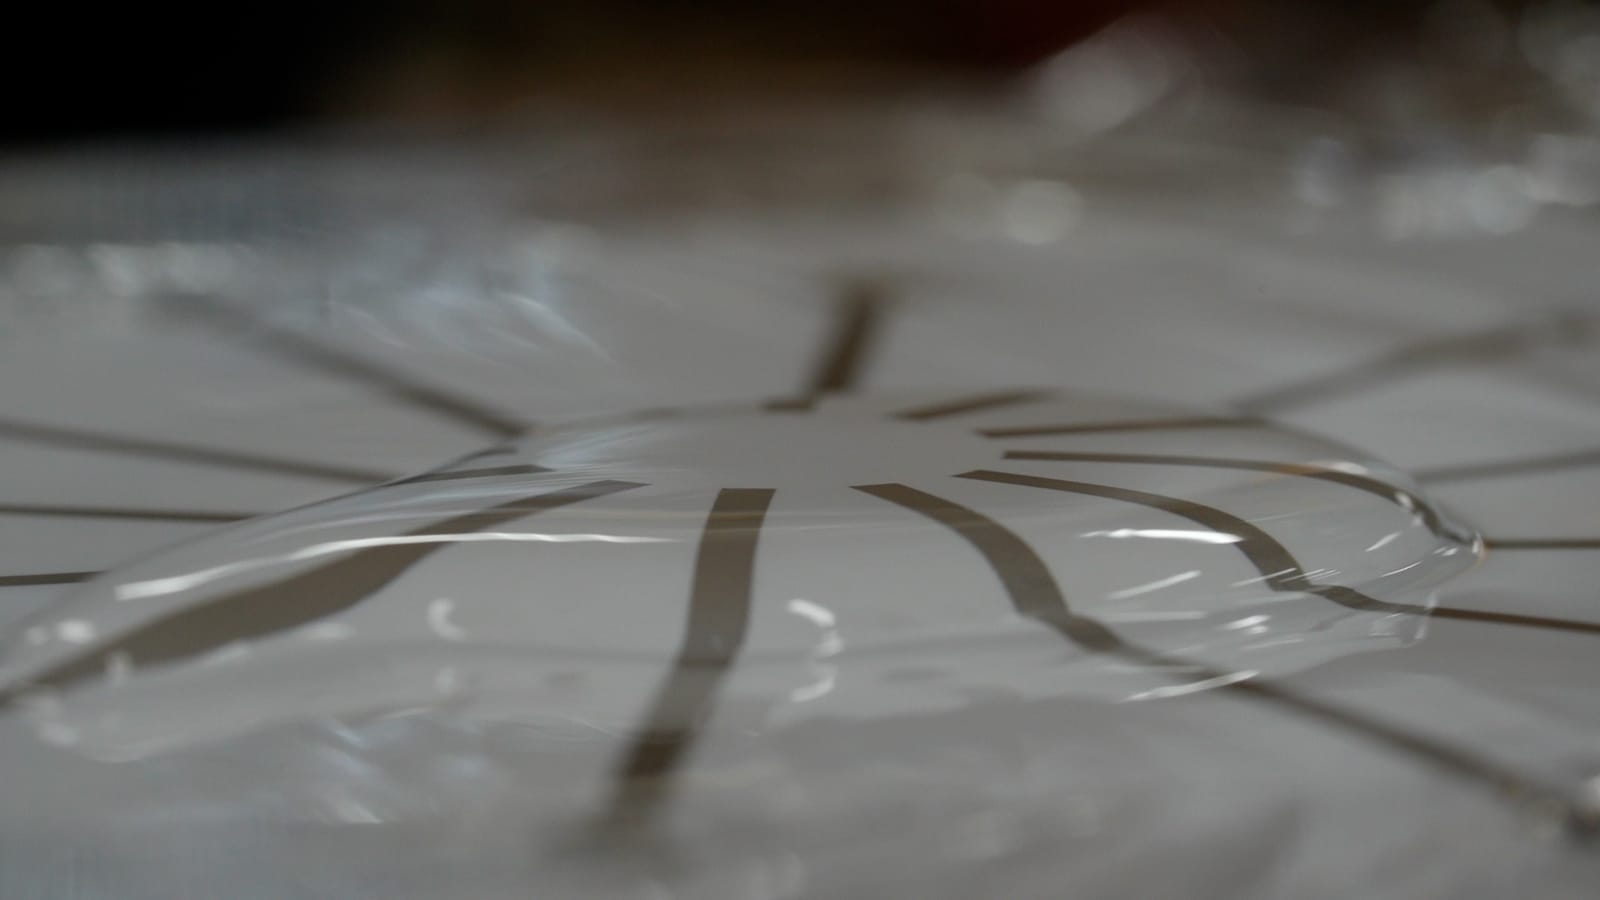
MorphDrops
紙に印刷した導電インクの模様に電気を流し、その上に置いた水滴の形を自在に変えるディスプレイ。一枚の紙で複数の“形が動く”パターンを見せられる(CHI 2026 Interactive Demo)。
東京大学 筧康明研究室(xlab)
#HCI/MediaArt#CreatorTools
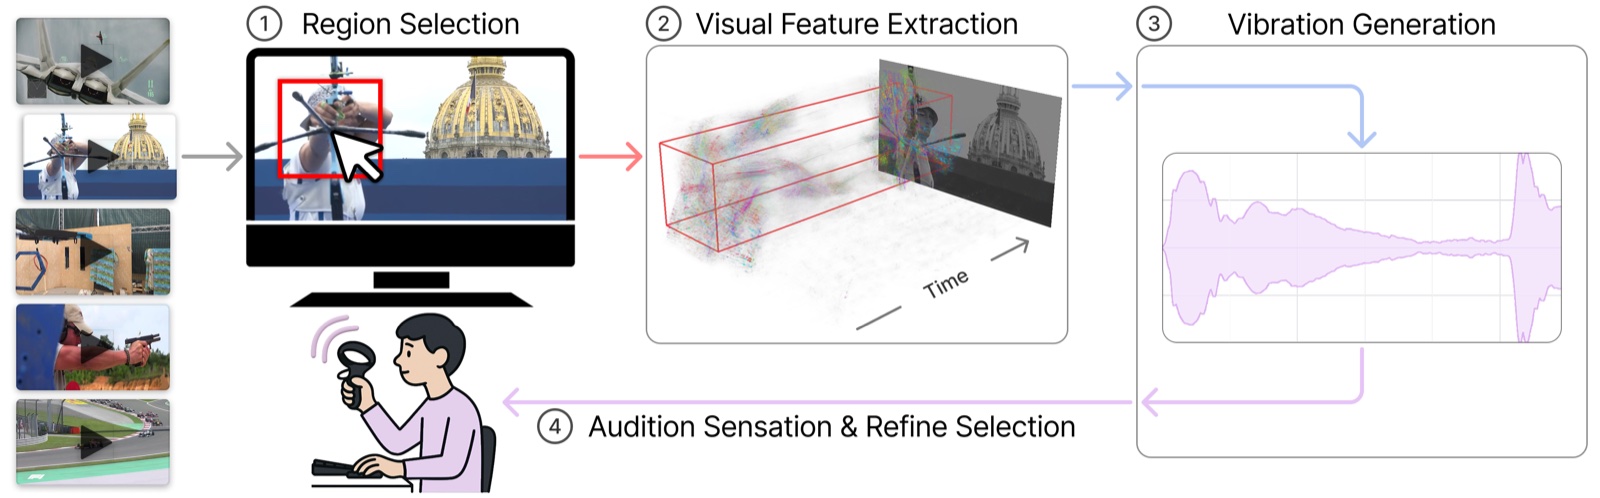
HapticLens
動画の好きな部分を選ぶと、その映像の細かな動きから振動(触覚)を自動生成してくれるオーサリングツール。たった1個の振動子で映像に触感を付けられる(CHI 2026、コードMIT公開)。
アリゾナ州立大学(Hasti Seifi 研究グループ) / GitHub
#HCI/MediaArt#CreatorTools
ACE-Step 1.5
歌詞とジャンル指定から、ボーカル入りの楽曲を丸ごと生成するオープンソースの音楽AI。自分のPCで動き、A100なら1曲を数秒で作れる(MITライセンス、GitHubスター1.1万超)。
ACE Studio / StepFun(ace-step) / GitHub
#Audio/Music#CreatorTools#AI/Agents
OBSIDIAN Neural
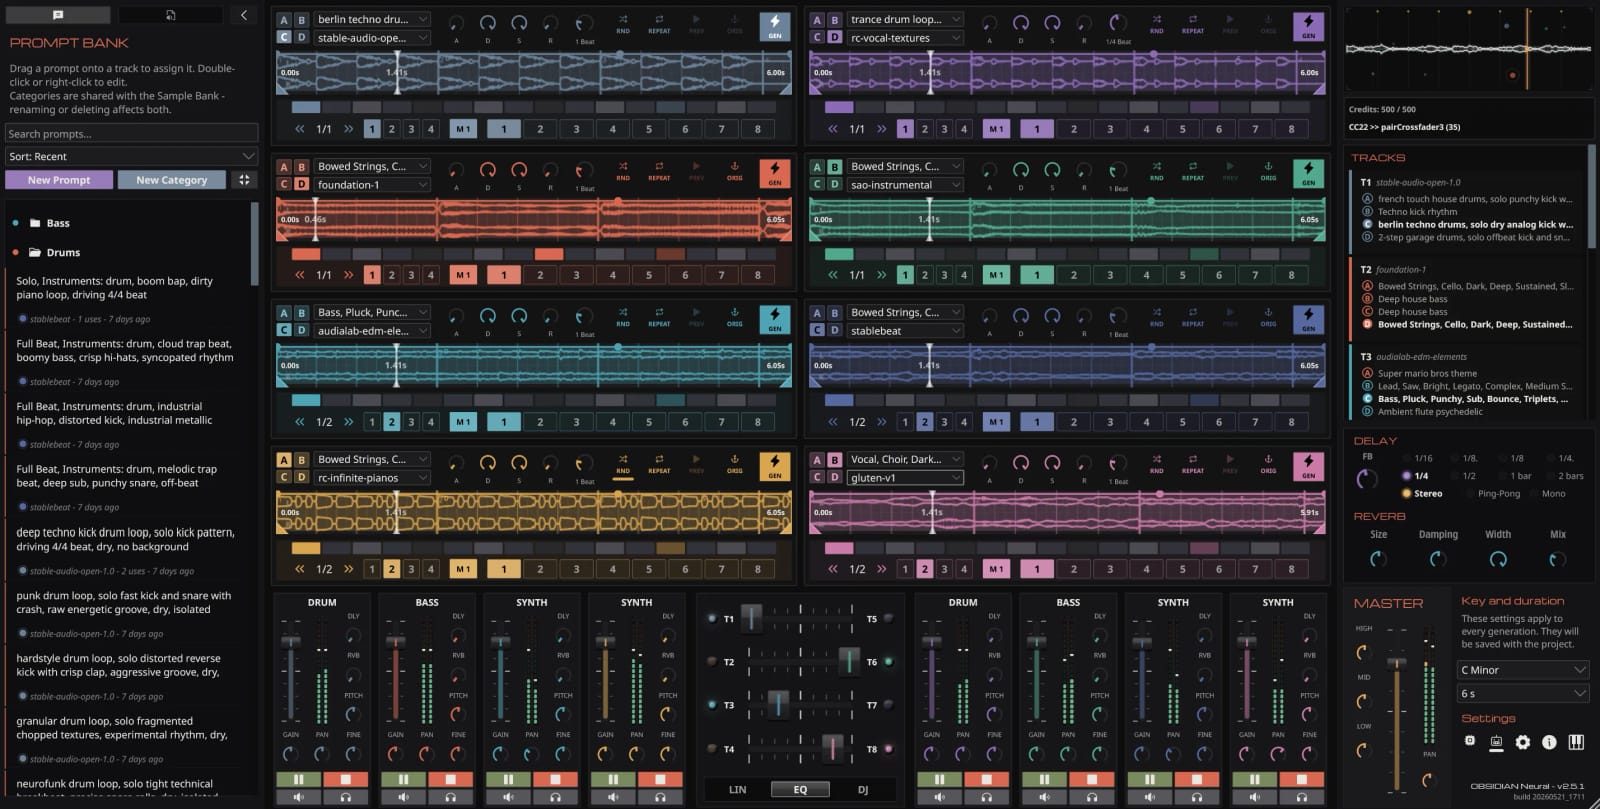
AIがその場でループ音源を生成する、ライブ演奏向けのオープンソース楽器(VST3/AU対応、プラグイン本体はAGPL-3.0でGitHubから無料ダウンロード可)。8トラックのサンプラーとして、MIDIやAbleton Linkと同期して即興演奏できる。ただしAI生成機能はクラウド版が月20クレジットまで無料でそれ以降は月額課金制。
InnerMost47(Anthony Charretier・個人開発) / GitHub
#Audio/Music#CreatorTools#HCI/MediaArt
LTX-2
Lightricksが2026年1月にオープンソース化した、音声と映像を同時生成できる初の公開基盤モデル。ネイティブ4K・50fps・最長20秒、重みから学習コードまで全公開。
Lightricks / GitHub
#GenVideo
OpenMontage
Claude Code等のAIコーディングアシスタントを「映像制作スタジオ」に変えるエージェント型動画制作システム。リサーチ→脚本→素材生成→編集→完パケまで自動化。公開3ヶ月で3万スター超。
Calesthio AI Labs / GitHub
#GenVideo#CreatorTools#AI/Agents
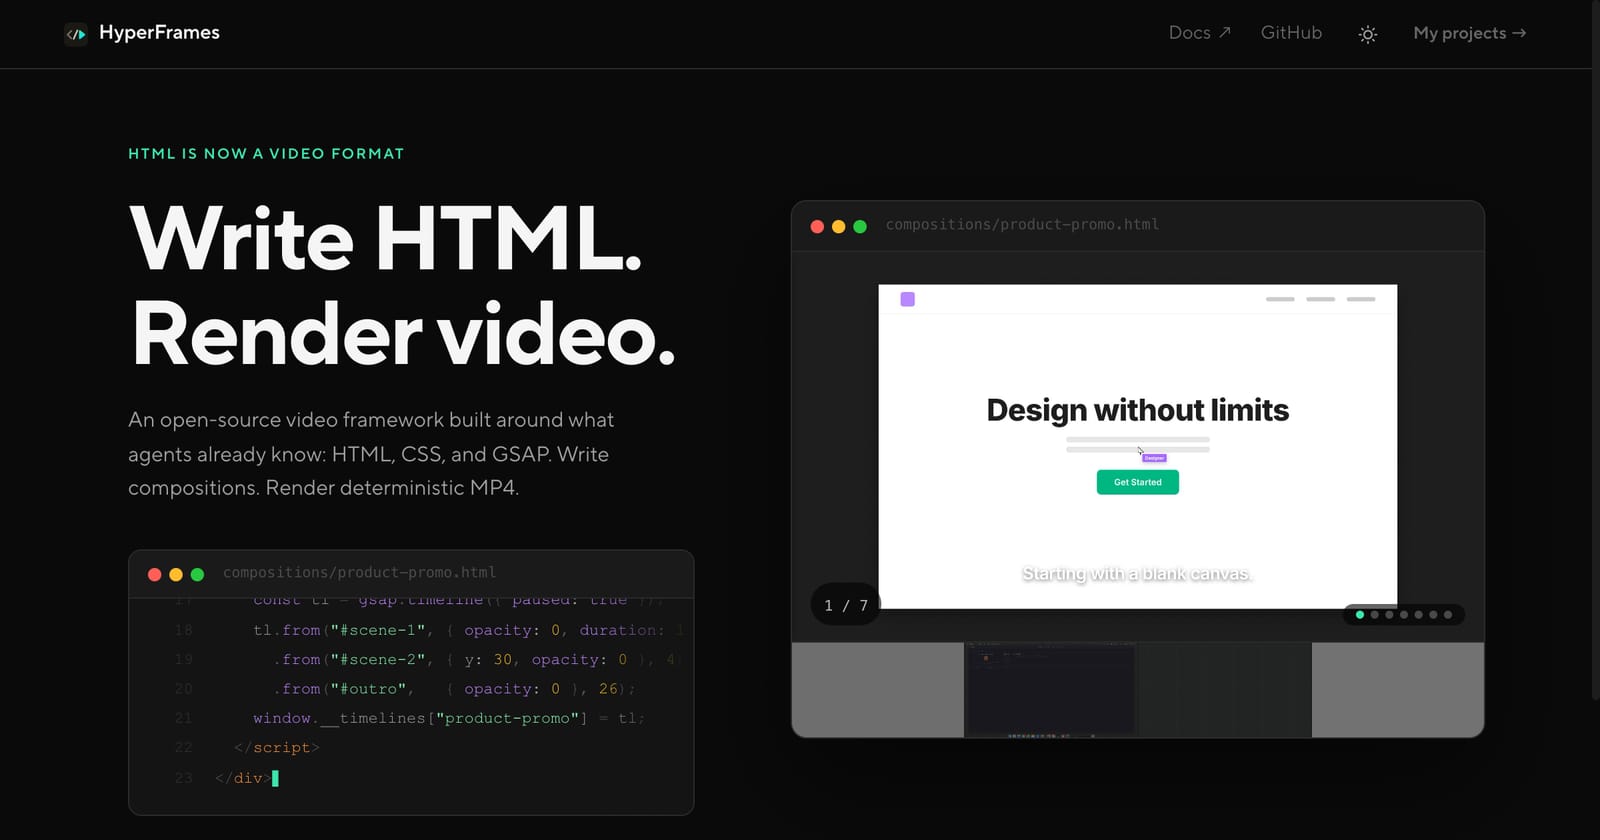
HyperFrames
AIアバターのHeyGenが公開した「HTMLを書けば動画になる」オープンソースフレームワーク。AIエージェントが動画制作できるよう設計され、用途別の20スキルを同梱。3.2万スター。
HeyGen / GitHub
#CreatorTools#AI/Agents
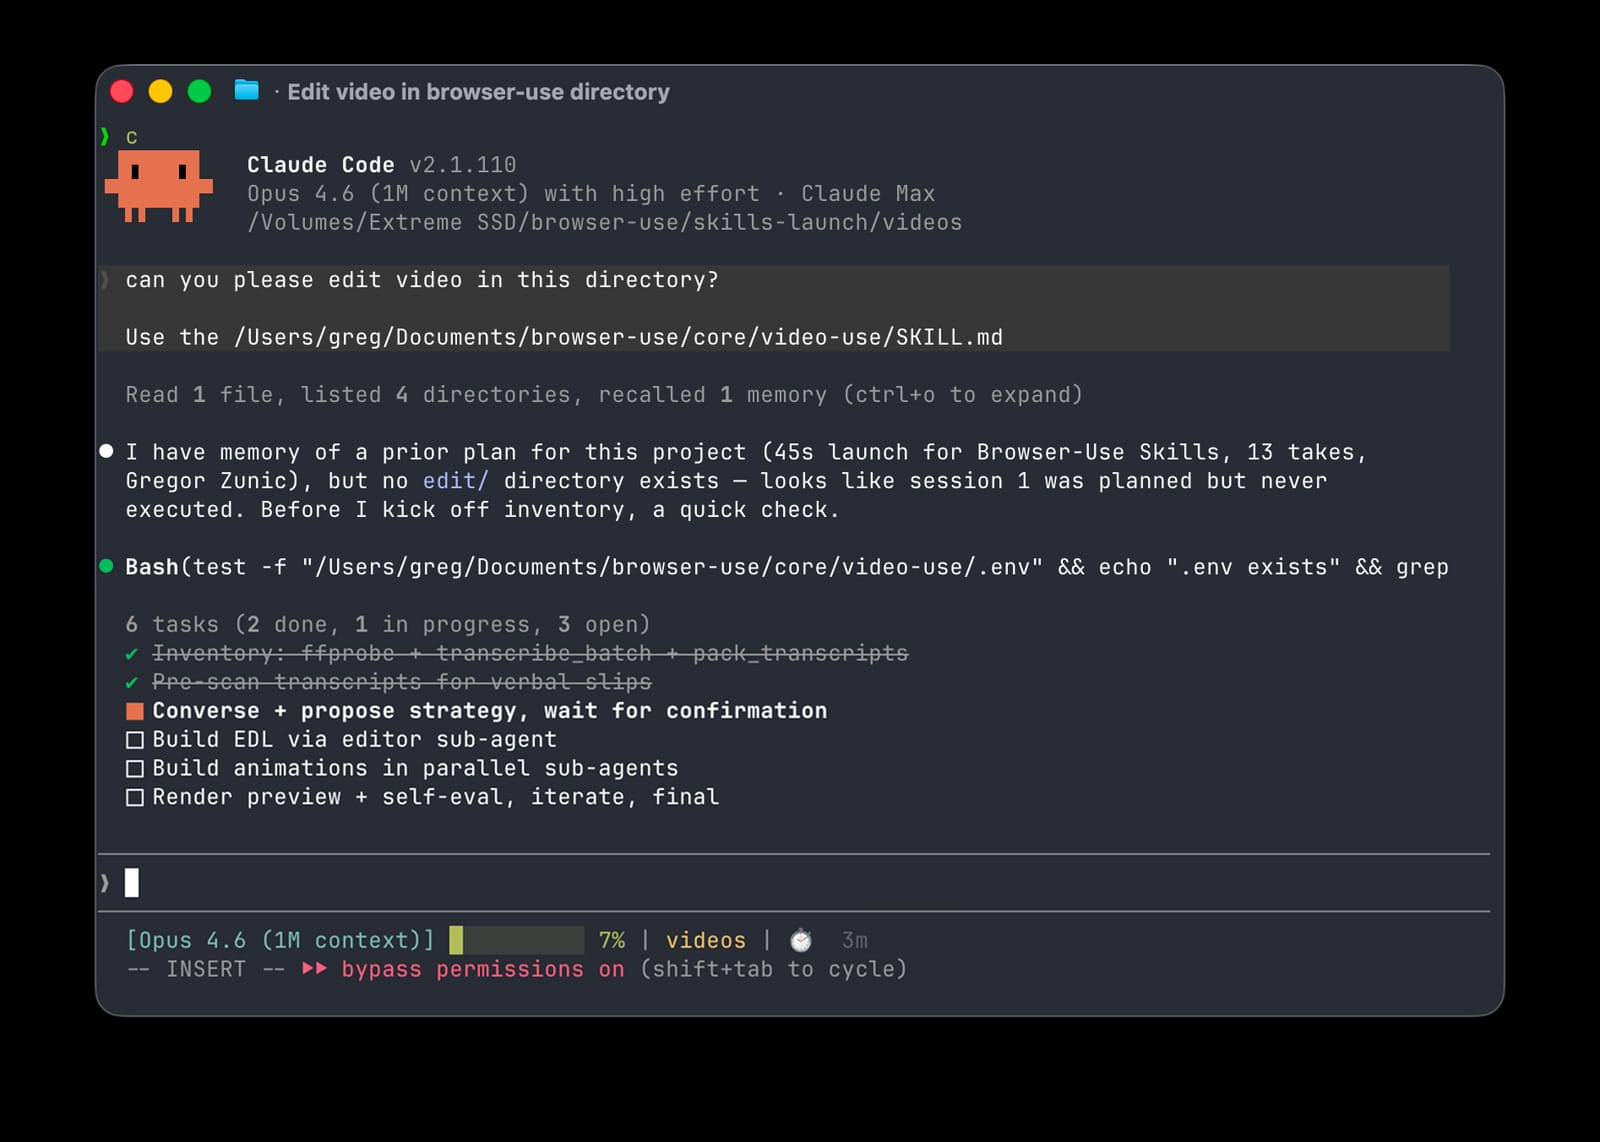
Video Use
ブラウザ操作AIで知られるbrowser-useチームによる「コーディングエージェントで動画編集」ツール。素材フォルダを渡してチャットで指示すると、フィラー除去・カラグレ・字幕入りのfinal.mp4が返る。
Browser Use / GitHub
#CreatorTools#AI/Agents
StableGen v0.3
Blender内で生成AIテクスチャリングと3Dアセット生成を完結させるオープンソースアドオン。2026年のv0.3系でTRELLIS.2による画像→3Dメッシュ生成とPBRマテリアル出力に対応。
sakalond(個人開発・OSS) / GitHub
#CreatorTools#Spatial/3D
VideoAgent
香港大学HKUDSによる、動画の「理解・編集・リメイク」を1つの対話型エージェントに統合したオープンソースフレームワーク。論文・コードを2026年6月に公開。
HKUDS(香港大学 Data Intelligence Lab) / GitHub
#GenVideo#CreatorTools#AI/Agents
Any4D
RGB動画に加えRGB-D・IMU・レーダーなど任意のセンサ入力から、実寸スケールの動く3D世界(メトリック4D)を1回の推論で復元するフィードフォワードモデル。
Carnegie Mellon University (AirLab) / GitHub
#Spatial/3D
Multi-View Foundation Models
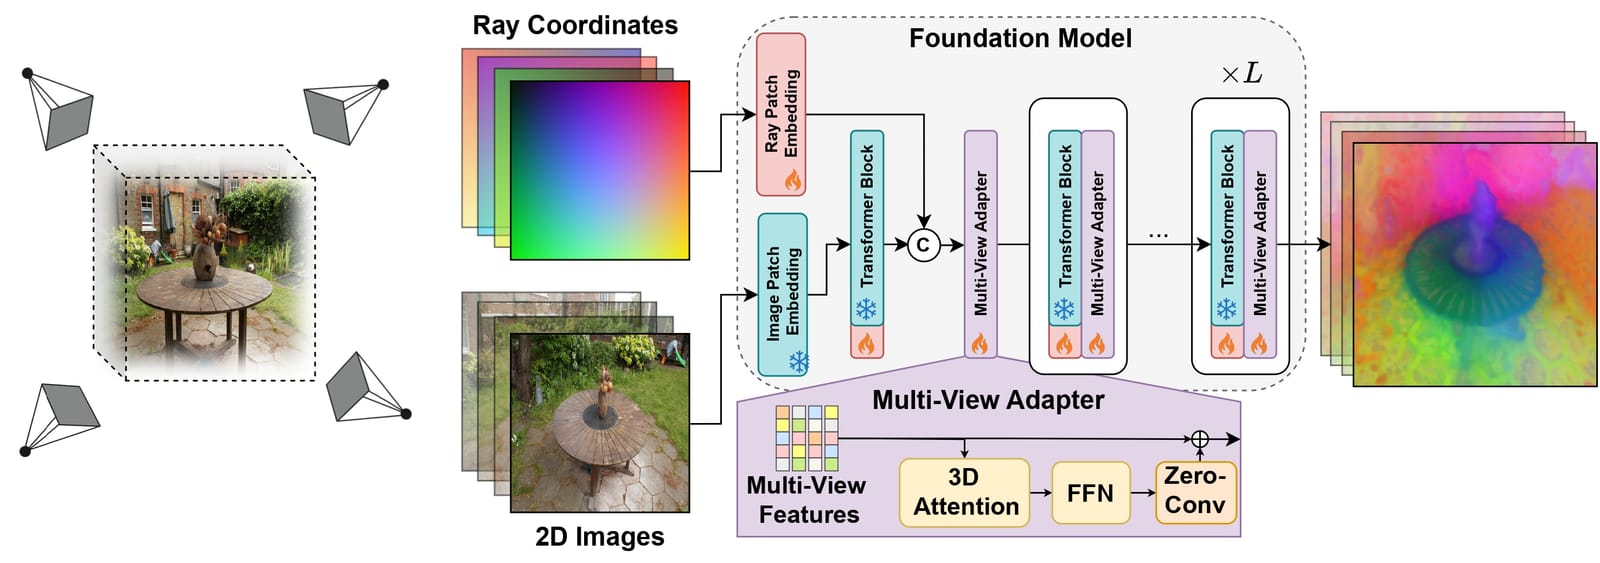
DINO・SAM・CLIPなどの2D基盤モデルに「マルチビュー空間アダプタ」を挿入し、明示的な3D再構成なしで視点間一貫の特徴を出せるようアップグレードする汎用フレームワーク。
テルアビブ大学 / GitHub
#Spatial/3D
ArtiFixer
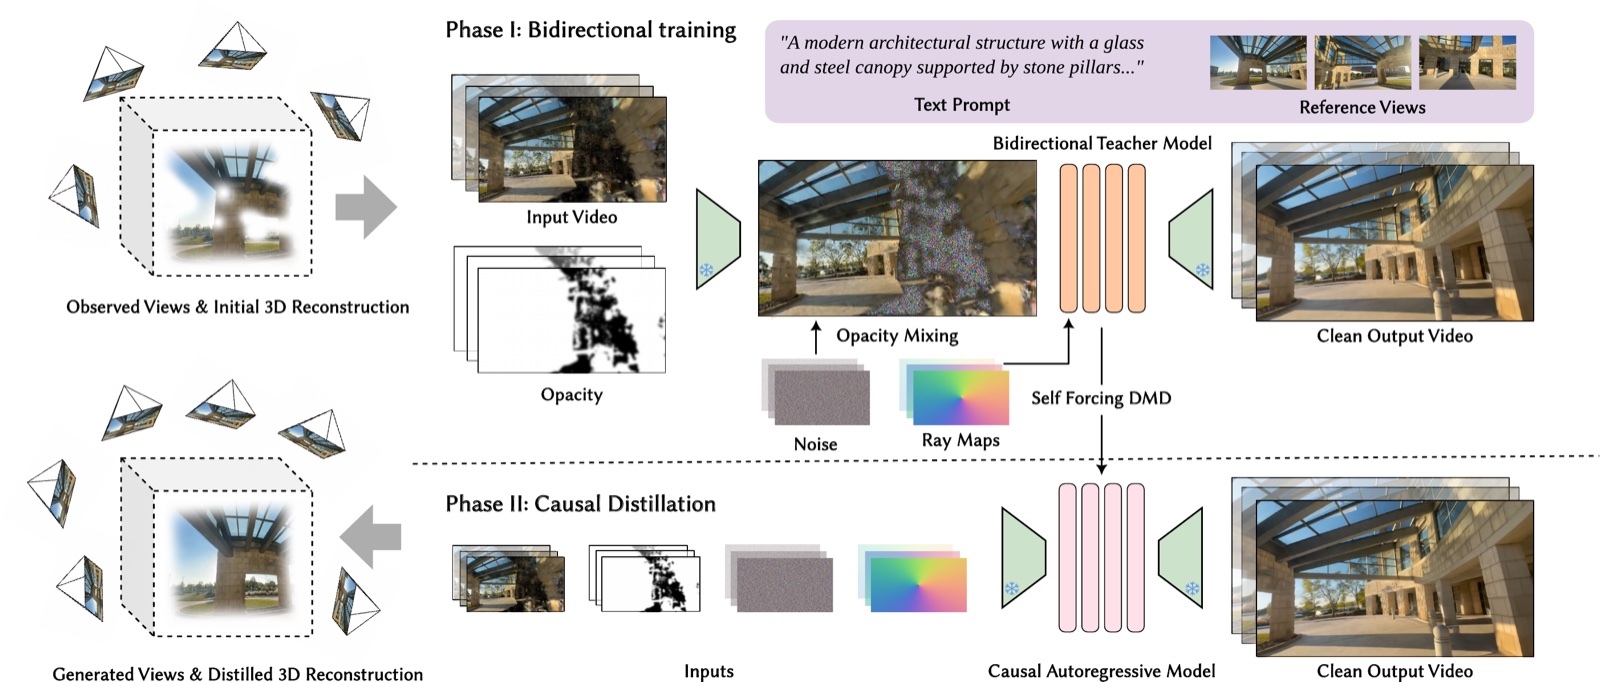
壊れた・ぼやけた3D再構成(Gaussian Splatting等)のレンダリングを、Wan2.1ベースの自己回帰ビデオ拡散モデルで綺麗に修復し、撮影していないアングルまで生成補完するNVIDIAの研究。SIGGRAPH 2026採択。
NVIDIA Spatial Intelligence Lab(ETH Zurich / Cornell / Univ. of Toronto 共同) / GitHub
#Spatial/3D#GenVideo
LingBot-Map
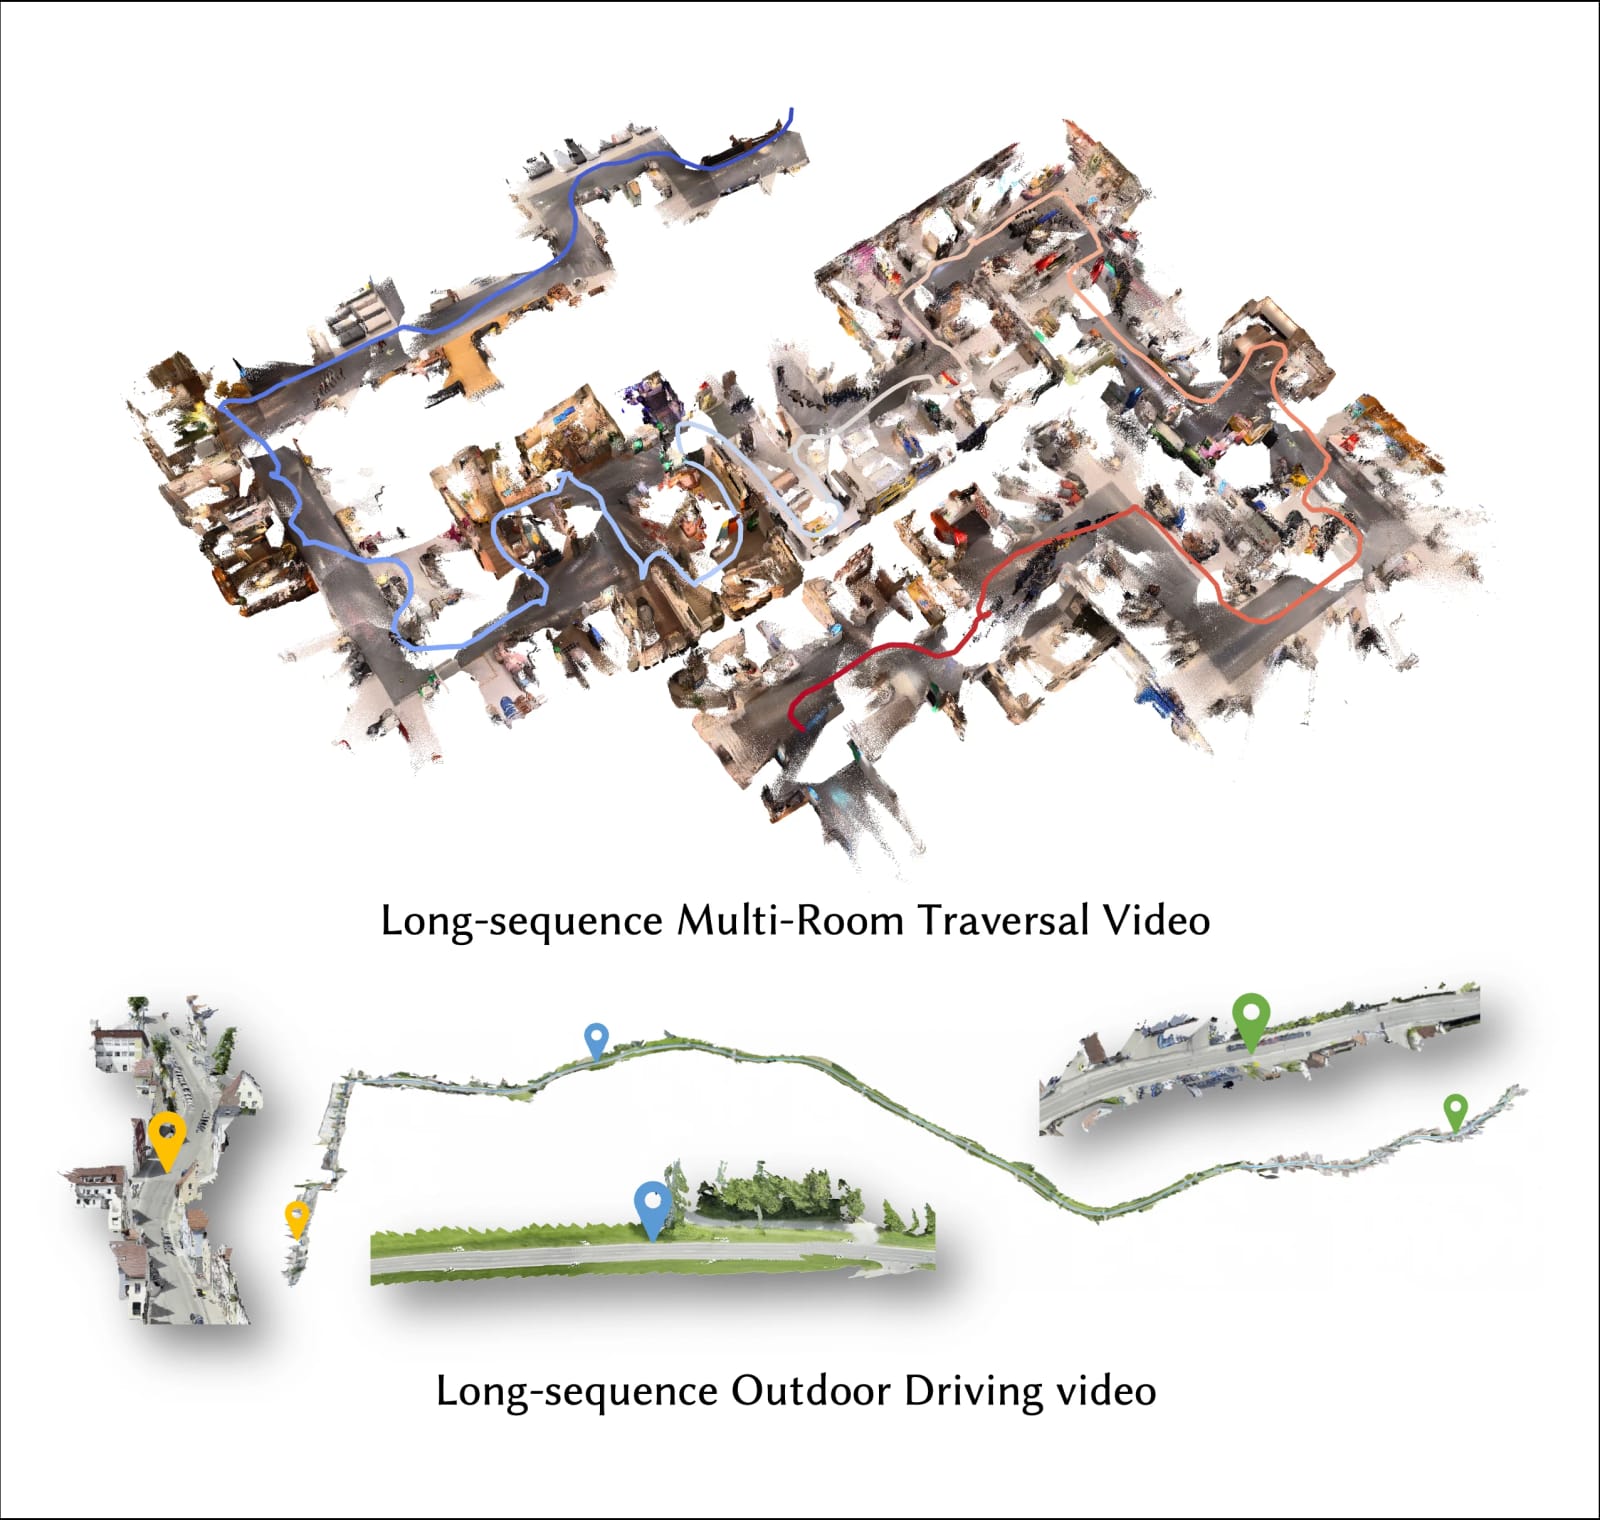
LiDAR不要・単眼カメラ映像だけで、シーンの3D形状をストリーミング(約20FPS)でリアルタイム再構成するフィードフォワード3D基盤モデル。1万フレーム超の長尺でもドリフト補正しながら動作する。
Robbyant(Ant Group系のロボティクス/身体性AI企業) / GitHub
#Spatial/3D
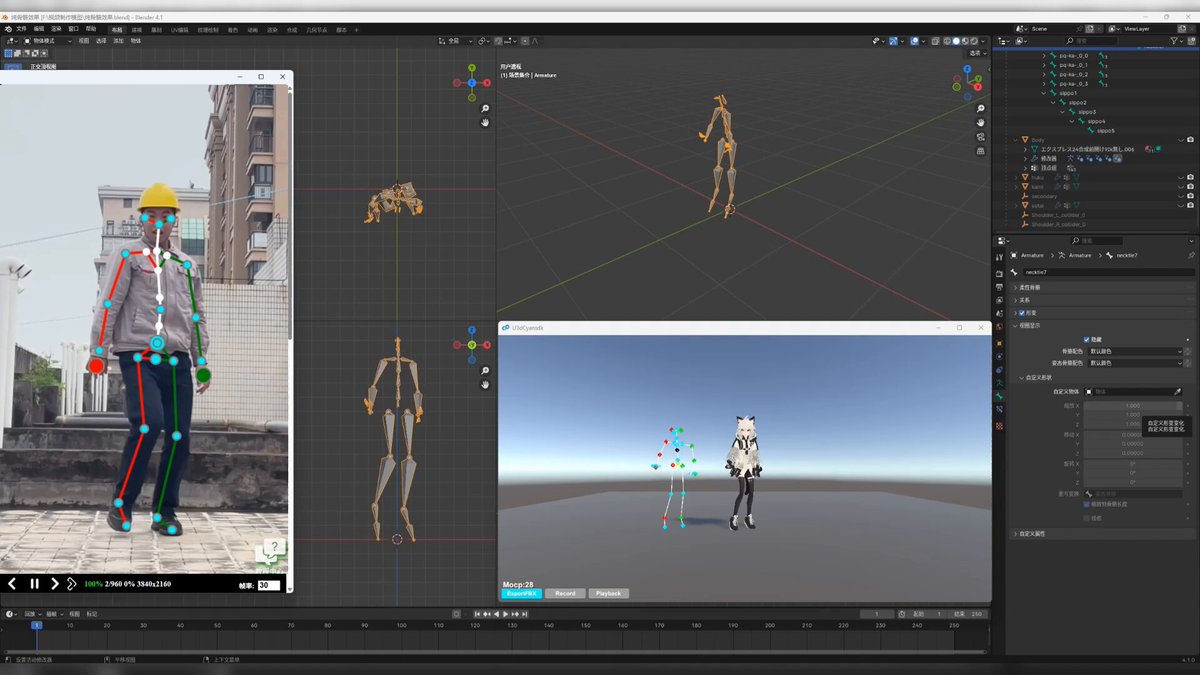
CYANPUPPETS 1B-parameter AI Motion Capture
10億パラメータのAIモデルをローカル実行し、1080pウェブカメラ2台または動画アップロードから全身33点+顔140点+指を含む208キーポイントをリアルタイム抽出するマーカーレスモーションキャプチャ。UE/Unity/MetaHuman等に対応。
CyanPuppets
#Motion/Body#CreatorTools
SpheRoPE
学習済みDiffusion Transformer(FLUX、LTX-2.3等)の位置エンコーディングに球面幾何の事前知識を注入し、追加学習ゼロで継ぎ目のない360°パノラマ画像・動画を生成するzero-shotフレームワーク。
Amazon Prime Video × Tel Aviv University × Hebrew University of Jerusalem / GitHub
#GenVideo#Spatial/3D
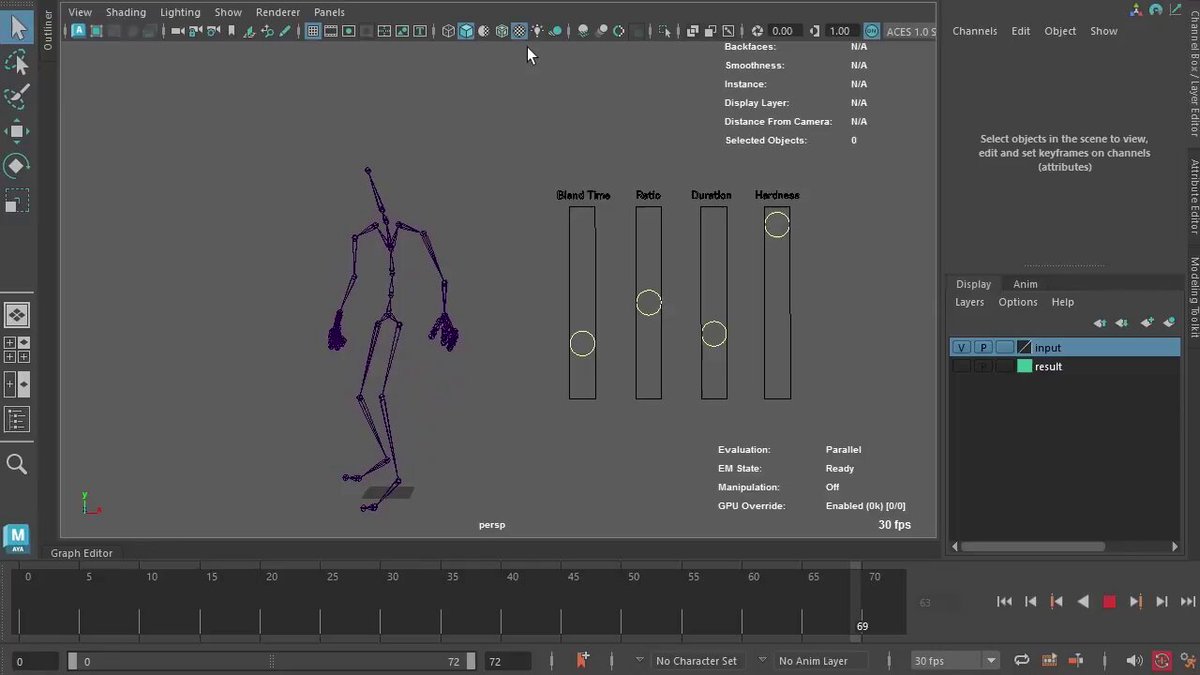
C1連続 in-loop-out モーション生成ツール
モーションキャプチャの任意区間から、開始・終了のポーズと速度まで一致するC1連続のループアニメーション(in→loop→out)を自動生成する個人開発ツール。差分をinertializationで上乗せする方式。
あかさき(個人・テクニカルアーティスト) / GitHub
#Motion/Body#CreatorTools
EditAnything (LTX-2.3 Video Edit LoRA)
動画生成モデルLTX-2.3をプロンプト指示型の動画編集モデルに変えるLoRA。背景/被写体の除去、モーション転写、要素の置き換え等をテキスト指示で実行できる。重み・ComfyUIワークフロー付きでHugging Face公開。
Alissonerdx(個人開発者)
#GenVideo#CreatorTools
AURORA Film Lab v1.0
55種のフィルムで実際に撮影した1,440枚の写真を計測・比較した実測データから選抜した12種のルックを混合し、独自のフィルム調カラーを作れるDaVinci Resolve用グレーディングツール。Randomize機能で1,440通りの組み合わせを探索できる。
D.Daniel(個人・フィルム/カラーグレーディング専門)
#CreatorTools
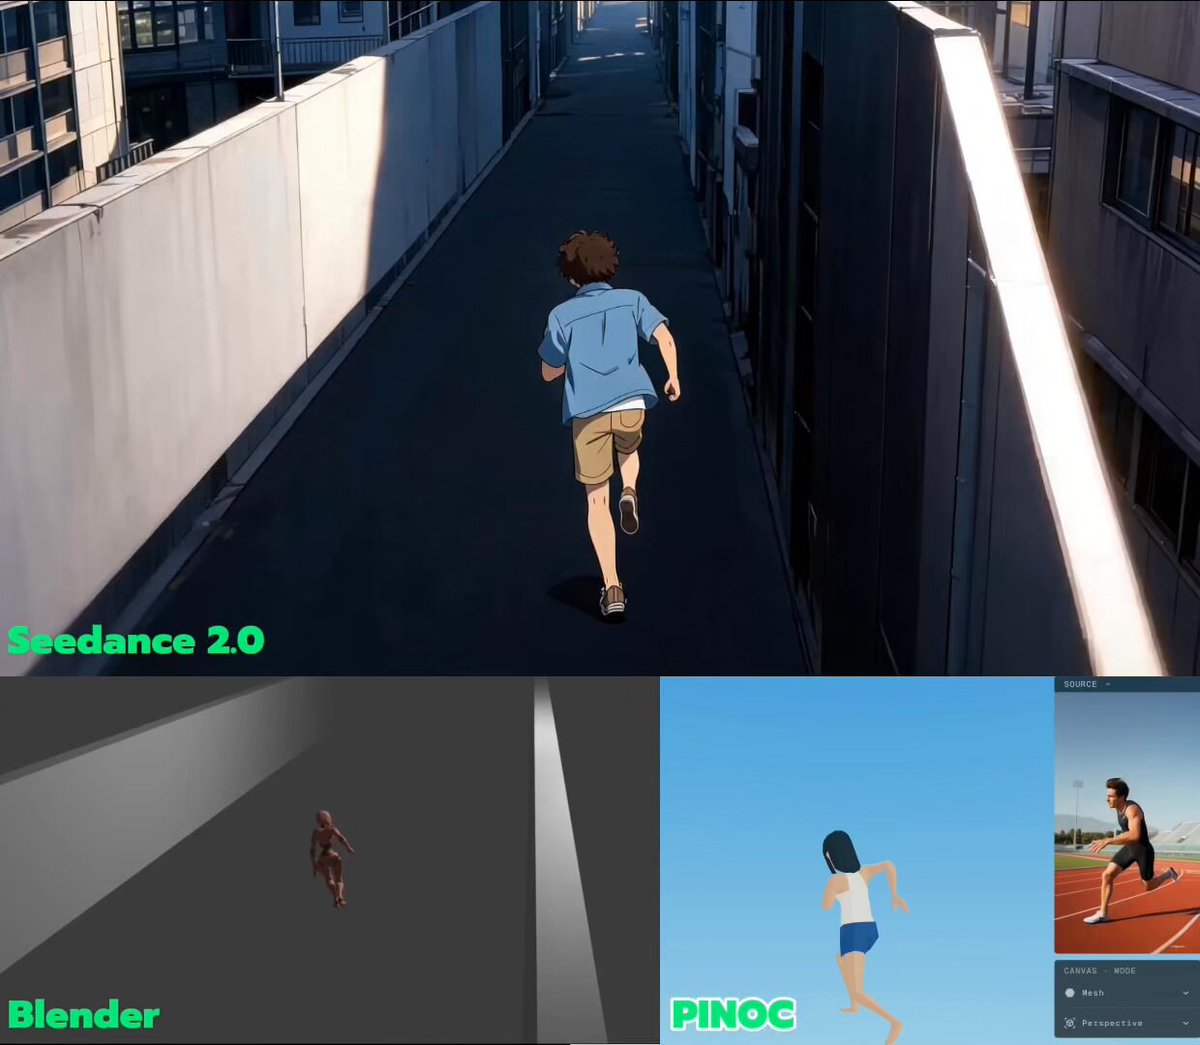
Viggle PINOC × Seedance ワークフロー
Viggleの無料ツールPINOC(動画→モーキャプ抽出+画像1枚からGaussian Splattingキャラ生成、FBX/GLB/BVH出力)で3Dプリビズを作り、Seedanceで最終映像化するワークフロー。手付けキーフレームゼロでチェイスシーンを構築。
Viggle AI
#Motion/Body#GenVideo
MetaHuman Animator マーカーレスMocap(UE 5.8)× AI再レンダリング検証
UE 5.8のMetaHuman Animatorに追加されたWebカメラ1台のマーカーレス全身Mocapを検証し、有料マーカーレスMocapを超える品質と報告。プレビズのモーションブラーがAI再レンダリング(Seedance 2.0)後の動画にも継承されるという発見を共有。
Epic Games(Mocap技術はMeshcapade提供)/検証: KakuDrop(個人クリエイター)
#Motion/Body#GenVideo
Splice MCP Server × Claude Cowork によるAIビートメイク検証
Spliceが公式提供するMCPサーバーをClaudeに接続し、自然言語の指示だけでDJプレミア風ヒップホップトラックを組めるか検証したYouTube動画付きポスト。
Splice/Anthropic/検証: DJ TAKI-SHIT
#Audio/Music#AI/Agents
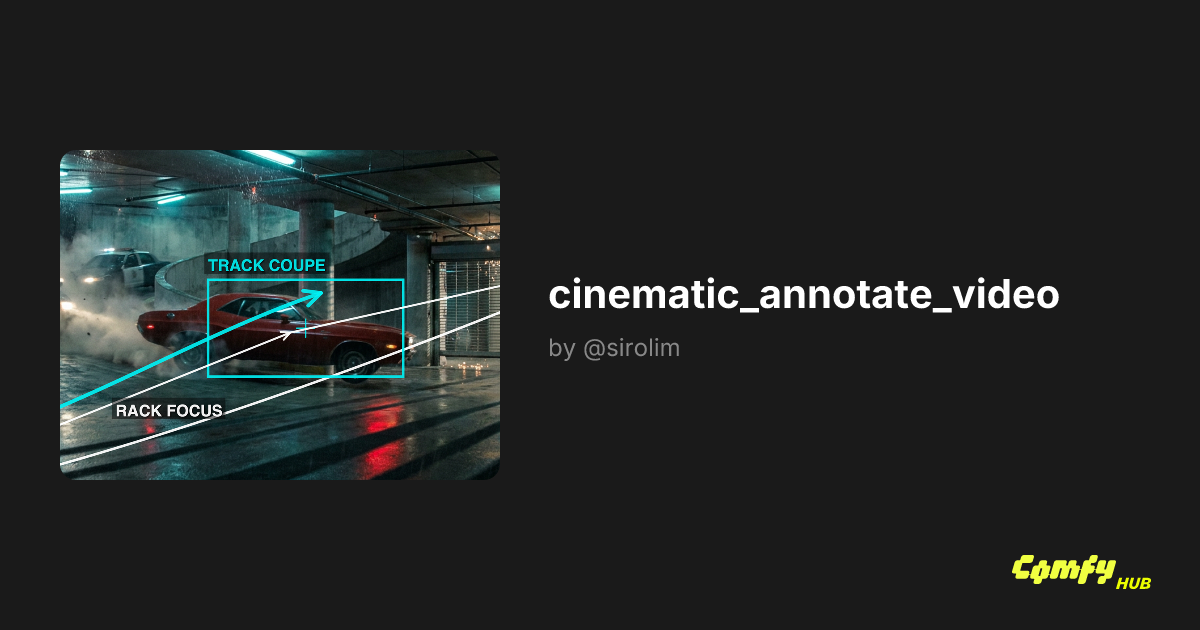
ComfyUI「Cinematic Annotate Video」ワークフロー
画像の上に線や注釈を描くだけでキャラの移動経路やカメラワークを指定でき、統合されたLLMがその描き込みをSeedance 2.0用のモーションプロンプトへ自動翻訳して動画を生成するComfyUIワークフロー。
Comfy Org/テンプレート作者: Sirolim
#GenVideo#CreatorTools
Rerun × Booster Robotics K1
OSSの時系列マルチモーダル可視化ツールRerunで、ヒューマノイドK1がサッカーボールを蹴る動作のセンサ・3D状態をリアルタイムにロギング・可視化したデモ。
Rerun (rerun.io) / GitHub
#CreatorTools#Spatial/3D#Motion/Body