MolmoMotion
Allen Institute for AI (Ai2)/2026-06
Overview
1枚の画像と自然言語の指示だけで、物体の3D上の動き(数秒先までの軌跡)を予測するAi2の基盤モデル。ロボットの動作計画や動画生成の精度向上に使える。
技術のポイント
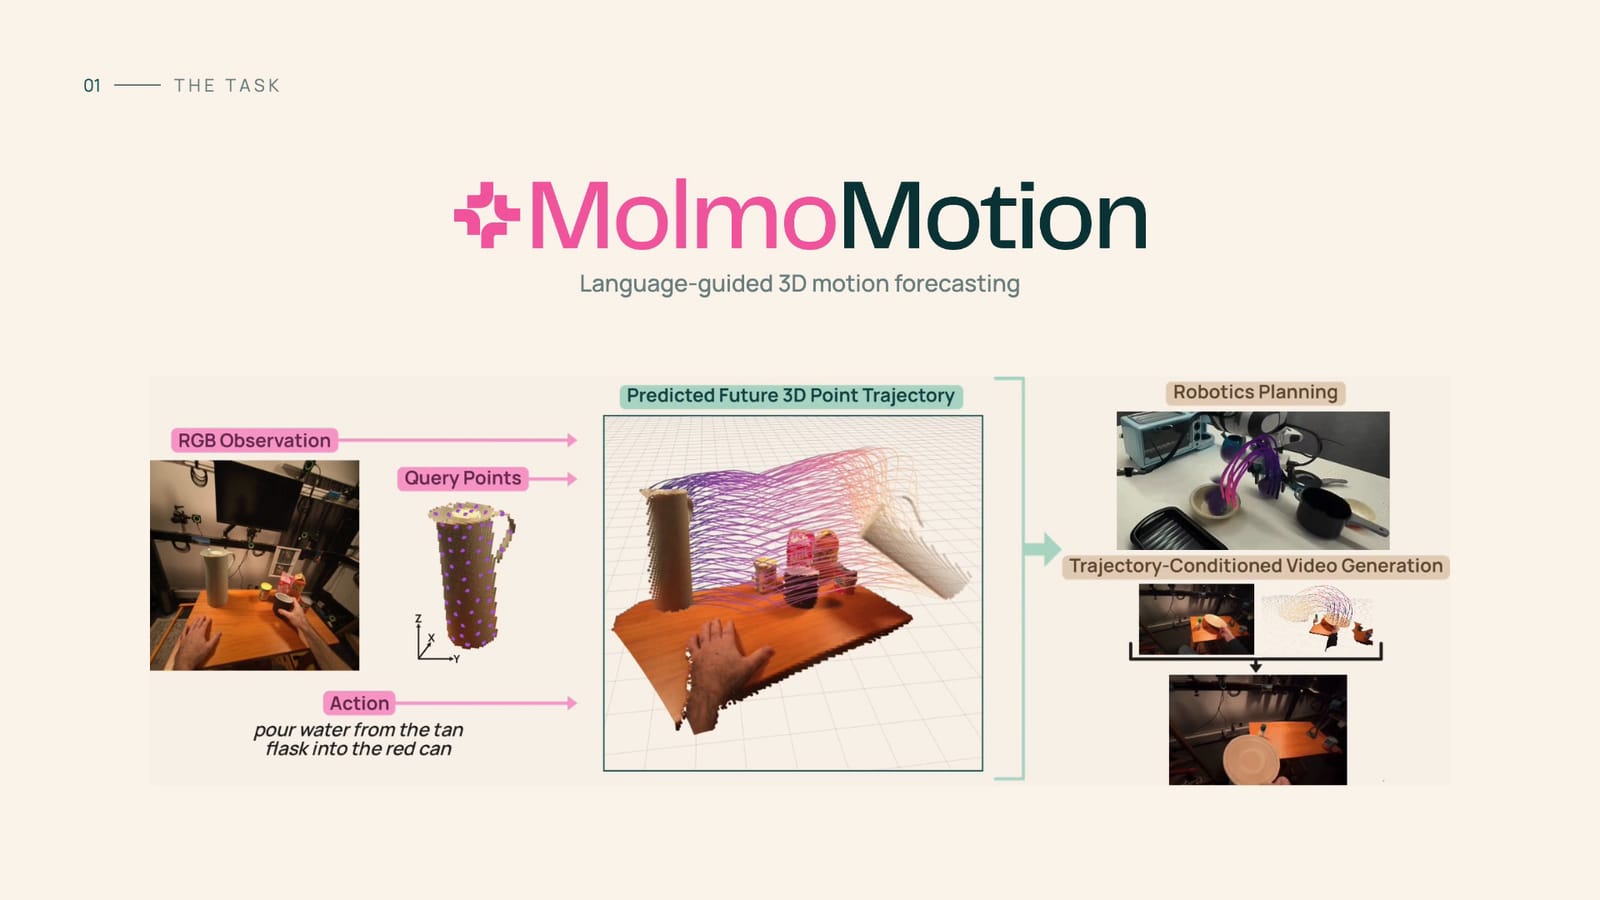
「このコップを持ち上げて」といった指示だけで、その物体が数秒後にどこへ、どんな軌跡で動くかを3D空間上に予測できるモデルです。これまでの動き予測は人体の骨格を前提にしたものが多く、道具や動物、様々なカメラ視点には応用しにくいという課題がありました。MolmoMotionは特定の形状に縛られない汎用的な「点の軌跡」として動きを表現するため、ロボットの腕が物を掴む動き、動物の動き、一人称視点でのモノの操作まで同じ枠組みで扱えます。実験では、この予測結果をロボットの行動計画に組み込むと成功率が大幅に向上し、動画生成AIに「この物体はこう動く」という道しるべとして与えると、生成される映像の動きの自然さも上がったと報告されています。広告・体験制作の視点では、演者やモノの動きを指示文だけで事前にシミュレーションし、CG合成や自動生成映像の「振り付け」の下描きとして使えるヒントになりそうです。
技術の詳細
MolmoMotionは、1枚の画像・その画像上でマークした3Dの点・「持ち上げる」などの動作を説明する文章の3つを入力として受け取り、その点が数秒間でどう動くかを3D空間上の軌跡として出力します。土台には視覚と言語を統合的に理解するAi2の基盤モデル「Molmo 2」を使い、軌跡をテキストのような座標列として段階的に予測する版と、ノイズから軌跡を生成する拡散モデル的な版の2種類が用意されています。学習には116万本の動画から抽出した大規模な3D軌跡データ(MolmoMotion-1M)を使い、736種類の動作・5,600種類の物体をカバーしています。 多くの動き予測モデルは人体の骨格モデルなど特定の「型」を前提にしていたため、道具や動物、複雑な変形をする物体の動きは苦手でした。MolmoMotionは物体に貼り付けた「点」だけで動きを表現するため、対象の種類やカメラの視点が変わっても同じ仕組みで扱えます。検証用に新設されたベンチマーク「PointMotionBench」(2,700本の動画・111カテゴリの物体・61種類の動作)では、ロボットの模擬ピック&プレース作業の成功率が既存モデルの56.0%から76.3%まで向上したと報告されています。 コード・学習済みモデル・評価スクリプトはGitHubとHugging Faceで無償公開されており(Apache-2.0ライセンスで商用利用も可能)、GPU環境があれば自分の画像や動画に対して動き予測を試せます。ロボット実機は不要で、動画生成AIと組み合わせて「物体の動線」を指定する用途であれば、映像制作のワークフローに組み込むことも可能です。
License
コード・モデルともApache-2.0で商用利用可