Minimax H3 Latent Upscaler
LBH-123-AI(コミュニティ開発)/2026-08
Overview
MiniMax H3が動画を生成する際の内部データ(潜在表現)を、映像に戻さず直接高解像度化するComfyUI拡張ノード。
技術のポイント
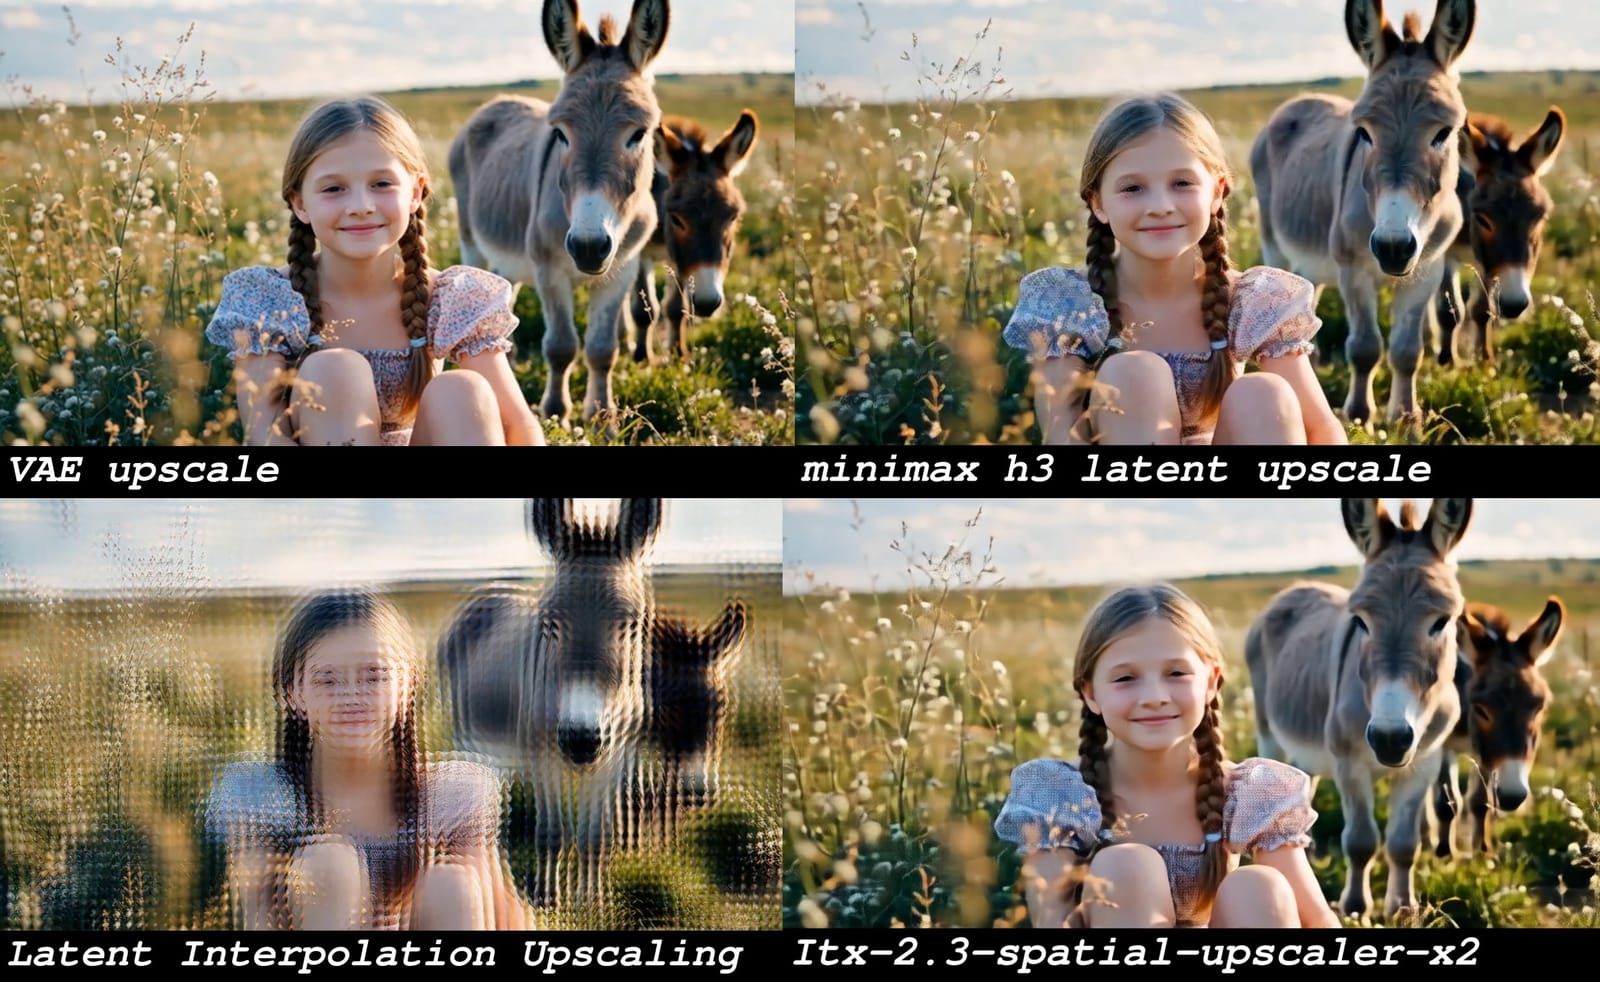
生成AI動画モデル「MiniMax H3」は、いったん動画をピクセルの映像に「現像」してから拡大する処理(VAEデコード)が非常に重く、50億パラメータ規模の計算が必要なため、高解像度化のたびに時間とGPUメモリを大きく消費していました。このツールは、その「現像」工程を経る前の圧縮データ(潜在表現)の段階でニューラルネットワークが直接拡大処理を行い、そのまま高解像度側の生成に引き渡します。現像・拡大・再エンコードという重い往復作業を一回スキップできるため、同じ品質の高解像度動画をより短い待ち時間で作れるようになります。広告や実験映像の制作で「ラフ解像度で構図やタイミングを何パターンも試し、決まったカットだけ高解像度化する」という高速イテレーションのワークフローに向いており、量産的なバリエーション出しが必要な案件で制作サイクルを縮められる可能性があります。
技術の詳細
仕組み: 動画生成AIは実際の映像(ピクセル)を直接いじっているのではなく、内部では圧縮された「潜在表現(latent)」という数値の塊を操作しています。たとえるなら、写真そのものではなく圧縮されたZIPファイルの中身を直接編集するようなものです。従来はこの潜在表現をいったん映像に「解凍」(デコード)し、映像として拡大し、また潜在表現に「圧縮」し直す(エンコード)という3段階が必要でした。MiniMax H3はこの解凍・圧縮を担う部品(VAE)が約50億パラメータと非常に大きく、ここが処理時間のボトルネックでした。本ツールはこの往復を省き、圧縮されたままの状態を専用に学習したニューラルネットワークで直接拡大します。 従来との違い: 単純な引き伸ばし処理(バイリニア/バイキュービック補間)を潜在表現に対して行うと輪郭が二重になる「ゴースト」現象が起きやすいのですが、本ツールは動画クリップと静止画あわせて約8万件のペアデータで学習済みのため、そうした破綻が起きにくいとされています。空間方向のみ拡大する軽量な2D版と、時間方向の滑らかさも保つ3D版の2種類が用意されています。 使うには: ComfyUIとMiniMax H3の生成環境が前提で、GitHubからノードを導入し、Hugging Faceで配布されている学習済みモデル(容量700MB〜1.4GB)を所定のフォルダに置くだけで使えます。追加費用はかかりませんが、VRAM使用量は「高解像度をそのまま生成する場合とほぼ同等」で、あくまで時間短縮が主なメリットです。
License
学習済み重み(Hugging Face配布分)はApache-2.0。GitHub本体には別途LICENSEファイルの明記なし
Sources
Related Works
- ComfyUI-H3-FaceRefine
同じMiniMax H3動画の顔だけを後処理で精細化する別ノード
- rockerBOO/h3-latent-upscaler
同じ課題(2パス間の潜在表現アップスケール)に取り組む別実装