FastH3 (FastVideo FastH3 8-Step V2)
Hao AI Lab (UCSD) / FastVideo/2026-09
Overview
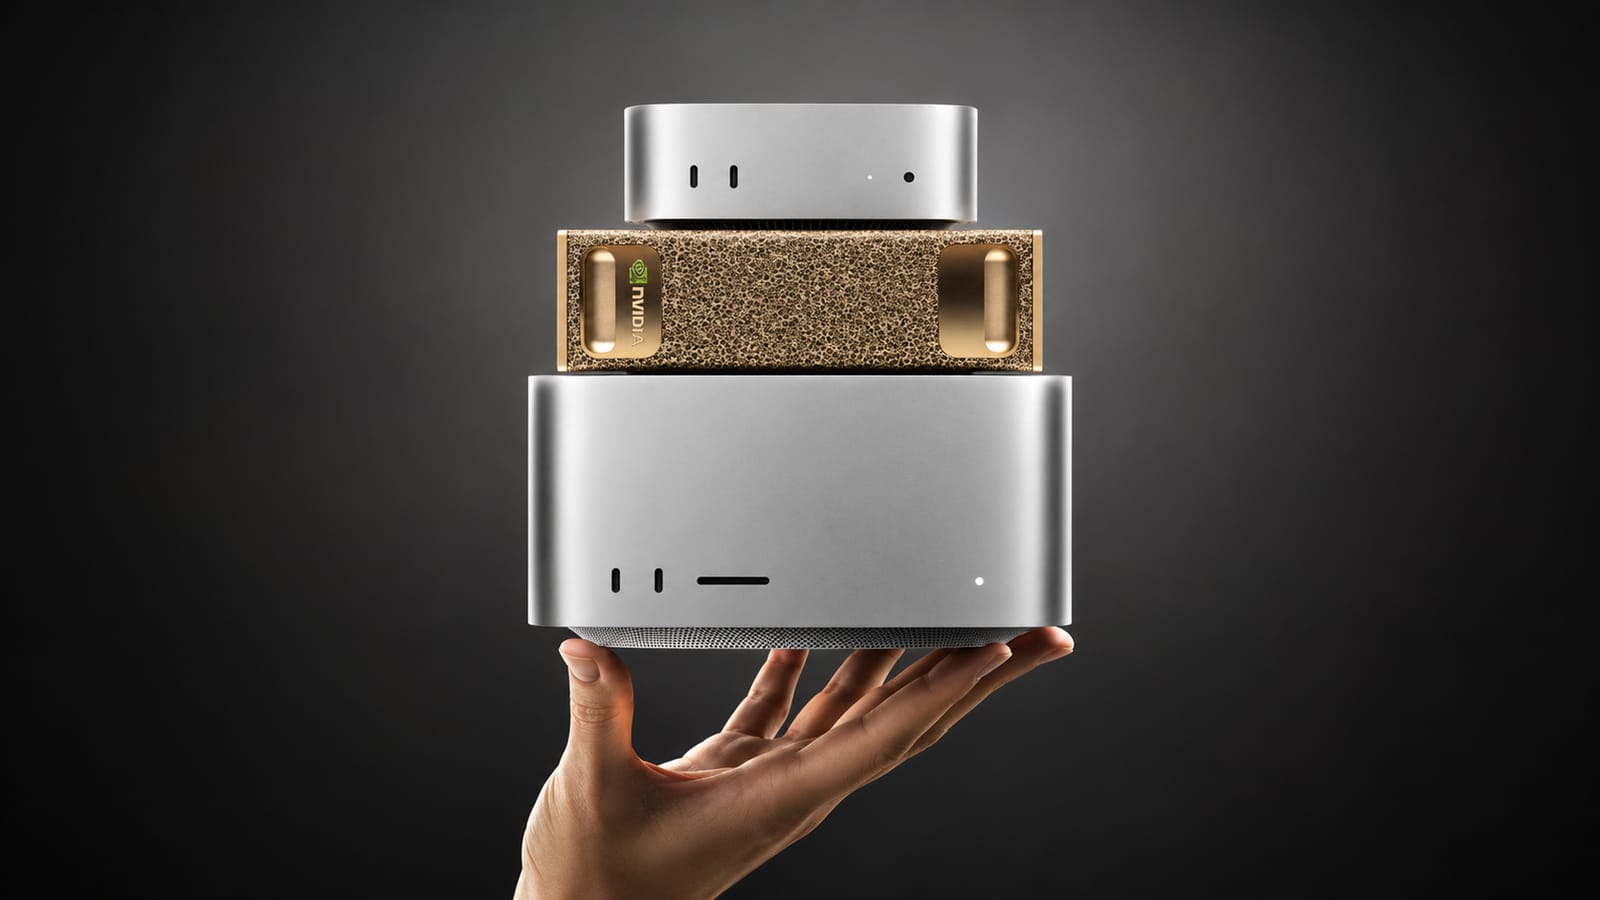
音声つきの動画生成モデルMiniMax H3を、わずか8ステップで動画と音声を同時に作れるよう蒸留(軽量化)した公開チェックポイント。ComfyUI v0.36.0から標準で使え、DGX SparkやM4 Max搭載Macなど手元の機材でも動かす手順が公開された。
技術のポイント
一番のすごさは「待ち時間の短さ」です。通常の動画生成は絵を何十回も描き直しながら仕上げますが、FastH3は8回の描き直しで映像と同期した音声(セリフや効果音)まで出します。料理でいえば、下ごしらえ済みの半調理品でスピード提供するイメージで、画質と動きの細かさは少し譲る代わりに試行回数を大きく増やせます。広告・体験づくりでは、絵コンテ段階で『この映像に、この声と音をつけたらどうなるか』を数十パターン試して方向性を決める、クライアント提案前のモーションスケッチ量産に向きます。イベント会場のその場でお客さんの一言から映像を作る体験や、社内プレゼン用のムード映像の即席作成にも使えそうです。最終納品はベースのH3で作り直す前提の「ラフ用エンジン」として位置づけると効果的です。
技術の詳細
仕組み:元のMiniMax H3(350億パラメータの大型モデル)が持つ『何十回も少しずつノイズを取り除いて映像にする』工程を、先生役のモデルの出力を生徒役に真似させるDMD2という蒸留手法で8回に圧縮しています。加えて、画面全体ではなく重要な部分だけを見るVideo Sparse Attention(VSA、80%スパース)で計算量を削っています。文字の理解や映像・音声の圧縮部品はH3のものをそのまま再利用するため、出力の作りは元モデルと揃います。 従来との違い:従来のH3は高性能な分、生成に数十ステップとデータセンター級GPUが必要でした。公式ブログによると、DGX Spark上でvLLM-Omni基準の7〜8倍の高速化、M4 Max(メモリ36GB以上)でも約456秒(INT6)で生成できたと報告されています。ただし動きや音の忠実度は元モデルより落ち、複数の参照素材を指定する機能(Ref2VA)は蒸留対象外で、text-to-videoとimage-to-videoのみです。 使うには:ComfyUI 0.36.0以上に、蒸留モデル・Qwenテキストエンコーダ・映像/音声VAEの4ファイルを置けばワークフローが動きます。モデルカード上の検証環境はB200 4枚ですが、ローカル版ガイドではDGX Spark(128GB統合メモリ)やApple Siliconを使う手順が案内されています。ライセンスは地域制限があるため、日本国内での利用可否と商用可否は導入前に確認が必要です。
License
MiniMax H3 Community Licenseに準拠。適用地域が限定され、米国・EU・英国・韓国ではローカル実行(および出力物の利用)が許諾されないと報じられている。案件で使う前に必ず原文を確認すること(第三者ブログの解説を根拠にしており、原文の全文は未確認)
Sources
Related Works
- MiniMax-H3(ベースモデル)
FastH3の蒸留元となる、映像と音声を同時生成する大型モデル
- FastVideo(推論・ポストトレーニング基盤)
動画生成を高速化する統合フレームワーク
- ComfyUI FastH3 ワークフロー例
ComfyUI公式のFastH3利用チュートリアル