AEON
Tsinghua University (Weiqi Zhang ら)/2026-10
Overview
テキストや1枚の画像から、動画ではなく「あとから自由な角度で見られる4Dの世界」(動く3D空間)を直接生成する世界モデル。
技術のポイント
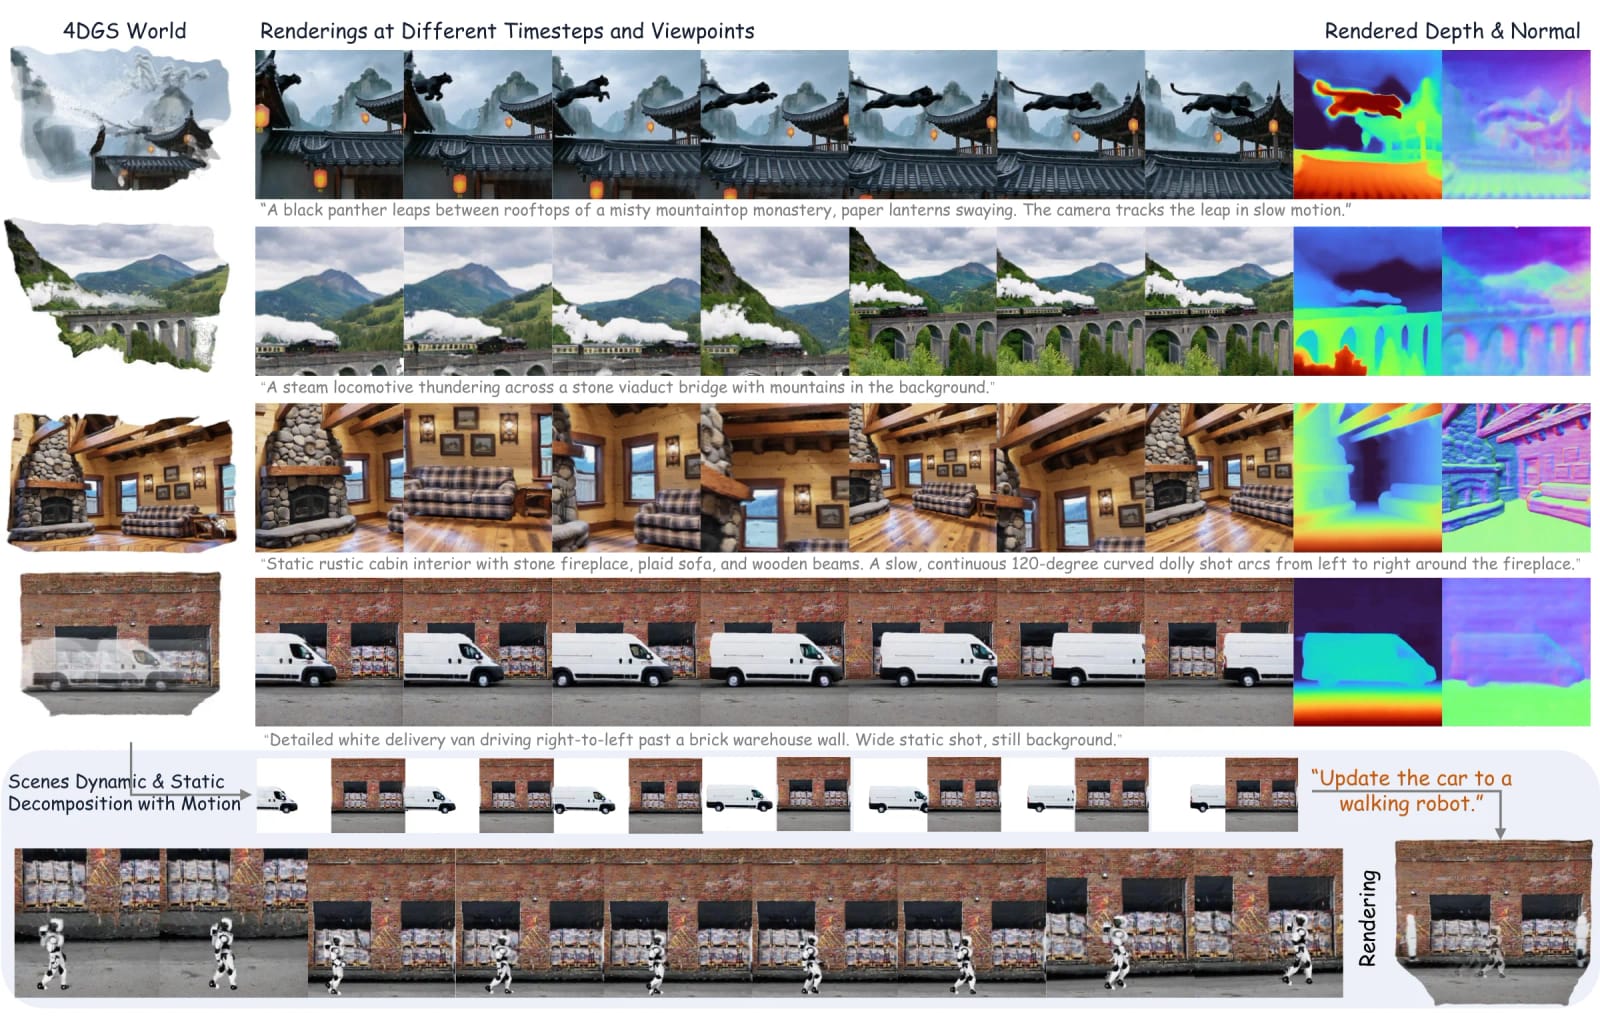
従来の動画生成AIは、出てきた映像を後から別の角度で見直すことができませんでした。AEONは動画生成モデル(Wan2.1)が内部で作る情報を、動く3D空間(4D Gaussian Splatting)に変換します。これにより、生成した世界を好きな時刻・好きなカメラ位置からリアルタイムに眺められます。深度や法線(面の向き)も一緒に出るため、後から編集もできます。例として、バンを歩くロボットに差し替える編集が示されています。広告・体験づくりでは、1枚のキービジュアルから「入り込める」空間を作る用途が考えられます。たとえばカメラを自由に動かせるMVの背景、店頭やイベントのインタラクティブ展示、コンテ段階でのカメラワーク検討などです。生成物が3Dなので、同じ世界から縦型・横型など複数のカットを切り出すこともできます。
技術の詳細
仕組み:まずテキスト(または画像とテキスト)から、Wan2.1が「動画の設計図」にあたる潜在表現(latent)を作ります。次に、学習済みの変換モデル(ドメインアダプタと4D再構成モデル)が、この設計図から画素ごとの動く3D点(4D Gaussian)と各フレームのカメラ位置を読み出します。最後にgsplatで描画します。動画を一度作ってから3D化する方法より、動画生成の知識をそのまま3Dに引き継げるのが特徴です。 従来との違い:動画モデル系は見た目は良くても3Dとして整合しません。3D生成モデル系は動きや多様さに弱いという課題がありました。AEONは両者を一つの流れにまとめ、動画の自然さと3Dの自由視点を両立しています。出力は動画ではなく4D Gaussian Splattingなので、レンダリング、編集、シミュレーションにそのまま使えます。 使うには:GitHubにCLI(aeon-generate)とPython APIがあり、デコーダ重み(3.3GB)はHugging Faceから取得します。Wan2.1のベースモデルは別途ダウンロードが必要です。必要なGPUメモリは大きく、READMEでは14Bモデルで約50GB(CPUオフロードあり)、1.3Bモデルでピーク約60GBです。個人PCでは動かしにくいため、クラウドGPUでの利用が現実的です。Pythonとコマンドライン操作のスキルが必要です。
License
AEON本体のコードはMIT。ベースのWan2.1はApache-2.0。同梱の第三者コード(aeon4d/_vendor/)は個別ライセンスなので、商用利用前にTHIRD_PARTY_NOTICES.mdを確認すること。