Jazz Pianist Style (Learning Jazz Pianist Style with Cross-Attention Conditioning)
Drew Edwards (Queen Mary University of London) / Akira Maezawa (Yamaha) / Simon Dixon/2026-10
Overview
ジャズピアニスト12人それぞれの「弾き癖」を学習し、指定した奏者らしい続きを作れるピアノAI。コード、学習済みモデル、デモページがすべて公開されている。
技術のポイント
「この人っぽい弾き方」を選んで、曲の続きを作らせられる点がすごい。ピアノの演奏データ(MIDI)で学習した既存モデルに、ピアニスト12人分の個性を表す小さな数値のかたまりを加えて、それを参照しながら音を作る仕組みだ。同じ曲の出だしでも、奏者を変えるとリズムの揺れや和音の選び方が変わる。広告や体験づくりでは、BGMを「誰らしいか」で指定する制作に使えそうだ。たとえば、ジャズ喫茶風のブランドムービーで奏者の雰囲気だけを変えた複数案を一気に作る、来場者の選んだ奏者で続きが生成される展示などが考えられる。生成されるのは音声ではなくMIDI(音符データ)なので、好きな音源で鳴らして手直しもできる。
技術の詳細
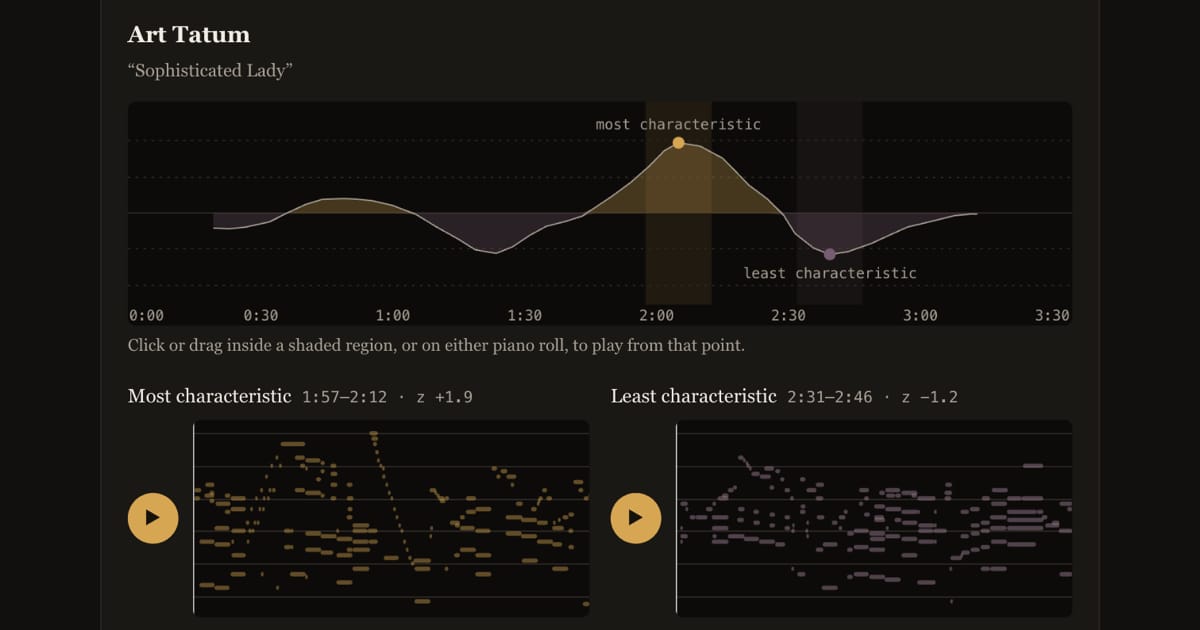
仕組み:土台は、ピアノ演奏のMIDIを大量に学んだ Aria という16層のモデル。ここへピアニスト12人分のソロ演奏(PiJAMAデータセット)で追加学習をした。さらに後ろ8層に「ゲート付きクロスアテンション」という仕組みを足している。これは、音を作るたびに奏者ごとの4つの数値(性格のメモのようなもの)をのぞいて参考にする部品だ。ゲートは、そのメモをどれだけ反映するかを調整する弁にあたる。 従来との違い:生成の良し悪しは、通常は予測の当たり具合(パープレキシティ)で測る。本件ではこの指標が条件の有無でほとんど変わらなかった。そこで、奏者を当てる分類器で、生成した演奏が狙った奏者に聞こえるかを測っている。結果は、条件なしの追加学習モデルで37%、条件ありで70%(事前学習のままだと25%)。生成物だけで学習した分類器でも、本物の録音を曲単位で95%の精度で当てられた。 使うには:GitHub に uv 用のロックファイルが付いており、Python 環境があれば再現できる。学習済みの生成モデルと分類器2つは Hugging Face Hub(drewbie/jazz-pianist-style-generator など)にある。デモページには、12人で同じ出だしを弾き分けた例や、奏者当てクイズもある。費用はかからず、GPU があれば手元で動かせる。ただしデモ音声は選別した例で、著者もそう注記している。
License
コードと学習済みモデルは Apache-2.0(ベースの Aria に合わせたもの)。同梱の cheston_dpi 部分のみ MIT。
Sources
Related Works
- LiveSynth
MIDIで演奏でき、楽器の音色を録音や文章から作るストリーミング型ニューラルシンセ(2026年10月、コード未確認)。
- Real-Time Interactive Music Generation via Data-Free Streaming Consistency Distillation
演奏者の入力にその場で反応できる、低遅延の音楽生成。
- DEMON: Diffusion Engine for Musical Orchestrated Noise
拡散モデルによる音楽・ノイズ生成エンジン。ライブデモ付き。