Prism(動的スパースアテンションによる2Kネイティブ映像+音声同時生成)
Fudan University / Tencent Hunyuan Foundation Model Team / Zhejiang University/2026-10
Overview
映像と音声を同時に作る生成AIを、2K(2560×1440)解像度で直接学習できるようにした動的スパースアテンション手法。訓練コード・推論コード・preview重みがMITで公開された。
技術のポイント
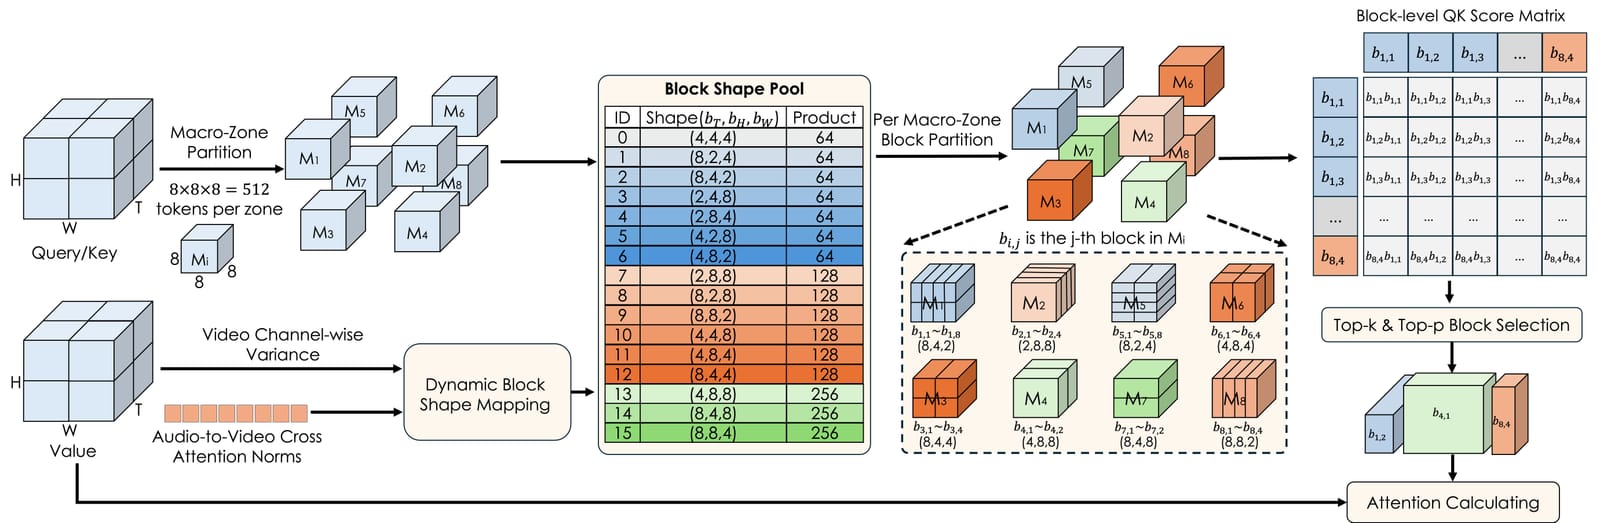
従来の映像+音声同時生成モデルは、計算量の都合で低解像度(480p〜720p)で学習してあとから引き伸ばすのが普通でした。Prismは画面を時間と空間の「ゾーン」に分け、動きが激しい場所や、音と映像が強く結びつく場所(口元や打楽器の当たる瞬間など)にだけ細かい注意計算をかける仕組みで、フル計算より学習が約2.5倍速いのに品質は同等以上と報告されています。広告・体験づくりでは、セリフ・効果音・BGMまで一度に付いた2K映像を素材として直接作れるため、スポーツや食事シーンのようなシズル感のあるカット、店頭サイネージ用の縦長・高精細ループ、ナレーション付き商品紹介の下書きなどに使えそうです。プロジェクトページには音付きの23ケースがあり、公開コードで自社データによる追加学習(LoRA的な拡張)も狙えます。
技術の詳細
仕組み:動画のトークン(AIが読み取る細かい画像片)の並びを、時間×空間の大きなブロック(macro-zone)に区切ります。各ブロックについて「映像の特徴のばらつき(絵が大きく変わるか)」と「音から映像への注目の強さ(音が絵に効いているか)」の2つを測り、変化が大きい所は細かいブロック、単調な所は粗いブロックでアテンション(どこを見るかの計算)を行います。会議で全員が全員に話すのをやめ、必要な人同士だけ話すようにして時間を減らすイメージです。 従来との違い:既存の音声付き映像モデル(Ovi、LTX-2.3、MOVAなど)は高解像度化でアテンション計算が爆発するため、低解像度で学習していました。Prismは2Kでネイティブ学習でき、論文では比較対象を上回る品質と、フルアテンション比2.5倍の学習高速化を示しています。リポジトリには720p/1080p/2Kの学習スクリプト、単GPU・FSDP(複数GPU分散)の推論スクリプト、データ準備ツールが入っており、READMEのみのプレースホルダではありません。 使うには:重みはHugging Face(FrancisRing/Prism)で配布。推論は720pで80GB GPU 1枚、1080p/2Kは80GB GPU 4枚以上が目安、学習は32〜64枚の80GB GPUが必要で、個人PCではなくクラウドGPU向けです。費用はGPUレンタル代のみで、ライセンスはMITのため商用利用の障壁は低いです。まずは公開デモ動画とpreview重みでの検証から始めるのが現実的です。
License
コード・重み(FrancisRing/Prism)ともMIT。ただし依存する第三者コンポーネントは各元ライセンスに従う。