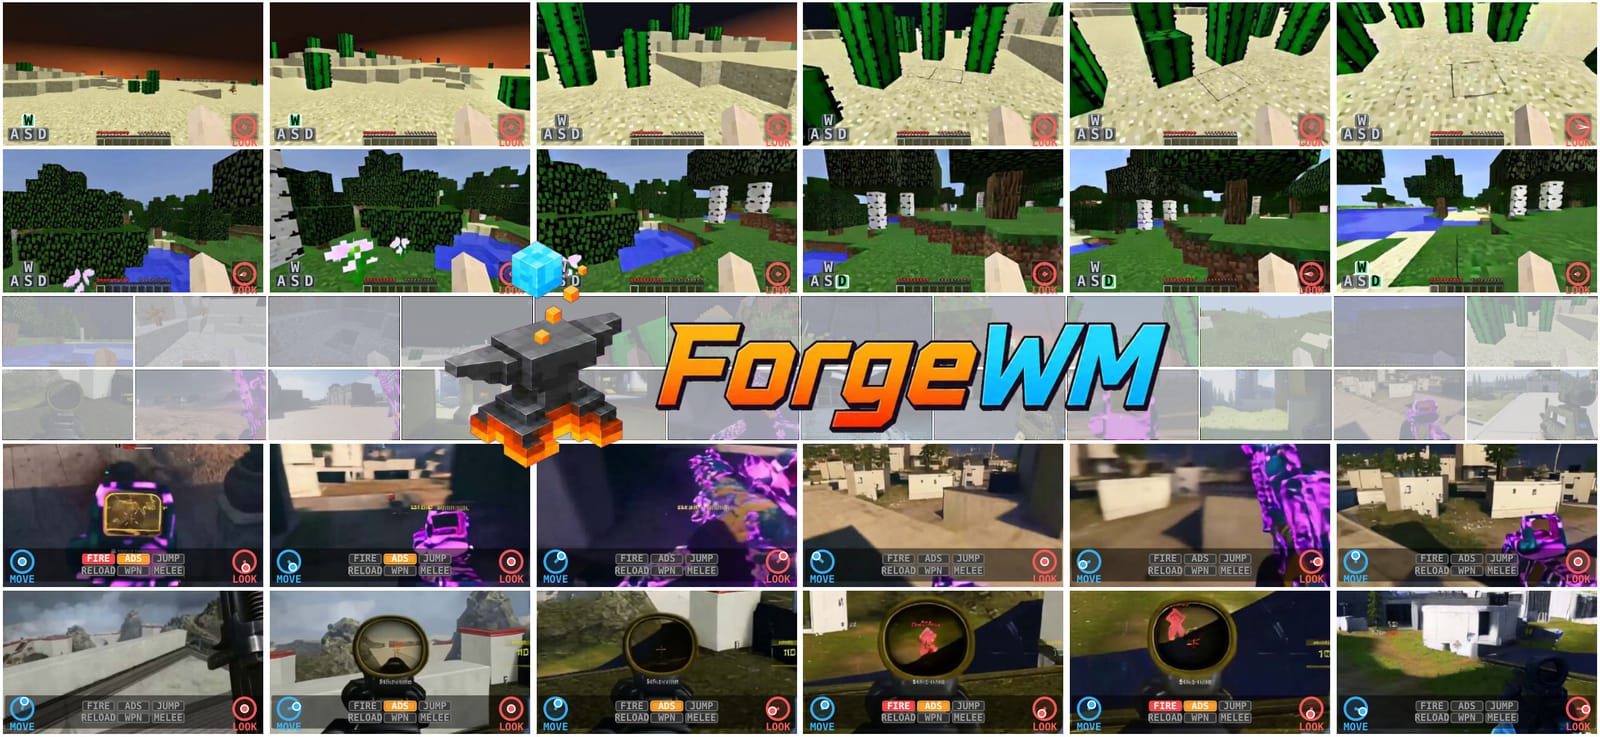
ForgeWM
asdfo123(著者: Xinye Liほか、所属機関は論文上に明記なし)/2026-08
Overview
キーボードやゲームパッドの操作にリアルタイムで反応し、次に見える映像をAIが直接生成し続ける『操作可能な動画世界モデル』。コード・学習済みモデル・論文すべて公開済み。
技術のポイント
キーボードやゲームパッドの操作に合わせて、AIが『次の瞬間に見えるはずの映像』をリアルタイムで生成し続ける技術です。たとえるなら、3Dモデルを作ってレンダリングするゲームエンジンの代わりに、AIが次の一瞬の映像を絵筆で描き続けることでゲームのような体験を作る、という発想です。従来この方式は生成に時間がかかり実用速度が出せませんでしたが、ForgeWMは4段階の学習を経て1ステップで映像を生成する高速版を実現し、GPU1基で毎秒72コマのリアルタイム再生を達成しました。広告や体験型コンテンツにおいて、3Dモデルを一切作らずに『操作できる映像世界』——来場者の動きに反応して変化する没入型インスタレーションや、ブランド世界を歩き回れるインタラクティブ映像体験——を作る際の技術的な下敷きとして参考になります。研究段階のプロトタイプですが、コード・学習済みモデル・論文がすべて公開されており実際に動かして検証できます。
技術の詳細
仕組みとしては、Matrix-Game 2という既存の画像→動画AIモデルをベースに、①静止画から動画を作る学習の応用、②プレイヤーの操作(矢印キーやゲームパッドの入力)に応じて次の1コマを予測する学習、③複数の未来を同時に想定して一貫性を高める学習、④計算を1〜4回の予測だけで済ませる高速化、という4段階の訓練を順に行います。将棋で言えば、何手も深く読む代わりに『次の一手』だけを瞬時に精度よく判断できるよう鍛え直すイメージです。 従来のゲームエンジンは3Dモデル・テクスチャ・物理演算を作り込んでからレンダリングしますが、ForgeWMはその制作工程を経ず、AIが直接『次に見えるはずの映像』を生成します。ベースにしたMatrix-Game 2は水中シーンなどで映像が破綻しやすい弱点がありましたが、ForgeWMは高速化してもこの空間的な一貫性を保てる点を強みとしています。 試すにはHugging Face上で配布されている学習済みモデルとPythonの推論コードが必要です。推論のみならGPU1基(H20相当の高性能GPU)で動きますが、フル学習には8基規模のGPUクラスタが要る本格的な研究プロジェクトのため、個人が学習から再現するのは非現実的です。公開済みモデルを動かして挙動を確認する使い方が現実的です。
License
NOTICEファイルに派生元コンポーネントの記載あり。Apache-2.0のため商用利用は基本的に可能。
Sources
Related Works
- Matrix-Game 2
ForgeWMのベースとなった画像→動画変換AIモデル(MITライセンス)
- GameFactory
ForgeWMの学習データセットの由来元となった研究