ViT-H
北京大学 / BIGAI(北京通用人工知能研究院)/2026-10
Overview
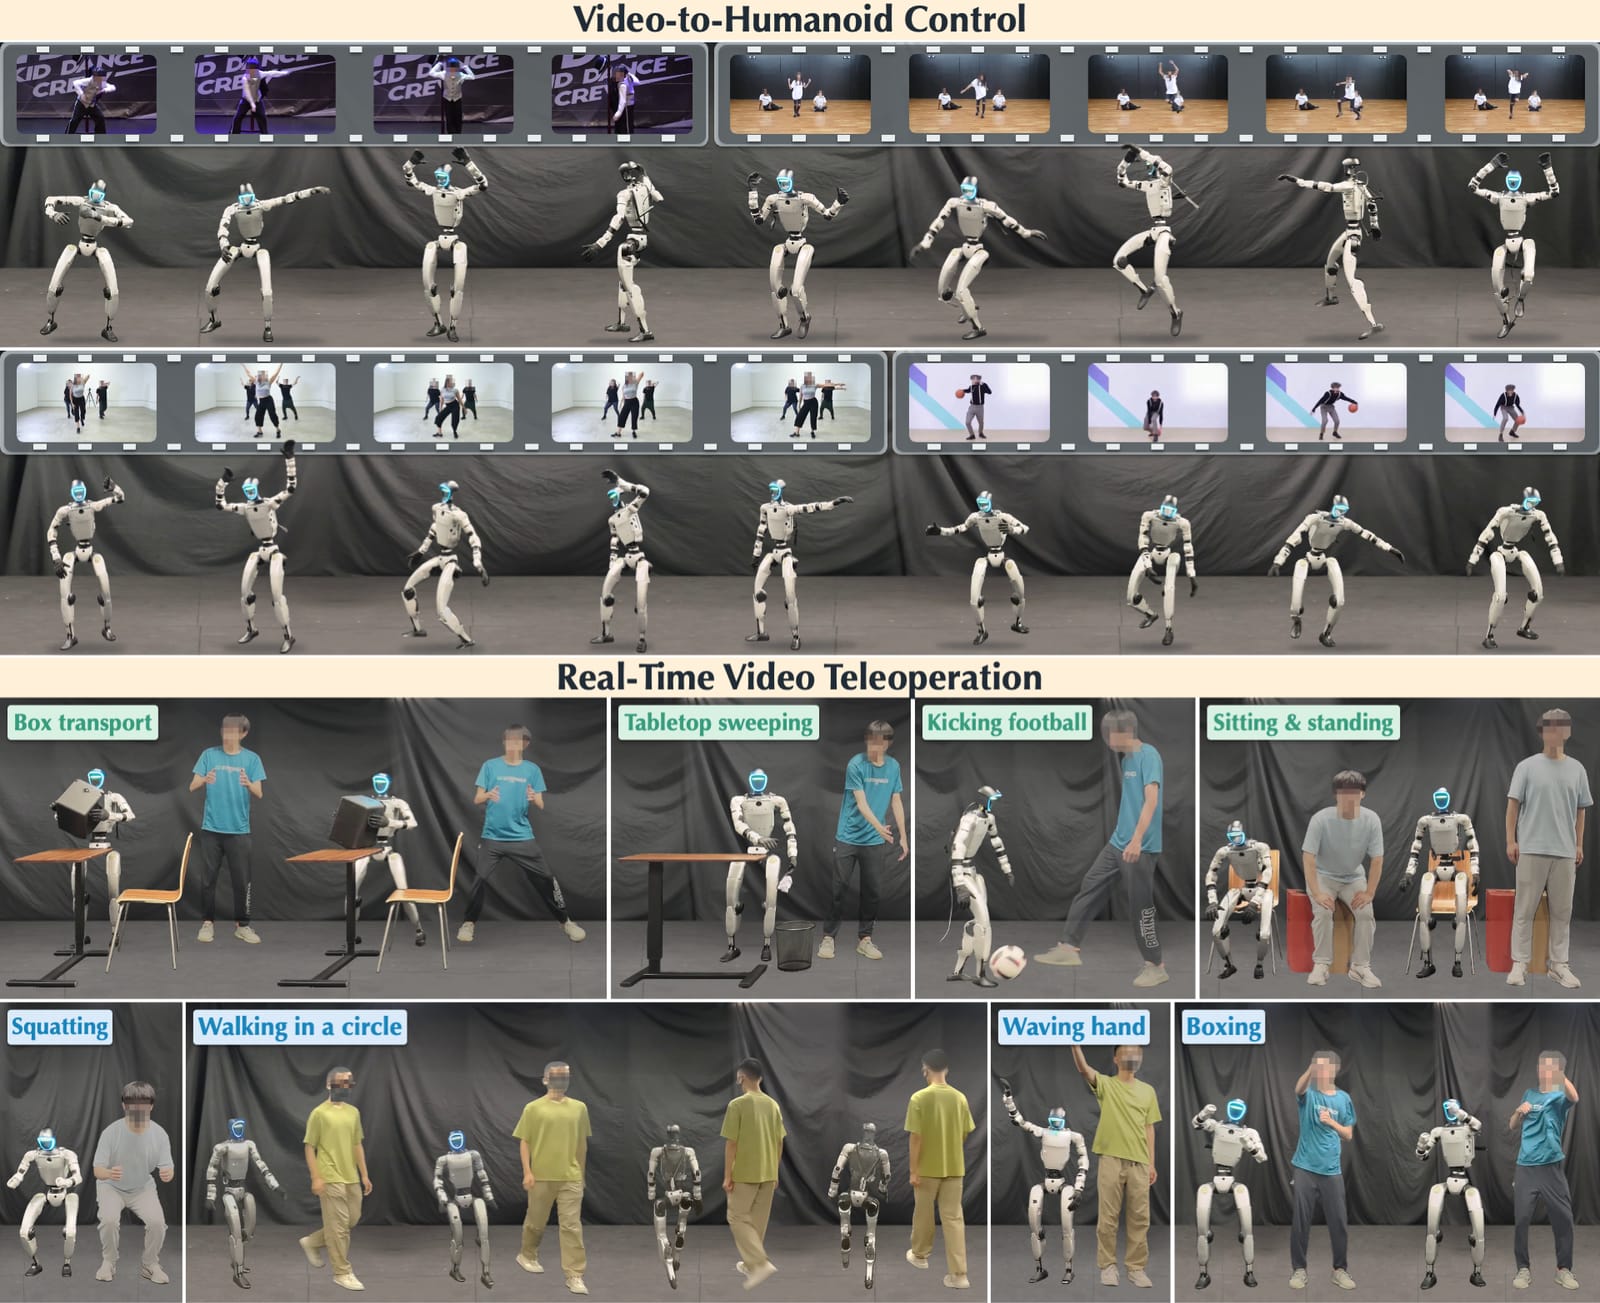
普通のカメラで撮った人の動画から、人型ロボット(Unitree G1)が実際に実行できる動きを直接つくり出す技術。従来の「人の姿勢を復元→ロボットに変換→追従」という3段階を飛ばせる。
技術のポイント
何がすごいか:人の動画からロボットの動きを作る従来の流れは、①人の3D姿勢を復元、②ロボットの体型に合わせて変換、③ロボットが再現、という3段階でした。各段階の小さな誤差が積み重なり、ロボットが転んだり不自然になったりしがちでした。ViT-Hは動画から「ロボットが実際に実行できる動き」を拡散モデル(ノイズから少しずつ動きを描き出すAI)で直接生成します。さらに、生成した動きを実際にロボットの制御ソフトに追従させ、うまくいったかどうかの結果をAIの学習に戻すので、「見た目は良いが実行できない動き」が減ります。広告・体験づくりでの使い道:来場者がカメラの前で踊ったりポーズを取ったりすると、人型ロボットが同じ動きをその場で返す展示や、ダンサーの動画をそのままロボット演舞に変えるステージ演出、ロボットを使ったライブ型コンテンツなどが考えられます。リアルタイム版はカメラ1台で遅延が約250ミリ秒と報告されており、操作を体験できる展示にも向きます。
技術の詳細
仕組み:学習済みの動画から動きを生成するAI(16層のトランスフォーマー、動画は30fpsに変換して120フレームずつ処理)が、動画を見てロボット用の動きの下書きを直接つくります。次に、MuJoCo(物理シミュレータ)上の追従制御で実際に動かしてみて、成功した動きと失敗した動きの差をAIに教え直します(DPOという好みの学習手法)。先生が生徒の答案を採点して、良い答案の書き方を覚えさせるイメージです。リアルタイム版は逐次生成型で、遠隔操作に使えます。 従来との違い:これまでは姿勢の復元やロボットへの変換を別々に最適化していたため、後段でロボットが失敗しても前段を直せませんでした。ViT-Hは追従結果をそのまま生成側に返すため、全体が一体で良くなります。論文では、モデルや学習データを増やすほど性能が上がることも報告されています。コードは2026年10月15日から公開が始まり、10月27日に推論・学習コード、28日にG1の追従器とアセットが追加され、11月2日にも修正が入っています。 使うには:Pythonとコマンド実行の知識、NVIDIA GPU、SAM3D・SMPL/SMPL-X・検出器などの外部素材のダウンロードが必要です。モデルの再学習には大規模なモーションデータ(AMASSなど)が要ります。推論スクリプト(tools/infer_video.py)で動画から動きを生成でき、実機のロボットは必須ではなく、同梱のMuJoCo追従器で動きの確認ができます。実機デプロイ用のコードは2026年12月1日公開予定と記載されています。
License
コードはMIT。SMPL/SMPL-X等の身体モデルや学習データは別規約のため、商用利用は各素材の条件を要確認。
Sources
Related Works
- GMR (General Motion Retargeting)
人の動きを様々な人型ロボットへCPUでリアルタイムに変換するリターゲティングツール。ViT-Hが飛ばす従来の変換段階にあたる。
- Humanoid-GPT
Unitree G1向けのゼロショット動作追従(CVPR 2026)。ViT-Hの追従フィードバック先の一つ。
- HumanTracker
人型ロボットの動作追従を人の好みに合わせて評価するベンチマーク(ECCV 2026)。