TRACE (Typed Reference-Aware Conversational Editing for Humanoid Motion Diffusion)
Multimodal-Perception-Action(Zejian Kang ほか)/2026-10
Overview
「もう少し深くお辞儀して」のような会話で、人型ロボット(Unitree G1)の動きを文章から作り、そのまま手直しできるモーション生成・編集システム。
技術のポイント
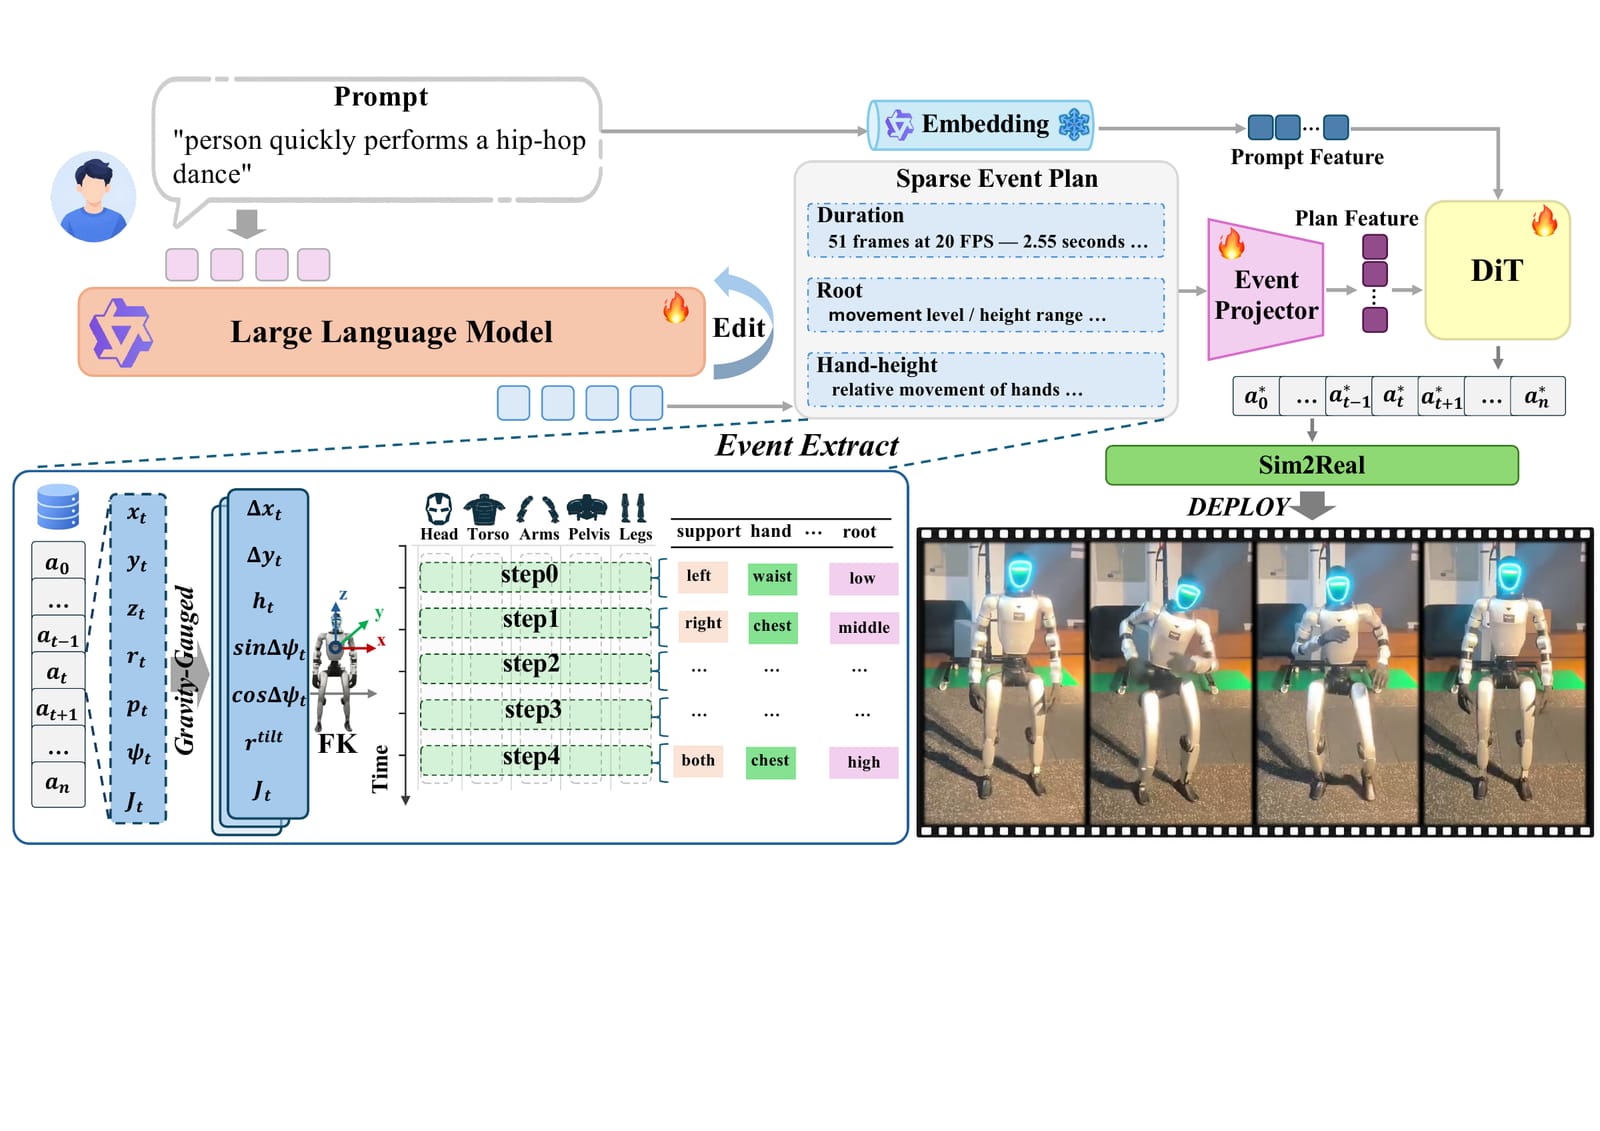
すごい点は、動きを一発で生成するだけでなく、「腕だけもっと高く」「ここの動きをゆっくりに」と会話で何度も修正できることです。言語モデルが「いつ足がつくか」「手がいつ動くか」といった動きの骨組みを先に決め、その骨組みをもとに拡散モデル(ノイズから少しずつ動きを描き起こすAI)が滑らかな動作に仕上げます。編集時は直したくない部分を固定したまま変更できるため、少しずつ演出を詰める作業と相性が良いです。広告・体験づくりでは、ロボットやキャラクターのダンス・お辞儀・ジェスチャーを「言葉で演出する」ワークフローに使えそうです。展示会のロボット受付、ショールームの人型ロボット演出、モーションキャプチャを使わない振付の叩き台づくりなどが想像できます。実機での動作映像(ジャンピングジャックの編集、ダンスなど)も公開されています。
技術の詳細
仕組み:まず言語モデルが、指示文から「動きの長さ」と「足の接地・体の移動・手の動き」といった要所のタイミング(スパースなイベント)を予測します。次に、その要所と元の文章を条件にして拡散トランスフォーマーが全身の連続した軌道を生成します。編集用には別の拡散モデルがあり、「どの部位を・どの時間帯に・今の動きに対してどれだけ変えるか」を型付きの指示として受け取り、守りたい部分の値は生成中に固定します。 従来との違い:多くのテキストtoモーション研究は一回きりの生成で、少し直したいときにプロンプトを書き直して全体が変わってしまう問題がありました。TRACEは前の出力を参照して相対的に直す(例:もっと深く)ことを狙い、連続した編集でも安定して実行できるとしています。ただし出力は平らな床を想定した運動の参照データで、実ロボットで動かすには別途検証済みの追従制御が必要です(リポジトリには含まれません)。 使うには:Linux、Python 3.10〜3.12、NVIDIA GPUが推奨で、重みはModelScopeから、言語モデルの土台(Qwen系、約16GB)は別途ダウンロードします。生成・編集・対話のスクリプトとレンダリングは同梱されていますが、生成器・編集器の学習用エントリポイントは現時点で未収録です。費用は無料ですが、研究コード相当なので環境構築にはPythonとGPUの知識が必要です。
License
コードと学習済み重みはApache-2.0。ただし土台のQwen系モデルは各自のライセンス、学習データ(BONES-SEED)の権利は付与されない。
Sources
Related Works
- Kimodo (NVIDIA)
テキストと簡単な制約から人間・ヒューマノイドの3Dモーションを生成するオープンモデル。
- HY-Motion 1.0 (Tencent)
10億パラメータ級のテキストtoモーション生成モデル。
- MoMask
マスク予測による3D人体モーション生成の代表的な先行研究。