GRAIL
NVIDIA / UCLA/2026-06
Overview
3Dアセットと動画生成AIから人型ロボット向けの全身動作データを自動合成し、実機のUnitree G1に転移させるNVIDIA/UCLAの研究パイプライン。
技術のポイント
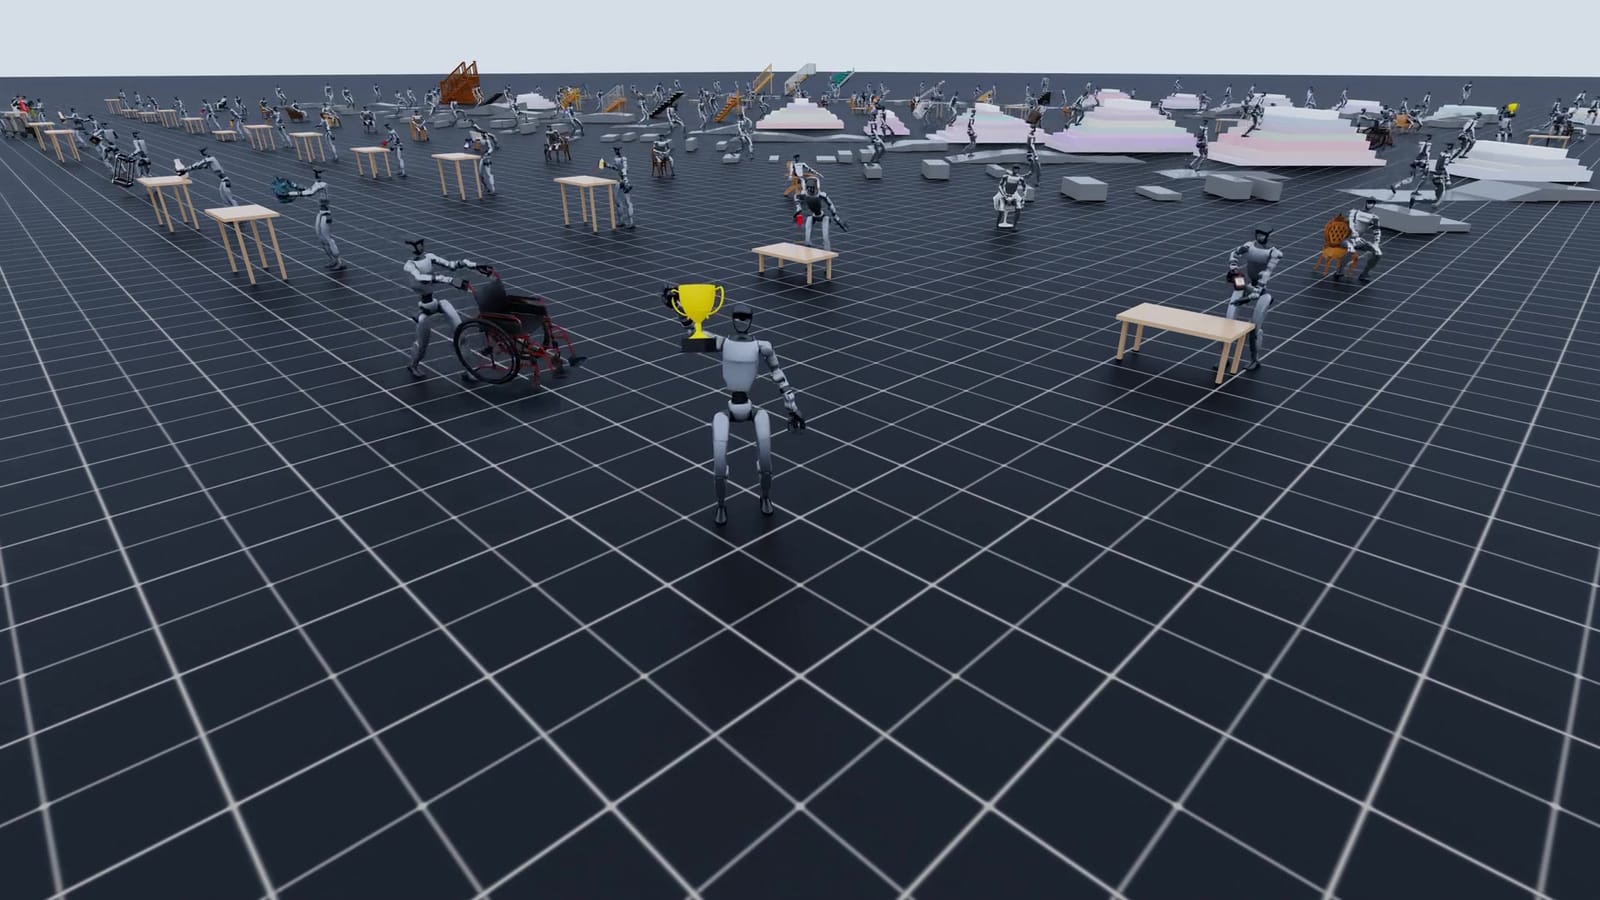
人型ロボットに「物を拾う」「階段を登る」といった全身の動きを覚えさせるには、本来は人間がモーションキャプチャスーツを着て演技したり、ロボットを直接操作して大量のお手本を集めたりする必要があります。GRAILはこの手間を丸ごと省く技術です。3Dモデルの部屋や小物を組み合わせた仮想シーンを用意し、動画生成AI(ビデオ基盤モデル)に「人がその物を持ち上げる」映像を作らせ、そこから3Dの動きを逆算して、ロボットの体格に合わせて動きを移し替えます。実際にこの合成データだけで学習したロボットが、現実の物体を拾ったり階段を登ったりできたと報告されています。広告・体験制作の観点では、実在しないシチュエーションのロボットや人型キャラクターの「もっともらしい動き」を、実写ロケや高価なモーションキャプチャなしに量産できる可能性を示す事例で、CGキャラクターの群衆演技やインタラクティブな展示物の動作設計にも応用できそうです。
技術の詳細
GRAILの処理は3段階です。まず、部屋の3Dモデルや家具・小物といった3Dアセットを組み合わせ、カメラ位置やスケールまで含めた仮想的な撮影セットを用意します。次に、その仮想セットを条件として動画生成AIに「人がその物を持ち上げる」映像を生成させ、映る人物の姿勢や物体の動きを追跡・再構成することで、現実のスケール感を保った3Dの動作データ(4D軌跡)を復元します。最後に、その動きをロボットの体格・関節構造に合わせて着せ替え、様々なタスクをこなす制御方針(ポリシー)を学習させます。 従来、ロボットに新しい動きを教えるには、モーションキャプチャスタジオでの演技収録か、人がロボットを遠隔操作して動きのお手本を集める「テレオペレーション」が必須で、コストと時間がかかるうえ対応できる物体や状況の種類も限られていました。GRAILはこの収録工程を仮想空間と動画生成AIに置き換え、2万本以上の動作シーケンスを自動生成しています。実機のUnitree G1に、生成データだけで学習した制御方針を積んだところ、物を拾う・階段を上るといった動作が現実でも機能したとされ、仮想データが実世界へ「転移」する精度の高さが従来手法との違いです。 現状は研究者・開発者向けのコード公開で、Dockerでの環境構築、3Dシミュレータ、Unitree G1のようなヒューマノイドロボット実機(または物理シミュレーション環境)が必要になります。ライセンスはNVIDIA独自の非商用ライセンスのためそのままの商用利用はできませんが、生成データセット自体はHugging Faceで公開されており、研究目的なら誰でも動作生成の仕組みを試せます。
License
NVIDIA独自の非商用ライセンス(NVIDIA以外は非商用利用のみ)。生成データセットはHugging Faceで別途公開。
Sources
Related Works
- ProtoMotions
GRAILが動作データの学習・シミュレーションに用いるNVIDIAのGPU高速物理シミュレーション基盤
- Kimodo
70万時間の光学モーキャプデータから人型・ロボット動作を生成するNVIDIAの拡散モデル
- GR00T N1.6
GRAILの生成データを学習に取り込む対象となるNVIDIAの人型ロボット基盤モデル