ComfyUI-DBS
hiroki-abe-58(非公式ノード)/ 元モデル: Tsinghua Univ. (Dynamic Band Splitting)/2026-10
Overview
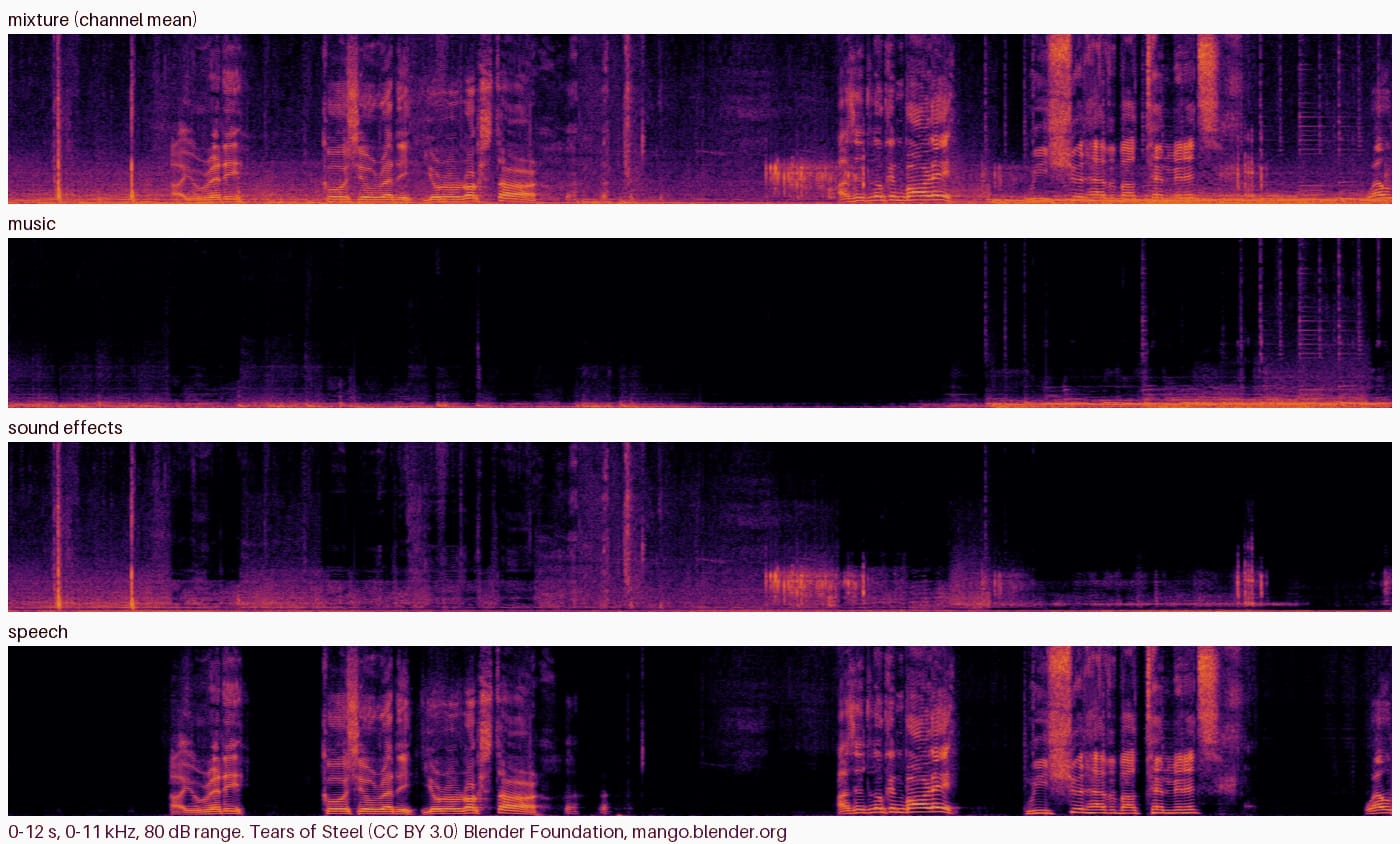
映画やCMの音声を「音楽・効果音・セリフ」の3つに分けるComfyUIノード。セリフだけ消した動画も作れる。
技術のポイント
1本の音声を、音楽・効果音・セリフの3本に自動で分けられます。3本を足すと元の音に戻る設計です。セリフだけ抜いて音楽と効果音を残した動画を作れるので、素材のナレーションを差し替えたり、吹き替えや字幕用にセリフだけ取り出したりする作業がComfyUIの中で終わります。モデルは合計約23MBと小さく、CUDA対応GPUがなくてもCPUで動きます。広告制作では、既存映像のBGMを活かしたまま別言語の吹き替えを載せる、権利処理済みのSEだけ残してナレーションを撮り直す、といった使い方が考えられます。AI生成映像の音を整える後工程としても使えます。MITライセンスのため業務利用の見通しも立てやすい点も長所です。
技術の詳細
仕組み: 音声を周波数ごとの帯域に分けて解析するAI(Dynamic Band Splitting)を使っています。従来は帯域の切り方が固定でしたが、この方式は音ごとに切り方を予測して変えます。ノードは2つです。「DBS Loader」でモデル(軽量なTIGERか、CPU向きのBSRNN)を選び、「DBS Separate」で音声を入れると music / sfx / speech の3本が出ます。長い音声は短い窓に区切って重ねながら処理するので、長さの制限はありません。ステレオを保つ「each channel」モードもあります。 従来との違い: 公式の研究コードをそのまま動かすには環境構築が必要でしたが、このノードでComfyUIの動画ワークフローに直接つながります。作者の検証では、公式パッケージと同じ結果になることを確認済みです(CPUで6件中6件一致)。ただし分離の品質そのものは再評価しておらず、学習データは英語の映画風ミックスなので、歌入りの楽曲や日本語素材は自分の耳で確かめる必要があります。 使うには: ComfyUI v0.38.0以降とPython 3.10以上が必要です。リポジトリを custom_nodes にclone → requirements.txtをインストール → tools/download_model.py でモデルをダウンロード(SHA-256で検証)します。無料です。workflows/gui/ に、3本に分けるもの、セリフを消すもの、動画のセリフを消すものの3種類のサンプルがあります。
License
ノード本体はMIT。同梱の公式DBSコードとモデルはApache-2.0、学習データDnR v2はCC BY 4.0(表記が必要)。
Sources
Related Works
- Dynamic Band Splitting (公式実装)
このノードが使う分離モデルの元研究。BSRNN/TIGER等のDBS版と学習済みモデルを公開。
- Learning Where to Split (arXiv 2610.14993)
帯域の切り方を入力ごとに予測する音源分離の論文。