RecGen3D
Zhisheng Huang ら(SIGGRAPH Asia 2026採択)/2026-09
Overview
数枚の写真(カメラ位置不明でもOK)から、形が欠けない完全な3Dモデルを作る手法。復元AIと生成AIを共通の座標空間で協調させ、コードと重みが公開されました。
技術のポイント
少ない写真から3Dモデルを作るとき、「写った部分は正確だが裏側が欠ける復元系」と「全体は埋まるが実物とズレやすい生成系」という弱点がありました。RecGen3Dは両者を組み合わせ、写真に忠実でしかも欠けのない3D形状を出力します。カメラの位置情報がなくても動く点も実用的です。広告や体験づくりでは、商品や小物を数枚スマホで撮っただけで3D化してAR・Webの3D表示・インタラクティブな展示に使ったり、撮り直しのきかない現物の簡易デジタルアーカイブを作ったりといった試作に向きます。ただし現状は非商用の研究用ライセンスなので、企画段階のプロトタイプや検証用途が中心になります。
技術の詳細
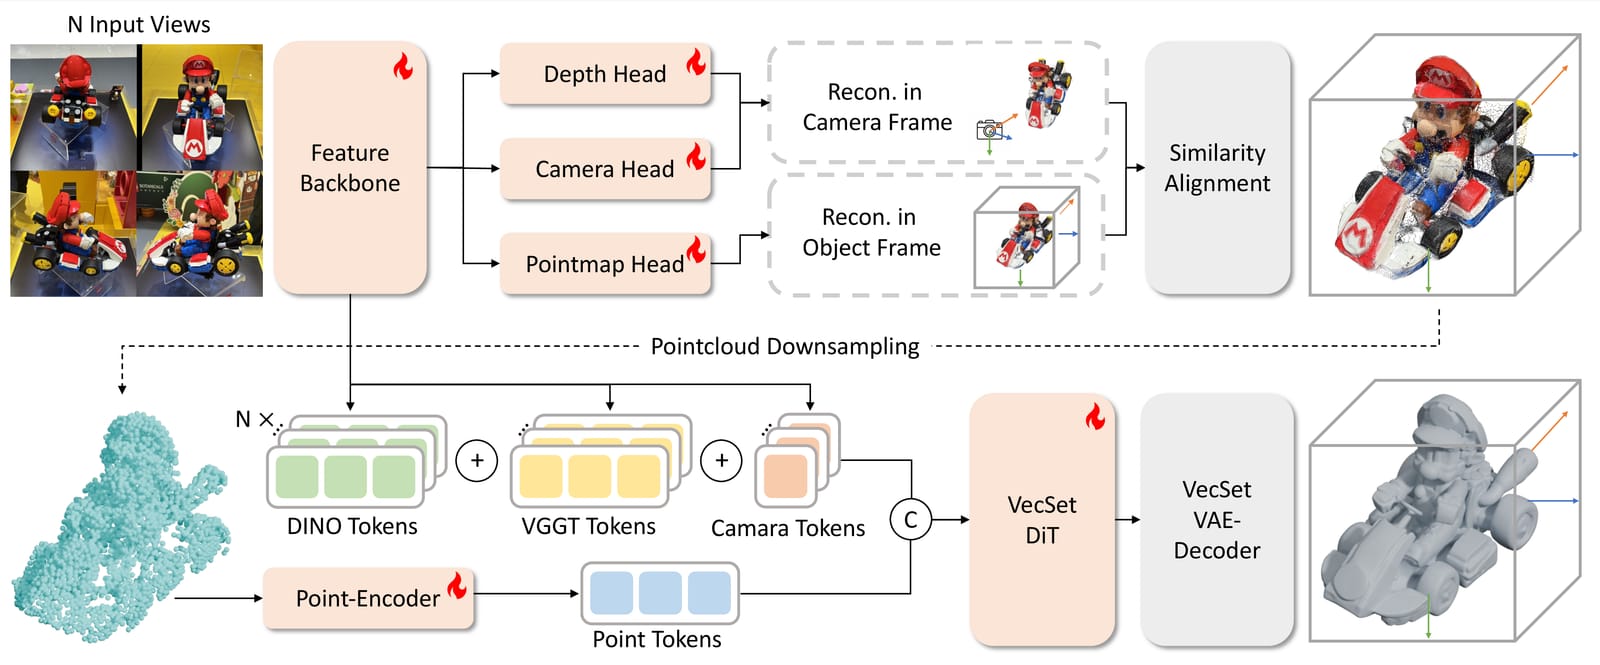
仕組みは2段構成です。まずVGGT(複数の写真から奥行きやカメラ位置、3D点を一気に推定するAI)を改造し、物体を基準にした共通座標での点群(3D空間に散らした点の集まり)を作ります。次にその点群を「設計図」として、Hunyuan3D-Omni由来の拡散Transformer(VecSet DiT)に渡し、DINOの画像特徴も加えて欠けた部分を補いながら3D形状を仕上げます。たとえるなら、測量で骨組みを作ってから、彫刻家が写真を見ながら肉付けするイメージです。 従来は復元系と生成系が別々の道具で、どちらかの弱点が残りました。本手法は同じ座標空間で両者をそろえることで、忠実さと完全さを両立したと論文は報告しています。 使うにはGitHubのリポジトリと約23GBの重みをダウンロードし、inference.pyで推論します。大容量VRAMのGPUとPython環境が必要で、費用はソフトウェアは無料ですがライセンスは非商用限定です。商用の案件に使う場合は、上流ライセンスを確認するか別手法での再検証が必要です。
License
上流のVGGTとHunyuan3D-Omniの制約を継承し、非商用の研究用途に限定(LICENSES/参照)。重みは約23GBでHFのzsh523/RecGen3Dから取得。
Sources
Related Works
- VGGT
複数画像からカメラ・奥行き・3D点を一括推定する基盤モデル。
- Hunyuan3D-Omni
点群など多様な条件で制御できるテンセントの3D形状生成。
- LingBot-Map
3D再構成系の関連プロジェクト。