DreamX-World 1.0
AMAP-ML (Alibaba AutoNavi)/2026-06
Overview
テキスト指示だけで、視点を動かしても矛盾なく繋がり続ける「歩き回れる3D世界」の映像を生成できるAIモデル。
技術のポイント
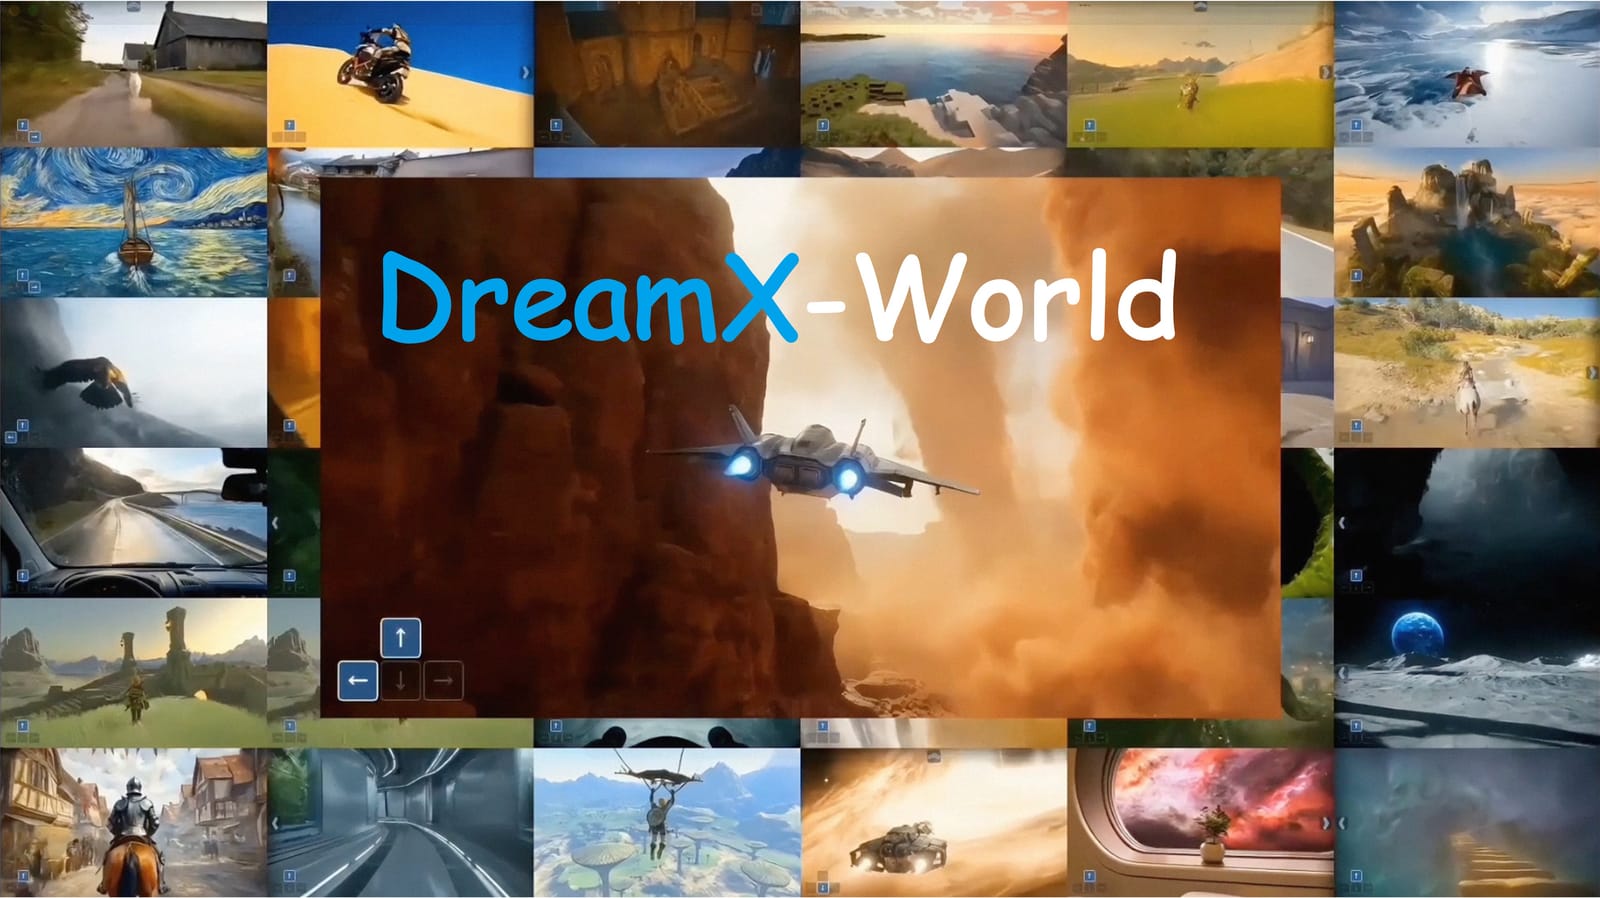
DreamX-Worldは、文章の指示だけで「歩き回れる3D世界」の映像を生成し続けられるAIモデル。従来の動画生成AIは数秒で背景や物の位置がブレたり作り変わったりしてしまう弱点があったが、本モデルは「これまで見た場所の記憶」を保持する仕組み(world memory)を備え、カメラを動かしても同じ建物や道が同じ場所にあり続ける、一貫性のある空間として生成し続けられる。さらにカメラの向きや動きも数値で自由に指定できる(6自由度カメラ制御)。広告・体験づくりの観点では、実写ロケを組まずに「未知の街を歩く」「異世界を探検する」といった没入型プロモーション映像を作れるほか、ゲームやCM撮影のプリビズ、バーチャルショールームの下絵づくりなど、企画の初期段階で世界観を素早く映像化する用途に使える可能性がある。
技術の詳細
テキストで「未来都市の路地裏」のように空間を指示すると、AIがその場所を映像として生成する仕組み。一般的な動画生成AIの多くは数秒ごとに背景がリセットされたように変化してしまうが、DreamX-Worldは一度生成した場所の形状や配置を記憶し続け、カメラが同じ場所に戻ってきたときにも矛盾なく同じ景色を描き直せる。いわば「頭の中に地図を持ちながら映像を生成している」状態に近い。 一般的な動画生成AIは単発のクリップ生成が主で、視点を大きく動かすと世界が破綻しやすかった。DreamX-Worldは複数回の生成をまたいで空間の一貫性を保てる点、およびカメラ位置・向きを細かく数値制御できる点が従来との違い。 使うには、50億パラメータのモデル本体をHugging FaceまたはGitHubから無償で入手(コード・重みともにApache-2.0ライセンスで商用利用可)。実行にはNVIDIA GPU(相応のVRAM)とPython/PyTorch環境が必要で、モデルにより生成できる映像の長さは異なり、カメラ制御対応の5B-Camモデルは最大5秒、長時間生成対応の5Bモデルは最大60秒(1分)の映像を生成できる仕様。
License
GitHub(コード)とHugging Face(重み)双方で無償公開、商用利用可
Sources
Related Works
- World Labs Marble
テキストや画像から探索可能な3D世界を生成する商用サービス
- Google Genie 3 (Project Genie)
リアルタイムに世界を生成・探索できるGoogleの世界モデル
- HunyuanWorld-1.0
テキスト/画像から没入可能な3D世界を生成するTencentのOSSモデル