ArtiFixer
NVIDIA Spatial Intelligence Lab(ETH Zurich / Cornell / Univ. of Toronto 共同)/2026-06
Overview
壊れた・ぼやけた3D再構成(Gaussian Splatting等)のレンダリングを、Wan2.1ベースの自己回帰ビデオ拡散モデルで綺麗に修復し、撮影していないアングルまで生成補完するNVIDIAの研究。SIGGRAPH 2026採択。
技術のポイント
スマホで手早く撮った3Dスキャン(ガウシアン・スプラッティングなど)は、撮り漏らした角度がグチャッと崩れてしまうのが常識でした。ArtiFixerは、動画生成AIが持つ“それらしく描き足す力”を使って、この崩れた部分をきれいに修復し、さらに実際には撮っていないカメラアングルの映像まで作り出します。画質の指標(PSNR)では、これまでの最高性能の手法を1〜3dB上回ると報告されています。広告や体験づくりでは、ロケ地や商品を数分スキャンするだけで自由にカメラを動かせる高品質な3D空間が作れるため、CMのバーチャルロケハン、店舗のデジタルツイン、実在の街を舞台にしたWeb体験などの制作コストを大きく下げられる可能性があります。NVIDIAらによるSIGGRAPH 2026採択の研究です。
技術の詳細
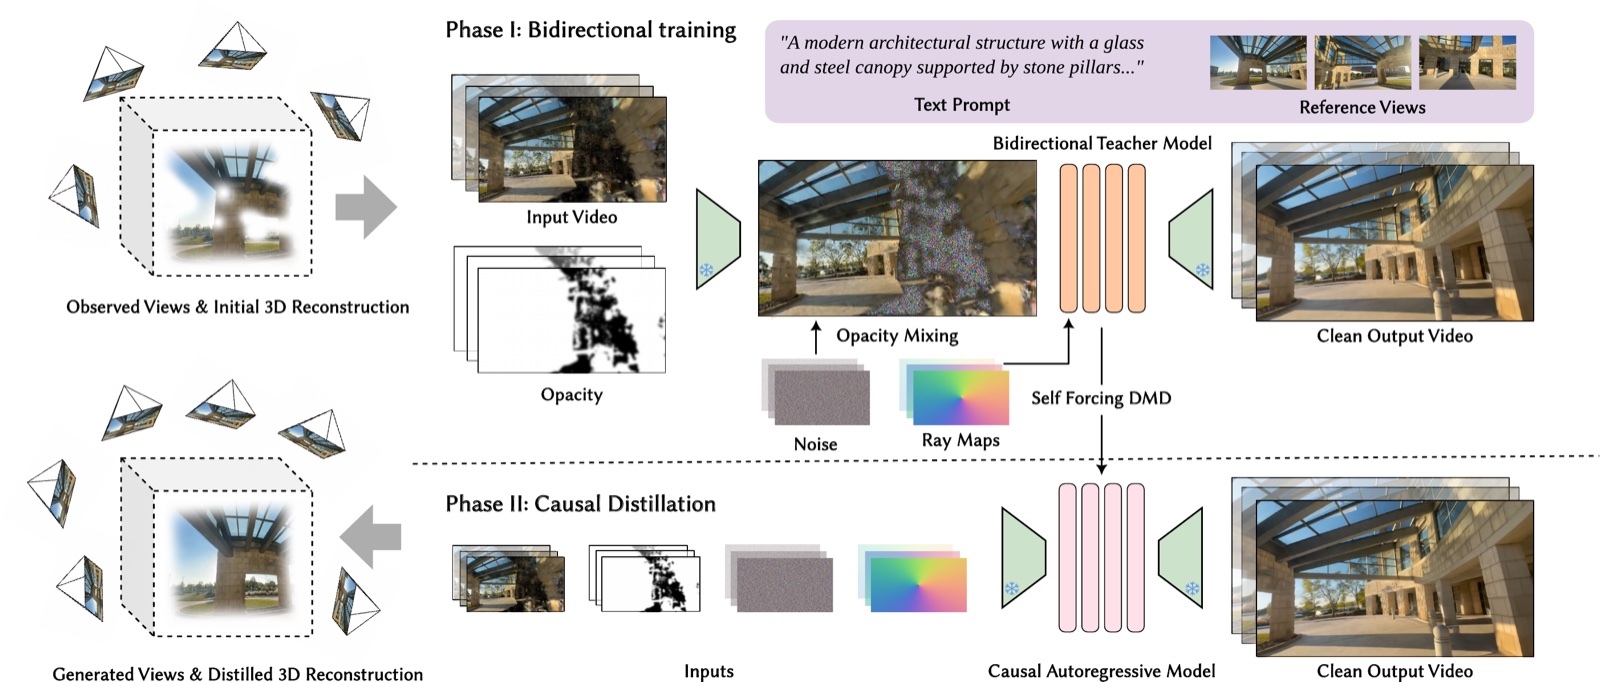
ArtiFixerは2段構えで動きます。まず、たくさんの映像で鍛えた高品質な動画生成モデル(前後の文脈を両方見て破綻なく描く“双方向モデル”)を用意し、崩れたスキャン映像を『本来こう見えるはず』と描き直させます。次にそのモデルを、時間を追って一気に描く“自己回帰モデル”に蒸留(軽量化・高速化)し、1回の処理で数百コマぶんの映像をまとめて生成できるようにします。これにより、雑なスキャンの穴を埋めながら、新しい視点の連続映像を破綻なく作り出せます。 3Dガウシアン・スプラッティングなどは、しっかり撮れた範囲では非常に高品質ですが、撮影が薄い場所やまったく映っていない場所の再現が苦手でした。従来はこの穴を埋めるために別のマルチビュー生成(GoogleのCAT3Dなど)を使いましたが、品質や一貫性に限界がありました。ArtiFixerは動画生成AIの表現力で欠損を補い、画質指標で従来最高手法を1〜3dB上回ります。1回の推論で長い連続フレームを出せるため、視点をなめらかに動かす映像づくりに向いています。 開発はNVIDIA Spatial Intelligence Labを中心に、ETH Zurich・コーネル大学・トロント大学らの共同。コードはGitHubで公開(Apache-2.0)ですが、HuggingFaceで配布されるモデルの重みはNVIDIAの非商用ライセンスで、研究開発の範囲に限られます。実行にはPythonと相応のGPU、修復元となる3Dスキャンデータが必要です。現時点では商用利用不可のため、実務では技術検証や表現探索の段階での活用が現実的です。
License
GitHubのコードはApache-2.0だが、HuggingFace配布のモデル重みはNVIDIA非商用ライセンス(研究開発限定)