CoMoVi
HKUST(香港科技大学 IGL)/2026-04
Overview
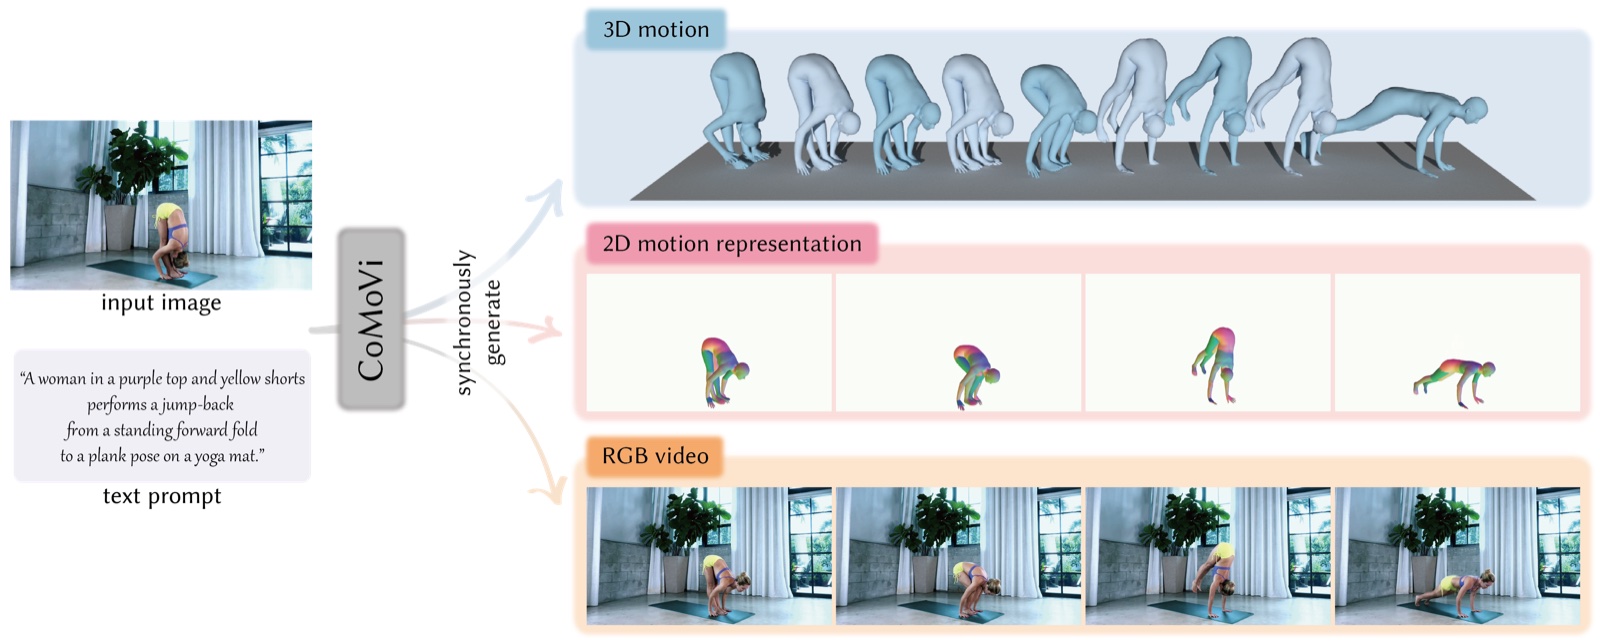
文章から『3Dの人の動き』と『写実的な映像』を一つの生成ループの中で同時に作る。3Dが映像に構造の正しさを、事前学習済みの映像モデルが3Dの動きに汎化力(多様でもっともらしい動きを生む力)を互いに与え合って品質を底上げする。
技術のポイント
文章から「3Dの人の動き」と「写実的な映像」を同時に、一つの生成ループの中で作り出す技術。ふつうは先に動きのデータを作り、それを別工程で映像化するが、CoMoViは両者を互いに参照させながら並行生成する。3Dの動きが映像に骨格の正しさを与え、事前学習済みの映像モデルが3Dの動きに汎化力(多様でもっともらしい動きを生成する力)を与える——二人三脚で品質を底上げする発想だ。出力は編集や再ライティングに使える3Dモーションと、そのまま見せられる動画の両方。広告・体験づくりでは、テキストから欲しい動きのモーションデータを起こしてCGキャラに流用する、絵コンテ代わりに動きつきのラフ映像を素早く作る、実写風の人物アクション素材を撮影なしで生成する、といった用途に使える。3Dデータが同時に手に入るので、後工程でのカメラ変更やCG合成にも展開しやすい。
技術の詳細
仕組みは二股の拡散モデルだ。二つの動画生成モデルを並べ、片方が3Dの人体モーションを、もう片方が映像を担当し、両者が特徴を相互にやり取りしながら(3Dと2Dのあいだで注意を向け合いながら)同時に生成を進める。3D側が「体はこう動くはず」という構造の裏付けを映像側に与え、事前学習済みの映像モデルは「こんな動きもありうる」という汎化力を3Dモーション側に与える。 従来は「テキスト→モーション」と「テキスト→動画」が別々の研究で、動きは正確でも映像が不自然、あるいは映像は綺麗でも3D構造が取り出せない、というトレードオフがあった。CoMoViは両方を一体で生成することで、動きの正確さと映像の自然さを両立させ、しかも編集に使える3Dデータも同時に得られる点が新しい。 土台にはオープンな動画生成モデルWan2.2(5B規模)を使う。コードと重みはApache-2.0で公開され(重みはダウンロードスクリプト経由)、商用利用も可能。学習には複数GPUが必要だが、生成(推論)はCUDA対応GPUとPython環境があれば動く。
License
コード・重みともApache-2.0で商用可(重みはダウンロードスクリプト経由)