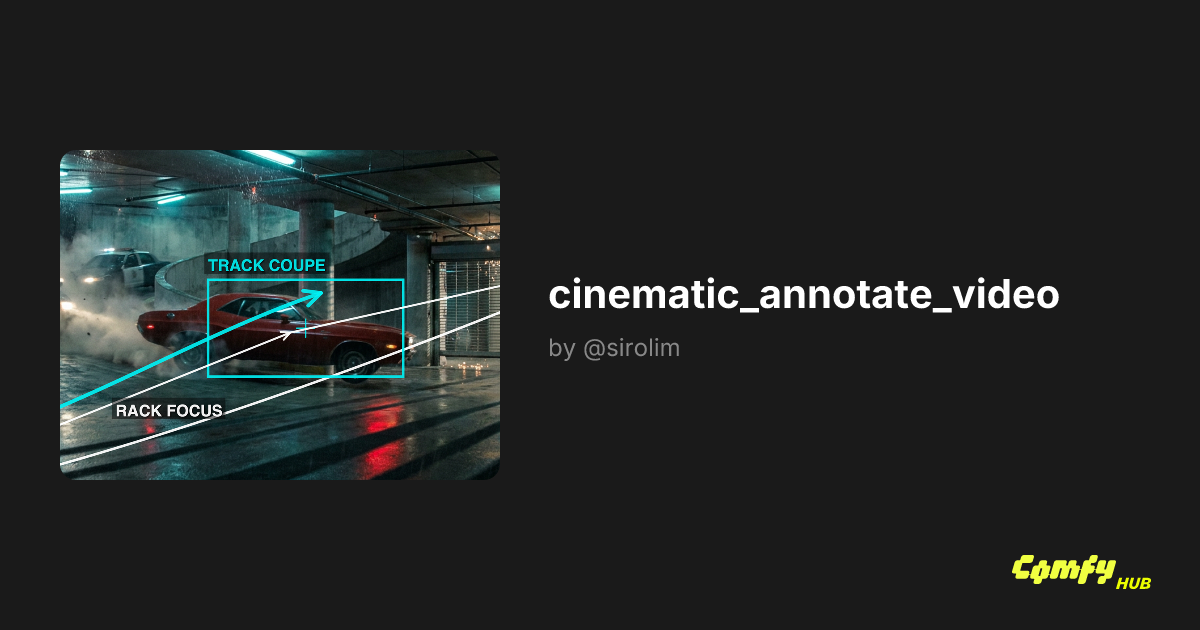
ComfyUI「Cinematic Annotate Video」ワークフロー
Comfy Org/テンプレート作者: Sirolim/2026-06
Overview
画像の上に線や注釈を描くだけでキャラの移動経路やカメラワークを指定でき、統合されたLLMがその描き込みをSeedance 2.0用のモーションプロンプトへ自動翻訳して動画を生成するComfyUIワークフロー。
技術のポイント
AI動画生成の大きなストレスは、「右奥へゆっくりドリー(カメラを台車ごと近づける動き)しながら…」といったカメラ演出を言葉で説明しきれないことだった。このComfyUI(無料公開されているAI画像・動画生成の組み立てツール)向けワークフローは、カメラの動きを「画像の上に描かれた線や注釈」という目に見える形式で扱う。公開テンプレートでは、画像を1枚入れるとGemini(Googleの画像を理解できるAI)がシーンを解析してカメラパスの注釈を自動で描き込み、続いて別のGeminiノードがその描き込みをSeedance 2.0用のモーションプロンプト(カメラの経路・タイミング・緩急まで記述する指示文)に翻訳し、元画像の見た目を保ったまま短いシネマティック動画を生成する。動きの設計図が、絵コンテの矢印と同じ「見て確認できる」形で工程の途中に挟まるのが本質的に新しい。広告制作では、商品カット1枚からカメラが回り込むシネマティック動画を起こす、絵コンテからそのままビデオコンテを作るといった使い方が見込める。
技術の詳細
処理は3段階のリレーだ。まず入力画像をGeminiの画像ノードが解析し、被写体や空間の構造を踏まえたカメラパスのマークアップ(線や記号による注釈)を画像の上に自動生成する。次に別のGeminiノードがその注釈画像を読み取り、Seedance 2.0が理解できるモーション指示——カメラの経路、タイミング、動きの緩急(イージング)まで記述した文章——へ整形する。最後にByteDance系の参照ノードが、元画像の見た目を保持しながら動画を合成する。ポイントは、AIが考えたカメラの動きが「注釈の描かれた画像」という人間にも読める中間形式でいったん可視化されること。絵コンテの矢印と同じ言語なので、生成前に演出の意図を目で確認できる。 テキストだけでカメラを制御しようとすると解釈のブレが大きい。ドラッグ軌跡で動きを指定する研究(DragNUWA)や、画像上に軌跡パスを描くワークフロー(Wan ATI)といった先行例はあったが、このワークフローは注釈の生成と指示文への翻訳の両方をLLMに任せ、それを高品質な動画モデルSeedance 2.0につないだ構成が新しい。 ComfyUI本体は無料のオープンソースで、ワークフロー自体もテンプレートとして無料公開されている。ただしGeminiとSeedance 2.0はいずれもAPI経由の外部モデルのため、有効なAPIキー(利用は有料)が必要になる。ページにはローカルのモデルプロバイダへの切り替えも可能と記載されており、ブラウザ上のComfy Cloudでも試せる。商用利用の可否は各API提供元の規約に依存する。
License
ワークフロー自体は無料公開(ComfyUI本体はGPL-3.0のOSS)。動画生成に使うSeedance 2.0はAPI経由の有料モデルで、商用利用可否はAPI提供元の規約に依存
Sources
Related Works
- Wan ATI Motion Control
画像上に軌跡パスを描いて動きを制御する先行ワークフロー
- DragNUWA
ドラッグ軌跡で動画の動きを制御する研究の先行例