HS-TasNet
L-Acoustics(原論文)/コミュニティ実装(lucidrains ほか)/2024-02
Overview
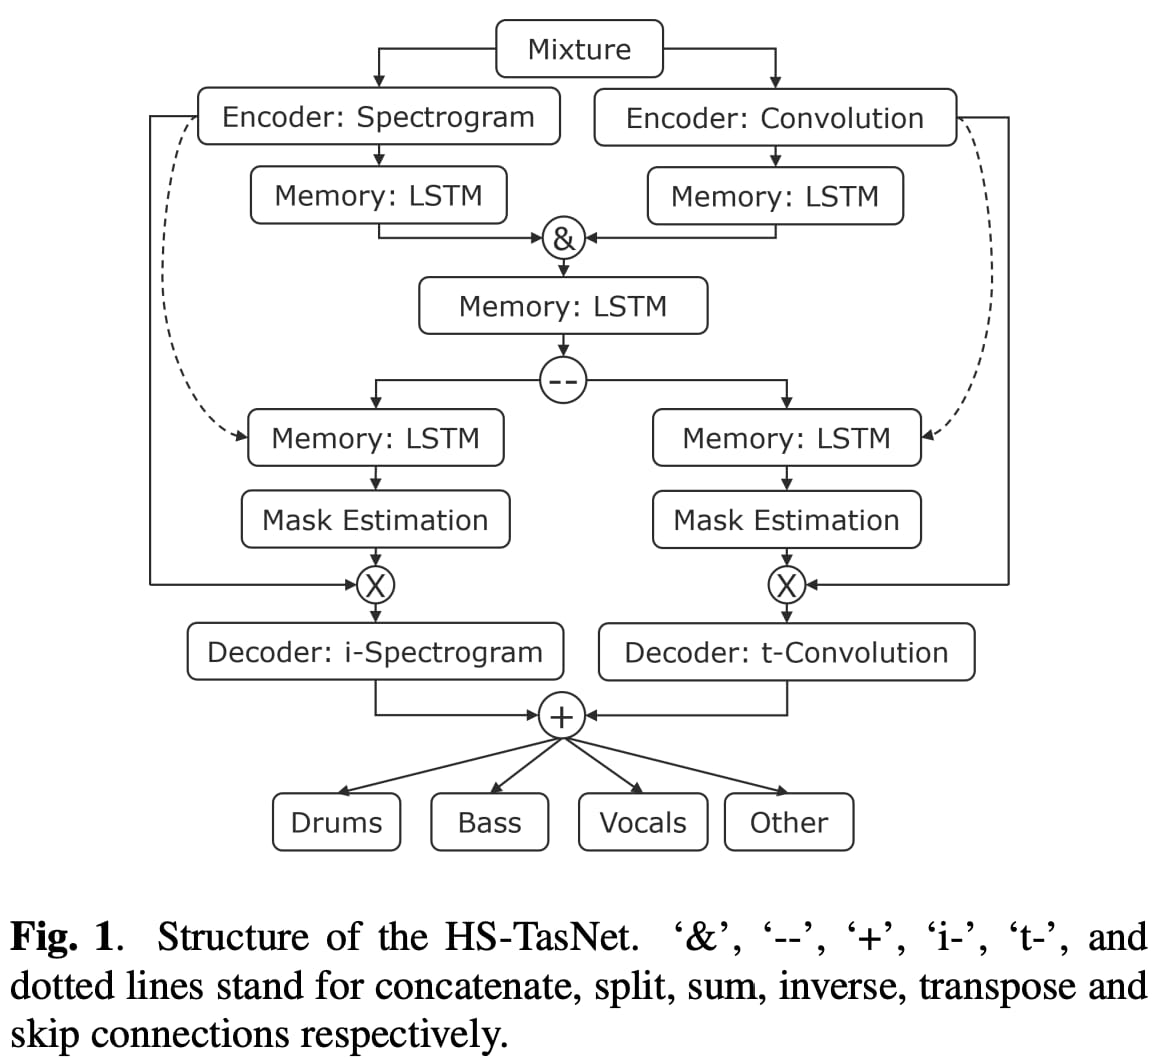
音声のスペクトログラムと波形の両方を同時に扱うハイブリッド型ニューラルネットワークで、23ミリ秒という極小フレームでボーカル・ドラム・ベース・その他をリアルタイムに分離する音源分離モデル。
技術のポイント
音楽配信の裏側でよく使われる音源分離AIの多くは、曲を丸ごと読み込んでから数秒かけて処理する『バッチ処理』型でした。HS-TasNetは、音の周波数成分を見る手法(スペクトログラム分析)と波形そのものを直接扱う手法(TasNet)を組み合わせることで、わずか23ミリ秒ぶんの音を受け取るたびに次々と分離結果を出力できるようにした研究成果です。人間がタイムラグを感じ始める境界とされる数十ミリ秒を下回る速度のため、ライブ配信中に司会者の声だけを強調する、DJプレイ中にドラムだけをリアルタイムで抜き出す、といった『聞きながら仕分ける』体験の土台になります。実際にこのモデルはStemgenRTなどのVST/AUプラグインに採用され、DJや配信者が使える実用ツールへと発展しています。
技術の詳細
仕組みは、音をごく短い時間の窓に区切り、周波数領域の分析結果と時間領域(波形)の分析結果を1つのネットワーク内で組み合わせて推定するハイブリッド構成にあります。従来のDemucsのような高精度モデルは曲全体を先読みする必要がありましたが、HS-TasNetは過去の情報だけを使って未来を予測しない因果的な設計にすることで遅延を最小化しています。MUSDBという標準ベンチマークでSDR4.65〜5.55dBというスコアを報告しており、精度と速度のバランスを取った点が特徴です。利用にはPythonで`pip install`して事前学習済みモデルを読み込むだけで試せ、MITライセンスのため研究用途はもちろん商用プラグインへの組み込みも可能です。GPUがあれば実時間よりずっと速く動作しますが、CPUでも23ms級のフレームサイズなら実用的な速度で動作します。
License
コミュニティ実装コードはMIT表記