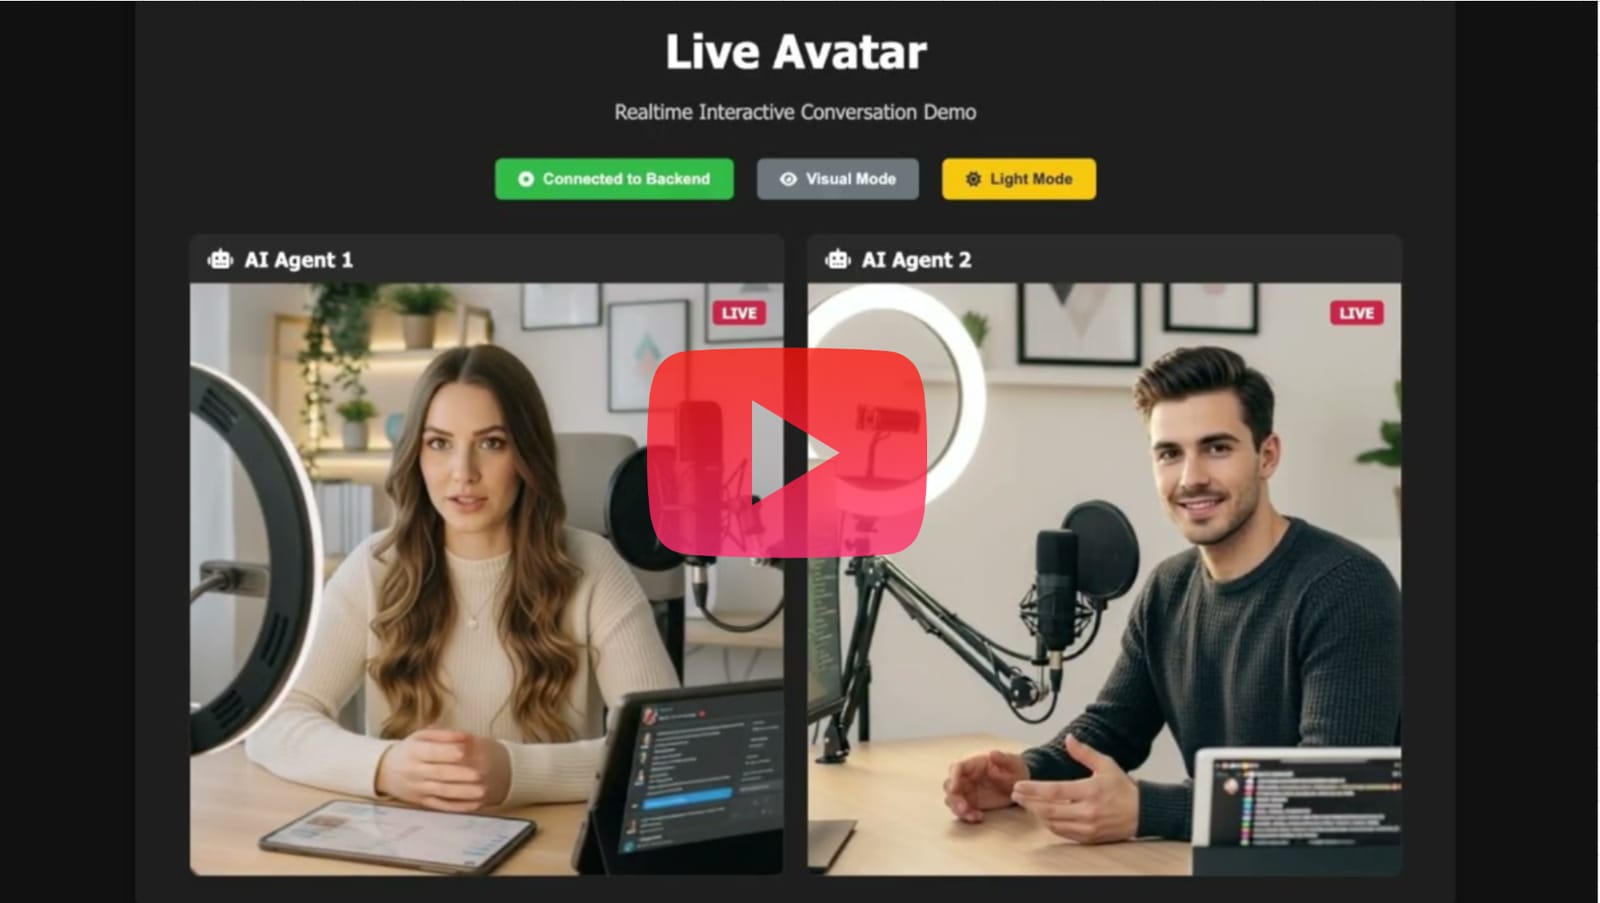
Live Avatar
Alibaba Quark / 中国科学技術大学 (USTC)/2025-12
Overview
1枚の顔写真と音声だけから、何時間でも破綻せずしゃべり続けるリアルタイム映像アバターを生成するAI。オンライン会議用ではなく、ライブ配信・大画面演出向けの生成速度と持続性を狙って設計されている。
技術のポイント
従来のAI動画生成は「数秒の映像を時間をかけて作る」のが基本でしたが、Live Avatarは逆に「入力した音声に合わせてリアルタイムで映像を生成し続ける」ことに特化しています。140億パラメータという大型の拡散モデルを、GPUごとに処理の役割を分担させる独自の並列化技術で高速化し、複数GPUなら45FPS、1万秒(約2.8時間)を超える連続生成でも顔が崩れたり別人になったりしないよう設計されています。ライブ・ステージ演出の観点では、実在しないバーチャルMCやAIキャラクターを、事前収録なしでその場の音声・掛け合いに反応させながらLEDビジョンやホログラム風スクリーンに映し出す、といった使い方が現実味を帯びてきます。歌唱イベントの合間のMC進行や、来場できないゲストのアバター出演を長時間安定して届けたい制作に向いた技術です。
技術の詳細
仕組みを簡単に言うと、あらかじめ大きな「双方向(前後の文脈を見て絵を整える)拡散モデル」を訓練しておき、それを「一方向・数ステップで済む軽量モデル」に蒸留(知識を圧縮して移す)し直すことでリアルタイム性を確保しています。さらに長時間再生すると顔がぶれていく問題(ドリフト)を抑える工夫が複数組み込まれており、10,000秒超の連続ストリーミングでも同一人物として破綻しにくいのが特徴です。処理はGPUごとに担当するタイムステップ(拡散の段階)を固定して非同期パイプライン化する「Timestep-forcing Pipeline Parallelism」という独自方式で高速化しています。 従来の配信用バーチャルヒューマンは、事前にモーションキャプチャした動きを再生する方式が主流でしたが、本技術は音声入力だけからその場でリアルタイムに映像そのものを生成する点が異なります。台本にない即興のやり取りにも対応できる可能性がある一方、複数GPU(H800×5枚、計400GB VRAM)でのフル性能運用が前提で、単体GPUでも80GB以上、量子化を使っても48GB級のGPUが必要になるなど、現時点では個人利用よりも制作会社・配信スタジオでの導入が現実的な規模感です。コード・モデル重みはApache-2.0で商用利用も可能で、GitHubから入手できます。
License
モデル・コードともにApache-2.0で公開。商用利用制限の明記なし
Sources
Related Works
- JoyAvatar
同系統の無限長リアルタイムアバター生成モデル
- KlingAvatar 2.0
Klingによる高品質音声駆動アバター生成技術