Fragmenta
MAz-Codes(個人開発)/2026-10
Overview
自分の音源でStable Audio 3を追加学習(LoRA)し、そのモデルでの生成とライブ演奏までを1本で行えるデスクトップアプリ。v1.2.0を2026-10-27に公開。
技術のポイント
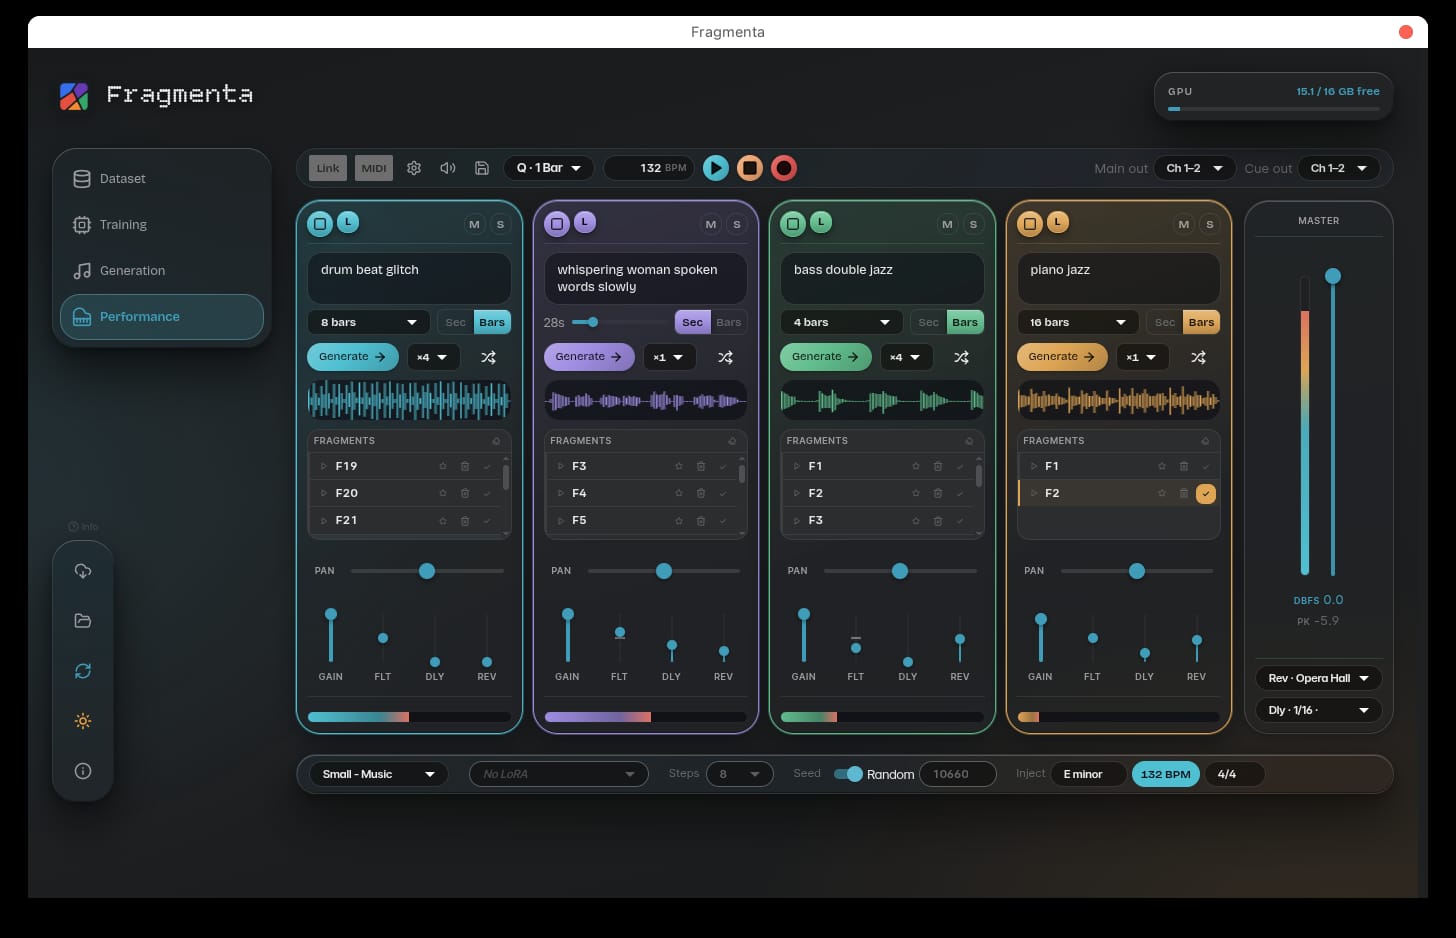
すごい点は、「音源を集める→タグ付け→追加学習→生成→ライブ演奏」という流れが、1つのデスクトップアプリで完結することです。自分の録音やサンプル集を読み込むと、自動でタグ付けして学習し、そのブランド専用・作家専用の音のモデルが作れます。さらに「Performance Mode」では4チャンネルのライブサンプラーとして、生成した音を効果音つきで鳴らしたり、Ableton Link(複数のソフト・機材のテンポを合わせる仕組み)やMIDIコントローラーで操作したりできます。広告・体験づくりでは、ブランド固有の音世界をAIで量産して展示や映像に使う、来場者の動きに応じて音素材をその場で生成・演奏するインスタレーション、ライブイベントでのAI即興演奏などが作れそうです。サンプルを自分で学習させるため、他人の曲に似すぎるリスクも抑えやすい点が、クリエイターには安心材料になります。
技術の詳細
仕組み:土台はStability AIのStable Audio 3(文章から音を作る拡散モデル。ノイズから少しずつ音を浮かび上がらせる方式)です。Fragmentaはこの巨大モデルを丸ごと作り直さず、LoRA/DoRA/BoRAと呼ばれる「小さな差分だけを学習する」方法で、手元の音源の癖を覚えさせます。音源のタグ付けはDSP解析かLAION-CLAPという音の自動分類モデルが担当します。画面はDataset・Training・Generate・Performanceの4ページ構成で、READMEにスクリーンショットとデモ動画があります。 従来との違い:これまでは学習用スクリプトを自分で動かし、生成も別ツール、演奏はDAWと、環境を行き来する必要がありました。Fragmentaは学習から演奏までを1アプリにまとめた点が新しさです。なお音声の編集機能(スタイル変換・インペイント等)は上流の精度が足りないため現状オフになっています。 使うには:Windows/macOS/Linux対応で、READMEにインストールスクリプトがあります。生成だけなら一般的なGPUで動きますが、Mediumモデルはフラッシュアテンション2対応のNVIDIA GPUが必要です。モデル重みは別途ダウンロードし、Stability AI Community Licenseの条件確認が要ります。アプリ自体は無料のオープンソースですが、AGPL-3.0なので改変して配布・提供する場合はソース公開義務があります。
License
アプリ本体はAGPL-3.0。同梱のStable Audio 3コードはMIT。モデル重みは再配布されず、Stability AI Community Licenseに従う。
Sources
Related Works
- stable-audio-tools
Stability AIの音声生成モデルの学習・推論ライブラリ。Fragmentaの土台にあたる。
- Ableton Link
複数アプリ・機材のテンポを同期させる仕組み。Fragmentaのライブ演奏モードが対応。