Any4D
Carnegie Mellon University (AirLab)/2026-06
Overview
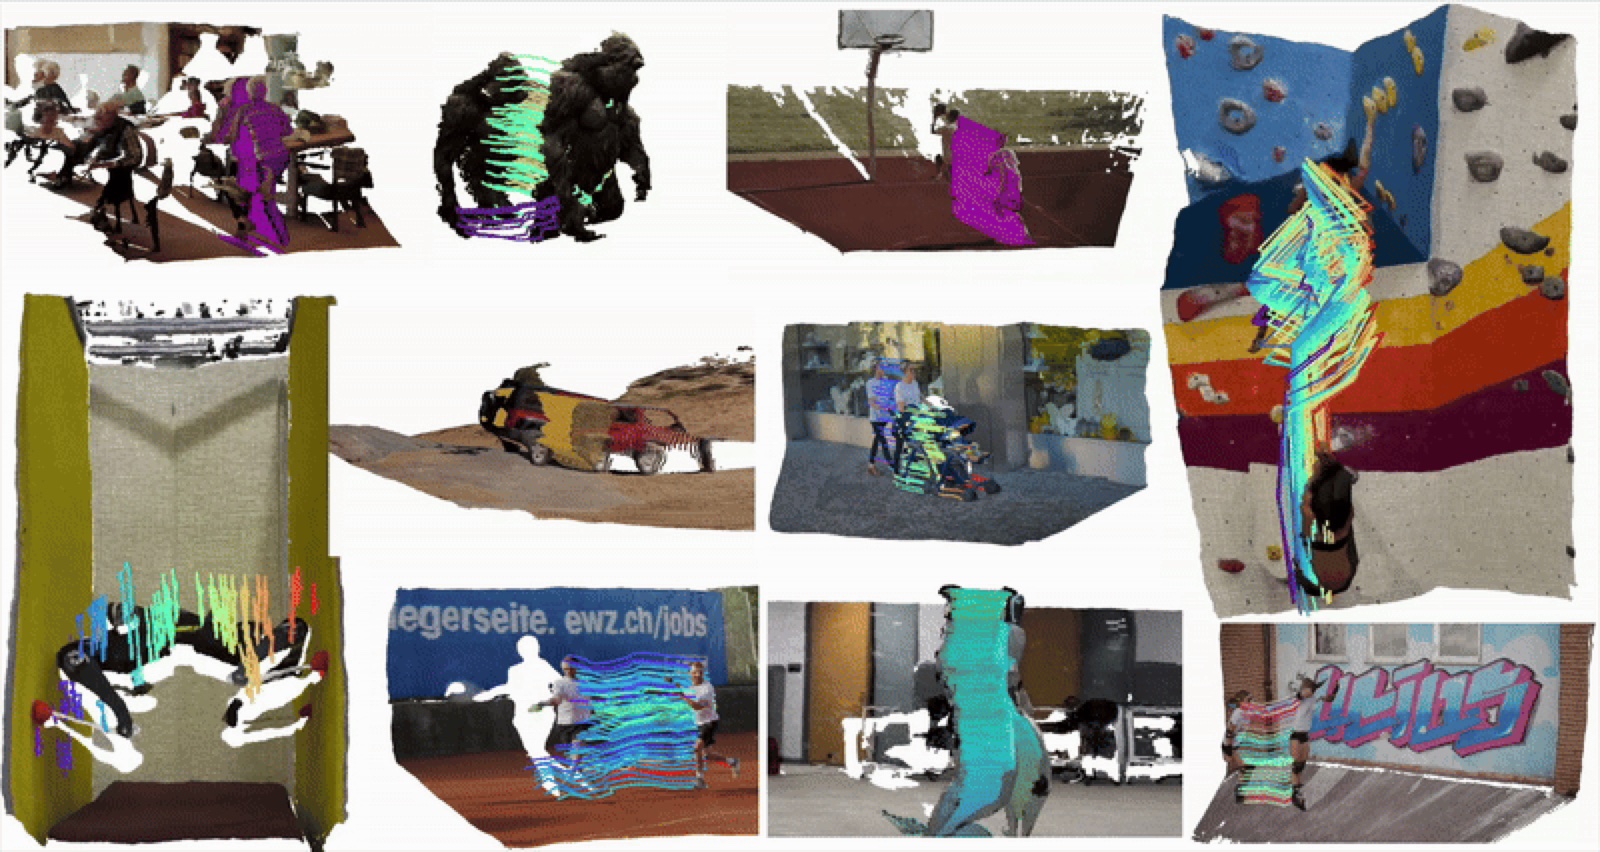
RGB動画に加えRGB-D・IMU・レーダーなど任意のセンサ入力から、実寸スケールの動く3D世界(メトリック4D)を1回の推論で復元するフィードフォワードモデル。
技術のポイント
動く被写体を含んだ世界を、実際の寸法(メートル単位)付きの“動く3Dデータ”として復元する技術です。すごいのは、動画を1回入れるだけで結果が出る『フィードフォワード型』であること。従来は時間のかかる調整計算が必要でしたが、Any4Dは誤差を従来の2〜3分の1に抑えつつ、処理を約15倍速くこなすと報告されています。しかも普通のRGB動画に加えて、深度カメラ・IMU(スマホにも入る動きセンサー)・レーダーなど手元にあるセンサーを自由に足せて、足すほど精度が上がります。広告や体験づくりでは、ロケハンで撮った映像から実寸大の3D空間を即座に起こしてCG合成やAR演出の下地にしたり、イベント会場をスキャンして空間演出を事前プレビュー(プレビズ)したりと、空間系の制作フローを一気に短縮できます。
技術の詳細
Any4Dは、動画の1コマごとに『各ピクセルがどれだけ動いたか(動き)』と『どんな奥行きか(形)』を同時に予測します。内部では世界を2つの部品に分けて捉えるのが特徴で、ひとつはカメラから見た手前の情報(各点までの距離=深度と、カメラのレンズ特性)、もうひとつは世界全体を基準にした情報(カメラの位置や、シーン内の物の流れ)。この組み合わせで、カメラ自身の動きと被写体の動きを切り分けながら、実寸スケールの“動く立体地図”を作ります。 これまでの4D(3D+時間)復元は、シーンごとに長い最適化計算を回して辻褄を合わせるのが一般的で、結果が出るまで待たされました。またRGB映像だけでは『実際の大きさ』が定まらず、スケールが曖昧になりがちでした。Any4Dは1回の推論で答えを出すうえ、深度カメラやIMU、レーダーといった追加センサーの情報を柔軟に取り込めるので、実寸の確からしさと精度を両立できます。論文では誤差を2〜3分の1に、速度を約15倍にと報告されています。 開発元はカーネギーメロン大学(AirLabなど)。コードはGitHubでApache-2.0ライセンス(商用利用可)で公開され、HuggingFace上に試せるデモもあります。実行にはPythonとGPU環境が必要で、追加センサーを使う場合はその入力データも要ります。現時点では研究成果として公開された段階のため、制作に使うなら自社のパイプラインに組み込む前提の検証から始めるのが現実的です。
License
Any4DリポジトリはApache-2.0(374 stars)