Qwen-Video-Edit
Yunpeng Bai, Yossi Gandelsman, Michaël Gharbi, Qixing Huang (UT Austin / Adobe Research)/2026-08
Overview
動画を指示文だけで編集できるAI。画像編集モデルを流用し、動画のコマを1枚の巨大画像のように並べ替えることで実現した。
技術のポイント
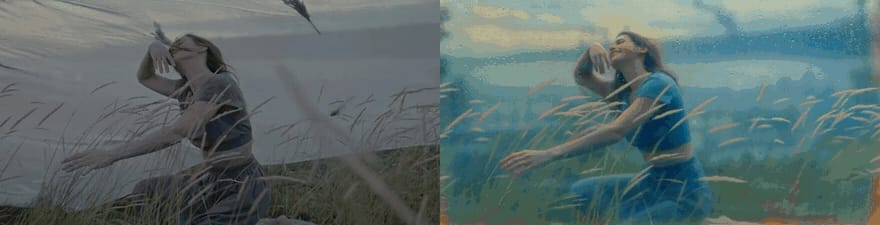
通常、動画編集AIを作るには動画データだけで大量に学習させる必要があるが、この技術は既存の「画像編集AI」(Qwen-Image-Edit)をほぼそのまま流用する点が独自。動画の各コマ(フレーム)を写真アルバムのようにタイル状に並べて1枚の巨大な画像に見立て、画像編集モデルにそのまま渡す。小さな変換パーツを挟むだけで、動画特有の圧縮データと画像編集モデルの間を橋渡しする。広告制作では「この俳優の服を赤に変えて」「背景をロボット工場に差し替えて」といった指示文だけで、撮影済み映像の一部をピンポイントで書き換えられる。ロケ再撮影や高額なVFX作業をせずに、素材の使い回し幅を大きく広げられる可能性がある。
技術の詳細
動画は連続する静止画(フレーム)の集まりだが、この技術はそれらのフレームをタイルのように並べて1枚の巨大な仮想画像として扱う。画像編集AIはもともと「1枚の画像の一部だけを指示通り書き換える」訓練を受けているため、動画フレームを並べたタイル画像に対しても同じ要領で編集できてしまう、という発見が出発点になっている。動画データと画像データの間には「VAE」と呼ばれる圧縮変換の仕組みの違いがあるが、そこを小さな変換レイヤー2つで橋渡しすることで、大掛かりな再学習なしに動画編集を実現している。 従来の動画編集AIの多くは動画データだけを使ってゼロから(または大規模動画モデルをベースに)学習させる必要があり、開発コストが高かった。この手法は画像編集モデルの能力を「借用」することで学習データ・計算コストを抑えつつ、長尺動画や縦型(ポートレート)動画にも対応する。仕上げにWan 2.2による数ステップの追加処理を挟み、時間方向のちらつきを抑える工夫も入っている。 コードとモデル重みはGitHub・Hugging Face・ModelScopeで公開されており、実行にはCUDA対応のNVIDIA GPUとPython 3.10〜3.12環境が必要。ファインチューン済みモデルは1つ約40GBあり、まとまったVRAM・ストレージを要する。2026年8月20日の更新でComfyUI連携と480P/720Pのチェックポイントが追加され、通常のComfyUI環境からも扱いやすくなった。研究コードのため商用利用は同梱ライブラリのライセンス確認が必要。
License
リポジトリ自体には明示ライセンスがなく、同梱コードはDiffSynth-StudioとDittoの上流ライセンスに従う。商用利用可否は個別確認が必要
Sources
Related Works
- Qwen-Image-Edit
本技術がベースにした指示ベース画像編集モデル
- Ditto-1M
ファインチューンに使われた動画編集トリプレットデータセット
- Wan 2.1/2.2
動画VAEおよび時間方向強化に使われるバックボーン