UNITAS
DexForce / CUHK-SZ ほか/2026-10
Overview
ロボットの手や人の手の動きと、それによって物の置かれた空間がどう変わるかを、同じ3D座標の中でまとめて予測する「3D世界モデル」。1.7Bパラメータで、推論コードと学習済みモデルが公開されている。
技術のポイント
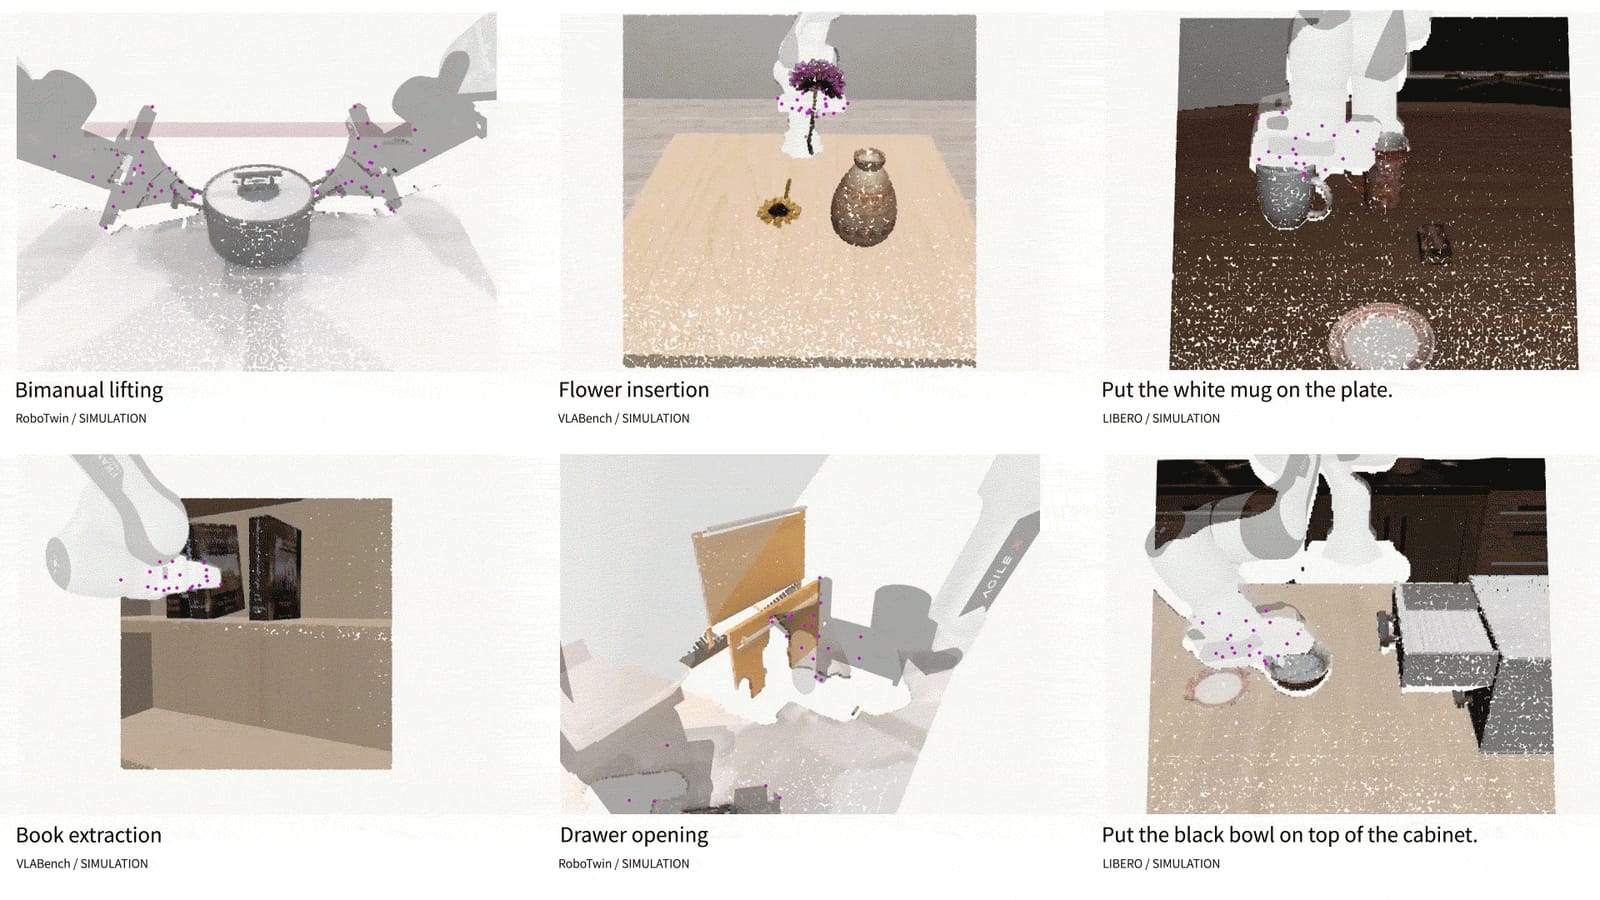
何がすごいか:映像(2D)を丸ごと生成するのではなく、空間内の点の動き(点群の軌跡)として「手が動くと、物がどう動くか」を予測します。ロボットの腕でも人の手でも同じ表現で扱えるので、動きの種類が違ってもひとつのモデルで予測できます。論文ではロボット操作のベンチマークで、既存手法(PointWorld)より予測の位置誤差を最大49%減らしたと報告しています。広告・体験づくりでの使い道:手でつかむ・押す・積むといった動作が空間にどんな変化を起こすかを、映像を作らずに3Dの動きとして得られます。たとえばインタラクティブ展示で来場者の手の動きから物が動く様子を先読みして演出する、ロボット演出の動きを事前にシミュレーションする、といった用途の試作に使えそうです。実際に使うには研究用の環境構築が必要で、制作現場向けのツールではない点には注意が必要です。
技術の詳細
仕組み:カメラ映像から、空間の位置(メートル単位の3D座標)を持つ点の集まりを作ります。ロボットのグリッパーや人の手は「3D空間を動く点の軌跡」で、物の変化は「各点がどれだけ動いたか(変位)」で表します。点の軌跡という共通言語にしたので、ロボットでも人の手でも同じモデルで扱えます。ロボットの動作生成と、動作を入れたときの空間の変化の予測という2つの機能を同じモデルで持ちます。 従来との違い:従来の世界モデルの多くは、次のフレームの画像を予測する方式でした。UNITASは3D座標のまま予測するため、カメラの位置や見た目に左右されにくく、距離やスケールの情報も保てます。論文ではLIBEROで成功率99.8%、RoboTwinのシーン予測でPointWorld比の誤差低減を報告しています(いずれも著者報告値で、筆者側で再現は確認していません)。 使うには:GitHubにはインストール手順、推論・評価コード、結果を3Dで見る可視化スクリプト(ポート8080のビューア)があり、Python 3.10とCUDA対応のGPUが想定されています。学習済みモデルはHugging Faceから無料で入手できます。ただし学習コードと学習データは「公開予定」の状態です。ライセンスはApache-2.0で商用利用も可能です。
License
コードはApache-2.0。重みはHugging Faceで配布。ベースのFlorence-2-largeは別途ダウンロードが必要。学習コードと学習データは未公開(推論・評価コードのみ)。