Openjutsu
D3voz(個人開発者)/2026-10
Overview
動画と1枚のキャラクター写真を渡すだけで、動画の主役をそのキャラクターに差し替える完全ローカルのツール。髪や服の変更、物体の削除、背景の変更にも対応する。
技術のポイント
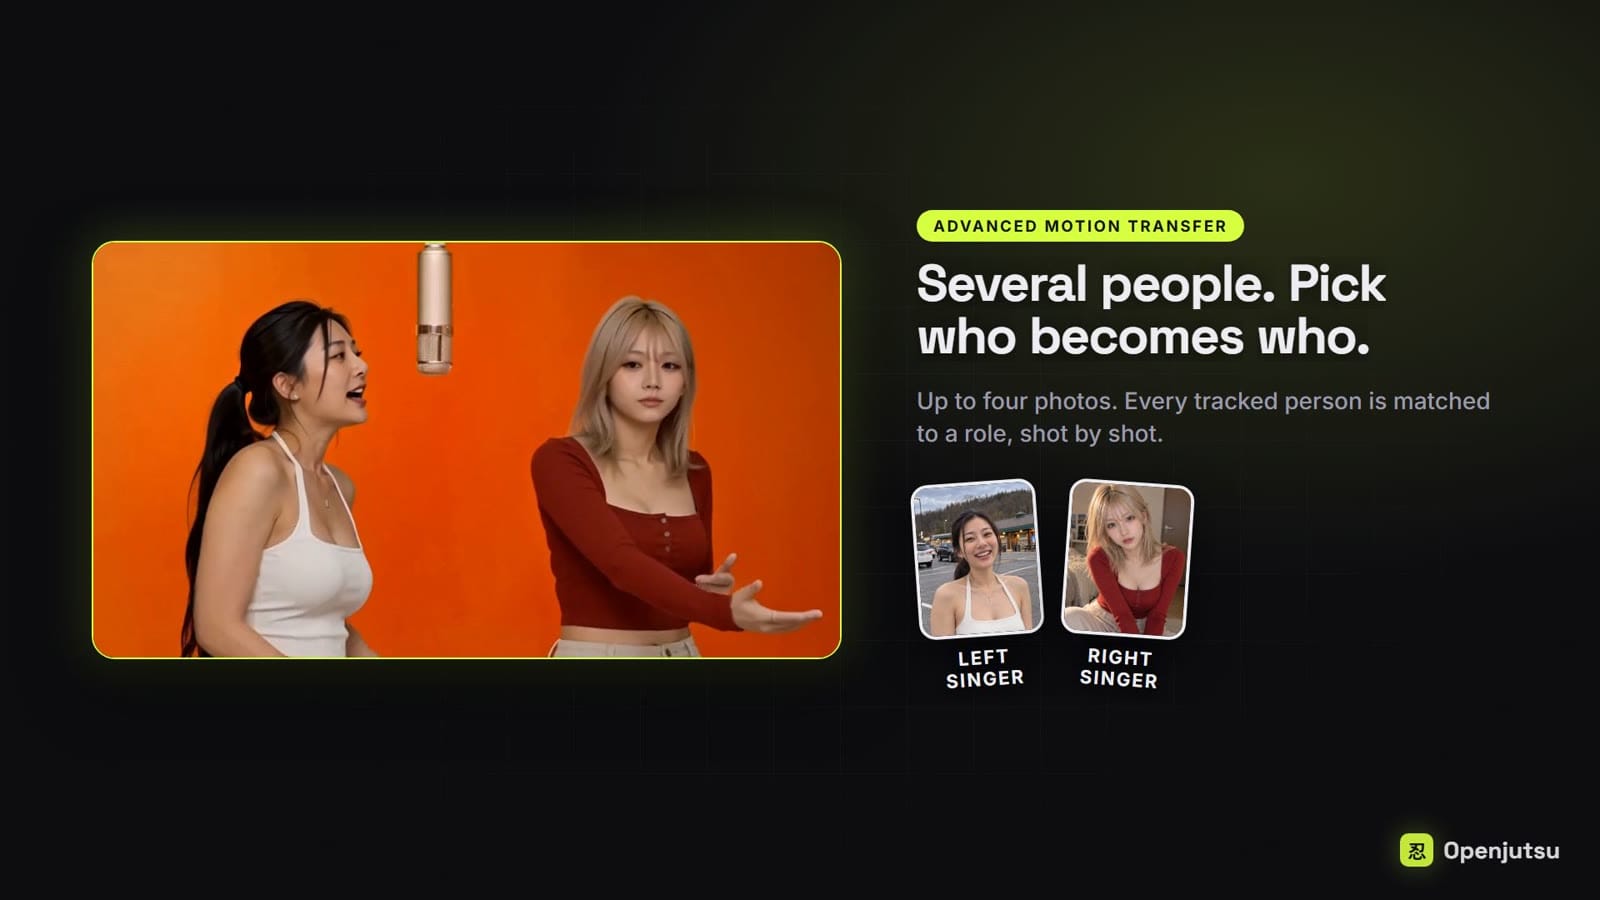
動画と差し替えたいキャラクターの写真を用意して Generate を押すと、映像内の人物が写真のキャラクターに置き換わります。カメラワーク、カット割り、動き、音声はそのまま残ります。複数人が映る場面では、誰を誰に差し替えるかを人物ごとに指定できます。髪型や服だけを変える、車やサングラスのような物を消したり描き足したりする、といった部分的な編集にも対応します。顔が小さく映ると崩れやすいという弱点には、顔だけを大きく描き直して貼り戻す『Fix faces』を用意しています。広告制作では、撮影済みの素材を使い回してキャラクターやタレントを入れ替えるバリエーション制作、架空キャラクターの実写風プロモ動画、ライティングを17種類から選んで雰囲気を変える見せ方の検討などに使えそうです。再撮影のコストを抑えながら、複数パターンの映像案を短時間で並べられます。
技術の詳細
仕組みは次のとおりです。まず SAM 3.1 という物体追跡モデルで動画内の人物を追いかけ、Qwen3-VL という画像を読めるAIが各カットの様子を文章にします。その情報をもとに、MiniMax H3 という動画生成モデルが、動きを保ったまま人物だけを描き直します。画面は Next.js 製の操作画面で、裏側では ComfyUI のワークフロー(処理の流れを部品でつないだ設計図)が動いています。Comfy 公式のリファレンスアプリ comfy-reshoot の作り方を踏襲しています。 従来は ComfyUI のノードを自分でつないで、人物のマスク作成、プロンプト作成、生成、仕上げを手作業で行う必要がありました。Openjutsu は『簡単モード』『複数人モード』『物体モード』『写真から作るモード』『顔補正と色補正の後処理』をボタン操作にまとめています。実行前には、足りないカスタムノードやモデルファイルを自動で検出して案内する機能もあります。 使うには、NVIDIA GPU(動作確認は RTX 4060 Ti 16GB、システムメモリ 64GB)、ComfyUI 0.41.2 以上、Node.js 22.6 以上が必要です。SolarRenderer など十数個のカスタムノードと数十GB規模のモデルを入れる準備が要るため、初回は導入に時間がかかります。費用はかかりません。GitHub から取得して start_openjutsu.bat で起動します。
License
Openjutsu 本体は MIT。ただし MiniMax H3・SAM 3.1・SolarRenderer・Qwen3-VL などのモデル重みは、それぞれのライセンスに従う必要がある。
Sources
Related Works
- comfy-reshoot
Openjutsu が手本にした Comfy 公式のリファレンスアプリ。
- SolarRenderer
Openjutsu の『写真から作るモード』で使う4ステップの動画描画 LoRA。
- comfyui-h3-oneclick-swap
Openjutsu の人物差し替え処理を担う ComfyUI ノード群。