FlashMotion
Kaixing Yang ほか(FlashMotion 研究チーム)/2026-11
Overview
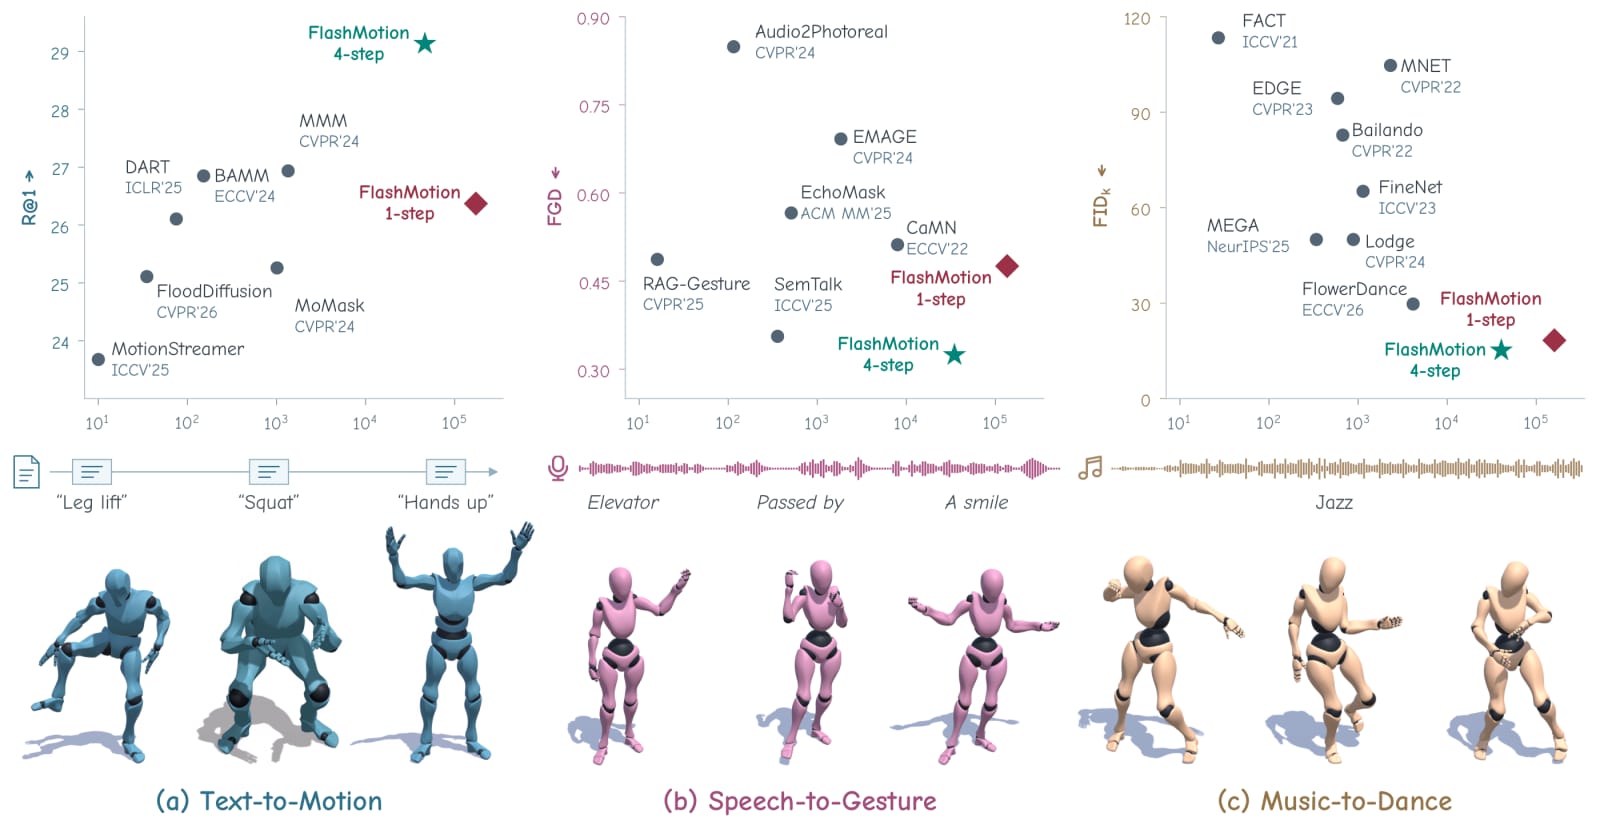
文章・音声・音楽のどれからでも、長尺の3D人体モーション(動作・身振り・ダンス)を1〜4ステップの少ない計算で一気に作る研究。コードと学習済み重みが公開されている。
技術のポイント
すごいのは速さです。従来のAIモーション生成は、ノイズから何十回も少しずつ整えて動きを作るため、長い動きほど待ち時間が膨らみました。FlashMotion は1〜4回の計算で仕上げます。1万フレームという非常に長い動きでも、文章からの生成で13.6倍、音声からの身振りで4.4倍、音楽からのダンスで9.8倍と、比較対象の最速手法より速いと報告されています。使い道は広告・体験づくりに直結します。たとえば、キャンペーン曲を流すと踊るデジタルアバター、ナレーションに合わせて身振りをつけるバーチャル案内役、「ゆっくり歩いて手を振る」と入力するだけで動くキャラクターが挙げられます。プロジェクトページには、ロボット動作・XRキャラクター・スマホアバターへの応用デモも載っています。待ち時間が短いので、クライアントの前でその場で動きを作り直すような使い方にも向きます。
技術の詳細
仕組みは2つの工夫でできています。1つ目は「MeanFlow」という考え方です。従来の手法は、ノイズだらけの状態から完成形まで坂道を少しずつ下るように何十回も計算していました。MeanFlow は「この地点から完成形までの平均的な進み方」を学習しておき、坂道を数歩で一気に下ります。これに、関節が不自然に曲がらない、前後のフレームがなめらかにつながる、という制約を加えています。2つ目は、各ステップの計算を軽くする工夫です。長い動きの処理に Transformer ではなく Mamba 系の軽量な構造(BiMamba)を使い、文章・音声・音楽といった条件の情報を各層に混ぜ込む方式で、長さが伸びても計算量が膨らみにくくしています。さらに、動きの一部だけを差し替える編集では、境目をなめらかにぼかすマスクを使っています。 従来との違いは、速さと品質を両立したと主張している点と、1つの枠組みで3種類の入力(文章→動き、音声→身振り、音楽→ダンス)を扱える点です。1ステップ版と4ステップ版の学習済みモデルが、タスクごとに計6個用意されています。 使うには、Linux と NVIDIA GPU が必要です(動作確認は Linux 前提)。環境は conda で構築し、推論は GPU 1枚で動きます。ただしデータセット(BABEL・BEAT2・FineDance)と人体モデル SMPL-X は自分で申請・入手する必要があり、評価用データは約35GBあります。費用はGPU環境のみで、導入には Python と深層学習環境の知識が要ります。出力は人体の骨格データなので、Blender などに読み込んで使うには変換の作業が別途必要です。
License
FlashMotion のコードは MIT。SMPL-X 等の身体モデルや BABEL・BEAT2・FineDance の各データセットは別ライセンス・申請制で、商用利用は個別確認が必要。学習済み重みは Hugging Face(yangkaixing/FlashMotion-models)で公開。
Sources
Related Works
- T2M-GPT
文章から3D人体モーションを生成する代表的な公開実装(VQ-VAE + Transformer)。
- Motion Diffusion Model (MDM)
拡散モデルによる文章→モーション生成の基礎的な研究。コード公開。
- EDGE
音楽からダンスを生成する拡散モデル。編集機能つき。