ReViV (Reconstructing the Viewer and the View in 4D from Monocular Egocentric Video)
ETH Zürich, Delft University of Technology, Microsoft/2026-07
Overview
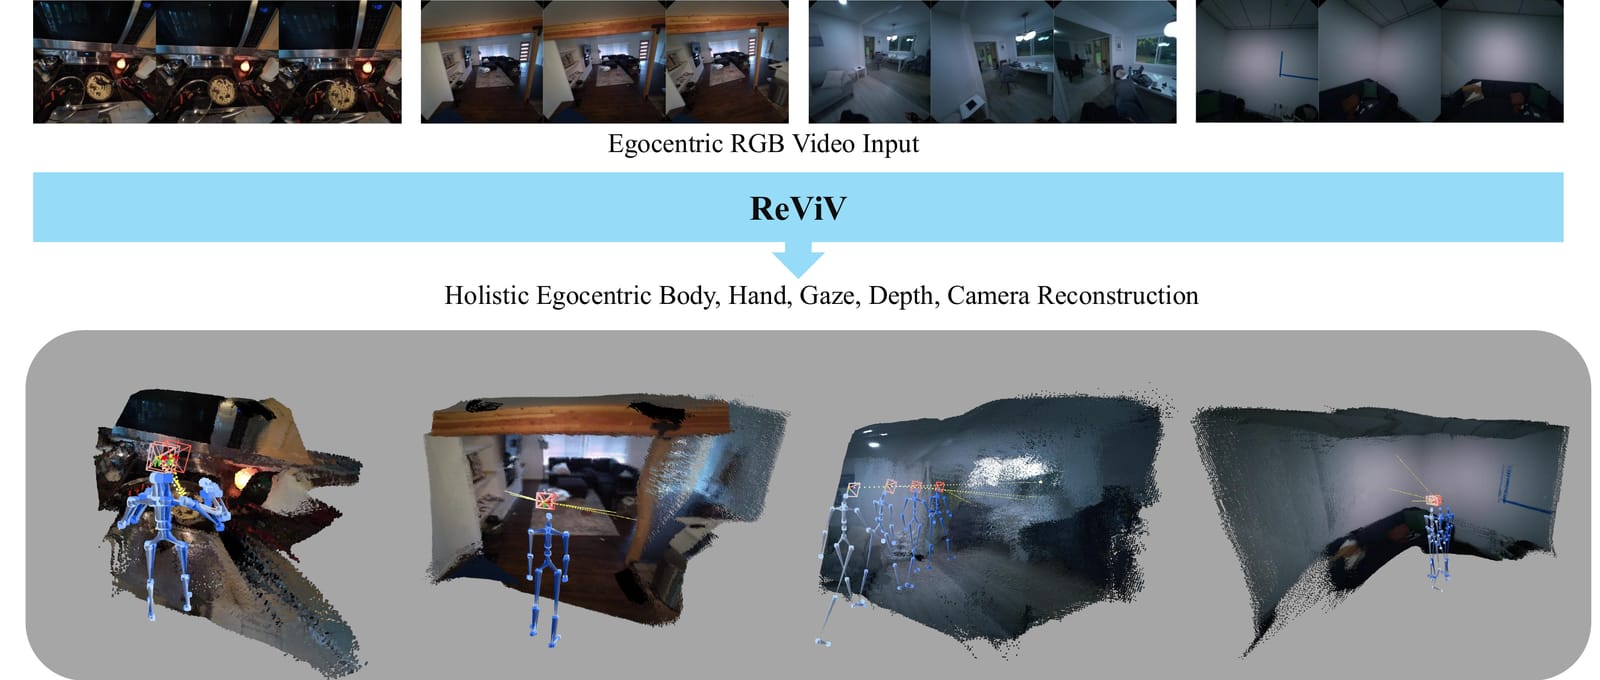
単眼のエゴセントリック(一人称視点)RGB動画1本だけから、装着者の全身・手・視線の動きと、周囲シーンのカメラ軌跡・深度を同時に4D復元する統合フレームワーク。ECCV 2026採択。
技術のポイント
従来手法はカメラ軌跡などの補助入力が必要だったり、人物の動き推定とシーン復元を別々に解いていて処理も遅かったが、ReViVはRGB映像のみからマスク生成トランスフォーマーで両者を同時に一括推論し、EgoAlloやHaMeRなど既存手法に対し精度で上回りつつ100倍以上高速化を実現した。広告・体験制作では、GoProやスマートグラス等の一人称視点映像だけから装着者の全身・手・視線の動きとカメラ軌跡を丸ごと3D/4D復元できるため、実写のPOV映像をそのままモーションキャプチャ素材やバーチャル空間への配置データとして再利用したり、視線トラッキングを使ったアテンション可視化コンテンツなどに応用できそうだ。
技術の詳細
手法の核はModality-specific VQ-VAEでRGB・深度・カメラ・視線・手・全身の各信号を離散トークン化し、Masked Generative Egocentric Transformer(MGET)がランダムにマスクされたトークンを予測することで、モダリティ内の時間変化とモダリティ間の相関を同時に学習する点にある。推論時は観測されたRGBトークンのみを条件に、身体・シーンの未観測状態を反復的に生成し、最後に床面フィッティングで視者と視界を共通の4D座標系に整合させる。 HoloAssist、HOT3D、ARCTIC、Aria Digital Twin、TACOなど複数ベンチマークで評価されており、体動作復元ではEgoAlloの100倍、UniEgoMotionの10倍以上高速、手の動き復元ではHaMeRの100倍、Dyn-HaMRの400倍以上高速と報告されている。 利用にはPythonの学習・推論環境構築(GitHub上にconda環境用YAMLあり)と、Polybox経由で配布される事前学習済みモデル重み(研究目的限定ライセンス)が必要。
License
コード自体はApache 2.0だが、公開されている学習済みモデル重みは非商用の研究目的利用に限定(Sample Code Licenseにより商用利用不可)
Sources
Related Works
- EgoMono4D
同じくエゴセントリック動画からの自己教師あり4Dシーン復元を行う関連研究