CustomDance
Xulong Tang ほか(SIGGRAPH Asia 2026 採択)/2026-09
Overview
音楽と文章の指示から、AIが「振付家のように」ダンスを段階的に作り上げる3Dダンス生成システム。全自動ではなく、候補を選びながら人が振付を仕上げていく対話型のコードが公開された。
技術のポイント
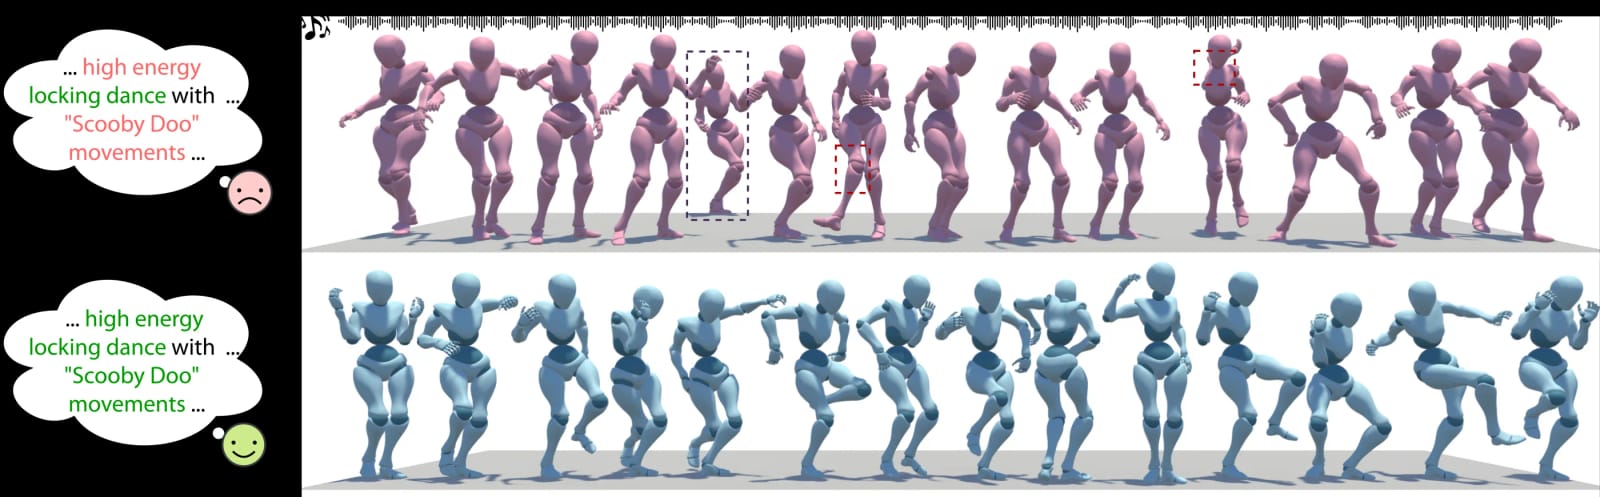
これまでの音楽→ダンス生成AIは「曲を入れたら踊りが出てくる」一発勝負で、出てきた動きが気に入らなくても細かく直せませんでした。CustomDanceは人間の振付家の進め方をまねて作業を3段階に分けています。まずAI(画像・音声も読める大規模言語モデル)が曲と「サビで大きく跳ぶ」などの文章指示を読み、見せ場の位置(アンカー)を提案します。次に、その位置ごとにダンスの動きライブラリから似合う候補を複数見せてくれるので、人が好きなものを選べます。最後に、選んだ動き同士を拡散モデル(ノイズから少しずつ形を作るAI)が曲に合わせて自然につなぎます。広告・体験づくりでは、ブランドソングに合わせた踊りのモーションを、ディレクターが「ここはこの動き」と指定しながら作る使い方が考えられます。バーチャルタレントのライブ演出、SNS用ダンス動画の絵コンテ代わりの3Dプレビュー、ゲームやXRのキャラクターダンスの初稿づくりなど、「AIに丸投げせず意図を反映したい」場面と相性が良い研究です。
技術の詳細
仕組みは料理の段取りにたとえられます。①MLLMが曲と指示文から「どこで何を盛り込むか」のメモ(時間軸上のアンカー)を作る。②各アンカーで、事前に用意したダンス動作の「引き出し」から、曲の雰囲気と文章に合う動きをマルチモーダル検索(音と言葉の両方で探す)して複数候補を提示する。③人が選んだ動きの間を、曲に条件づけた拡散モデルのインペインティング(穴埋め)でなめらかにつなぐ。何度でも選び直してやり直せ、動きの強弱の可視化も見られます。従来の音楽→ダンス手法は入力から結果までがブラックボックスで、部分的な修正や意図の反映が苦手でした。本研究は「候補提示→選択→補間」という人間主導のループにした点が違いです。 使うには、GitHubのコードに加え、FineDanceデータセット、SMPL人体モデル(登録して入手)、配布されている学習済みモデル一式が必要です。環境はPython 3.10、CUDA 12.8対応のNVIDIA GPU、Mamba系のCUDA拡張のビルドがあり、Linux前提でコマンド操作に慣れた人向けです。意図解析にはOpenAI APIキー(別途従量課金)が必要で、SMPLの非商用条項もあるため、実案件への直接利用は権利確認が前提になります。付属のブラウザ上のSMPLエディタでダンスを確認・編集でき、出力は3Dモーションデータなので、CGツールへの取り込みは追加作業になります。まずは社内の検証・企画のプロトタイプとして試すのが現実的です。
License
コードはMIT。ただし学習・実行にはFineDanceデータセットとSMPLモデル(SMPLは非商用ライセンス)が必要で、商用利用は各ライセンスの確認が要る。意図解析にOpenAI APIキー(従量課金)を使う。
Sources
Related Works
- FineDance
本研究が学習に使う、プロダクション品質のダンスモーションデータセットと生成手法。
- Bailando
音楽から3Dダンスを生成する代表的な先行研究(CVPR 2022)。
- AIST++ API
ダンスモーション研究で広く使われるGoogleのデータセット用ツール。