StreamTalk
東京大学 / Alibaba Tongyi Lab / 南洋理工大学 / 中国人民大学(国際共同研究)/2026-08
Overview
スピーチ音声に合わせてリアルタイムで自然な身振り(ジェスチャー)を生成し続けるAI技術。長時間再生でも動きが徐々にズレていく問題を、要所ごとに姿勢を検算・修正する仕組みで抑えた。
技術のポイント
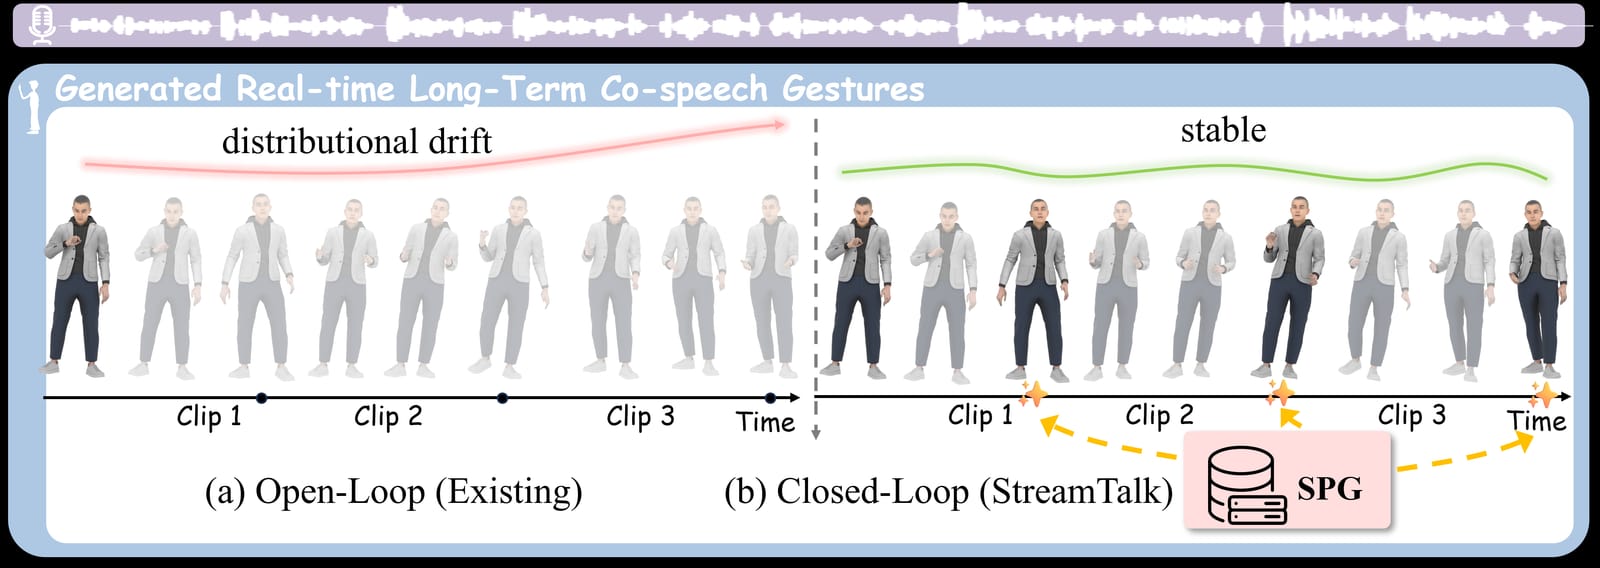
人が話しているときの身振り手振り(相槌のうなずき、手の動きなど)をリアルタイムでCGキャラクターに生成し続ける技術です。従来のAIは動きを少しずつ予測して繋げていく方式のため、長く喋らせ続けると徐々に姿勢がズレていき、キャラクターが不自然に傾いたり手が変な位置に固定されたりする問題がありました。StreamTalkは「生成→検索→微調整」を数秒ごとに繰り返し、あらかじめ用意した自然な決めポーズに軌道修正しながら動きを作るため、長時間のライブ配信やバーチャルヒューマンの生放送でも破綻しにくいのが特徴です。76fpsというゲーム並みの速度で動くため、VTuberの自動アバター演技やAI司会者、店舗の接客アバターなど、台本のない「その場で話す」用途に向いています。
技術の詳細
仕組み: 音声が入力されると、AIはまず数秒分の身振りをまとめて予測しますが、そのクリップの末尾に「ここに着地すべき自然な姿勢」を、事前に集めたその話者らしい決めポーズのデータベースから1つ選んで割り当てます。そのうえで選んだ着地姿勢に合うよう動きを引き直す(微調整する)——このサイクルを数秒ごとに繰り返すことで、遠い未来までズレを持ち越さない設計です。手・体幹・全身の移動を別パーツとして扱うことで、手だけが激しく動いても体全体がつられて暴れるような不自然さも防いでいます。 従来との違い: 既存のリアルタイム身振り生成は「直前の動きから次の一瞬を予測する」を繰り返す将棋倒し式で、誤差が雪だるま式に蓄積し、長時間再生すると腕が体にめり込んだり動きが単調になったりしていました。要所要所で「正解に寄せ直す」仕組みを挟むことでこの蓄積誤差を大幅に抑えたのが最大の進歩です(ECCV 2026採択)。 導入に必要なもの: GitHubで学習・推論コードがMITライセンスで公開されており、Python環境(conda)とGPUがあれば動作します。ただし公開されているのは研究用実装で、実際に自社キャラクターへ組み込むには3Dキャラクターのリギングや音声認識との連携など追加のエンジニアリングが必要です。商用のVTuberツールやリアルタイムアバターサービスへの応用を狙う場合、まずは研究デモとして自社音源で試すところから始めるのが現実的です。
License
コード本体はMITで商用利用可。ただし推論に必要な外部アセット(ベースモデル等)は別途各自のライセンスに従う必要がある。
Sources
Related Works
- EMAGE
表情・全身の共発話ジェスチャー生成モデル(比較対象)
- GestureLSM
潜在空間拡散による共発話ジェスチャー生成(比較対象)
- LiveGesture
ストリーミング型の共発話ジェスチャー生成モデル