Anima Reference Adapter (ComfyUI-Anima-Ref-Adapter)
ElectronGirl(個人開発者)/2026-10
Overview
アニメ系画像モデル Anima に、参照画像を1枚渡すだけで、キャラクターと画風を保ったままポーズ・背景・構図をプロンプトで変えられる ComfyUI 用アダプター。
技術のポイント
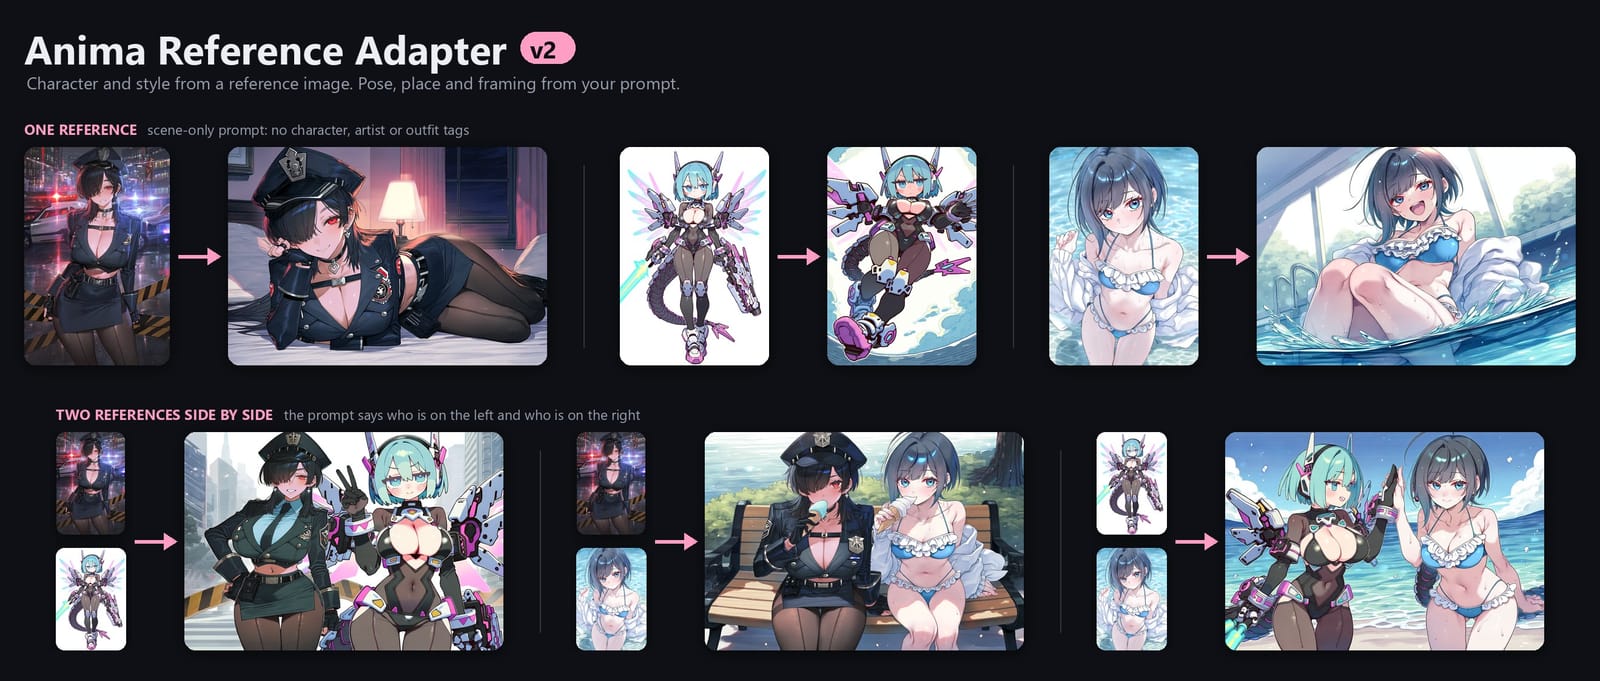
参照画像を1枚読み込み、シーンだけを文章で書くと、同じキャラクター(髪、目、服、小物)と画風が保たれたまま、ポーズや背景を変えた絵が出力されます。キャラクター名、作家名、衣装のタグは不要なので、オリジナルキャラクターにも使えます。参照画像を2枚並べれば、2人のキャラクターを1枚に描くこともできます。広告・体験づくりでは、マスコットや架空キャラクターの設定画から、カフェ、海辺、空を飛ぶシーンなどの絵コンテや動画用の素材画像を量産する使い方が考えられます。LoRA(追加学習)を作る手間を省いて、キャラクターの一貫性を保った画像を並べられるため、動画生成の元画像づくりやキャラクターシートの検証に向いています。ただし重みは非商用ライセンスのため、実案件では企画検討や試作の段階での利用に限られます。
技術の詳細
仕組みは、参照画像を一度だけ内部表現に変換し、それを画像生成モデル Anima の途中の層に追加の手がかりとして渡すものです。この処理を軽量な追加学習(rank 64 の LoRA、183MB)で実現しています。学習には2,300キャラクター・1,952の画風・計15,600枚のデータを使っています。参照の変換は1枚につき1回だけなので、前の試作版より約2倍速く、RTX 3060 Ti(VRAM 8GB)で832x1216の画像が約65秒で生成できます。 従来のキャラクター固定は、キャラクターごとに LoRA を学習するか、キャラクター名をタグで指定する必要がありました。このアダプターは学習不要で、初めて見る絵柄の参照にも対応します。ポーズ・背景・構図はプロンプト側に任せるため、参照画像の構図に引きずられにくい設計です。 使うには ComfyUI、Anima base v1.0、Qwen3-0.6B テキストエンコーダー、Qwen-Image VAE が必要です。ノード1つをカスタムノードとして git clone で追加するだけで、初回実行時に重みを自動でダウンロードします。ただし、資金不足のため開発は停止中で、キャラクターと画風を別々に参照する機能は未公開です。学習コードと実験記録は別リポジトリで公開されています。
License
コードは Apache-2.0。学習済み重みは CircleStone の非商用ライセンスで、商用利用はできない。
Sources
Related Works
- IP-Adapter
参照画像を拡散モデルに条件として与える代表的なアダプター手法。
- Anima (circlestone-labs)
このアダプターの土台になっているアニメ系画像生成モデル。
- anima-ref-adapter-research
学習コード・データ生成・実験ログを公開した研究リポジトリ。