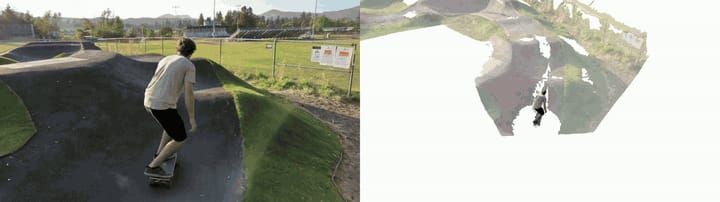
ReLift (Dense 3D Tracking as Lifted Trajectory Repair)
Technion / NVIDIA/2026-11
Overview
普通の動画1本から、映っている全ピクセルが3D空間でどう動いたかを追跡するモデルです。壊れた軌跡を直す小さな補正モデルで精度を上げています。
技術のポイント
ふつうの動画の中の「画面のどの点が、奥行きも含めてどこへ動いたか」を、全ピクセルぶん3Dの軌跡として取り出せる技術です。既存の2D追跡と3D形状推定モデルをそのまま組み合わせ、間違った軌跡や物の陰に隠れて途切れた部分を、小さな補正モデルで直して埋めます。同種の最新手法より高精度で速いと報告されています。広告・体験づくりでは、手持ちで撮った映像にあとからCGの要素を貼り付けて動きに追従させる、人や布や物の動きを3Dデータとして取り出してパーティクルやエフェクトの元にする、といった用途が考えられます。専用のモーションキャプチャ機材やマーカーなしで、スマホ動画から「動く点群」を作れるため、インタラクティブ展示やVFXの素材づくりが手軽になります。まだ研究コードの段階ですが、推論スクリプトも学習スクリプトも公開されており、検証や試作にすぐ使えます。
技術の詳細
仕組み:まず既存の2Dトラッカーが「動画の各点が次のフレームでどこにあるか」を画面上で追います。次に既存の3D形状推定モデルが、各フレームの奥行きとカメラの位置を推定します。この2つを使って、2Dの軌跡をカメラから伸びる線上の推定した奥行きの位置まで持ち上げ、3Dの軌跡にします。ただしこのままでは奥行きの誤差や、物の陰に隠れた部分の欠損でガタガタになります。そこで小さなtransformer(補正モデル)が、壊れた部分を直して穴を埋めます。補正モデルは、PointOdysseyというCGデータの正解軌跡に擬似的な誤差を加えたもので学習するため、画像そのものや前段モデルを学習に使わずに済みます。 従来との違い:3Dトラッキング専用に大きなモデルを一から作るのではなく、既存の部品を差し替えながら使え、1つの補正モデルがさまざまな組み合わせに対応します。WorldTrackというベンチマークで平均精度が最高水準と報告され、同程度の精度の手法より高速です。 使うには:Linux、condaと、24GB以上のVRAMを持つCUDA対応GPUが必要です(一部のトラッカーは48GB)。git clone後にscripts/setup.shで環境を作り、download_weights.pyで重みを取得し、scripts/demo_video.pyで手持ち動画から3Dトラックを出力します。費用はかかりませんが、Pythonとコマンド操作の知識が必要です。商用で使う場合は組み合わせる前段モデルの非商用ライセンスに注意してください。
License
リポジトリ本体はMIT。ただしthird_party/内の前段モデル5本のうち4本は非商用ライセンス、重みも個別ライセンス(configs/weights.yamlに記載)。VGGT-Omegaの重みはHugging Faceでアクセス申請が必要。商用利用は構成の確認が必須。
Sources
Related Works
- TrackCraft3R: Repurposing Video Diffusion Transformers for Dense 3D Tracking
動画拡散モデルを転用して、1回の処理で全ピクセルの3D軌跡を出す手法。
- 4RC: 4D Reconstruction via Conditional Querying Anytime and Anywhere
動画から任意の時刻・位置の4Dを問い合わせて再構成する手法。