SpatialClaw
NVIDIA Research/2026-06
Overview
画像・映像・4Dシーンについて「どこに何がどれだけ離れてあるか」を、AIが自らPythonコードを書きながら考えて答える空間推論エージェント。
技術のポイント
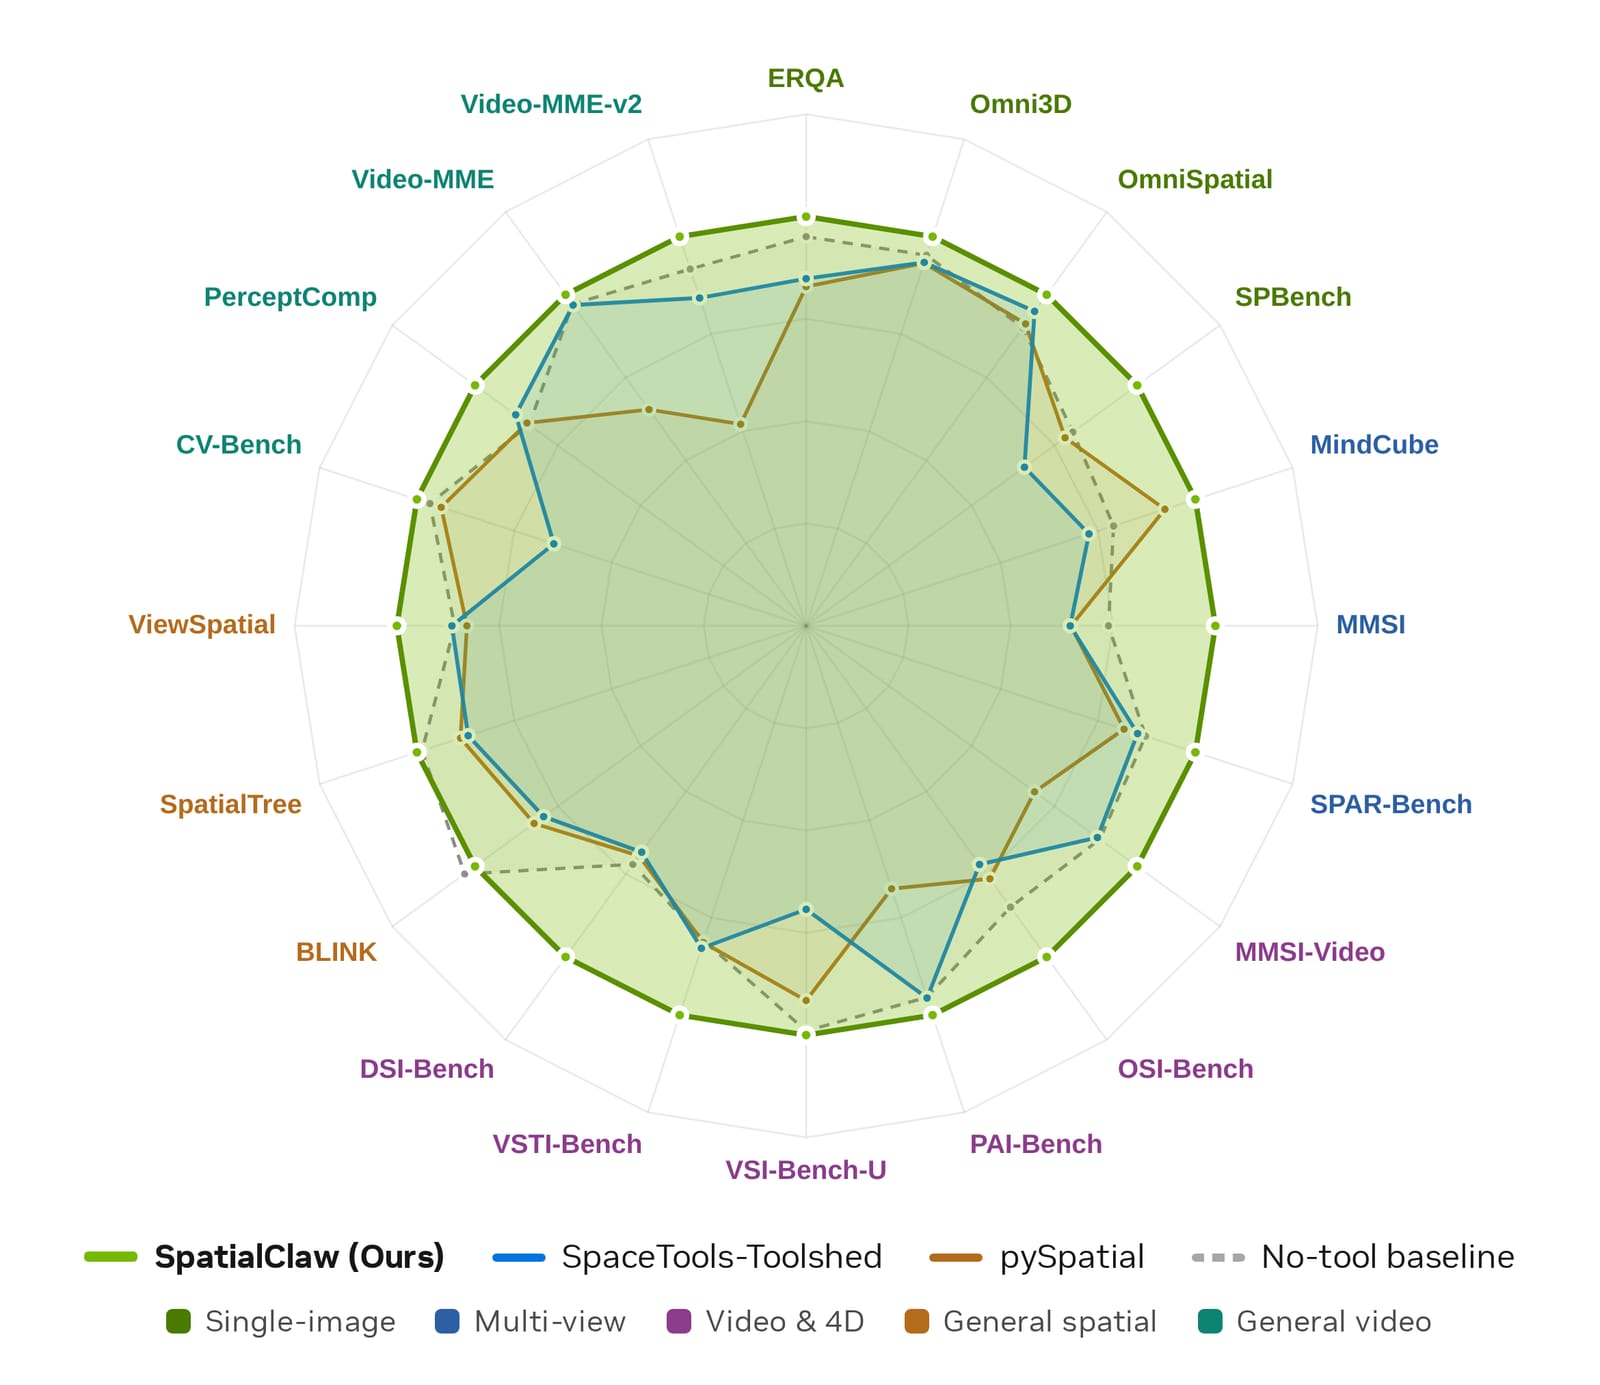
「このコップからテーブルの端まで何cm?」「この2つの物体、どちらが手前?」——こうした空間的な質問は、実は画像認識AIが最も苦手とする領域の一つです。SpatialClawは、AIモデル(VLM)に一発で答えさせるのではなく、AI自身にPythonのプログラムを書かせて、深度推定や物体検出などの専門ツールを呼び出しながら、人間が電卓や定規を使うように一歩ずつ計算・確認させる仕組みです。単一の画像だけでなく複数視点の写真、動画、4D(時間変化する3D)シーンまで幅広い“空間の質問”に対応し、20種類のベンチマークのうち19種類で従来手法を上回る精度を達成しました。広告・体験づくりの観点では、AR演出や空間デザインの検証を自動化する下地になります。「この会場に設置するサイネージのサイズはこの位置から見て適切か」といった空間チェックをAIエージェントに任せたり、ロケハン写真から寸法や配置の妥当性を自動レビューさせる、といった実務ツールへの応用が見込めます。
技術の詳細
仕組みは、AIに“道具箱”を持たせるイメージです。深度推定・物体検出・セグメンテーションなど個別の画像解析ツールをPythonの関数として用意しておき、AI(VLM)はチャットで答えを出す代わりにその場でPythonコードを書いて道具を呼び出し、結果を見ながら次の一手を考える、を何ステップも繰り返します。人が電卓アプリを開いて計算しながら考えるのに近く、AIが自分の計算過程を検算できる点が特徴です。従来の空間推論エージェントは特定のベンチマークやモデルに合わせて追加学習(ファインチューニング)が必要でした。SpatialClawは追加学習なし(training-free)で、26億〜3970億パラメータの6種類の異なるAIモデルに接続するだけで精度が向上する点が新しく、特定のツール呼び出しAPIに縛られず「コードを書く」という汎用的な行動様式を採用したことが従来手法との違いです。使うにはGitHub上のコード一式(エージェント本体・20種のベンチマーク評価用ローダー・GPUツールサーバー)をクローンし、対応するVLM(API経由または自前でホストするvLLM環境)を用意する必要があります。ライセンスはNVIDIA Source Code License-NCで非商用の研究利用に限定されており、そのままでは商用サービスに組み込めない点に注意が必要です。
License
NVIDIA Source Code License-NC(非商用)。一部サードパーティOSSコンポーネントを含む
Sources
Related Works
- Depth Anything 3
SpatialClawが呼び出す深度推定ツールの一つ