R4DGS / ReferGaussian
Bangpu Chen ら(ACM MM 2026採択と記載)/2026-10
Overview
動く3Dシーン(4D Gaussian Splatting)に対して「手前で走っている人」のような自然言語で対象を指定し、時間をまたいで追跡・切り出せる手法とベンチマーク。
技術のポイント
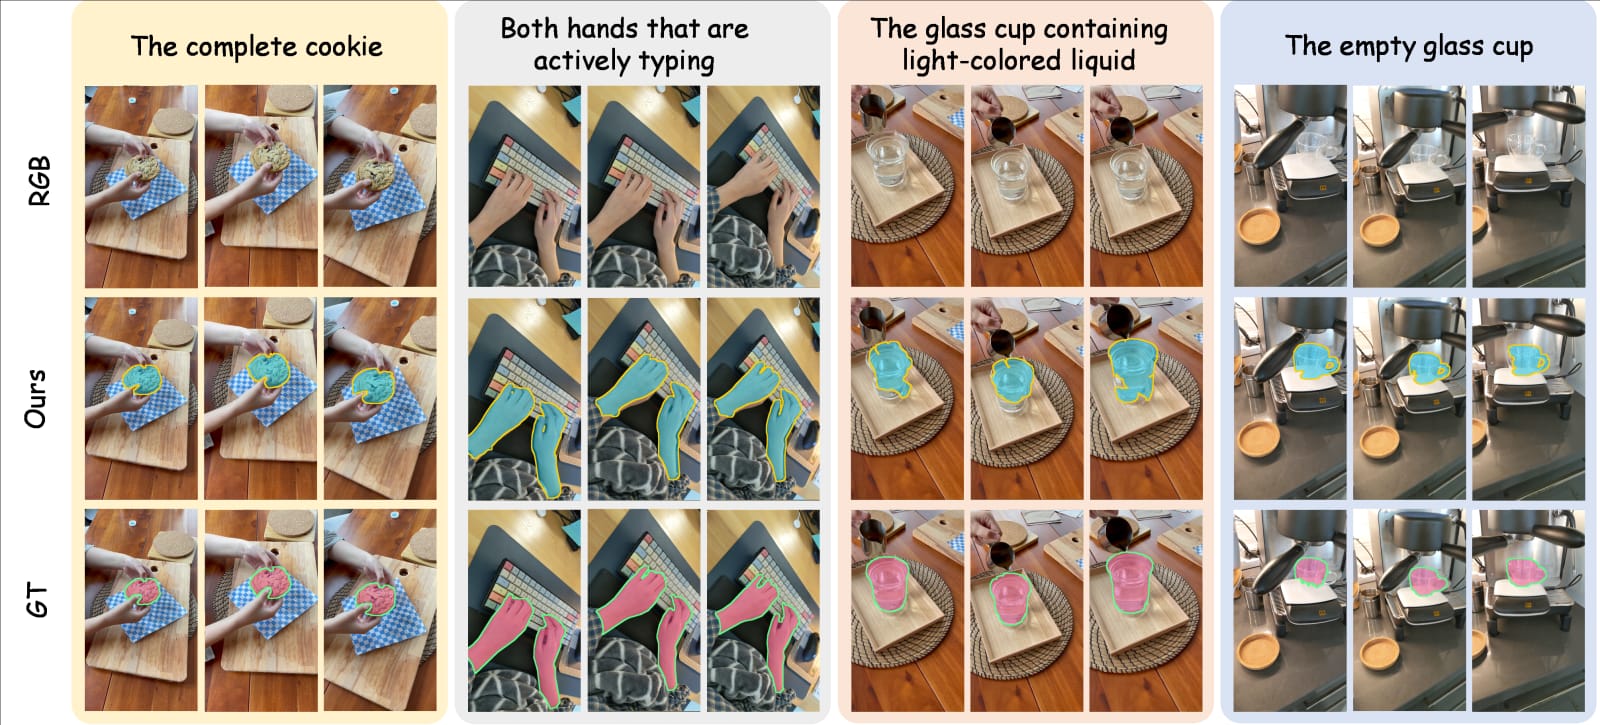
動画から作った動く3D空間の中で、「赤い服で左へ歩いている人」「最後に画面から出ていく車」のように、言葉で指定したものだけを選び出せます。しかも対象ごとに追加学習をしない(training-free)ため、手持ちの4DGSシーンにそのままかけやすい手法です。広告・映像づくりでは、4D撮影した人物やプロダクトを言葉で指定して抜き出し、別シーンへ合成したり、特定の被写体だけ色や表示を変えたり、ボリュメトリック映像の編集を言葉でできる未来が見えます。まだ研究コードで、Linux+NVIDIA GPUでの環境構築が必要ですが、「3D空間の検索・編集をLLMで指示する」流れの最前線を試せます。
技術の詳細
仕組みは、まず既存の4DGSで動くシーンを作り(ここは通常の手法のまま)、次に質問文をマルチモーダルLLM(Qwenベース)が「追跡すべき物の名前」と「条件(いつ・どこ・どう動く)」に分解します。分解結果をGrounded-SAM2で各フレームの画像上のマスクにし、その結果を3D上のガウス粒子に持ち上げて、時間をまたいで同一の物体としてまとめた「EntityBank(物体の名簿)」に入れます。名簿を引くことで、言葉で指定した物体の粒子だけを取り出せる、という流れです。 従来の4D LangSplatなどは、シーンごとに言語特徴を学習する必要があり、複数対象・多段階の推論・該当なしの質問に弱いという課題がありました。本手法はシーンごとの意味学習をせず、LLMの推論力を使う点が違います。READMEの数値では、R4D-Bench-QAでAcc 76.5(4D LangSplatは58.4)ですが、HyperNeRF分割ではvIoUは4D LangSplatの方が高く(62.95対72.26)、全面的に勝つわけではありません。 使うにはLinux、Miniconda、NVIDIA GPU(CUDA 12.1)、COLMAP、そしてQwenやGrounded-SAM2のモデル重みが必要です。リポジトリにはrefergaussianパッケージ、セットアップ・データ準備・学習・ベンチマーク用スクリプトとテストがあり、167コミットの実体あるコードです。費用はGPU環境のみで、コード自体はMITです。
License
コードはMIT。ただし内部でQwen・Grounded-SAM2等の外部モデルを使うため、それぞれのライセンス確認が必要。Linux+NVIDIA GPU(CUDA 12.1)+COLMAPが前提。
Sources
Related Works
- 4D LangSplat
4DGSに言語特徴を学習させて言葉で検索する先行手法(本論文の比較対象)
- gsplat
Gaussian Splattingの学習・描画ライブラリ