EchoAvatar
Zhejiang University (State Key Lab of CAD&CG)/2026-07
Overview
話し声や音楽をリアルタイムに聞き取りながら、全身が自然に動く3Dアバターをその場で生成する研究。会話にもダンスにも同じ仕組みで対応する。
技術のポイント
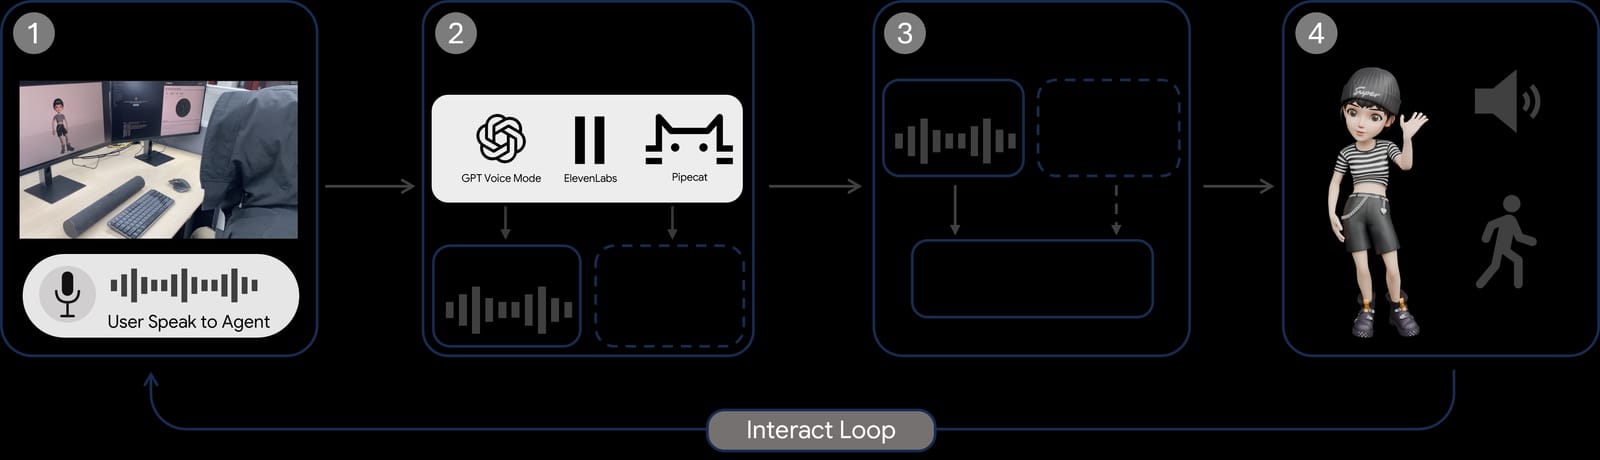
このシステムのすごいところは、音声を最後まで聞いてから動きを作るのではなく、話している最中の音の流れをそのままリアルタイムで拾って、遅れなくキャラクターの体を動かせる点です。しかも同じ仕組みで、日常会話のような自然なジェスチャーと、音楽に合わせたダンスの両方を作れます。さらにChatGPTのような音声AIアシスタントと直接つないで、「うなずいて」「もっと元気に踊って」のような指示をリアルタイムに反映させることもできます。この技術があれば、配信やライブイベントでAIキャラクターが視聴者とその場で会話しながら自然に身振り手振りを返す接客・MC体験や、店頭・展示会に置くしゃべって踊るデジタルサイネージのキャラクター、音声アシスタント連動のバーチャルタレントのようなものが、遅延なく作れるようになりそうです。
技術の詳細
仕組みとしては、マイクから入ってくる音声を細切れの断片として少しずつAIに渡し、その都度「次の一瞬の体の動き」を予測して足していく方式を取っています。人間が話を聞きながら相槌を打つように、AIも音の到着を待たずに動き続けられるのがポイントです。学習の際には、動きが音にきちんと連動するよう強化学習で仕上げの調整をしており、不自然な間延びや棒立ちを防いでいます。 従来のアバター生成AIの多くは、あらかじめ用意された音声ファイル全体を解析してから動きを書き出す「オフライン処理」でした。そのためライブ配信や対話中のキャラクターには使いにくいという弱点がありました。EchoAvatarは配信中にリアルタイムで動きを出し続けられる点、さらに会話用とダンス用でモデルを分けなくてよい点が従来との大きな違いです。 使うには、3Dキャラクターを動かすための骨格データと、ある程度の計算能力を持つGPUを積んだPC、Unityなどのゲームエンジンでの表示環境が必要です。研究段階のコードとして無償公開されていますが、ライセンス表記がないため、実案件に使う前には開発元への利用条件確認とプロ向けの検証を挟むのが安全です。
License
リポジトリにライセンス表記なし。学術研究コードとして公開されており、商用利用条件は開発元への確認が必要
Sources
Related Works
- HunyuanVideo-Avatar
音声から感情豊かなアバター動画を生成するTencentのモデル
- Kimodo
テキストと骨格制約から人間・ロボットの動きを生成するNVIDIAの拡散モデル