MiniMax H3 on TensorFold(NVFP4 ComfyUIローダー)
jayleaton/2026-10
Overview
MiniMax H3(音声付き動画モデル)をRTX 50シリーズ1枚で高速に動かす、ComfyUI用のドロップイン・ローダーノード。Windowsネイティブで標準の約2.3倍、Turbo LoRAと疎アテンション併用で最大7.7倍と報告。
技術のポイント
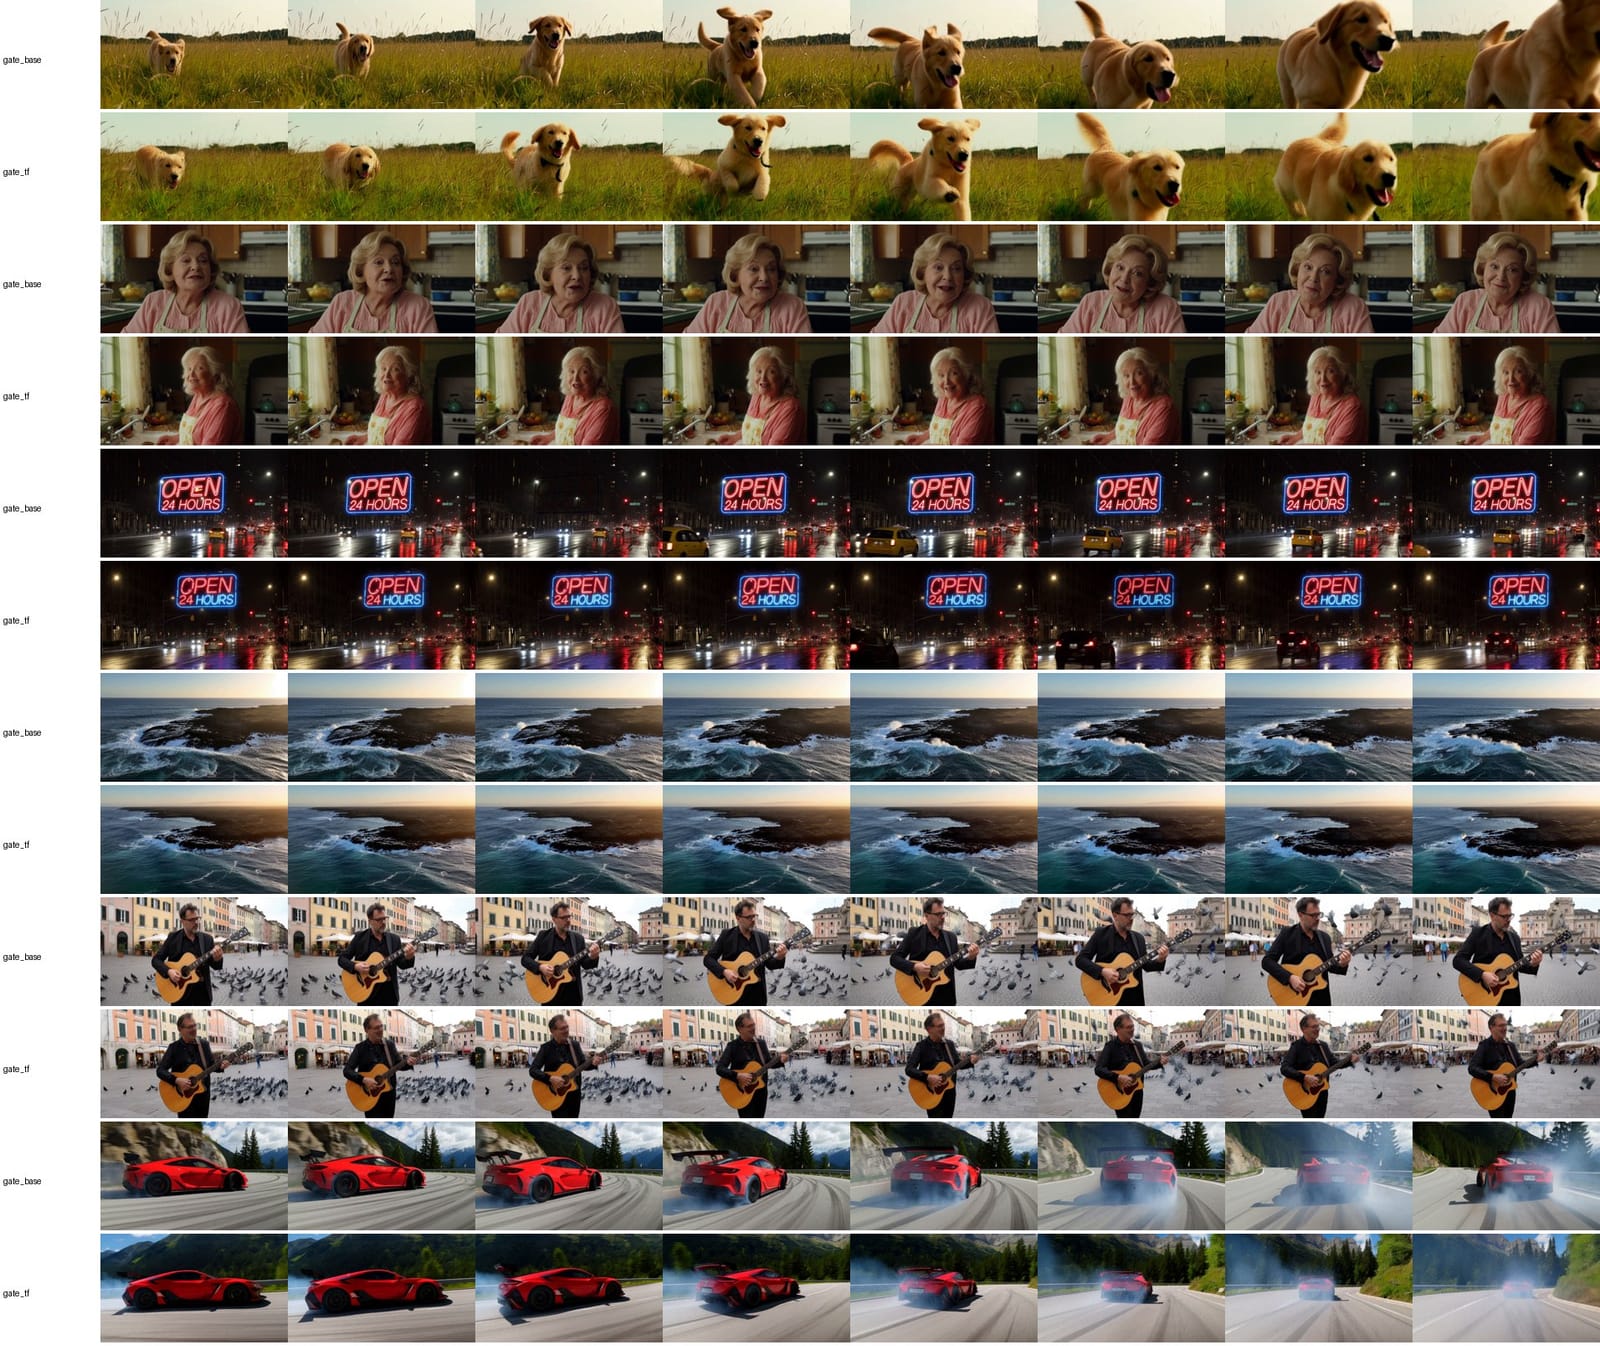
MiniMax H3は190億パラメータの大型モデルで、一般的なGPUでは5秒の動画1本に10分以上かかっていました。このツールは、ComfyUIの「Load Diffusion Model」ノードを「TensorFold MiniMax H3 Loader」に差し替えるだけで、Blackwell世代(RTX 50)のNVFP4(4ビット浮動小数)演算を使う高速エンジンに切り替えます。READMEの実測(RTX 5070 Ti 16GB、1344×768・5秒・音声付き)では、標準623秒が20ステップで273秒、Turbo LoRA+疎アテンション+int8 VAEの組み合わせで81秒まで短縮されています。広告制作では、クライアント確認用のカット案を1日に何十本も回す、ローカルで機密素材を外部に出さず生成する、といった運用が現実的になります。
技術の詳細
仕組み:動画モデルの計算の大半は、巨大な行列の掛け算です。このローダーは、その中核であるDiTの50ブロックだけをTensorFoldというNVFP4対応の計算ライブラリに置き換え、文字・キーフレーム・音声・映像を並べる処理やテキストエンコーダ、VAE(画像⇔内部表現の変換器)は元のComfyUIのまま使います。工場のライン全体は変えず、一番遅い工程の機械だけを新型に替えるイメージです。 従来との違い:標準のComfyUIはint8の重みをbf16のアテンション経路で流しており、4ビット演算の恩恵を受けられませんでした。ここでは4ビット化で画質の細部や構図が「同じプロンプトでも別サンプル」程度に変わる点をREADMEで明記し、6プロンプトでLPIPS・DINOv2類似度・PSNR・音声ログメル距離を標準版と比較する検証スクリプト(bench/quality.py)まで同梱しています。既掲載のFastH3やBlock Sparse Attentionとは、4ビットGEMMで本体計算そのものを置き換える別アプローチです。 使うには:RTX 50シリーズ(Blackwell, sm_120)のGPU、Windows 11またはLinux、ComfyUI(検証は0.37.0・torch 2.10+cu130)、RAM 64GB程度が目安。READMEは作者が1台の環境で測った作業中(WIP)の数値だと明記しており、設定や数値は今後変わる可能性があります。ソフトの費用はかからず、導入はComfyUIのcustom_nodesへ配置してワークフローのノードを差し替える手順です。
License
本プロジェクト自身のコードはApache-2.0。TensorFoldは未改変のsubmoduleとして利用。MiniMax H3の重みは各自のライセンスに従う。
Sources
Related Works
- TensorFold
NVFP4 W4A4テンソルコアGEMMを提供する、本プロジェクトのエンジンの土台。
- Block-Sparse-Attention
疎アテンションで長い動画系計算を速くするライブラリ。併用できる別方向の高速化。
- LightX2V
動画生成モデルの推論高速化フレームワーク。