Mira-Scene
VAST AI Research / The University of Hong Kong/2026-09
Overview
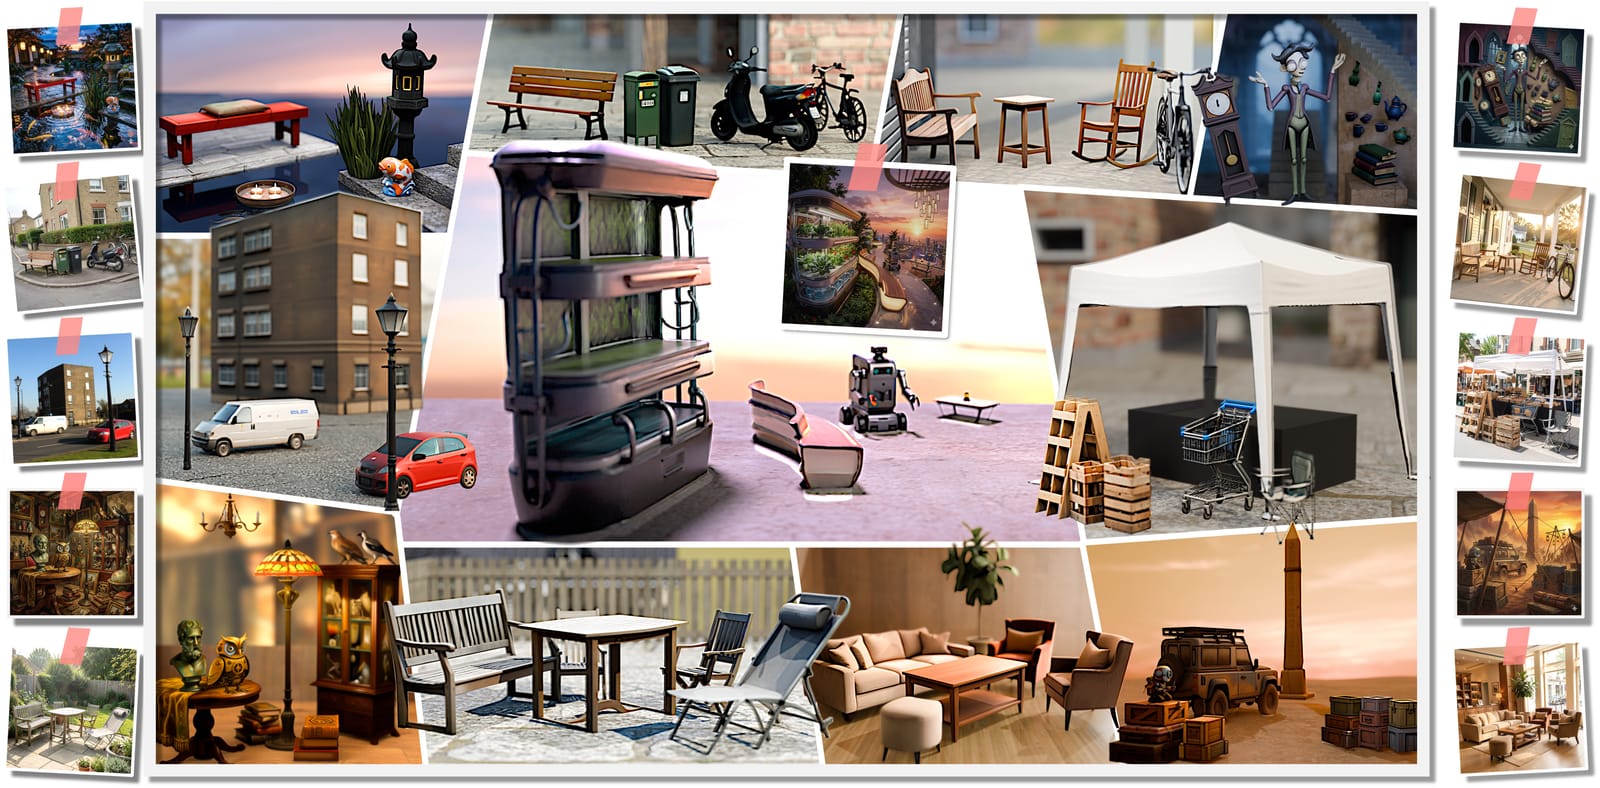
1枚の写真から、家具や物体がそれぞれ独立したパーツとして配置された『編集できる3Dシーン』を自動生成する研究。香港大学とVAST AI Researchによる。
技術のポイント
従来、1枚の写真から3Dシーンを作る技術は『カメラの位置と物の向きを推測して配置する』方式が主流で、物同士の位置関係がずれたり奥の物体が歪んだりしやすい弱点がありました。Mira-Sceneは、写真の各ピクセルが物体表面のどの位置に対応するかを密に対応づける『座標マップ』という仕組みを使い、この推測作業をより確実にすることで、Meta社のSAM 3Dという既存手法と比べて配置精度が体積ベースの指標で約4割向上したと報告されています。広告や体験制作の現場では、商品陳列やロケハン写真を1枚撮るだけで、家具や小物を個別に動かせる3DシーンをCG的に組み立て、CM用のプレビズやAR配置検証、バーチャル背景の下敷きとして素早く使えるようになる可能性があります。
技術の詳細
仕組みを簡単に言うと、写真に写る机や椅子などの物体ごとに『真上や真横から見たらどう見えるか』という基準の姿を思い浮かべ、写真の各点がその基準姿のどこに当たるかを色分けした地図(座標マップ)を作ります。この地図と深度推定AIが作る大まかな奥行き情報を組み合わせることで、物体の3D的な向き・大きさ・位置を計算で求め、さらに拡散モデル(画像生成AIの一種)が物体の形とレイアウトを同時に生成します。 従来手法は物体の3Dの向きや位置を『それらしい値を直接推測する』回帰型の方式が中心で、複数の物体が写る複雑な部屋のシーンでは誤差が蓄積しやすいという課題がありました。Mira-Sceneは各ピクセル単位の対応関係という密な手がかりを使うことでこの誤差を抑え、屋内外・現実/合成データを横断したテストで既存手法より高い精度を示したと論文は報告しています。 利用にはNVIDIA製GPUを備えたLinux環境とPython、PyTorchが必要で、GitHub(VAST-AI-Research/Mira-Scene)で推論コードが公開され、学習済みモデルの一部の重みもHugging Face(Yang-Tian/Mira-Scene)から入手できます。ただし公開されているのはパイプラインの一部の重みで、物体切り出しや深度推定は別途サードパーティのモデルを組み合わせる必要があり、ライセンスファイルが見当たらないため商用利用には権利者への確認が必要です。
License
GitHubリポジトリにLICENSEファイルが存在せず、権利条件が明示されていない。商用利用前に開発元への確認が必要。
Sources
Related Works
- SAM 3D (Meta AI)
1枚の画像から物体・人物の3D形状を推定する手法。Mira-Sceneが精度比較のベースラインとした技術。
- TRELLIS (Microsoft)
画像やテキストから単一の3Dアセットを生成する構造化潜在表現モデル。物体単体の3D生成という先行研究にあたる。