ProAct
ProActRobot(SIGGRAPH Asia 2026 Journal Track採択論文)/2026-10
Overview
人と話しながら、声と身ぶりをリアルタイムに生成し、記憶や状況判断をもとに自分から話しかけるヒューマノイドロボット向けの対話システム。コードは2026-10-31に公開された。
技術のポイント
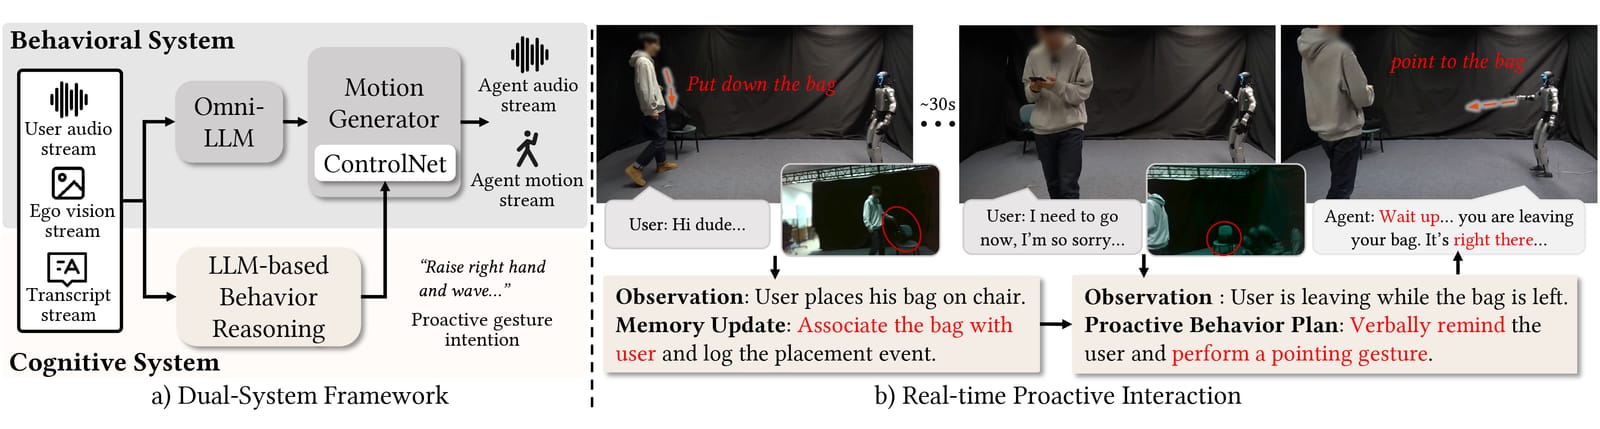
ロボットが人の話を聞きながら、同時に声と身ぶりを途切れなく出し続け、さらに記憶と空気を読む頭脳が別に働く点がすごい。素早く反応する「行動担当」と、会話の履歴から人の気持ちや意図を考える「認知担当」を分離している。そのため、ロボットが忘れ物を教えたり、ポスター展示へ誘ったり、疲れた様子の人を慰めたりと、受け身でなく自分から動く。広告・体験づくりでは、展示会場やショールームで来場者に能動的に話しかける案内キャラクターや、文脈に応じて身ぶりが変わる3Dキャラクターの接客演出に応用できそう。「相手の話を聞いている間の頷きや相づち」といった細かな非言語動作まで自動で生成できる点は、体験型演出の見せ場になる。
技術の詳細
仕組みは2層構成。Behavioral System(行動担当)は、音声を扱うストリーミング型のマルチモーダルLLMと、flow matchingという生成方式を使ったモーション生成器を組み合わせ、話し手と聞き手の両方の動きを音声から連続生成する。ControlNet(元の生成を壊さず追加の指示を足す仕組み)で「慰める」「お祝いする」といった意図をテキストで注入し、窓の境界の動きの途切れも重ね合わせとキャッシュで抑える。Cognitive System(認知担当)は、履歴を有限のメモリに圧縮し、Behavior Plannerが「今、話しかけるべきか」を判断する。 従来のロボット対話は、人が話し終わってから反応する受け身型が多かった。ProActは反応型と能動型の振る舞いを途切れなく切り替える点が違う。実機のヒューマノイド(G1)で動作する。 使うにはCUDA対応GPU、Python環境、設定用の.envが必要。学習済みモデルとデータはHugging Face(UsanoCoCr/ProAct)から別途取得する。MuJoCo描画は任意で、シミュレータなしでも実行できる。BVHからG1へのリターゲットや学習スクリプトも含まれる。実機デモにはG1ロボットが必要で、費用は高いが、コード自体は無料で使える。リポジトリは公開直後で星2、コミット1件のため、安定性は未知数。
License
ソースコードはMIT。モデル、データセット、図版、サードパーティ部品は個別条件(THIRD_PARTY_NOTICES.md)に従う。
Sources
Related Works
- ProAct 論文(arXiv)
手法の詳細とProActBenchの評価。
- ProAct モデル(Hugging Face)
公開された学習済みモデルの配布先。
- ProAct-Data(Hugging Face)
学習・評価用のデータセット。