MACE-Dance
AMap (Alibaba) / Renmin University of China/2026-07
Overview
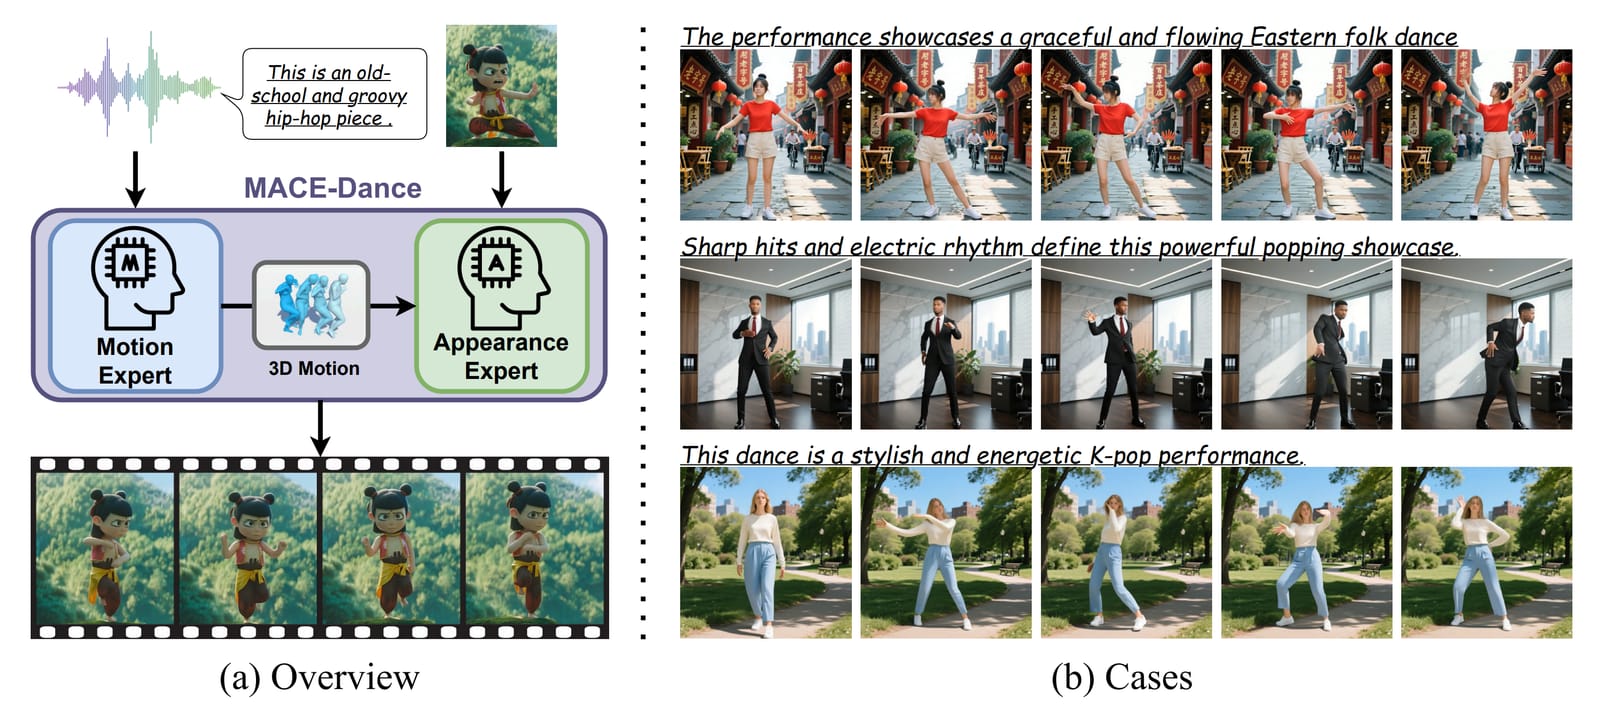
1枚の人物写真と1曲の音楽を渡すだけで、その人がリズムに合わせて踊る高品質なダンス動画を自動生成する技術。
技術のポイント
すごいのは、「振り付け(体の動き)」と「見た目の質感(映像としての仕上がり)」を別々の専門AIに分業させている点です。まず「モーション担当AI」が音楽のリズムやジャンルを解析して3Dの骨格アニメーションを作り、それを受け取った「映像担当AI」が指定した人物写真の顔や服装を崩さずに動画へ変換します。この二段構えのおかげで、動きが不自然にガクガクしたり、途中で顔や服が変わってしまったりする従来モデルの弱点を大きく減らしています。広告の世界では、タレントを長時間拘束して撮影しなくても、1枚の商品モデル写真とBGMだけでダンス動画バリエーションを量産できたり、SNSキャンペーン用に「好きな曲で踊るオリジナルアバター」をユーザー参加型で作らせる企画にも応用できそうです。
技術の詳細
仕組みは二段階のリレーです。1段目の「Motion Expert」が音楽データから人体の関節位置(SMPLという3D人体モデル形式)の時系列を予測し、リズムに合った振り付けを作ります。2段目の「Appearance Expert」はその骨格の動きを設計図として使い、渡された1枚の人物画像の見た目(髪型・服・体型)を保ったまま、コマごとの映像を生成します。役割を分けたことで、単一のAIに全部を任せる従来方式より、長い動画でも人物の同一性やダンスジャンルの多様性を保ちやすくなっています。 学習には約70,000本・116時間分のダンス動画データセットが使われており、20種類以上のダンスジャンルに対応します。開発には中国人民大学(Renmin University)のほか、地図アプリ大手アリババ傘下AMapの研究チームが関わっています。 使うにはある程度のVRAMを積んだGPU環境とPythonの実行環境が必要で、モデルの重み自体はHugging Face経由で申請の上ダウンロードする形です。コードはGitHubで公開されていますが、ライセンス表記が明記されていないため、商用での本番投入前には開発元への利用条件の確認をおすすめします。
License
リポジトリにライセンス表記なし。モデル重みはHugging Face経由の申請制で、商用利用条件は要確認
Sources
Related Works
- LongCat-Video-Avatar
音声駆動でキャラクターアニメーションを生成するMeituanのモデル
- EchoAvatar
音声ストリームからリアルタイムに全身アバターの動きを生成する研究