Multi-View Foundation Models
テルアビブ大学/2025-12
Overview
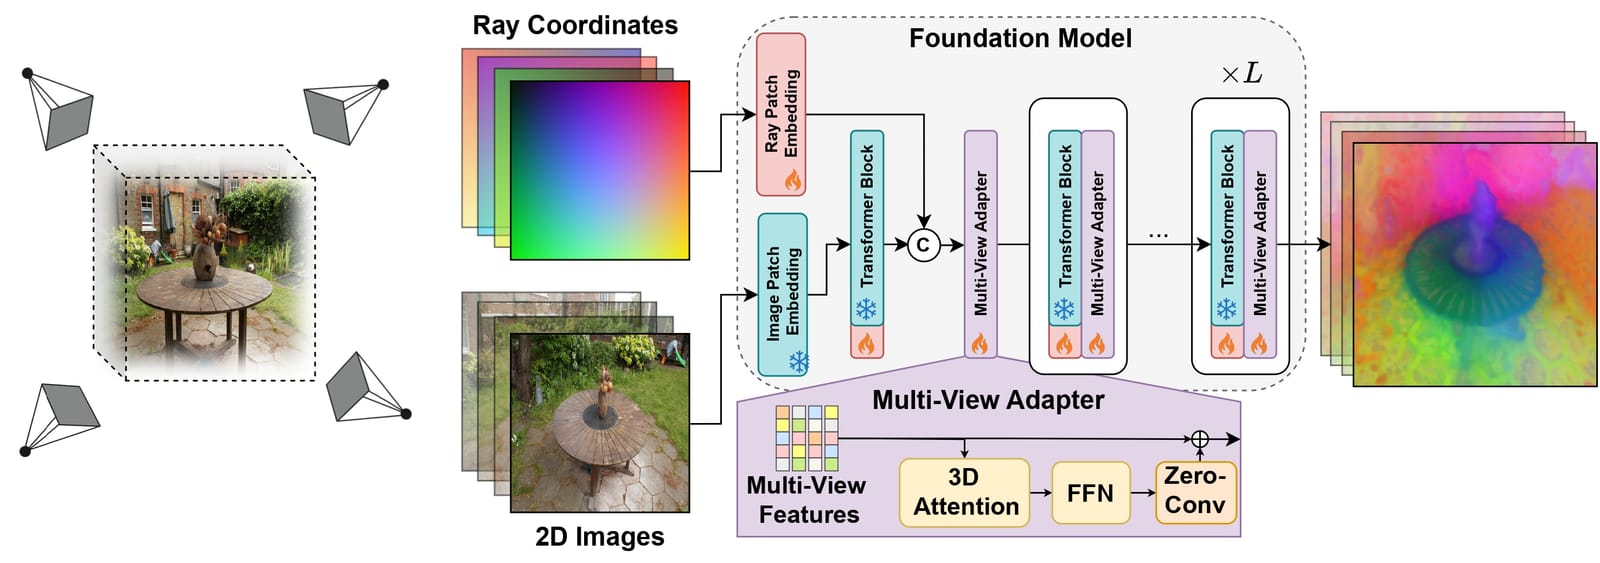
DINO・SAM・CLIPなどの2D基盤モデルに「マルチビュー空間アダプタ」を挿入し、明示的な3D再構成なしで視点間一貫の特徴を出せるようアップグレードする汎用フレームワーク。
技術のポイント
DINOやSAM、CLIPといった画像AIの“定番エンジン”は、とても賢い一方で『同じ物でも見る角度が変わると認識がブレる』弱点がありました。この研究は、そうした既存モデルに“マルチビュー空間アダプタ”という小さな追加部品を差し込むだけで、どの角度から見ても一貫した理解を持つ3D対応モデルに作り替えます。しかも本格的な3D再構成をわざわざ行わずに、視点をまたいだ特徴のつじつまを合わせられるのがポイント。広告や体験づくりでは、商品を1回指定すれば全アングルの映像で自動追従して切り抜き(セグメント)できる演出、店舗を空間スキャンした中でのオブジェクト認識AR、多視点で撮った素材の自動マスク生成など、“どの角度でもズレない画像認識”を土台にした企画の下地技術になり得ます。
技術の詳細
たとえるなら、優秀だけれど“一枚の写真しか見ていない”鑑定士に、複数アングルの写真を見比べて『これは全部同じ物だ』と判断できる眼を後付けするようなものです。具体的には、DINOv2・DINOv3・CLIP・SAMといった既存の画像基盤モデルに、視点間の幾何学的な関係を学ぶ軽量なアダプタを挿入します。すると、ある3D上の同じ点を別々のカメラから見たときに、モデルが返す特徴(数値表現)が食い違わず一致するようになります。 従来、複数視点で一貫した認識を得るには、いったんきちんと3D形状を復元してからそこに情報を貼り付ける、という手間のかかる回り道が主流でした(FiT3DやFeature 3DGSなどの先行研究)。この手法は明示的な3D再構成を挟まず、既存モデルに小さなアダプタを足すだけで多視点の一貫性を得られるのが新しい点です。ベースモデルを丸ごと作り直さないので、導入のコストも軽く済みます。 開発はテルアビブ大学(Leo Segreら)。実装一式がGitHubでMITライセンスとして公開され、学習済みモデルも入手できます。ただし土台にするDINO・SAM・CLIPなど各モデルには、それぞれ固有のライセンスがあり、用途によってはそちらの条件に従う必要があります。実行にはPythonとGPU環境、多視点の画像・スキャンデータが必要で、現状は研究実装のため、製品化には自社での検証・組み込みが前提になります。
License
本体はMITでフル実装公開済み。ただしDINO/SAM/CLIP等アップストリームモデルの各ライセンスに従う必要あり
Sources
Related Works
- FiT3D
3D Gaussianを介して2D特徴の3D認識を改善する先行研究(ECCV 2024)
- Feature 3DGS
3D Gaussian Splattingに基盤モデル特徴を蒸留する代表研究