Bernini
ByteDance(Seed / ByteDance Research)/2026-06
Overview
自然な言葉の指示で画像も動画も生成・編集できる統合モデル。指示を読み解く『演出担当』AIと映像を描く『作画担当』AIが分業し、触らない領域を保ったまま編集する。
技術のポイント
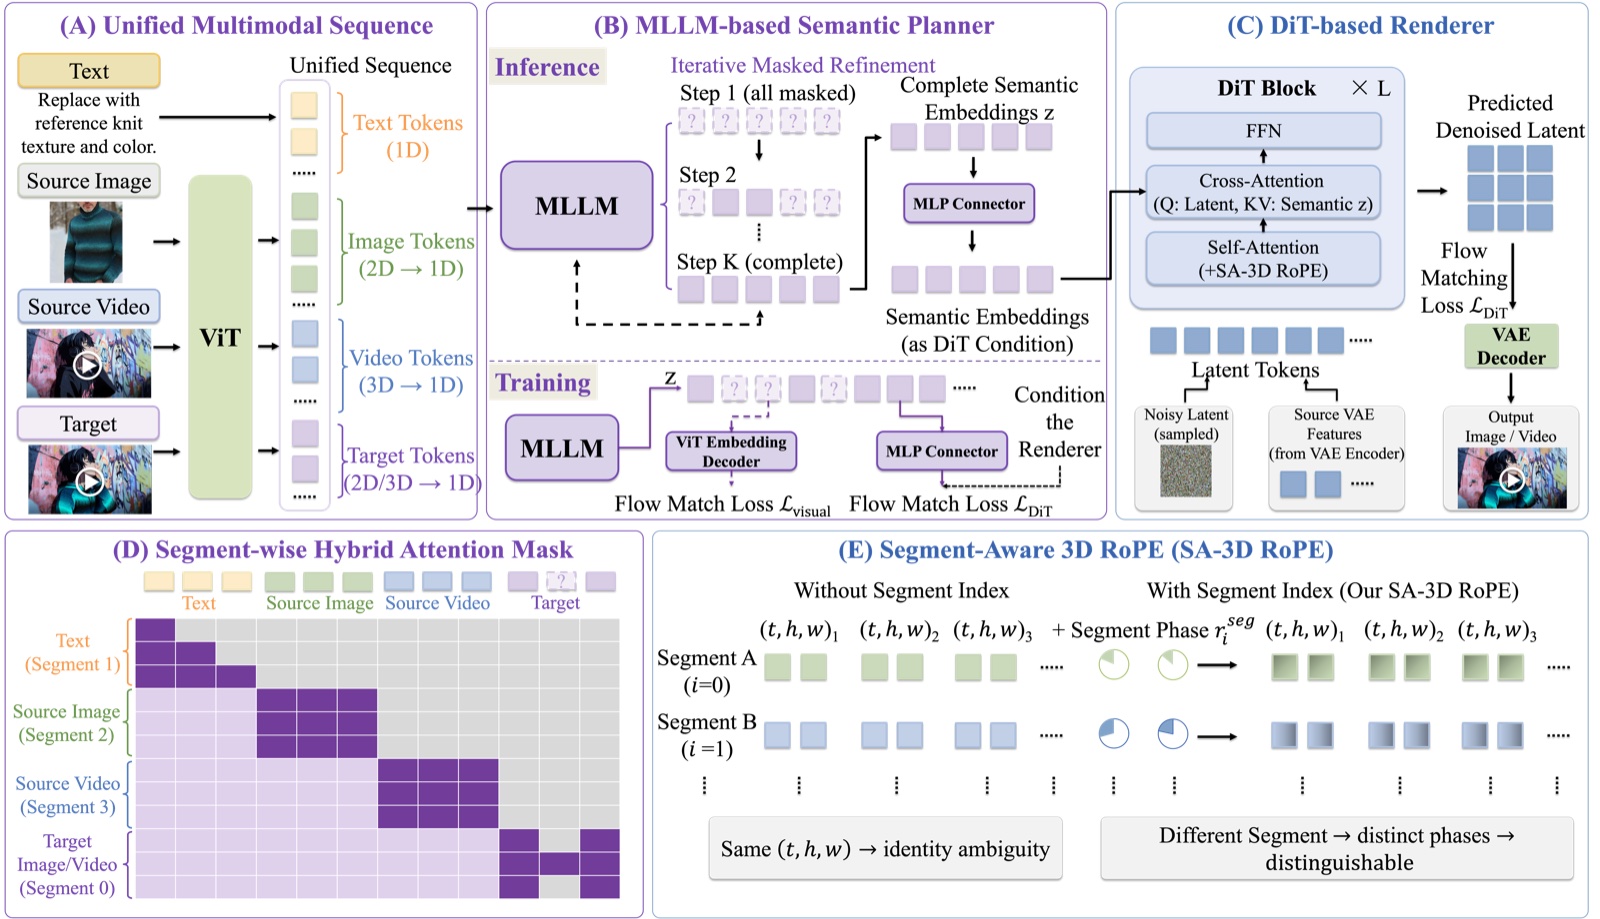
「この動画の服だけ変えて」「この登場人物を動画にして」といった自然な言葉の指示で、画像も動画も生成・編集できる統合モデル。裏側では、指示を読み解いて手順を組み立てる“演出担当”のAIと、実際に映像を描く“作画担当”のAIが分業する。文章から画像・動画を作るのはもちろん、既存動画の一部だけを編集したり、参考動画のスタイルや衣装を移したり、特定の被写体を主役にした動画を作ったりと、6種類の作業を一つの枠組みでこなす。従来は編集すると関係ない部分まで作り変わってしまいがちだったが、Berniniは触らない領域を保ったまま直せる。広告・体験づくりでは、撮り直しなしで動画内の商品や衣装を差し替える、1本の素材から多数のバリエーションを量産する、参考映像の質感を自社素材に移すといった編集作業を、言葉の指示だけで回せる。
技術の詳細
仕組みの肝は「計画してから描く」二段構えだ。まずマルチモーダル大規模言語モデル(画像や動画も理解できるAI)が指示の意味を汲み取り、どこをどう変えるかの手順に分解する。次に拡散モデル(DiTレンダラー)がその計画どおりに映像を生成する。人間の制作でいえば、ディレクターが指示書を書き、アニメーターが手を動かす関係に近い。 従来の生成モデルは編集を頼むと、指定していない背景や人物の顔まで意図せず変わってしまうことが多かった。Berniniは計画段階で「触る場所/触らない場所」を切り分けるため、編集していない領域や被写体の同一性を保ちやすい。人手で評価する編集品質のランキングでも上位に位置づけられている。 土台にはオープンな動画生成モデルWan2.1/2.2(最大14B規模)を使う。コードとモデル重みはApache-2.0で公開され、商用利用も可能。軽量な1.3B版のレンダラーも用意され、比較的手頃なGPUでも試せる。実行にはPython環境とGPUが必要。
License
コード・重みともApache-2.0で商用可。軽量1.3B版レンダラーあり