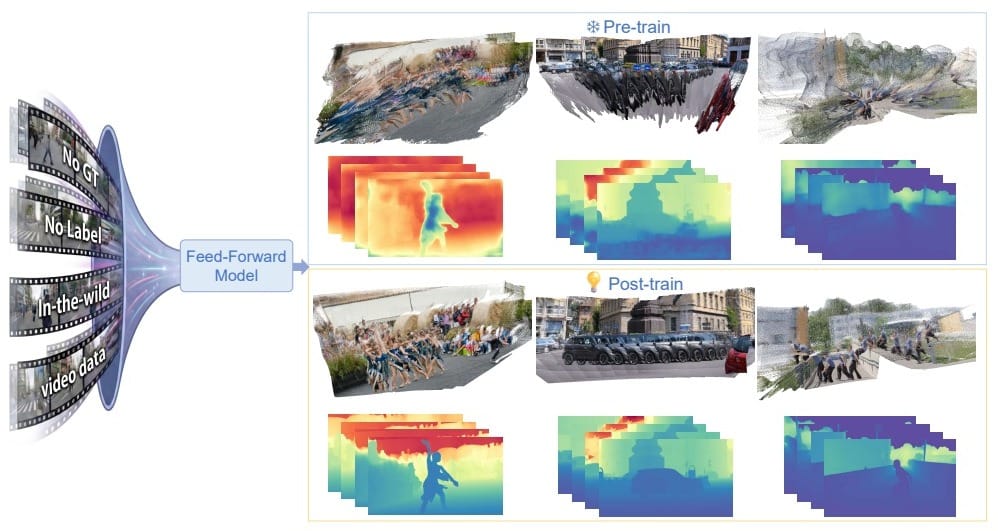
PURE (Refining Feed-forward 3D Reconstruction with Unlabeled Post-training)
Yaolong Zhu, Yuan Liu ほか(ACM Multimedia 2026 採択)/2026-10
Overview
既存の3D復元モデル(Pi3・Depth Anything 3・VGGT)を、正解データなしの普通の動画だけで追加学習し、動く被写体を含む場面でも精度を上げる手法。コード・重み・Hugging Faceデモが公開されている。
技術のポイント
すごい点は、人や車が動き回る「現実の動画」で苦手になりがちな3D復元を、高価な正解ラベルなしで改善できることです。3D復元モデルは、止まった景色には強い一方、動く被写体、物陰、光の変化が入った動画では精度が落ちがちでした。PURE は、すでに強い2D向けの深度推定などの知識を借りて、手持ちの動画だけで既存モデルを賢くします。広告・体験づくりでは、スポーツ中継やダンス、街のスナップなど動きの多い映像からカメラの動きと奥行きを取り出し、3D空間に文字やCGを自然に置く合成の下準備に使えます。点群を作って空間演出のベースにすることも考えられます。HFのPURE Studioで自分の動画を試せるので、使えそうか手軽に確かめられます。
技術の詳細
仕組み:PUREは「先生と生徒」の追加学習です。先生役は、1枚の画像から相対的な奥行きを推定する強力な2Dモデルや、動く領域の検出、フレーム間の対応点などです。生徒役は、複数フレームから3D復元を行うモデル(Pi3、Depth Anything 3、VGGT)です。先生が出した「この物体はあれより手前」「この点は次のフレームのここに写っている」といった手がかりを使い、正解の深度やカメラ位置がない動画でも、生徒の予測が先生の知識と矛盾しないよう調整します。 従来との違い:従来、動画の3D復元モデルを動的な場面に強くするには、深度やカメラ位置の正解データを大量に用意する必要があり、費用がかかりました。PUREは正解なしの動画から改善でき、論文では複数の最新アーキテクチャで合成・実写の動的ベンチマークとも精度向上が報告されています。ACM Multimedia 2026に採択されています。 使うには:GitHubからソースを取得し、READMEの手順に沿ってデモ、Python API、学習スクリプトを使います。重みは初回に自動ダウンロードされ、ログインは不要です。ブラウザ上でHugging FaceのPURE Studioでも試せます(ZeroGPUの枠に制限あり)。自分で追加学習するには教師キャッシュの準備が必要で、一定のPython・GPUスキルが求められます。コードはMITですが、土台モデルごとの条件を確認してください。
License
PURE自体のコードはMIT。組み込まれたモデル部品は各自の第三者ライセンスに従う(LICENSES/とTHIRD_PARTY_NOTICES.md参照)。用いる土台モデルごとに確認が必要