OpenVLHarness
UCLA NLP / Apple/2026-10
Overview
画像を見られるAI(マルチモーダルLLM)に、拡大・文字認識・物体の位置特定・奥行き推定・Web検索・Pythonコード実行などの道具を持たせ、見たものを「記憶」として貯めさせる、学習不要のエージェント基盤。
技術のポイント
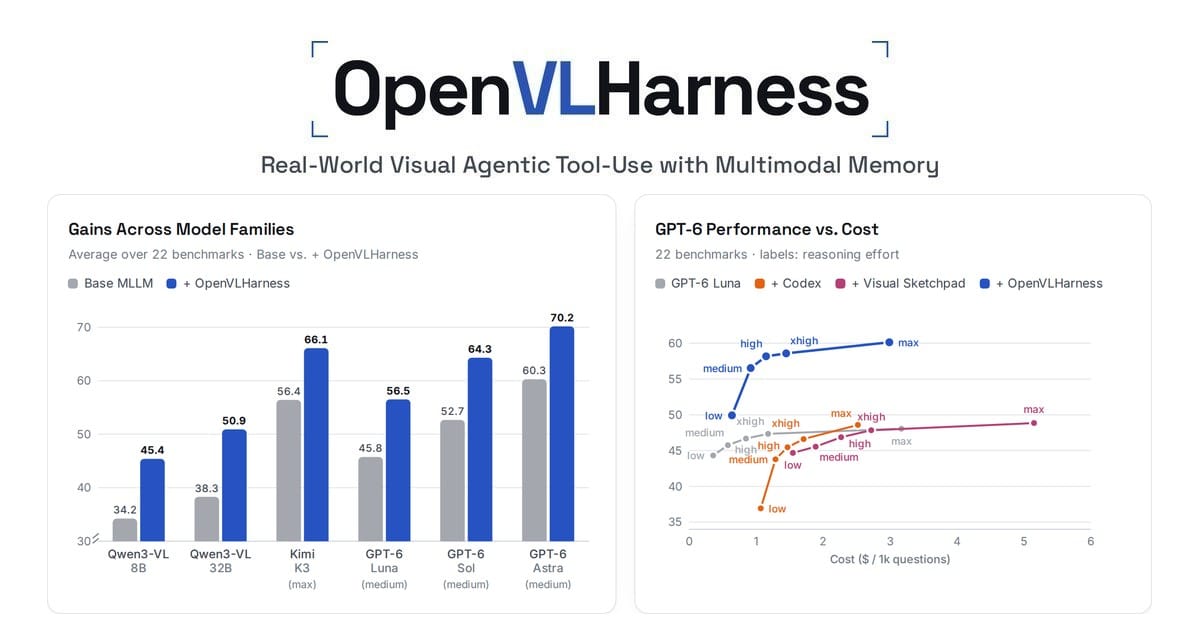
AIに画像を渡して「この中の小さな文字を読んで」「この商品と同じものをネットで探して」と頼むと、一度見ただけでは間違えることがよくあります。OpenVLHarnessは、AIが人間のように「拡大して見直す」「文字を読み取る」「奥行きを測る」「Webで調べる」「計算用のコードを書く」といった道具を自分で選んで使い、取得した画像や調べた結果を記憶に残しながら答えにたどり着く仕組みです。AI本体の再学習はしていないのに、22種類のベンチマーク平均で+9.7〜+12.6ポイント精度が上がったと報告されています。広告・体験づくりでは、大量の参考画像やロケ写真の整理、競合クリエイティブの調査の自動化、展示物やパッケージの細部チェックなど、「画像を見ながら調べものをする下働きエージェント」の土台として使えそうです。ブラウザ上で試せるデモもあり、手元の画像を最大4枚アップロードして挙動を確かめられます。
技術の詳細
仕組みは、司令塔役のAI(マルチモーダルLLM)が、料理人が包丁やフライパンを使い分けるように道具を使い分けるイメージです。道具は大きく3種類で、画像を調べる道具(拡大、文字認識、物体の位置特定、奥行き、カメラの向き)、情報を探す道具(テキスト検索、画像検索、Webページ閲覧)、そしてコードを書いて動かす道具です。各道具が出した画像や表データ、Webの参照先は「マルチモーダル記憶」に保存され、AIは後から取り出して使えます。さらに、うまくいかなかった約9,900件の失敗例をAIに読ませて原因を分析させ、足りない道具の追加や指示文の修正を自動で提案・適用する「ハーネス最適化」も行います。この間、AIモデルの重みは一切変えません。 従来の「道具を使えるようにモデルを追加学習する」方式は学習コストが大きく、モデルを入れ替えるたびにやり直しでした。本手法は周りの仕組み(ハーネス)だけを改良するので、6種類の異なるモデルに載せ替えても効果が出たと報告されています。比較では、7Bクラスのモデルを追加学習なしで使って33.5点を記録し、追加学習した従来手法の25.0〜28.0点を上回りました。 使うには、Python環境とツール呼び出しに対応したOpenAI互換のAPIエンドポイント(または自前でvLLMを立てたモデル)が必要です。Web検索を使うなら検索APIキーも要ります。コードはMITですが、既定で使うモデルやAPIは別途の費用・規約がかかる場合があります。コード・設定・評価キットは公開済みです。
License
本体はMIT。評価キットはVLMEvalKit由来(Apache-2.0)、SAM 3の可視化補助はSAM License。既定ツールが使うモデル・サービス・データセットは別ライセンスで、THIRD_PARTY_LICENSES.md の確認が必要。
Sources
Related Works
- Visual Sketchpad
AIが描画やコード実行を使い、スケッチで考えながら視覚的な問題を解く先行研究。
- Qwen3-VL
本研究が失敗例分析の対象にした8Bクラスのオープンなマルチモーダルモデル。
- VLMEvalKit
本研究の評価キットの元になった、マルチモーダルモデル評価ツールキット。