LingBot-Map
Robbyant(Ant Group系のロボティクス/身体性AI企業)/2026-04
Overview
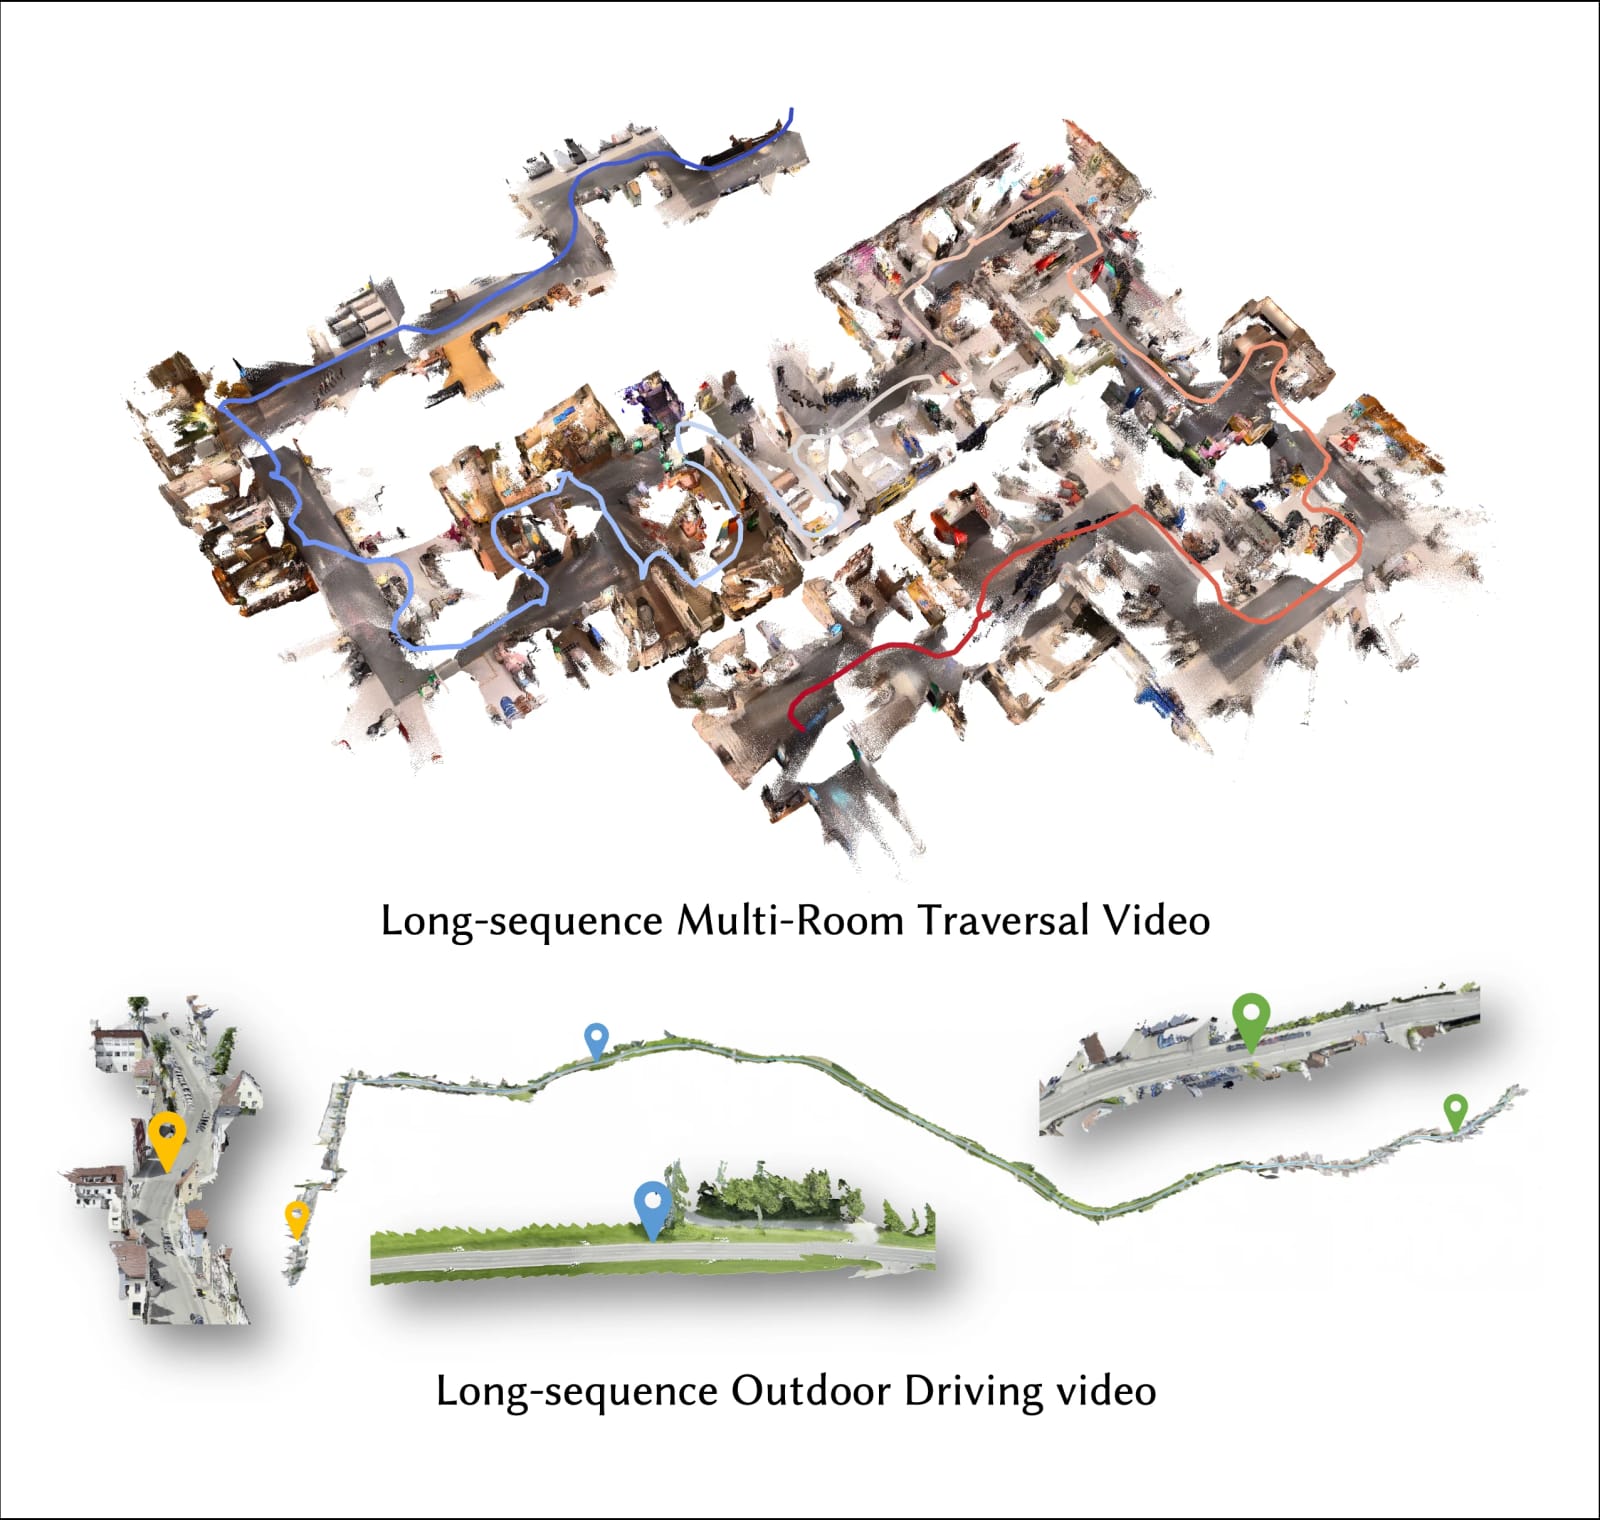
LiDAR不要・単眼カメラ映像だけで、シーンの3D形状をストリーミング(約20FPS)でリアルタイム再構成するフィードフォワード3D基盤モデル。1万フレーム超の長尺でもドリフト補正しながら動作する。
技術のポイント
普段、部屋や街並みをそっくり3Dデータに起こすには、レーザーで距離を測る高価なLiDARセンサーを積んだ機材か、撮影が終わってから何時間もかかる重い計算処理が必要でした。LingBot-Mapがすごいのは、ごく普通のカメラ1台で撮った映像を流し込むだけで、その場でリアルタイムに(約20コマ/秒で)3D空間が立ち上がっていくこと。しかも1万コマを超える長回しでも、進むうちに少しずつ生じる位置ズレ(ドリフト)を自動で補正し続けます。GitHubスターは9千超と世界の開発者からの注目度も高い技術です。広告や体験づくりでは、来場者がスマホ片手に会場を歩くだけでその空間の3Dモデルが即座にできあがるインスタレーションや、ロケ地を歩くだけで完成するバーチャル店舗ツアー、会場を認識して動くロボット・ドローン演出の“目”として活用できそうです。
技術の詳細
仕組みはこうです。カメラ映像を1コマずつAIに送ると、モデルがそのつど『これはさっき見た壁の続きだ』と過去の記憶(トラジェクトリメモリ)と照らし合わせながら、点の集まりとして3D形状を描き足していきます。中核にあるのは“Geometric Context Transformer”という仕組みで、カメラの位置合わせ・立体の奥行き手がかり・長時間ぶんのズレ補正を、ひとつの流れの中でまとめて処理します。解像度518×378の映像なら約20FPSで動き、リアルタイム用途で1万コマ超、オフラインなら最大2万5千コマまで扱えます。 従来のこの手の3D化は、①LiDARのような専用センサーを積むか、②撮り終えた大量の写真をあとからまとめて突き合わせる“重い最適化計算”に頼るのが常識でした。どちらも機材か時間のコストが大きく、その場で結果を見ることはできません。LingBot-Mapは一度きりの推論で答えを出す『フィードフォワード型』なので、映像を入れた端から結果が返ります。長く撮るほど誤差が積み上がってズレていく弱点も、過去の記憶を使った補正で抑え込んでいます。 使うには、モデルがHuggingFaceとModelScopeで公開されており、コードはGitHub上でApache-2.0ライセンス(商用利用可)で入手できます。開発元はAnt Group系のロボティクス企業Robbyant。動かすにはPythonとGPUの実行環境が必要で、そのまま製品に組み込むというより、体験装置やロボット演出の空間認識エンジンとして自社システムに組み込む使い方が現実的です。
License
GitHubリポジトリはApache-2.0。モデルはHuggingFace/ModelScopeで公開