MoCapAnything V2
Huawei (AniMotionLab / Huawei Central Research Institute, Singapore)/2026-09
Overview
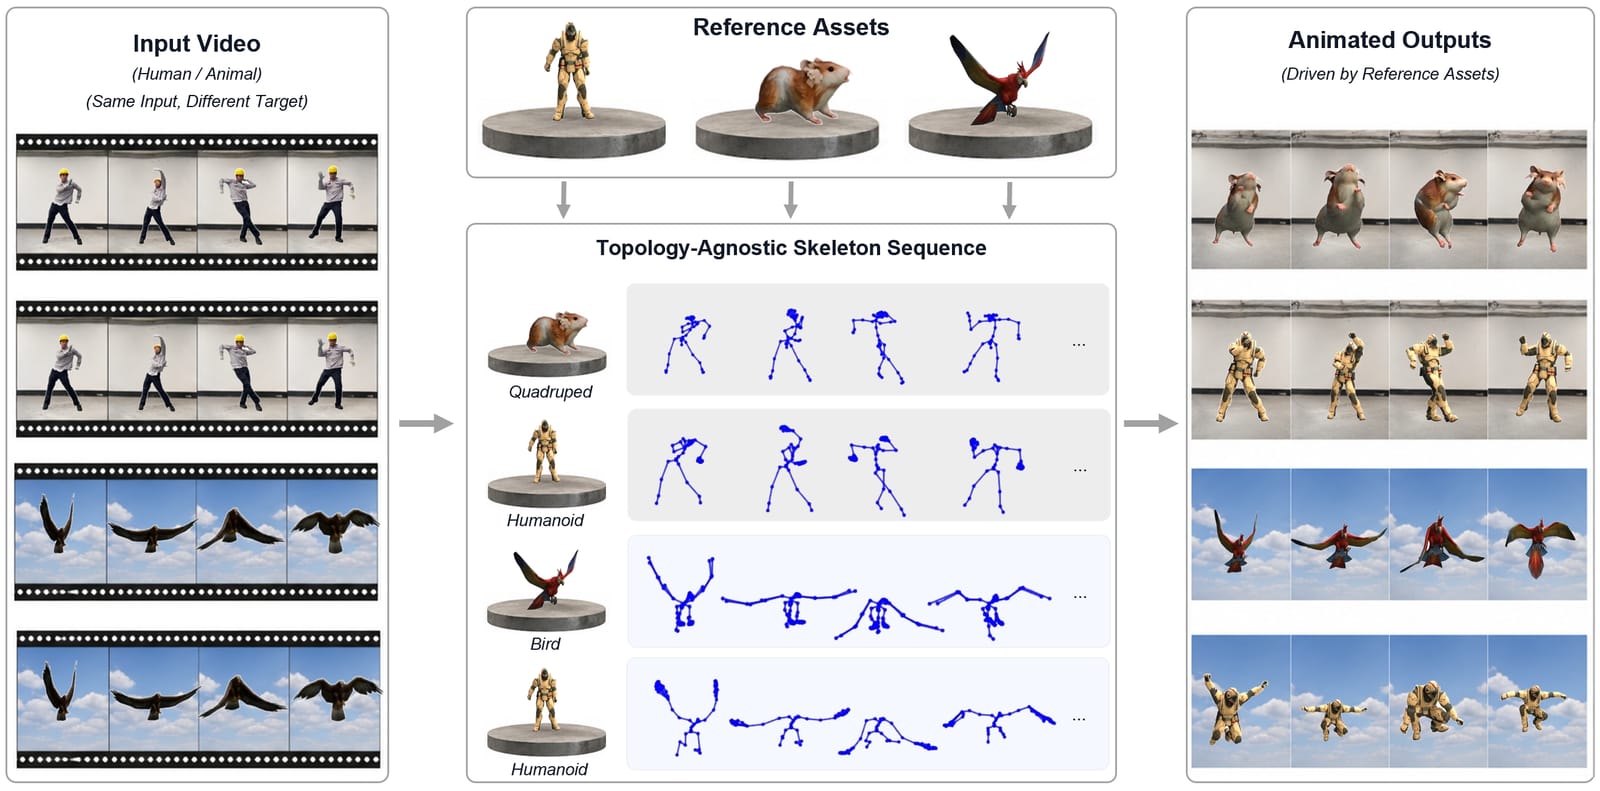
1台のカメラで撮った動画から、人間・動物・オブジェクトを問わず、どんな骨格の3Dキャラクターにもそのまま使えるモーションデータを自動生成する研究。
技術のポイント
従来のモーションキャプチャ(モーキャプ)は、専用スーツや多数のカメラを使う特殊なスタジオで撮影する手法でした。MoCapAnything V2は、スマホやYouTubeにあるような普通の1本の動画を入力するだけで、映っている動き(人間はもちろん、犬や鳥などの動物、さらには物体まで)を解析し、3Dキャラクターがそのまま踊ったり歩いたりできる「関節の回転データ」に変換します。しかも人間と骨格の形がまったく違うキャラクター(触手が生えたモンスターなど)でも、参照ポーズを1枚与えるだけで対応できるのが特徴です。従来手法より処理も約20倍速く、精度も大きく向上しました。広告制作の現場では、モーキャプスタジオを借りずに、既存のダンス動画や街頭の映像素材から独自キャラクターのアニメーションを量産する、といった使い方が考えられます。ブランドマスコットや架空の生き物を動かすプロモーション動画のコストと制作期間を大きく圧縮できる可能性があります。
技術の詳細
通常、動画から3Dモーションを作るには「①動画から人の3D形状(メッシュ)を推定する」→「②メッシュから骨格の動きを逆算する」という2段階の変換が必要で、間に工程を挟むほど誤差が積み重なり処理も遅くなっていました。MoCapAnything V2は、動画から直接「関節がどう回転しているか」を一気に予測する1つのAIモデルにまとめることで、中間のメッシュ工程を丸ごと省略しました。通訳を2人挟んで話を伝えるのではなく、1人のネイティブ通訳が直接翻訳するようなイメージで、情報の劣化が減り速度も上がります。 既存技術の多くは「人間の標準的な骨格」を前提に作られており、犬や独自デザインのキャラクターには使えないという制約がありました。本研究はキャラクターごとに違う骨格構造を扱う専用の注意機構を導入し、参照ポーズを1枚与えるだけで未知の骨格にも対応できるようにしています。論文によると、関節の向きのズレ(角度誤差)は従来の約17度から6.5度程度まで縮小し、処理速度は約20倍に高速化したとのことです。 コードはGitHub上でMITライセンスにより無料公開されており、ブラウザで試せるデモも用意されています。ただし背景を切り抜く前処理部分は非商用ライセンスのAIモデルを使っているほか、学習用データセットの一部は別途利用許諾が必要なため、商用制作で全機能をそのまま使う場合はライセンス確認が必要です。動作にはNVIDIA製GPUを積んだPC(または対応クラウド環境)とPythonの実行環境が必要で、3Dソフトへの書き出しにはBlenderがあると便利です。
License
コア実装はMITで商用利用可だが、前処理で使う背景除去モデルRMBG-1.4(BRIA AI)は非商用ライセンス。学習データの一部(Truebones Zoo)は別途利用許諾契約が必要。
Sources
Related Works
- MoCapAnything (V1)
同チームによる前身研究。単眼動画から任意スケルトンへの3Dモーションキャプチャを初めて統合的に扱った
- Kimodo (NVIDIA)
テキストからヒト型の高品質なモーションを生成する拡散モデル。生成方向のアプローチとして対照的