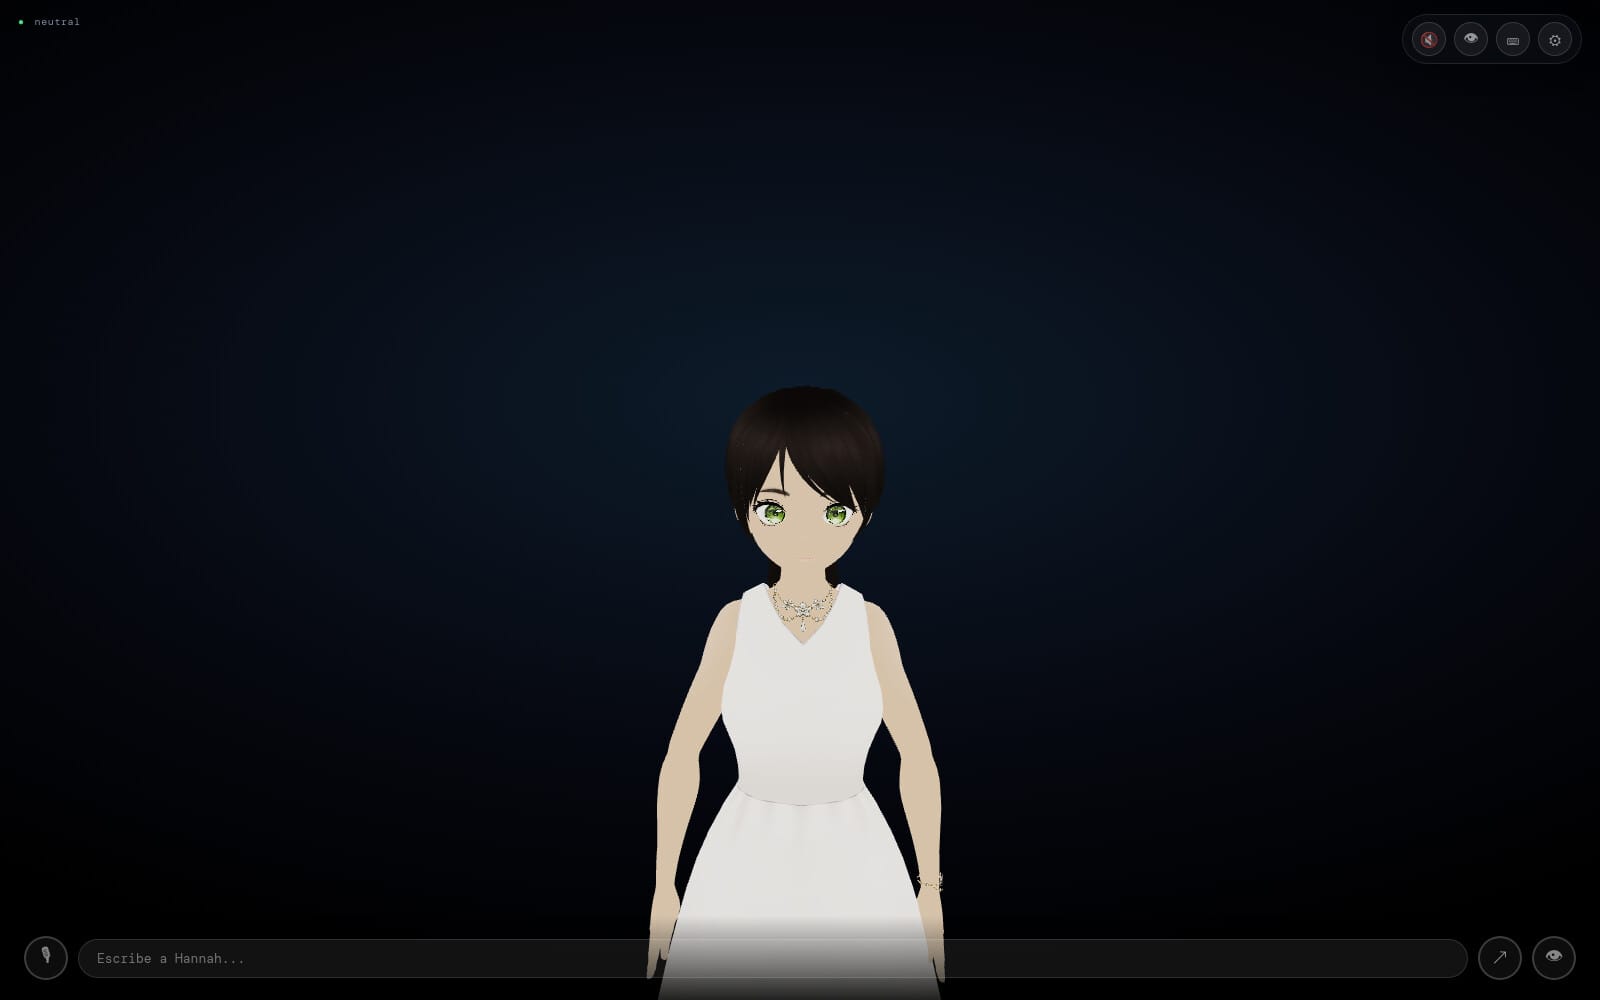
Hannah Motion Model (motionlab)
Vanth Labs/2026-09
Overview
AIアシスタント「Hannah」のために開発された、しゃべる文章のテキストからその場で3D body languageの動き(身振り手振り)を直接生成する研究用モデル。
技術のポイント
従来、AIキャラクターに身振り手振りをつけさせる主流のやり方は「音声の波形を分析してそこから動きを推定する」という遠回りな方法でした。このHannah Motion Modelは、しゃべらせたい『文章そのもの』と『どんな感情・強さで話すか』という指定だけを入力すると、それに合った上半身・手・下半身の動きを直接生成します。声を経由しないので反応が速く、しかも「興奮して手を振る」のような具体的な演技指示(アクションプロンプト)も別途足せるのが特徴です。広告や体験づくりの観点では、バーチャル店員・AI司会者・VTuber風のブランドキャラクターに、台本のテキストを渡すだけで毎回違う自然な身振りをその場で付けられる、という使い道が考えられます。決め打ちのループアニメを使い回す必要がなくなり、セリフごとに『生きた』印象の動きを量産できる可能性があります。ただし開発元は個人規模のチームで、実績のある大手研究機関の成果ではなく、まだ発展途上の研究リポジトリである点は割り引いて見る必要があります。
技術の詳細
仕組みは2段階です。まず「Stage A」で、人の動きを『上半身』『手』『下半身』のパーツごとに分解し、それぞれを短い数値の列(ちょうど音楽を五線譜に圧縮するように、動きの本質だけを抜き出したもの)に変換するVAE(自動で圧縮・復元を学習するモデル)を作ります。次に「Stage B」で、テキストの意味と感情・強さの指定を読み取り、その圧縮された動きの列を一気に生成する拡散モデル(Flow Matching DiT)を学習します。学習データはBEAT2・AMASS・Motion-X++という、研究でよく使われる人体動作データセットです。 従来手法との違いは入力の起点で、多くの既存システムは『音声→動き』という間接的な変換のため、声質や間の取り方に動きの質が左右されがちでした。本モデルは『テキスト→動き』を直接学習しているため、音声合成が終わるのを待たずに動きの生成を始められ、遅延を減らせるとされています。 使うには、Python 3.12とNVIDIAのCUDA対応GPU(学習・推論に相応の計算資源)が必要です。また学習済み重みを使う場合は研究データセットのライセンス上、非商用利用に限られ、商用で使いたい場合は自前データでの再学習が求められます。加えてSMPL-X(人体の3Dモデル形式)とAMASSデータセットは配布元に個別登録して取得する必要があり、誰でもすぐ商用導入できる完成品ではなく、研究者・開発者向けの土台という位置づけです。
License
学習・推論コード自体はMIT。ただし配布済み学習済み重みはBEAT2データセットのライセンスを継承しCC BY-NC 4.0(非商用のみ)。商用利用には自前データでの再学習が必要。加えてAMASSデータとSMPL-Xモデルは利用者が個別に規約同意の上で入手する必要がある。
Sources
Related Works
- EMAGE
音声から全身の身振りを生成する代表的な先行研究。本モデルはこの音声起点パイプラインをテキスト起点に置き換える狙いで開発された。
- NVIDIA Kimodo
テキストとキーフレーム指定から人体・ロボットの動きを生成するNVIDIA Researchの拡散モデル。同種のテキスト駆動モーション生成研究。
- Tencent HY-Motion 1.0
テキストからスケルトンベースの3Dモーションを生成する大手発の同種モデル。商用ライセンス体系の比較参考になる。