Wild3R
東京大学 山崎研究室/2026-06
Overview
観光地などで不特定多数がバラバラの日時・条件で撮った“寄せ集めの写真”だけから、一度のAI推論で3D空間を復元する技術。
技術のポイント
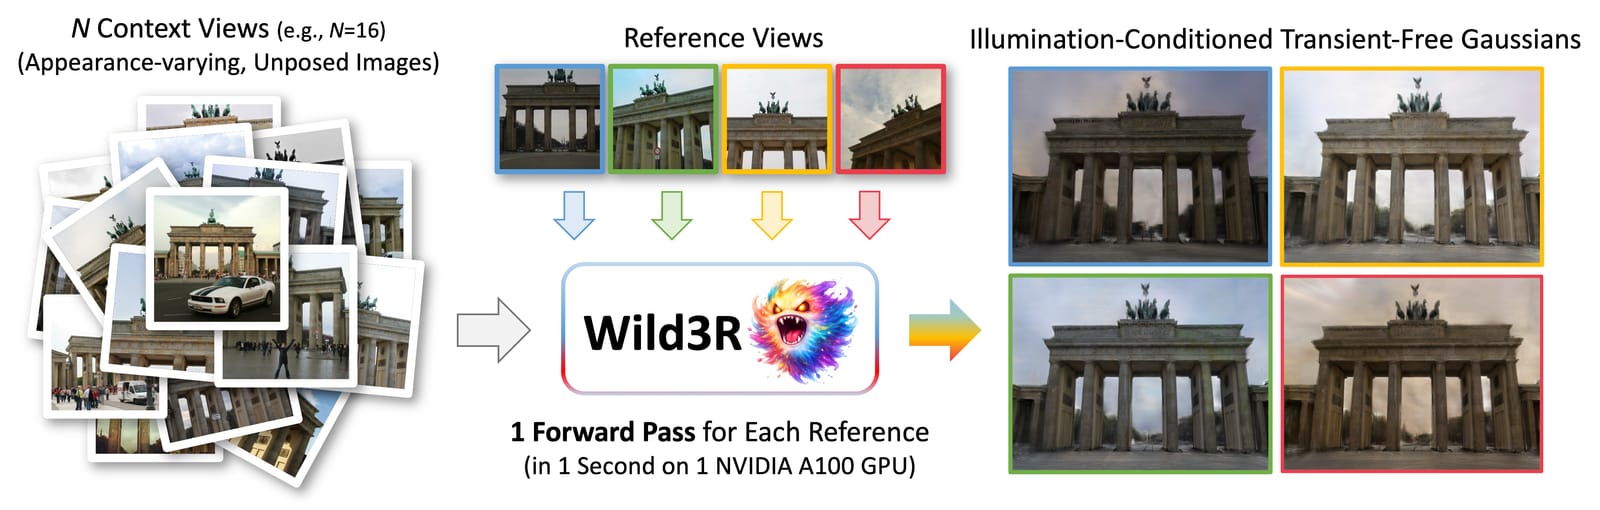
観光地の写真を思い浮かべてください。同じ建物でも、撮影者によって時間帯・天気・人の写り込みはバラバラです。Wild3Rは、そうした統一感のない大量の写真だけから、シーンの立体構造をたった一度のAI推論で復元してしまう技術です。従来のGaussian Splatting(3D点群による高速な3D表現)は、同じ照明条件・同じカメラで撮った写真セットが前提で、少しでも条件が違う“野良写真”が混ざると再構成が崩れていました。Wild3Rは照明差や人・車などの動く障害物を自動で無視しながら、きれいな立体シーンだけを取り出します。広告・体験づくりの視点では、SNS投稿写真や過去のイベント写真アーカイブなど「バラバラに撮られた素材」からそのまま3D空間を作れる可能性が生まれます。思い出の写真を集めてブランド体験の会場を3D空間として再現したり、ユーザー投稿写真だけでポップアップ店舗のバーチャル内覧を作る、といった企画のハードルが下がります。
技術の詳細
仕組みとしては、まず多数の入力写真をAIが読み込み、それぞれの写真の“見え方の違い”(照明・色調)を、シーンそのものの形とは別の情報として切り分けて扱います。たとえるなら、同じ舞台美術を昼公演と夜公演、雨の日と晴れの日に見た観客の証言を集めて、「舞台装置そのものの形」と「その日の照明・天候」を仕分けながら1つの立体模型を組み立てるようなイメージです。写真に写り込んだ通行人や車などの“その場限りの映り込み”も自動的に無視します。この分野の主流だったフィードフォワード型3D復元(1回のAI推論だけで完結する高速な方式)は、これまで同一条件で撮影されたきれいな写真セットでしか安定して動きませんでした。Wild3Rは研究チームが新たに用意した20万枚超・170通りの照明条件を含む学習データ(WildCity)で鍛えることで、寄せ集め写真にも対応できるようにした点が新しい。使うにはGitHub上のコードとHugging Face配布の学習済みモデルをダウンロードし、PyTorch環境(GPU推奨)で動かす必要があります。プログラミング知識が必要な研究プロトタイプの段階で、現時点でノーコードのアプリやWebサービスにはなっていません。
License
src/はAnySplat(MITライセンス)を採用したコード。学習済み重みはHugging Faceで配布、プロジェクトページのテンプレートはCC BY-SA 4.0
Sources
Related Works
- AnySplat
任意視点からのフィードフォワード型3D Gaussian Splattingの基盤手法
- WildSplatter
見え方の制御を扱う類似のフィードフォワード型3DGS手法