Click3R
University of Virginia (UVA Computer Vision Lab)/2026-11
Overview
2枚の写真から3Dを復元するAIが間違えたとき、人が「この点とこの点は同じ場所」とクリックで数回教えるだけで、その場で直せる手法です。
技術のポイント
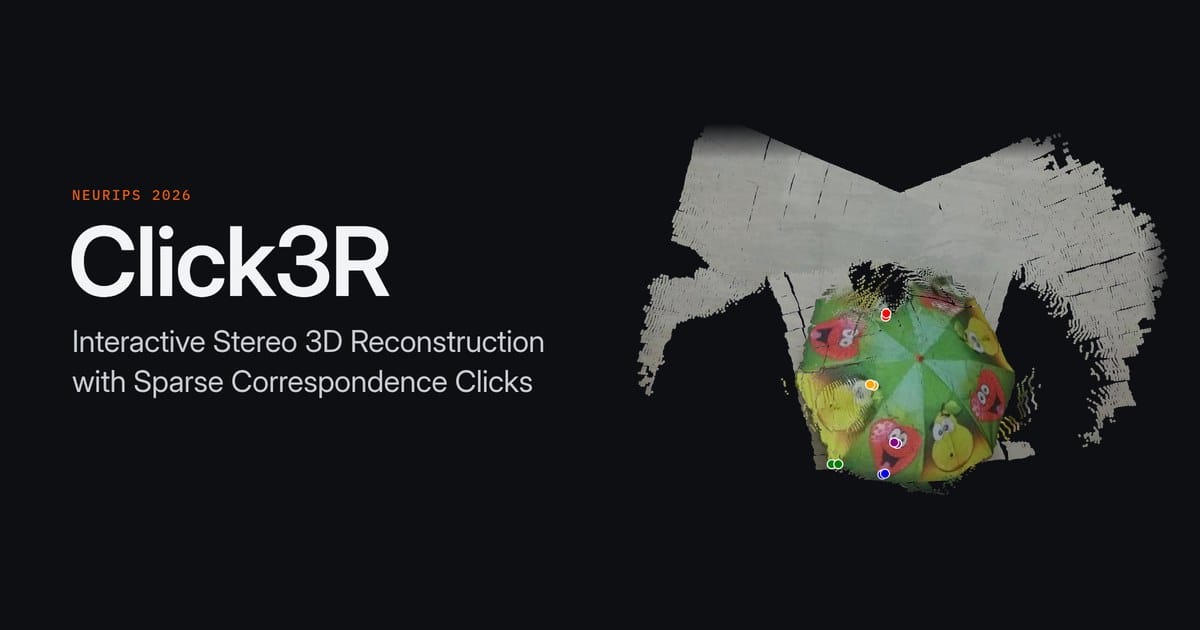
写真から3Dを起こすAI(DUSt3R系)は、繰り返し模様や左右対称の建物、のっぺりした壁、大きく角度が違う写真だと、1回の推論で出た結果が間違っていても直す手段がありませんでした。Click3Rは、2枚の写真の同じ場所を人が1〜12回クリックして伝えるだけで、再学習や長い最適化なしにその場で復元をやり直せます。論文では、実際の人のクリック(平均3.8回)で精度指標が35.7から56.2へ上がっています。広告や展示づくりでは、現地で撮った数枚の写真から会場や商品の3D背景を素早く作り、崩れた部分だけクリックで直す、という使い方が考えられます。撮影素材が少ない案件や、ロケハン写真からのプリビズ(仮の3D空間)づくりに向きます。ブラウザのデモが公開されているので、まず手元の写真で試せます。
技術の詳細
仕組み:土台は、2枚の写真から各ピクセルの3D位置を一度に予測するDUSt3Rです。そこに約3,400万パラメータの小さな追加部品(アダプタ)を足します。ユーザーがクリックした対応点の位置を数値の列に変えて、モデルの内部に注意機構(どこを見るか決める仕組み)で差し込みます。クリックが0回のときは追加部品を使わず、元のモデルと同じ動きになります。学習では、正解の3D情報から自動で作った疑似クリックを使っています。 従来との違い:これまでの同種モデルは、出力が1回で固定でした。結果が崩れたら別のモデルに替えるか、時間のかかる後処理をするしかありませんでした。Click3Rは1クリックから精度が上がり、人が直すことを前提にした設計です。難しい写真ペアを集めたベンチマークHard3DBenchも同時に公開されています。 使うには:コードはMITライセンスで、Python 3.11とNVIDIA GPUがあれば、demo.pyで重みの取得から起動までできます。ただし重みは非商用ライセンスなので、案件の納品物に直接使う場合は注意が必要です。公開直後のリポジトリでコミット数もまだ少なく、動作は筆者側で未検証です。
License
コードはMIT。学習済みの重み(チェックポイント)はCC BY-NC-SA 4.0で、非商用のみ。