tsov (the shape of voice)
luolianst(個人開発者)/2026-10
Overview
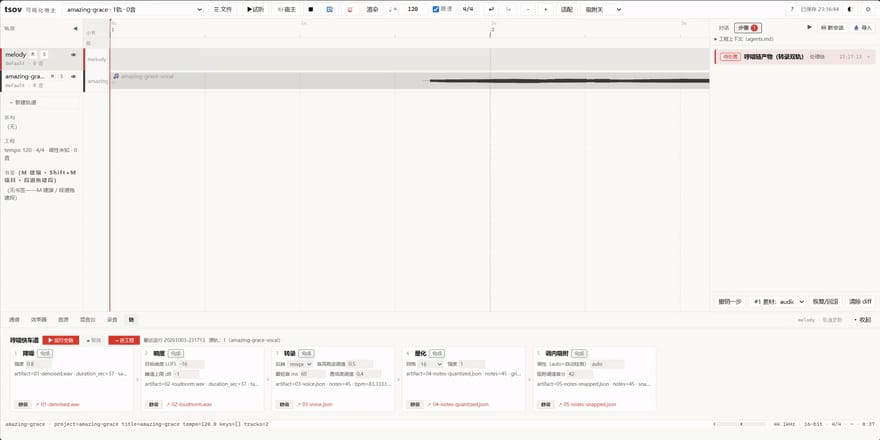
鼻歌を録音すると楽譜(MIDI)に起こし、AIチャットで編曲・ミックス・書き出しまで進められるローカル動作の音楽制作ワークスペース。変更は差分として確認でき、元に戻せる。
技術のポイント
鼻歌を録音するだけで、ノイズを取り、音程を拾い、リズムを揃え、スケール(音階)に合わせたメロディとして譜面に起こします。そこからチャットで「ベースを足して」「もう少しゆっくり」と頼むと、AIが編曲を提案し、変更は毎回「差分」として表示されるので、気に入らなければ取り消せます。ピアノロール画面でも手で直せ、ミックスや書き出し(ステム別・MIDI)も同じ画面でできます。曲の分解(ボーカル・ドラム・ベースの分離と採譜)は次の版に向けて開発中です。広告・映像づくりでは、ディレクターが鼻歌でイメージを伝えて作曲者に渡す、あるいは自分で仮の曲を素早く作る、といった初期の企画段階で使えそうです。作業はほぼ手元のPC内で済むため、未公開素材を外へ出したくない案件にも向きます。
技術の詳細
仕組み:既存の音楽AIをつなぎ合わせた作りです。鼻歌の音程は RMVPE、曲からのボーカル・ドラム分離は htdemucs や Mel-Band Roformer、ドラム採譜は ADTOF、そのほかの楽器の採譜は YourMT3 で行い、MIDIの音はFluidSynthやDexedなどのVST3で鳴らします。チャットのAIは既定でDeepSeekですが、OpenAI互換のAPIならどれでも使え、外部のAIエージェントから操作するための実験的なMCPサーバーも付属します。人もAIも同じ「コマンド層」を通して編集するので、AIの変更が人の操作と同じ形で記録され、取り消せます。 従来との違い:鼻歌の採譜、ステム分離、編曲、ミックスは別々のソフトで行うのが普通でした。これは1画面にまとめ、AIの編集を差分で見せる点が新しい点です。ただしモデル自体は既存のものを組み合わせた構成で、作者は v0.1 のプロトタイプで、今後 破壊的変更が入りうる と明記しています。 使うには:主な対象はWindows 10/11(Mac/Linuxは未検証)で、Python 3.12、uv、ffmpegが必要です。大きなモデルは別途 vendor/ フォルダに置く必要があり、取得用のスクリプトがあります。チャットのAI機能だけはLLMのAPIキーが必要で、その分は従量課金になりえます(他は無料でオフライン動作)。ビルド済みバンドル(約3.7GB)は中国のミラー経由で、アカウントが必要です。
License
AGPL-3.0。改変してネットワークサービスとして提供する場合はソース公開が必要。各モデル(Demucs等)は別ライセンスで、vendor/へ自分で配置する。